tstack de Theo: 9 skills para llevar un PR hasta el merge
Tabla de contenidos
Theo Browne lleva años contando en su canal frameworks, librerías y formas nuevas de construir software. Su último vídeo va de tres ficheros markdown. Y él mismo lo reconoce con cierta sorna: le parece un poco absurdo, pero esos tres ficheros han cambiado cómo trabaja.
Se llaman sol loop, full send y full stop. Según cuenta, casi la mitad de los hilos que abre en T3 Code acaban usando alguna de las tres, y los que llegan a main casi siempre llevan al menos una. Ahora las ha juntado, limpias y con licencia MIT, en un repositorio llamado tstack, junto a otras seis skills que las sostienen.
No son skills que se le ocurrieran en la ducha. Son cosas que se veía repitiendo a mano una y otra vez hasta que decidió escribirlas. Y eso es lo más útil del repo: más que copiar sus markdown, puedes copiar la forma de llegar a ellos.
Esto es lo que vas a encontrar:
- Qué es tstack, qué nueve skills trae y cómo se llaman unas a otras
- Por qué Theo escribe la descripción de una skill como un disparador y no como una descripción
- Cómo funciona sol-loop: un revisor de otro proveedor, un presupuesto de rondas y una guerra declarada al crecimiento del PR
- Qué permisos concede full send para que un agente lleve un cambio hasta el merge sin que nadie mire
- Por qué full stop hace lo mismo pero se detiene antes del botón verde
- Cómo encajan takeover, modernize, babysit-pr, file-pr y leaving-pr-comments
- Cómo instalarlas en Claude Code o Codex y dónde conviene tocarlas antes de usarlas
¿Qué es tstack y qué skills incluye? 
tstack es el repositorio público con las skills de agente que Theo Browne usa cada día, preparadas para que cualquiera pueda usarlas en Claude Code y en Codex. Algunas aprovechan funciones de T3 Code cuando están disponibles y recurren a las herramientas nativas del harness cuando no.
El README lo resume en una tabla de tres columnas: la skill, la frase que la dispara y lo que hace. Son nueve:
| Skill | Frase que la activa | Qué hace |
|---|---|---|
full-send |
“full send” | Lleva un cambio hasta un PR mergeado sin nadie mirando: lo prueba, lo revisa, abre el PR, lo vigila y lo mergea |
full-stop |
“full stop” | Lo mismo que full send, pero se para cuando el PR está listo para que tú lo mergees |
sol-loop |
“sol loop” | Revisa el cambio con GPT Sol en bucle hasta que los dos agentes están de acuerdo |
council |
“council” | Pide revisión a tres modelos de proveedores distintos y repite hasta que coinciden |
file-pr |
“file a PR” | Abre un PR corto que empieza por el problema, no por un inventario de cambios |
babysit-pr |
“babysit” | Vigila un PR durante CI y bots de revisión, y arregla los hallazgos reales |
takeover |
“take over” | Termina el PR, rama o hilo de otro y conserva su crédito |
modernize |
“modernize” | Rebasa un PR viejo y decide si todavía debe existir |
leaving-pr-comments |
(automática) | Da formato a los comentarios que un agente publica en tu nombre |
Las skills no son piezas sueltas. El propio README avisa de las dependencias: full-send usa sol-loop, file-pr y babysit-pr; full-stop usa full-send; takeover tira de modernize, file-pr, babysit-pr y leaving-pr-comments. Si instalas solo una, se queda coja.
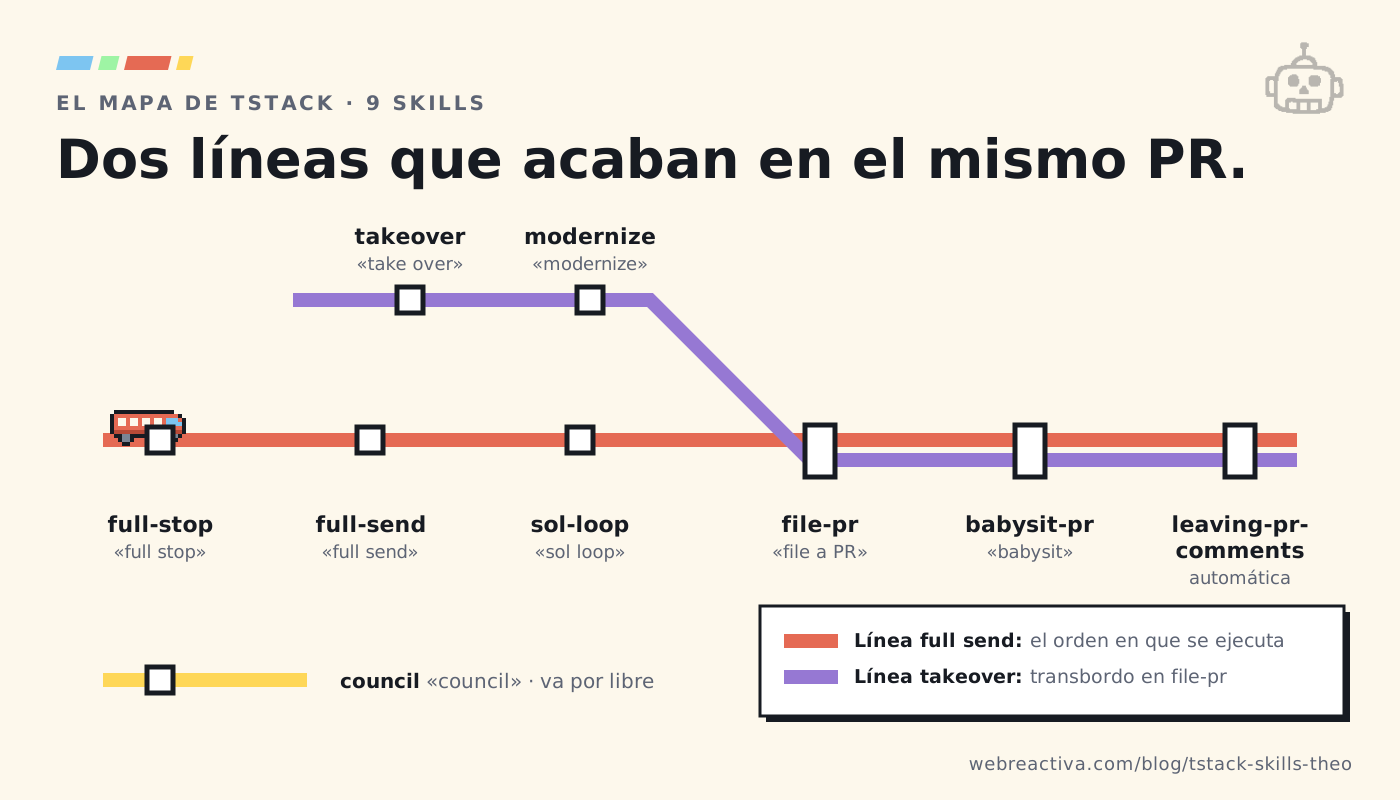
Los requisitos son pocos: el CLI de GitHub (gh) autenticado, python3 para el script de espera de babysit-pr y, para sol-loop y council, alguna forma de lanzar subagentes con modelos de otros proveedores. En T3 Code eso lo hace su herramienta delegate_task; fuera de T3 Code, necesitas un harness que pueda ejecutar esos modelos.
Si vienes de leer sobre pstack, el plugin de skills de Lauren Tan para Cursor, notarás el contraste enseguida. pstack es un método completo con 47 carpetas que va desde entender el código hasta aprender de lo que ha pasado. tstack es mucho más estrecho: todo gira alrededor del pull request y de cómo sacarlo de tu cabeza lo antes posible.
¿Por qué Theo escribe las descripciones como disparadores? 
Porque en una skill la descripción no sirve para describir: sirve para decirle al modelo cuándo cargarla. Theo lo explica en el vídeo con un ejemplo mínimo. La skill se llama sol-loop y su descripción es, literalmente, Use when the user says “sol loop”.
Mira el frontmatter de las tres estrellas del repo:
# sol-loop/SKILL.md
name: sol-loop
description: Use when the user says "sol loop".

# full-send/SKILL.md
name: full-send
description: Trigger this if the user says 'full send'.

# full-stop/SKILL.md
name: full-stop
description: Trigger this if the user says 'full stop'.
Nada de “Esta skill ayuda a mejorar la calidad del código mediante revisiones iterativas…”. Una frase, un disparador. El efecto es que la skill no entra en el contexto a menos que la pidas tú o la pida otra skill. En un flujo que concede permisos para mergear, eso te protege de que el modelo lo active por intuición en mitad de una tarea cualquiera.
Esto choca con el consejo habitual de escribir descripciones ricas para que el modelo descubra la skill solo, el que repasamos en las buenas prácticas para crear skills. No es una contradicción: depende de si quieres que el agente descubra la skill o que la obedezca. Para skills de conocimiento (cómo se usa tal API), descripción rica. Para skills que cambian el nivel de autonomía, disparador explícito.
🔑 Una descripción es un
if, no un resumen. Escríbela pensando en la condición que debe cumplirse para que la skill entre en juego.
¿Y por qué no usar comandos con barra? 
Hay una opción en el estándar de skills, disable-model-invocation, que impide que el modelo cargue la skill por su cuenta: solo entra si la invocas con /sol-loop o $sol-loop. Mucha gente le sugirió a Theo que la usara. Él no quiere, por tres motivos que da en el vídeo:
- No quiere acordarse de la sintaxis. Prefiere escribir o dictar “full stop takeover sol loop” en lenguaje natural y que el modelo entienda qué cargar.
- Algunos harnesses no te dejan invocar varias skills a mano a la vez, y él combina skills constantemente.
- En Claude Code, al invocar una skill a mano, tu prompt se inyecta también como argumento, así que acaba dos veces en el contexto. Theo lo atribuye a un comentario de otra persona; tómalo como observación de usuario, no como documentación oficial.
La única skill que sí invoca con barra es /grill-me de Matt Pocock, porque así la distribuye su autor.
Lo que le repites a tu agente cada día, escrito una vez en una skill
Un minicurso por email, a tu ritmo, para instalar skills en tu agente y escribir la tuya, como hizo Theo con sus hábitos.
Apúntate al minicurso →¿Cómo nacieron estas skills? 
Ninguna de las skills de tstack se diseñó de antemano: cada una es un hábito que Theo repetía a mano y que acabó escribiendo. Él mismo describe la cadena en el vídeo, y cuando la ves en orden se entiende por qué el repo tiene esta forma.
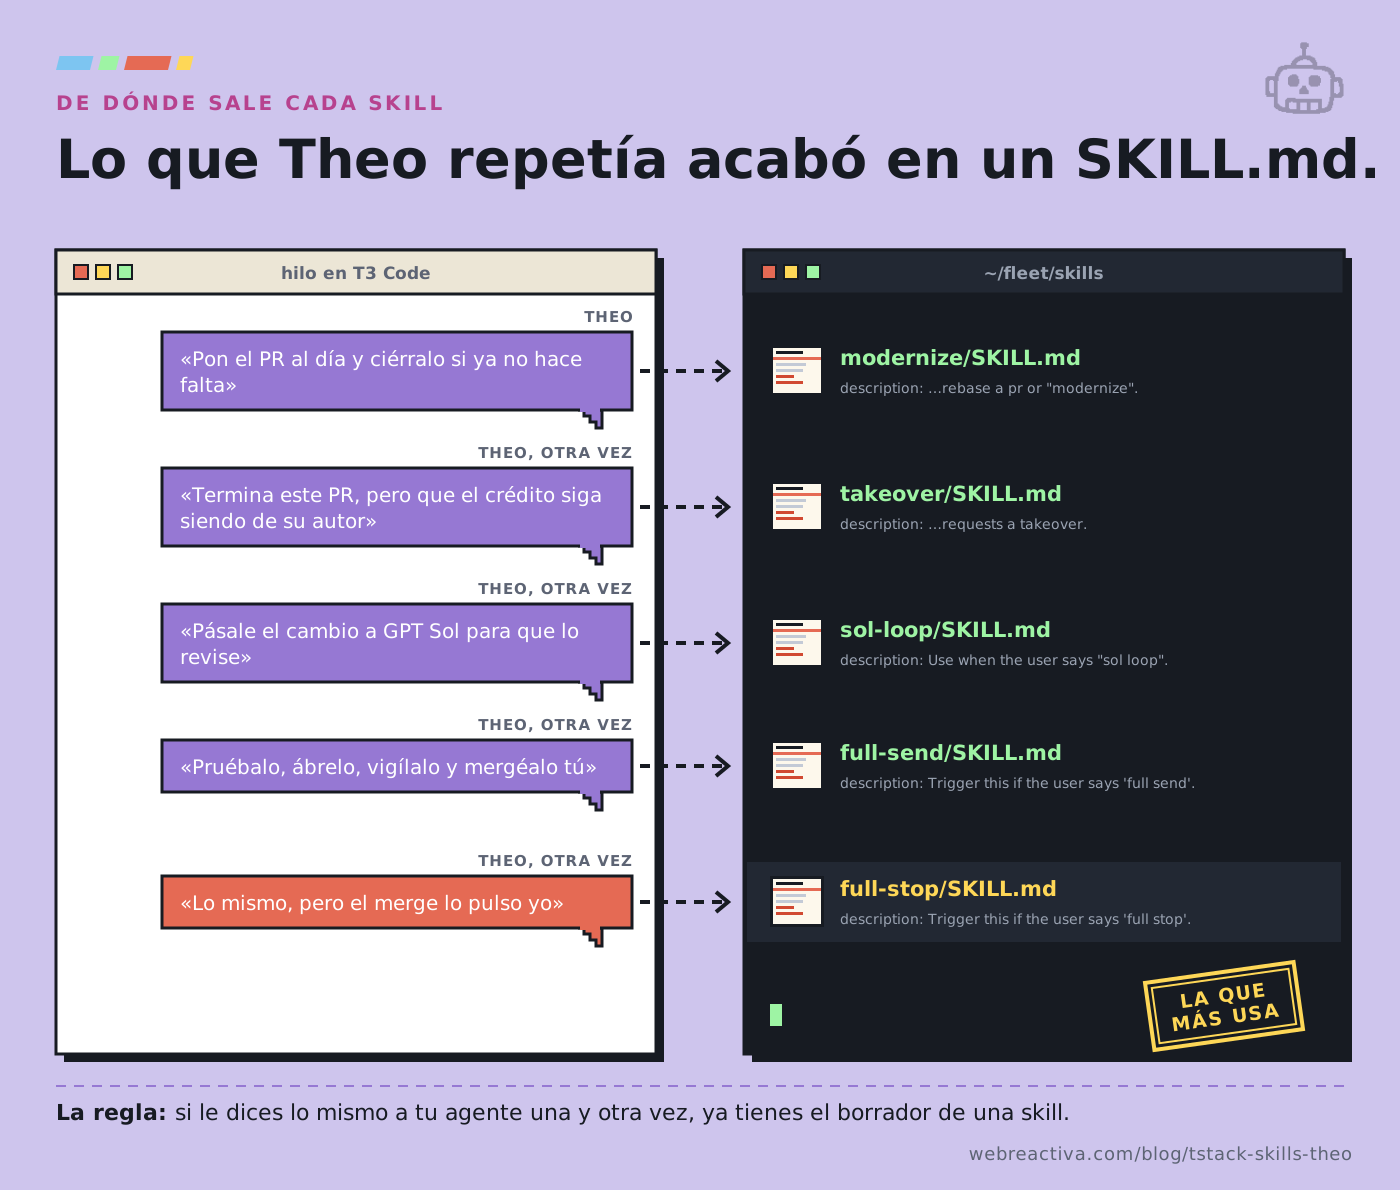
Primero fue modernize. Les decía a los modelos lo mismo cada vez: pon el PR al día con main y ciérralo si ya no tiene sentido porque se ha mergeado algo parecido. Lo convirtió en skill.
Después vino takeover. Como mantenedor de un proyecto open source, recibe PRs que arreglan cosas importantes pero que no puede mergear tal cual ni quiere reescribir encima de la rama de otro. Se repetían los mismos problemas, así que también acabó en un markdown.
Luego, sol-loop. Pedía revisiones a subagentes con GPT Sol a mano con tanta frecuencia que decidió formalizarlo. Al ver que el código que salía era mejor de lo que esperaba, se atrevió con full send: llevar el cambio hasta el final, merge incluido. Y como en los cambios delicados echaba de menos ese flujo, nació full stop, que Theo describe con honestidad como “Claude reescribiendo mi skill de full send con un cambio grande”.
💡 El patrón es más valioso que cualquiera de los ficheros: si le dices lo mismo a tu agente tres veces, ya tienes el borrador de una skill.
Hay un detalle que se ve comparando el vídeo con el repo. En el vídeo, varias skills hablan de “Theo” (“Theo te da permiso para mergear…”, “usa cuando Theo pida full stop”). En tstack ya pone “the user”. La versión pública es la limpieza de su versión personal, que vive en un repo privado llamado fleet desde el que sincroniza skills, MCPs y autenticación entre todas sus máquinas.
¿Qué hace sol-loop y por qué revisar con un modelo de otro proveedor? 
sol-loop es un flujo para que tu agente principal escriba el cambio y GPT Sol lo revise en bucle, con el mínimo de cambios necesario para dejar contento al revisor y sin miedo a llevarle la contraria. La primera frase del SKILL.md es casi un manifiesto: Make the most minimal possible changes to appease the Sol reviewers. Be careful of scope creep and don’t be scared to push back.
¿Por qué Sol? Theo trabaja casi todo con Opus 5.5, que considera mejor colaborador y mejor escritor de código. Pero ve a GPT-6.1 Sol más minucioso: lo llama “el rottweiler”, porque muerde un problema y no lo suelta. Si quieres los datos detrás de esas impresiones, tienes el análisis de Opus 5.5 y el de GPT-6.1 Sol. Para esta skill da igual cuál gana: están entrenados distinto y fallan distinto. Theo lo compara con pedir revisión a tres personas con experiencias diferentes: aumentan las probabilidades de que cada una encuentre algo que las otras no ven.
Hay otro motivo, más mundano: así aprovecha la suscripción de Codex que, de otro modo, apenas usaría.
¿Cuántas rondas hace sol-loop? 
Tres por defecto. La primera revisa el cambio completo; las siguientes solo miran el código que ha cambiado y los hallazgos abiertos. El presupuesto está escrito en la skill con reglas muy concretas:
- Se amplía a cinco rondas solo si hay algo abierto, con evidencia, sobre seguridad, permisos, autenticación, pérdida de datos o concurrencia. O si lo pides tú.
- Se para antes si una ronda solo devuelve nits. Los arreglos de comentarios, documentación o formato no justifican otra ronda.
- Un solo revisor. Sol no puede lanzar subagentes ni revisores propios, porque si no la cosa se anida a toda velocidad.
- Un registro (ledger) con id, severidad, resultado y consumo de tokens si lo devuelve. Y una advertencia: never guess it.
Sin presupuesto, un bucle de revisión entre dos modelos no termina nunca. Cada uno tiene opiniones y cada arreglo abre una conversación nueva.
¿Cómo clasifica sol-loop los hallazgos? 
Con tres severidades que el propio brief le pasa al revisor: blocker (el caso que se quería arreglar está mal), should (un bug real que van a encontrarse quienes llamen a ese código, dentro del objetivo) y nit (todo lo demás). El agente principal tiene que comprobar cada hallazgo y su severidad por su cuenta. Otro camino, un caso raro o un coste pequeño es un nit, venga con la etiqueta que venga.
Este es el brief de la primera ronda, tal cual aparece en el repo:
Review only. Do not edit, commit, push, comment on PRs, or start subagents.Repo: <abs path> Base: <sha> Intent: <intent> Out of scope: <scope> Checks: <results>See: git diff <base> [-- <paths>]; git status --short (read untracked).Read surrounding code. Find bugs, broken callers, mismatch with intent.Skip style unless it hides a bug. Hold to the smallest change. Flag code,tests, or guards the intent does not need. Other paths, rare cases, smallperf, extra compat: nits.blocker = intended case wrong. should = real bug callers will hit, in intent. nit = rest.Reply:VERDICT: APPROVE or CHANGESS1 [blocker|should|nit] <file>:<line> <claim>. Fix: <suggestion> (stable ids)Fíjate en que al revisor también se le pide señalar código, tests o guardas que el objetivo no necesita. No solo busca lo que falta: busca lo que sobra.
Para cada hallazgo, el agente tiene tres salidas. Si está de acuerdo, aplica el arreglo más pequeño, prefiriendo borrar o estrechar código antes que añadir un lock, una caché, un helper o una opción. Si no está de acuerdo, lo dice con evidencia (fichero y línea, test, salida). Si es un nit o está fuera de alcance, lo rechaza en una línea y lo apunta como tarea pendiente. Tras cada ronda vuelve a mirar git diff --shortstat: if review grew the diff, cut first.
⚠️ El fallo típico de los bucles de revisión con IA es que el PR crece un arreglo barato tras otro. sol-loop está escrito, casi línea por línea, para impedirlo.
¿Qué pasa si los dos agentes no se ponen de acuerdo? 
Si un punto sigue en disputa después de dos respuestas, o se acaba el presupuesto, la skill muestra los dos lados en dos o tres líneas cada uno y decides tú. Terminar el presupuesto no es aprobar. Un timeout o un error del revisor tampoco.
Y cuando el PR sale, lleva una línea encima de la firma del modelo:
Reviewed with sol-loop: <N> rounds with <model>. Sol verdict: approved
Theo añadió el veredicto después de notar que Opus, a veces, “casi quería esconder” que Sol no había quedado contento con los cambios. Con la línea obligatoria, eso queda a la vista de quien revise el PR. Es un buen ejemplo de por qué él insiste en editar las skills a mano: la versión anterior la había dejado crecer a base de pedirle arreglos a Claude y, al releerla, la encontró hinchada y con frases que olían a modelo.
¿Cómo lanzo GPT Sol desde Claude Code? 
La skill contempla varios caminos. En T3 Code usa orchestrator_capabilities para encontrar el último modelo Sol disponible y delegate_task para lanzar cada ronda como tarea asíncrona de revisión. Fuera de T3 Code, pide un subagente nativo de Sol. En Claude Code, solo vale un subagente personalizado que esté configurado para ejecutar Sol. Y si no hay ninguna ruta, la skill tiene que avisar del bloqueo en vez de cambiar de modelo.
En el vídeo Theo enseña dos montajes:
- Un proxy de CLI propio que centraliza la autenticación de todas sus suscripciones y le permite usar modelos de OpenAI dentro de Claude Code. Avisa de una asimetría importante: con la suscripción de Claude conviene usar solo Claude Code, porque Anthropic vigila que el system prompt sea el suyo; OpenAI, según Theo, no pone pegas a que uses los tokens de Codex en otra herramienta.
- El Orchestrator V2 de T3 Code (en la versión nightly cuando grabó el vídeo), que permite que un hilo de Claude Code lance hilos de Codex, Gemini o Muse con sus propios harnesses nativos, sin meter un modelo en el harness de otro.
Si no quieres montar nada de eso, el atajo más sencillo es el plugin de Codex para Claude Code, que ya trae un flujo de revisión con Codex como segundo agente. No es lo mismo que sol-loop (no tiene su presupuesto ni su registro), pero sirve para probar si un revisor de otro proveedor te aporta algo antes de copiar la skill.
Revisores de otros proveedores, skills que nacen de hábitos, agentes que se vigilan entre sí: de esto hablamos cada domingo en la newsletter, con +7.200 developers que también lo están probando. Gratis desde 2018.
Suscríbete gratis →¿Qué añade council sobre sol-loop? 
council amplía la idea a tres revisores de tres proveedores distintos, en paralelo, y repite hasta que los tres están satisfechos. Si no le dices qué modelos usar, coge el último modelo insignia de cada proveedor, por ejemplo Claude Opus, GPT Sol y Gemini Pro, con esfuerzo de razonamiento alto. Si no puede llegar a tres proveedores, lo dice; no sustituye a nadie en silencio.
Para revisiones de código pide a cada delegado una nota sobre 10 y lleva la cuenta de rondas. Si el trabajo acaba en un PR, mete una tabla en la descripción con las notas de cada modelo en cada ronda, y prohíbe inventarse una nota que el delegado no ha dado.
Theo tiene sus preferencias: le parece que los modelos de OpenAI son los más minuciosos, que los de Claude encuentran cosas raras y potencialmente peligrosas que otros pasan por alto, y que Gemini alucina más de lo que encuentra. Son impresiones personales de alguien que trabaja con ellos todo el día, no un benchmark, pero coinciden con algo que se repite en la comunidad: la diversidad de revisores vale más que tener al revisor “mejor”.
La regla final de council es la misma que la de sol-loop, y no es casualidad: Do not let repeated reviews result in scope creep. It is your job to fight to keep scope limited.
¿Qué es full send y qué permisos le da al agente? 
full send es la skill que convierte un hilo en un trabajo autónomo de principio a fin: el agente termina el cambio, lo prueba, lo revisa con sol-loop, abre el PR, lo vigila, lo mergea cuando pasa la puerta de merge y deja un informe. La premisa está en la primera línea: si el usuario ha activado esto, es porque no está mirando este hilo. Tus mensajes intermedios y el final no los va a leer nadie hasta mucho después.
La skill concede tres permisos explícitos:
- Mergear el PR cuando pase la puerta de merge.
- Hacer force push de la rama del propio PR con
--force-with-leasedespués de un rebase. - Usar los métodos de prueba que haga falta sin preguntar antes.
Theo cuenta por qué escribió esa lista: los modelos de OpenAI se ponían nerviosos con el merge si no tenían en el contexto un permiso explícito del usuario. Cada viñeta de la skill es la corrección de algo que no le gustó. Su método es preguntarle al modelo “¿por qué has hecho esto?”, leer la respuesta y tocar el markdown para que no se repita.
El tercer permiso merece atención. La skill dice que una petición de full send sustituye las reglas del proyecto que obligan a preguntar antes de usar un método de prueba: computer use, automatización del navegador, simuladores, arrancar la app, capturas. Sí respeta las reglas sobre cómo probar (qué comando, qué fixture). Y no amplía permisos a nada de lo que está en la lista de cosas por las que hay que preguntar.
🛡️ Si tu
CLAUDE.mdo tuAGENTS.mddice “no arranques el servidor sin preguntar”, full send se lo salta para ese cambio. Léelo antes de instalarla en un repo con reglas así.
¿Cuáles son los pasos de full send? 
Siete, y el agente no puede soltar el hilo entre medias:
- Terminar el cambio con lo mínimo que funcione. Arregla el caso que ha pasado, no todos los que podrían pasar. Si está en la rama por defecto, crea una rama.
- Probarlo. Evidencia para cada cambio.
- Pedir feedback con
sol-loop. - Abrir el PR con
file-pr, rebasado sobre la rama por defecto y con una línea que diga cómo se ha probado. - Vigilar el PR con
babysit-pr: CI, bots de revisión, hallazgos reales. - Mergear cuando pase la puerta.
- Informar: enlace al PR, commit de merge, prueba y cada decisión que tomó por ti.
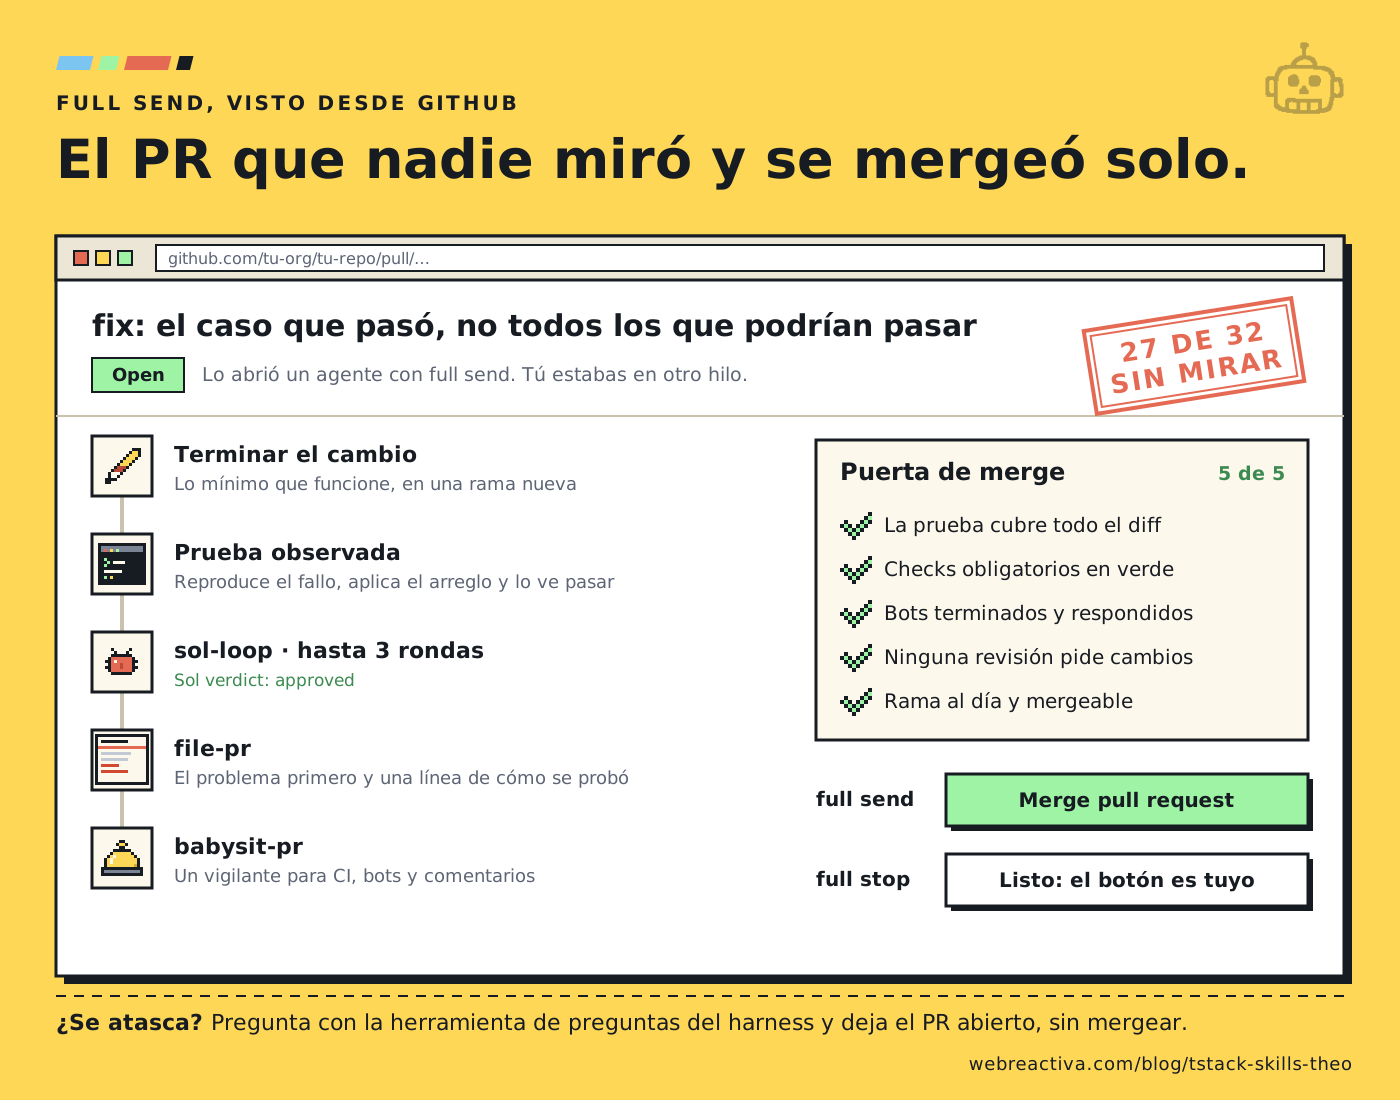
La skill insiste en algo que parece obvio y no lo es: si terminas tu turno mientras hay checks o bots pendientes, el trabajo se para, porque nadie te va a volver a escribir. Por eso obliga a esperar con el vigilante de babysit-pr, que despierta al agente cuando el PR cambia.
¿Qué cuenta como prueba? 
La definición es estricta: prueba es evidencia que el agente ha observado él mismo en esta sesión. Salida de comandos, una reproducción, una captura. En orden de preferencia:
- Reproducir el fallo original, aplicar el arreglo y ver pasar esa misma reproducción.
- Ejecutar los checks que ejecuta la CI del repo: typecheck, lint, tests.
- Añadir un test enfocado que falle sin el arreglo, si el comportamiento no tenía test y el repo tiene dónde ponerlo.
- Para UI y comportamiento en ejecución, arrancar la app y mirarlo. Unos tests en verde con mocks no prueban que la experiencia de usuario funcione.
Si el agente no encuentra forma de probar un cambio, la conclusión es tajante: no tiene confianza plena y debe preguntar. Es el mismo principio del loop engineering: un bucle que trabaja, verifica y sabe cuándo parar. Sin una forma de comprobar, la autonomía es una apuesta.
¿Qué es la puerta de merge? 
Cinco condiciones que tienen que cumplirse sobre el último commit:
| Condición | Qué significa en la práctica |
|---|---|
| La prueba cubre todo el diff | Ningún cambio sin evidencia observada |
| Los checks obligatorios están en verde | La CI del repo manda, no la opinión del agente |
| Los bots de revisión han terminado | Cada hallazgo arreglado o rechazado con un motivo escrito |
| Ninguna revisión humana pide cambios | Si alguien del equipo bloquea, no se mergea |
| La rama está al día y GitHub la da por mergeable | Nada de mergear contra un main viejo |
Se mergea con el método que use el repo, respetando branch protection, y nunca con --admin ni otros atajos. Hay una frase que conviene leer dos veces: el agente puede ignorar revisiones automáticas que pidan “necesita revisión humana” si tiene confianza alta en sus cambios. Es coherente con la filosofía de la skill, pero es el punto donde más vas a querer adaptarla a tu equipo.
¿Cómo pregunta el agente si nadie está mirando? 
Esta es, según Theo, la sección más importante. Una pregunta dentro de un mensaje normal pasa desapercibida y el hilo parece terminado. Así que la skill obliga a usar la herramienta de preguntas del harness (AskUserQuestion en Claude Code, request_user_input en Codex), que marca el hilo como “esperando” y lo saca a la bandeja de entrada.
La pregunta tiene que llevar todo el contexto: el enlace al PR, qué le bloquea y las opciones con su recomendación primero. Y solo se pregunta en cinco casos: no puede probar el cambio, la puerta de merge no puede pasar y no puede arreglarlo, el siguiente paso sale del permiso concedido (borrar datos, tocar producción, cerrar un PR, force push de otra rama), el objetivo es ambiguo de una forma que cambia el resultado, u otro PR deja este obsoleto.
Theo añadió esa lista cerrada después de comprobar que, tras darle la herramienta, el agente preguntaba todo el rato. Y si no hay herramienta de preguntas o nadie responde, toma el camino seguro: deja el PR abierto sin mergear y empieza su mensaje final con la pregunta.
¿Funciona de verdad? 
El dato que da Theo: en la ventana de tiempo que consultó, había dicho “full send” 32 veces, y 27 de esos PR se mergearon sin que volviera a mirarlos. Lo saca de una base de datos ClickHouse donde su proxy vuelca todas sus peticiones y respuestas, así que es su registro, no una estimación. Y asegura que ninguno de esos cambios dio problemas.
Con ese 84 % Theo no presume de que el agente acierte siempre. Presume de que, con práctica, ya sabe qué cambios puede dejar que se mergeen solos y cuáles necesitan otra mirada. Y lo acompaña de una red de seguridad: T3 Code publica una versión nightly cada seis horas, así que si algo se rompe se entera antes de la siguiente versión estable. Su frase es “construye buenos sistemas de verificación, pero también buenas redes de seguridad”. Cualquier error va a ocurrir tarde o temprano; lo que puedes controlar es cuánto daño hace y lo rápido que lo deshaces.
Tu IA puede mentirte
Prueba observada y revisión entre modelos: el método para fiarte de lo que entrega tu agente
Verás en directo cómo revisar y verificar lo que programan los agentes: pruebas en navegador con Playwright, casos Gherkin y adversarial review entre modelos, la misma idea que sostiene sol-loop y la puerta de merge de full send.
Entrar a la masterclass →Métodos en directo + casos Gherkin
¿Por qué el objetivo es que el hilo desaparezca? 
Porque Theo trata la barra lateral de T3 Code como una bandeja de entrada: cada hilo está trabajando o ya no está. Cuando un PR se mergea, el hilo se archiva solo. Hay una sección opcional de “trabajando” donde se esconden los hilos que no necesitan atención, y un hilo solo sale de ahí cuando pregunta algo con la herramienta de preguntas.
Con esa idea en la cabeza, full send tiene todo el sentido. Lo que quiere evitar es este escenario: has hablado con el agente, sabéis los dos qué hay que hacer, falta un detalle menor y luego pulsar merge. Si tienes que volver al hilo para eso, tienes que recordar todo el contexto otra vez solo para hacer clic en un botón. full send corta ahí. Una vez que confías en que el agente sabe lo que quieres, no te molesta salvo que se atasque.
Theo no lo plantea como “mergea lo que sea”. Lo plantea como optimizar para tener pocas cosas esperándote y hacer que mergear con confianza sea fácil. Ya tienes el comparativo de Orca, T3 Code y Paseo si quieres ver cómo organiza cada app esa bandeja.
¿En qué se diferencia full stop de full send? 
full stop hace todo el trabajo de full send y se para con el PR listo para que tú lo mergees. Nunca mergea, nunca activa auto-merge, nunca mete el PR en una merge queue y nunca empuja a la rama por defecto. Si el PR ya tenía auto-merge activado, lo desactiva antes de empezar y vuelve a comprobarlo antes de cada push.
Su SKILL.md es corto porque delega casi todo: lee la skill de full send, sigue su flujo, sus reglas de prueba, la revisión y la vigilancia, y sustituye el merge y el informe por una entrega. Al final deja el PR en uno de tres estados:
- Listo para mergear: pasa la puerta de merge y el PR sigue abierto.
- Esperando aprobación: solo falta una aprobación humana obligatoria, y el agente confirma que ese es el bloqueo real.
- Bloqueado: explica qué impide que esté listo, qué ha intentado y qué necesita.
Theo admite que la skill es “prácticamente slop” (bromea con llamarla full slop), porque se la escribió Claude a partir de full send. Y aun así se ha convertido en la que más usa. Cuenta que, al empezar un directo, le pasaron varios PR para revisar y a casi todos les respondió con “figure it out, full stop”. Otro caso: alguien le mandó por mensaje privado un bug y dos PR que lo arreglaban; copió el mensaje y escribió “friend sent this, triage and takeover, full stop”.
🔑 full send para cambios que podrías mergear con los ojos cerrados. full stop para los que quieres mirar una vez, pero solo cuando ya estén listos.
¿Cuándo usar takeover y modernize? 
takeover sirve para terminar el trabajo de otra persona (un PR, una rama o el hilo de otro agente) sin quitarle el crédito; modernize, para poner al día un PR viejo y decidir con honestidad si todavía debe existir. Son skills de mantenedor, y se nota.
takeover parte de una idea sana: no defiendas una implementación solo porque otro agente ya la construyó. Lee el PR original, las revisiones y las correcciones posteriores, trata ese material como contexto y no como prueba, y decide si continuar sobre ese código o usarlo como referencia. Si abre un PR de reemplazo, importa los commits originales a una rama nueva y añade sus arreglos aparte. Conserva la autoría de Git y los Co-authored-by, enlaza el PR original y, si el trabajo se va a hacer squash, mete el crédito humano en el commit de merge con identidades verificadas, no con emails inventados. La skill lo deja claro: la atribución al modelo no sustituye al crédito del contribuidor.
A Theo le importa mucho este punto. No quiere que nadie sienta que cierra su PR y le copia la idea; simplemente le sale más a cuenta que alguien de su equipo, que puede pulsar merge, lleve el cambio hasta el final.
modernize empieza con una frase que deberías pegar en la pared: moderniza la idea, no solo la rama. Un rebase limpio no demuestra que el PR siga teniendo sitio en el producto. Antes de tocar nada, revisa qué ha cambiado en main desde que el PR se separó y busca PRs que puedan haberlo reemplazado. Después elige una de tres salidas:
| Disposición | Cuándo | Qué hace |
|---|---|---|
| MODERNIZE | El objetivo sigue siendo útil y la implementación tiene buena forma | Rebasa, resuelve conflictos, ejecuta checks y actualiza la rama con --force-with-lease |
| REWORK | El objetivo vale, pero un rebase mecánico conservaría una implementación equivocada | Explica la reescritura mínima y se para |
| CLOSE | El PR está superado, obsoleto o ya no compensa su coste | Cita la evidencia y se para, sin cerrar el PR sin permiso |
Incluye un consejo que se olvida a menudo: compara la serie de commits antes y después del rebase con git range-diff para confirmar que no se ha perdido nada a propósito ni ha vuelto algo que ya estaba resuelto. Y otro que vale para cualquier código: la edad no es evidencia, y el esfuerzo invertido no es motivo para mantener vivo un PR.
Combinadas, las dos skills hacen cosas como esta, que Theo enseña en el vídeo: alguien enlazó un PR que arreglaba abrir el explorador de archivos en Windows. Theo escribió “take over and get this landed, full send”. El agente creó un PR nuevo, probó el arreglo (Theo cree que usó una máquina virtual con PowerShell), lo mergeó con el crédito al autor original y cerró el PR viejo. Theo no abrió el PR mergeado en ningún momento.
¿Qué hacen file-pr, babysit-pr y leaving-pr-comments? 
Son las tres piezas pequeñas sobre las que se apoyan las demás: cómo se escribe un PR, cómo se vigila y cómo comenta un agente en tu nombre. No tienen el brillo de full send, pero sin ellas el flujo no funciona.
file-pr pide un título que explique por qué importa el cambio y no qué técnica se ha usado. El ejemplo del propio SKILL.md es muy claro:
❌ perf(server): negotiate permessage-deflate on the websocket
✅ perf(server): cut websocket frame size by 70%+ with gzipping
La descripción empieza explicando el problema con palabras sencillas, a partir del prompt original, y no con un inventario de funciones borradas. Termina con una línea que dice qué modelo y qué harness hicieron el cambio, sin adivinar el modelo si el harness no lo expone. Y antes de enviarlo, revisa título, descripción y adjuntos en busca de secretos.
babysit-pr prohíbe al agente escribirse su propio bucle con sleep. En T3 Code usa watch_pull_request, que despierta al hilo cuando falla un check, se ponen en verde los obligatorios, alguien comenta o aparece un conflicto. En el resto de harnesses usa pr-wait, un script de Python incluido en la skill que imprime una línea por cada evento real y termina con códigos de salida claros:
# Espera a que el PR esté listo: checks en verde, revisión de bots y sin hilos abiertos
pr-wait 123 --until ready

# Solo checks obligatorios, para repos sin bots de revisión
pr-wait 123 --repo owner/name --until green
En Claude Code, la skill recomienda ejecutarlo con la herramienta Monitor, para que cada línea despierte al agente. La sección de revisiones repite la obsesión del repo: los bucles de revisión tienden a hacer crecer el PR un arreglo barato tras otro. Arregla los bugs reales del caso previsto y rechaza el resto (tests innecesarios, guardas para casos que no importan, compatibilidad extra) con un motivo escrito.
leaving-pr-comments es la que más fácil te resultará adoptar hoy mismo. Obliga a que todo comentario que un agente deje en tu nombre empiece con un aviso de GitHub:
> [!NOTE]
> 🤖 **<model> responding on behalf of <user>**

Actual comment starts here.
Y luego exige un estilo directo: la conclusión primero, cita del código o del check que lo respalda, nada de agradecimientos de plantilla y separar lo verificado de lo que es opinión.
Si te ha picado copiar las skills de otro y hacerlas tuyas, cada domingo compartimos 12 recursos sobre trabajar con agentes, y muchos los traen los propios suscriptores.
Suscríbete gratis →¿Cómo instalo tstack en Claude Code o Codex? 
Clonas el repo y copias las carpetas de skills/ al directorio de skills de tu agente. El README da los dos comandos:
git clone https://github.com/t3dotgg/tstack
cp -R tstack/skills/* ~/.claude/skills/   # Claude Code
cp -R tstack/skills/* ~/.codex/skills/    # Codex
Para Codex, varias skills traen además un agents/openai.yaml con nombre visible, descripción corta y un prompt por defecto. El de full send, por ejemplo, es “Use $full-send to take this to a merged PR. I am not watching this thread.”
Antes de lanzarte, tres consejos:
- No copies las nueve si no las vas a usar. Empieza por
leaving-pr-commentsyfile-pr, que no conceden permisos nuevos. Luegosol-loopocouncilsi tienes forma de ejecutar un modelo de otro proveedor. full send, al final. - Pon tus preferencias en
CLAUDE.mdoAGENTS.md, no en las skills. El README lo recomienda así: qué modelos forman tu council, por ejemplo. Así puedes actualizar las skills sin perder tus ajustes. - Lee full send entera antes de activarla. Revisa el permiso de pruebas, la frase sobre revisiones automáticas que piden revisión humana y el force push. Si tu equipo exige aprobación humana, la puerta de merge ya lo respeta; si no lo exige, decide tú si quieres que lo haga.
Si nunca has escrito una skill, el post sobre qué son las Agent Skills y en qué se diferencian de un prompt o un MCP te da la base para leer estos ficheros con criterio.
¿Qué límites tiene tstack? 
Está muy atado a GitHub y a la forma de trabajar de Theo. Todo el flujo depende de gh, de pull requests y de bots de revisión concretos: pr-wait sabe esperar a Greptile y Macroscope, trata a CodeRabbit como consultivo y salta los comentarios de github-actions y Vercel. Si tu equipo trabaja con GitLab o sin PRs, tendrás que reescribir media docena de secciones.
Otras cosas que conviene saber:
- sol-loop y council necesitan modelos de otros proveedores. Sin T3 Code ni un harness que pueda lanzarlos, tendrás que montar tú la ruta (proxy, plugin o subagente propio). La skill, con buen criterio, no cambia a otro modelo si no puede.
- full send presupone una red de seguridad que quizá no tienes. Theo publica una nightly cada seis horas y recibe feedback inmediato. Si tu despliegue tarda una semana en enseñarte un error, el riesgo de mergear sin mirar es otro.
- Las skills cambian rápido. El último commit del repo, del 24 de octubre de 2026, añade las notas de council a la descripción del PR. Lo que leas hoy puede no coincidir con lo que haya mañana.
- Theo avisa de que su versión personal se había hinchado a base de dejar que Claude la arreglara. La pública está limpia, pero el riesgo es el mismo para la tuya.
¿Qué skill de tstack necesito según lo que tengas entre manos? 
| Situación | Skill o combinación |
|---|---|
| Quieres una segunda opinión antes de abrir el PR | sol-loop |
| El cambio es delicado y quieres tres miradas distintas | council |
| Cambio pequeño, sabes lo que va a hacer y confías en la CI | full send |
| Cambio que quieres revisar tú, pero solo al final | full stop |
| Un PR de un contribuidor que no puedes mergear tal cual | takeover + full stop |
| Un PR de hace tres meses que no sabes si sigue teniendo sentido | modernize |
| Tu agente comenta en GitHub con tu cuenta | leaving-pr-comments |
Theo cierra el vídeo con una idea que va más allá de sus ficheros: no se trata de copiar sus markdown porque él sea muy listo, sino de ver cómo encuentra soluciones a sus problemas. Analiza qué haces una y otra vez, decide en qué confías al agente y en qué no, y escríbelo. Él lo llama convertirse en el mánager de uno mismo.
TL;DR 
- 🧰 tstack es el repo MIT con las nueve skills que Theo Browne usa a diario en Claude Code y Codex, centradas en llevar un PR de la idea al merge
- 🎯 Sus descripciones son disparadores (“Use when the user says ‘sol loop’”), así las skills no entran en el contexto sin que las pidas
- 🐕 sol-loop revisa con GPT Sol en un máximo de 3 rondas (5 si hay riesgo de seguridad o datos), clasifica en blocker/should/nit y pelea contra el crecimiento del PR
- 🚀 full send prueba, revisa, abre, vigila y mergea sin que mires: Theo cuenta 27 PR mergeados solos de 32 intentos
- ✋ full stop hace lo mismo y se para antes del merge; takeover y modernize completan el kit de mantenedor
Preguntas frecuentes 
¿Qué es tstack de Theo Browne? 
Es un repositorio público en GitHub (t3dotgg/tstack) con nueve skills de agente que Theo usa cada día: full-send, full-stop, sol-loop, council, file-pr, babysit-pr, takeover, modernize y leaving-pr-comments. Funcionan en Claude Code y Codex, y aprovechan funciones de T3 Code cuando están disponibles. Tiene licencia MIT.
¿Qué significa “sol loop”? 
Es un bucle de revisión en el que tu agente principal escribe el cambio y GPT Sol, de OpenAI, lo revisa. Por defecto son tres rondas, con un registro de hallazgos y tres severidades (blocker, should, nit). Termina cuando Sol aprueba, cuando un punto sigue en disputa tras dos respuestas o cuando se acaba el presupuesto.
¿Puedo usar sol-loop sin T3 Code? 
Sí, pero necesitas una forma de lanzar GPT Sol como subagente desde tu harness. En Codex es nativo. En Claude Code necesitas un subagente configurado para ejecutar Sol, por ejemplo a través de un proxy o de un plugin. Si no hay ruta, la skill avisa del bloqueo en vez de cambiar de modelo.
¿Es seguro dejar que un agente mergee sus propios PR con full send? 
Depende de tu red de seguridad. full send exige prueba observada de cada cambio, CI en verde, bots revisados, ninguna revisión humana bloqueando y rama al día, y nunca usa --admin. Aun así, Theo lo combina con versiones nightly cada seis horas para detectar fallos pronto. Si tu equipo no puede deshacer un error rápido, empieza por full stop.
¿Qué diferencia hay entre full send y full stop? 
full send lleva el cambio hasta el merge. full stop hace el mismo trabajo (probar, revisar, abrir el PR, vigilarlo y arreglar lo que salga) pero nunca mergea ni activa auto-merge. Te deja el PR listo, esperando aprobación o con un bloqueo explicado.
¿Por qué las descripciones de las skills de tstack son tan cortas? 
Porque Theo las usa como disparadores, no como descripciones. Una descripción del tipo “Use when the user says ‘full send’” impide que el modelo cargue la skill por su cuenta, algo importante en skills que conceden permisos como mergear o hacer force push.
¿Por qué Theo no usa disable-model-invocation para invocar las skills con barra? 
Porque prefiere activarlas con lenguaje natural y combinar varias en una frase (“take over, full send”). Además, algunos harnesses no permiten invocar varias skills a mano a la vez, y en Claude Code la invocación manual mete el prompt dos veces en el contexto, según cuenta en su vídeo.
¿Cómo conserva takeover el crédito del autor original? 
Importa los commits originales a una rama nueva, conserva la autoría de Git y los trailers de coautoría, enlaza el PR original en la descripción y, si se hace squash, mete el crédito humano en el commit de merge con identidades verificadas. La skill aclara que atribuir al modelo no sustituye al crédito del contribuidor.
¿Qué hace modernize con un PR antiguo? 
Revisa qué ha cambiado en la rama base desde que el PR se separó, busca PRs que puedan haberlo reemplazado y elige entre MODERNIZE (rebasar y actualizar), REWORK (explicar una reescritura mínima) o CLOSE (recomendar cerrarlo con evidencia). Nunca cierra ni mergea sin permiso.
¿Cómo instalo las skills de tstack? 
Clona https://github.com/t3dotgg/tstack y copia tstack/skills/* en ~/.claude/skills/ para Claude Code o en ~/.codex/skills/ para Codex. Necesitas gh autenticado y python3 para el script pr-wait. Instala también las skills de las que dependen las que uses.
Fuentes 
- tstack en GitHub: README, licencia y los SKILL.md de las nueve skills (consultado en el commit
7de017b, 24 de octubre de 2026) - T3 Code en GitHub: el harness en el que nacieron estas skills
- Vídeo de Theo Browne en su canal de YouTube @t3dotgg sobre sol loop, full send y full stop, fuente de las anécdotas, opiniones sobre modelos y el dato de 27 merges de 32
🧨 Última oprtunidad para recibir la dinamita que mereces sobre programación con IA el próximo domingo: Suscríbete gratis a Web Reactiva en https://webreactiva.com/newsletter
Escrito con la ayuda de la IA generativa de Claude, fuentes fidedignas y con un human in the loop:
Dani Primo.
12 recursos para developers cada domingo en tu bandeja de entrada
Además de una skill práctica bien explicada, trucos para mejorar tu futuro profesional y una pizquita de humor útil para el resto de la semana. Gratis.