Buenas prácticas para crear skills de agentes de IA
(actualizado )
Si estás creando skills para agentes de IA y no funcionan como esperabas, probablemente estés cayendo en errores que tienen solución.
Un skill no es un tutorial. Un skill no es documentación. Un skill es un mecanismo para transferir conocimiento experto a un modelo de IA. Y esa diferencia lo cambia todo.
En este artículo vas a encontrar los errores más comunes al diseñar skills y cómo evitarlos. Cada punto viene con su ejemplo malo y su versión corregida, con las razones detrás de cada decisión.
Lo que vas a llevarte:
- Por qué el campo
descriptiondecide si tu skill se activa o se queda en el cajón - Cómo estructurar en capas para no reventar el contexto del agente
- Qué frontmatter sobrevive fuera de Claude Code y cuál se queda por el camino
- Cómo evaluar una skill con un baseline en vez de con intuición
- Qué consejos de hace seis meses se han quedado desfasados (incluidos algunos de este mismo artículo)
Si todavía no tienes claro qué son los skills o cómo funcionan dentro de los agentes de IA, te recomiendo que empieces por Skills para programadores: saca todo el provecho de los agentes de IA. Si lo que quieres es situar la pieza frente a las demás, en Agent Skills: en qué se diferencian de los prompts, los MCP y los subagentes están las fronteras dibujadas. Y si necesitas decidir qué tipo de skill crear, Anthropic ha publicado una taxonomía de 9 categorías para organizar sus cientos de skills que funciona como mapa.
¿Qué ha cambiado en las skills desde principios de 2026? 
Este artículo se publicó en febrero. Medio año después, tres cosas han cambiado lo suficiente como para reescribirlo.
Las skills dejaron de ser cosa de Claude. El formato SKILL.md es ahora un estándar abierto que la documentación oficial de Claude Code reconoce de forma explícita: “las skills de Claude Code siguen el estándar abierto Agent Skills, que funciona en múltiples herramientas de IA”. La consecuencia práctica es que ahora tienes que decidir dónde va a vivir tu skill antes de escribir la primera línea de frontmatter, porque no todos los campos viajan.
Los comandos personalizados se fusionaron con las skills. Un fichero en .claude/commands/deploy.md y una skill en .claude/skills/deploy/SKILL.md crean el mismo /deploy y funcionan igual. Los .claude/commands/ antiguos siguen vivos, pero las skills añaden directorio de apoyo, control de invocación y carga automática.
La evaluación pasó de “buena idea” a parte del proceso. El skill-creator oficial de Anthropic ya no es un generador de plantillas: ejecuta cada caso de prueba dos veces —con skill y sin skill— y te enseña la diferencia en tasa de acierto, tiempo y tokens.
🔑 Si escribiste tus skills a principios de 2026 y no las has vuelto a tocar, lo más probable es que sigan funcionando. Y también que estén perdiendo la mitad del valor que podrían darte.
Preparado el terreno, vamos con las buenas prácticas.
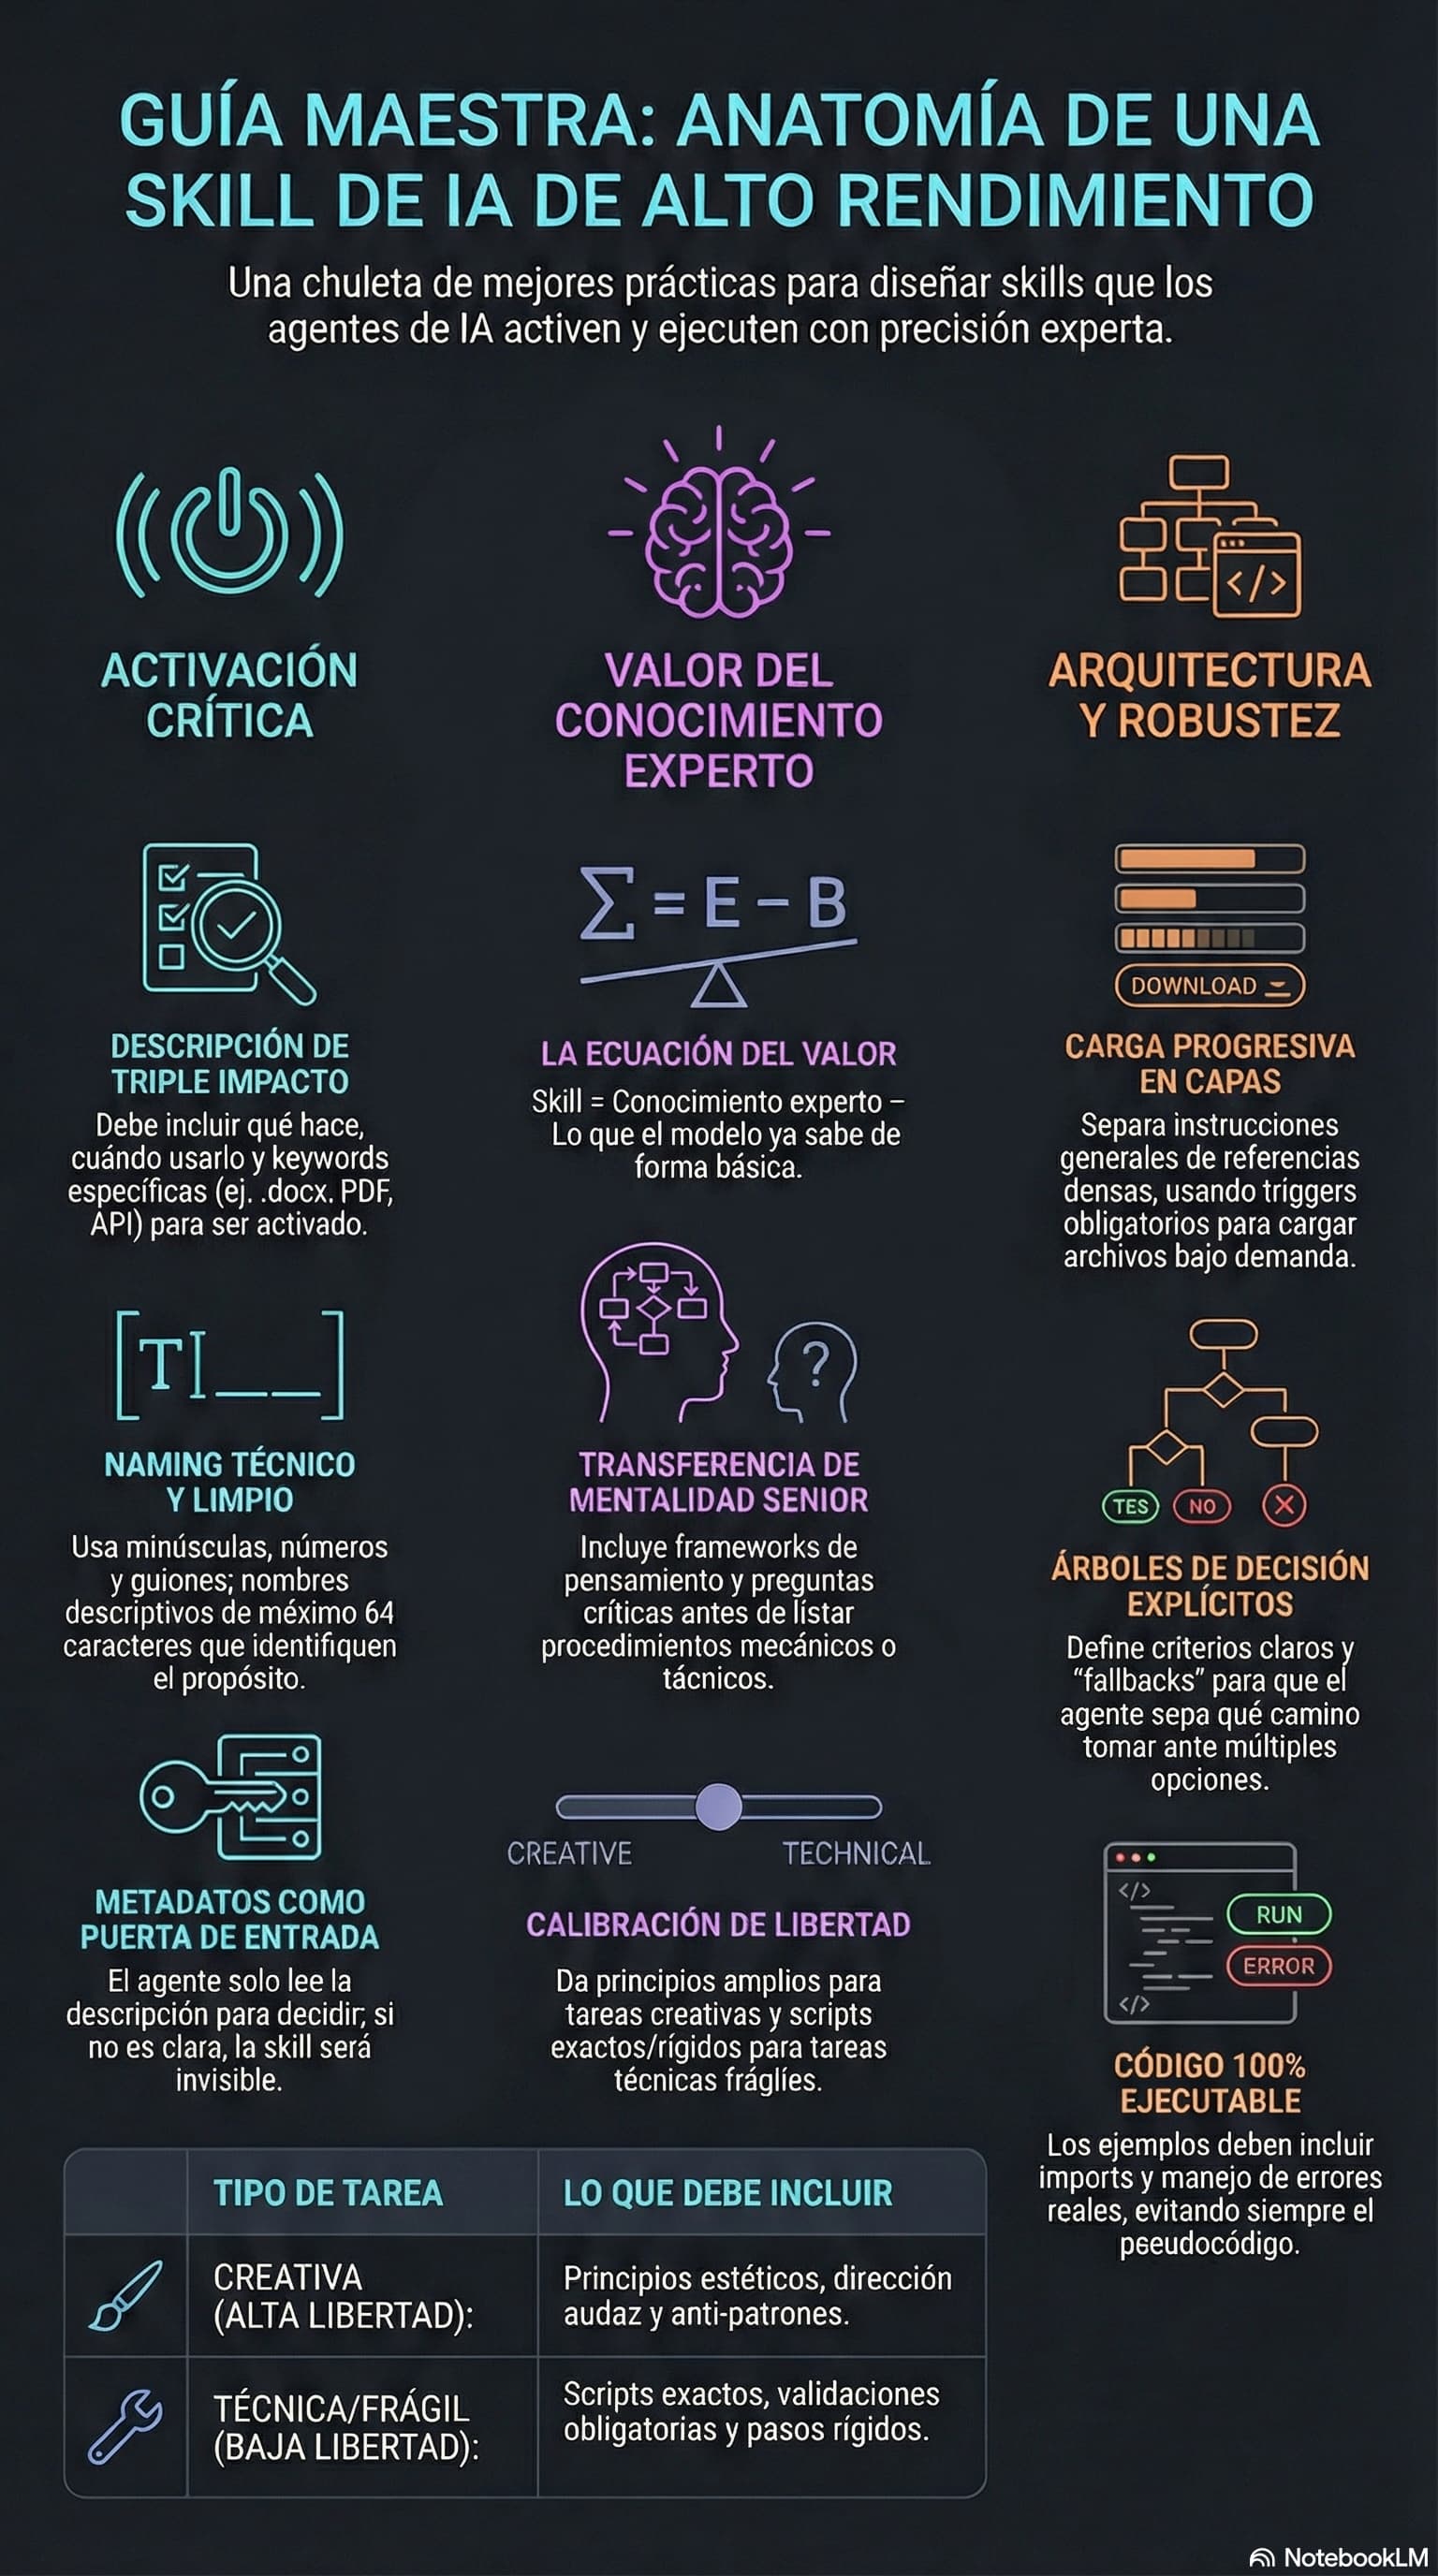
1. ¿Por qué el campo description decide si tu skill se llega a usar? 
Aquí es donde la mayoría de skills fracasan antes de empezar. Y no exagero.
El agente de IA tiene acceso a decenas o cientos de skills. Cuando recibe una petición del usuario, necesita decidir cuál activar. ¿Cómo lo hace? Leyendo las descripciones. Solo las descripciones. El cuerpo del skill no se carga hasta que la decisión ya está tomada.
Esto significa que puedes tener el mejor skill del mundo, con instrucciones perfectas y ejemplos brillantes. Si la descripción es vaga, el agente nunca lo activará.
🔑 La descripción es la puerta de entrada. Si está cerrada con llave y sin cartel, nadie va a llamar.
❌ Descripción que no funciona 
---
name: document-helper
description: Ayuda con tareas de documentos
---
¿Qué documentos? ¿Qué tareas? ¿Cuándo debería el agente usar esto? El modelo no tiene forma de saberlo.
🧨 Última oportunidad para recibir la dinamita que mereces sobre programación con IA el próximo domingo: Suscríbete gratis a Web Reactiva en https://webreactiva.com/newsletter
✅ Descripción que sí funciona 
---
name: docx-processing
description: Crea, edita y analiza archivos .docx con soporte para cambios registrados, comentarios y formato profesional. Usa este skill cuando trabajes con documentos de Word, necesites insertar tablas, aplicar estilos corporativos o exportar a PDF desde un .docx.
---
La diferencia está en tres elementos que toda descripción necesita:
Cada semana, experiencias y aprendizaje sobre desarrollo web e IA en tu bandeja de entrada.
Únete a más de 7.200 developers que ya reciben la newsletter.
Suscríbete gratis →- QUÉ hace: crear, editar, analizar archivos .docx
- CUÁNDO usarlo: cuando trabajes con documentos de Word, tablas, estilos
- PALABRAS CLAVE: .docx, Word, PDF, tablas, estilos corporativos
El agente necesita keywords para hacer match con la petición del usuario. Si el usuario dice “hazme un informe en Word”, el agente busca skills que mencionen “Word” o “.docx” en su descripción. Sin esas palabras clave, tu skill es invisible.
Escribe en tercera persona (esto no estaba antes) 
La documentación oficial lo marca como aviso: la descripción se inyecta en el prompt de sistema, y mezclar puntos de vista provoca problemas de descubrimiento.
# ✅ Tercera persona
description: Procesa ficheros de Excel y genera informes.

# ❌ Primera persona
description: Puedo ayudarte a procesar ficheros de Excel.

# ❌ Segunda persona
description: Usa esto para procesar ficheros de Excel.
Sé un poco pesado, porque el modelo tiende a no activarlas 
Este es el hallazgo más útil de todo el material nuevo. El skill-creator de Anthropic lo dice sin rodeos: Claude tiende a “infra-activar” las skills, es decir, a no usarlas cuando serían útiles. Y su recomendación para combatirlo es escribir descripciones un poco “insistentes”.
# ❌ Descripción tímida
description: Cómo construir un dashboard rápido para datos internos.

# ✅ Descripción insistente
description: Cómo construir un dashboard rápido para datos internos. Asegúrate de usar esta skill siempre que el usuario mencione dashboards, visualización de datos, métricas internas o quiera mostrar cualquier tipo de dato de la empresa, aunque no pida explícitamente un "dashboard".
Hay un segundo motivo por el que tu skill puede no dispararse, y no tiene nada que ver con la redacción: el agente solo consulta skills para tareas que no puede resolver por su cuenta. Una petición simple de un paso —“lee este PDF”— puede no activar nada aunque la descripción encaje al milímetro, porque el modelo lo resuelve con sus herramientas básicas. Las peticiones complejas, multi-paso o especializadas sí activan skills de forma fiable.
💡 Si tu skill no se dispara, antes de reescribir la descripción pregúntate si la tarea de prueba era lo bastante difícil como para que al agente le compensara buscar ayuda.
Los límites que conviene tener a mano 
| Campo | Límite | Dónde aplica |
|---|---|---|
name |
64 caracteres, minúsculas, números y guiones | Estándar y Claude Code |
name |
No puede contener “anthropic” ni “claude” | Palabras reservadas |
description |
1.024 caracteres | Spec de Agent Skills y API |
description + when_to_use |
1.536 caracteres antes de truncar | Listado de skills de Claude Code |
Ese truncado del listado tiene una consecuencia directa: pon el caso de uso principal al principio. Lo que se corta es la cola.
Más ejemplos de descripciones problemáticas 
# ❌ Demasiado genérica
description: Un skill útil para varias tareas

# ❌ Solo dice qué, no cuándo
description: Procesa archivos PDF

# ❌ Usa jerga interna que el modelo no entiende
description: Gestiona el workflow de Q3 reports
Y sus versiones corregidas:
# ✅ Específica y con triggers
description: Extrae texto y tablas de archivos PDF, rellena formularios y combina múltiples documentos. Usa cuando el usuario mencione PDFs, extracción de datos o fusión de documentos.

# ✅ Incluye escenarios concretos
description: Genera presentaciones en formato .pptx con diseño profesional. Activa este skill cuando el usuario pida crear slides, presentaciones, pitch decks o material para reuniones.
2. ¿Qué no debes contarle al modelo porque ya lo sabe? 
Este es el error más común y el más costoso. Literalmente costoso, porque cada token que usas explicando cosas básicas es un token que no puedes usar para conocimiento experto.
Claude ya sabe qué es un PDF. Ya sabe cómo funciona Python. Ya conoce los patrones de programación estándar. Cuando tu skill dedica párrafos a explicar estos conceptos, estás comprimiendo conocimiento que el modelo ya tiene.
La fórmula es simple:
Buen Skill = Conocimiento experto − Lo que Claude ya sabe
La documentación oficial lo formula como una suposición por defecto: Claude ya es muy listo. Y propone tres preguntas para cada bloque que escribas:
- ¿De verdad necesita Claude esta explicación?
- ¿Puedo asumir que Claude ya lo sabe?
- ¿Este párrafo justifica su coste en tokens?
❌ Skill que explica lo obvio 
## Qué es un archivo PDF

PDF significa Portable Document Format. Es un formato de archivo desarrollado
por Adobe que preserva el formato del documento independientemente del software,
hardware o sistema operativo utilizado para visualizarlo.

## Cómo abrir un archivo en Python

Para abrir un archivo en Python, usamos la función open():

file = open('documento.pdf', 'rb')
content = file.read()
file.close()
Todo esto Claude lo sabe. Cada línea es espacio desperdiciado.
✅ Skill que aporta conocimiento experto 
## Decisiones críticas en extracción de PDF

| Situación     | Herramienta primaria | Fallback      | Cuándo usar fallback                 |
| ------------- | -------------------- | ------------- | ------------------------------------ |
| Texto simple  | pdftotext            | PyMuPDF       | Cuando necesites info de layout      |
| Tablas        | camelot-py           | tabula-py     | Cuando camelot falle con bordes      |
| PDF escaneado | -                    | Tesseract OCR | Siempre que pdftotext devuelva vacío |

### Problemas comunes y soluciones

- **PDF escaneado detectado como texto**: Si pdftotext devuelve cadena vacía pero
  el PDF tiene contenido visible, aplica OCR primero.
- **Tablas fragmentadas**: camelot funciona mejor con tablas de bordes definidos.
  Para tablas sin bordes visibles, usa tabula con stream=True.
La diferencia es brutal. El segundo ejemplo transfiere conocimiento que solo alguien con experiencia en procesamiento de PDFs tendría. Son decisiones, trade-offs, casos límite. Cosas que no están en la documentación básica de ninguna librería.
Hay un corolario que casi nadie aplica: no ofrezcas cinco alternativas. “Puedes usar pypdf, o pdfplumber, o PyMuPDF, o pdf2image…” no es generosidad, es indecisión trasladada al agente. Da un valor por defecto y una salida de emergencia: “usa pdfplumber; para PDFs escaneados que necesiten OCR, usa pdf2image con pytesseract”.
💡 Antes de escribir cada sección de tu skill, pregúntate: “¿Claude ya sabe esto?” Si la respuesta es sí, bórralo.
3. ¿Cómo se transfiere mentalidad y no solo procedimientos? 
La diferencia entre un junior y un senior no está en saber “cómo hacer las cosas”. Está en saber “cómo pensar sobre los problemas”.
Un skill que solo lista pasos mecánicos pierde la oportunidad de transferir esa forma de pensar. Y eso es lo que realmente hace valioso a un experto.
❌ Procedimiento mecánico 
## Pasos para crear un documento

1. Abre el archivo de plantilla
2. Modifica el título
3. Añade el contenido
4. Guarda el archivo
5. Verifica que se guardó correctamente
Esto no aporta nada. Claude sabe abrir archivos y guardarlos.
✅ Framework de pensamiento + procedimiento específico 
## Antes de crear cualquier documento, pregúntate:

- **Propósito**: ¿Qué problema resuelve este documento? ¿Quién lo va a leer?
- **Restricciones**: ¿Hay requisitos de formato corporativo? ¿Límite de páginas?
- **Diferenciación**: ¿Qué hace memorable este documento frente a otros similares?

## Workflow específico para OOXML (esto Claude no lo sabe)

1. Descomprime el .docx (es un ZIP): `unzip documento.docx -d temp/`
2. Localiza el contenido en `temp/word/document.xml`
3. Edita el XML respetando namespaces (critical: no borres xmlns)
4. Valida la estructura ANTES de reempaquetar
5. Reempaqueta: `zip -r documento_editado.docx temp/*`
6. Verifica abriendo en Word (el validador interno es más estricto)
El framework de pensamiento cambia cómo el modelo aborda el problema. El procedimiento específico de OOXML es conocimiento que Claude probablemente no tiene, porque no está en tutoriales básicos.
Hay que distinguir entre tres tipos de procedimientos:
- Genéricos: abrir, leer, escribir, guardar. Claude los sabe. Bórralos.
- Específicos de dominio: workflow OOXML, secuencias de validación, orden crítico de operaciones. Estos sí aportan.
- Frameworks de pensamiento: preguntas que hacerse antes de actuar. Cambian el enfoque del modelo.
4. ¿Sigue valiendo oro la lista de “NUNCA hagas esto”? 
Sí, pero con un matiz que en febrero no estaba y que me obliga a corregir lo que escribí aquí.
Empecemos por lo que no ha cambiado. La mitad del conocimiento experto es saber qué NO hacer. Un diseñador senior ve un gradiente morado sobre fondo blanco y le rechinan los dientes. Sabe que eso grita “generado por IA”. Esa intuición viene de haber cometido errores y haberlos visto en otros. Claude no ha cometido esos errores, así que necesita que se lo digamos.
❌ Advertencias vagas 
## Consideraciones

- Evita cometer errores
- Ten cuidado con los casos límite
- Considera las mejores prácticas
Esto no dice nada. Es ruido.
✅ Anti-patrones específicos con razones 
## Qué evitar en tipografía y color, y por qué

- **Fuentes genéricas de IA** (Inter, Roboto, Arial) → Delatan origen automatizado.
  Usa fuentes con personalidad: IBM Plex, Source Serif, JetBrains Mono.

- **border-radius por defecto en todo** → Es el sello de UI perezosa. Decide
  conscientemente: bordes duros para seriedad, redondeados suaves para amabilidad,
  muy redondeados solo para elementos pill/tag.

- **Más de 2 familias tipográficas** → Crea caos visual. Una para títulos, otra
  para cuerpo. Ese límite existe porque la tercera familia ya no aporta jerarquía,
  solo ruido.

- **Gradientes morados sobre blanco** → Es el cliché visual de "esto lo hizo una
  IA". Si necesitas gradientes, usa tonos de un mismo color.
El matiz nuevo: cuidado con gritar 
La versión de febrero de este artículo recomendaba una sección titulada “NUNCA hagas esto” con mayúsculas. El skill-creator oficial de Anthropic ahora dice lo contrario, y lo dice bastante claro: si te descubres escribiendo ALWAYS o NEVER en mayúsculas, o montando estructuras rígidas, eso es una bandera amarilla. La recomendación es reformular y explicar el razonamiento para que el modelo entienda por qué eso importa. En sus palabras, es un enfoque “más humano, más potente y más efectivo”.
La lógica detrás del cambio: los modelos de hoy tienen buena teoría de la mente. Con un buen contexto van más allá de las instrucciones mecánicas. Un MUST en mayúsculas le dice al modelo qué hacer; una explicación le dice cuándo esa regla aplica y cuándo no, que es justo lo que necesita cuando se encuentra un caso que no previste.
| Enfoque | Qué transmite | Cuándo se rompe |
|---|---|---|
NUNCA uses X |
Una prohibición | En el caso límite que no anticipaste |
Evita X porque produce Y |
Un criterio | Casi nunca: el modelo generaliza |
Así que la práctica sigue en pie —lista lo que hay que evitar, siempre con su razón— pero baja el volumen. Los anti-patrones son valiosos por la razón que llevan detrás, no por las mayúsculas.
Un ejemplo excelente de este enfoque son las skills de Impeccable, que empaquetan anti-patrones de diseño en 23 comandos y 60 reglas deterministas para que tu agente deje de generar interfaces genéricas. Otro caso interesante es el checklist de revisión de gstack, con más de 200 líneas de patrones concretos y una sección de supresiones para evitar falsos positivos. Y si buscas el referente más completo de este patrón, las agent-skills de Addy Osmani incluyen tablas de anti-racionalizaciones en cada una de sus 19 skills: excusas documentadas que el agente usa para saltarse pasos, con la réplica que le obliga a seguir el proceso.
⚠️ Si tu skill no tiene una sección de “qué evitar”, probablemente le falta la mitad del conocimiento experto. Si esa sección está toda en mayúsculas, probablemente le falta la explicación.
5. ¿Cómo estructurar la skill en capas sin que el agente se pierda? 
Un skill no debería cargar toda su información de golpe. El contexto del agente es un recurso compartido entre el sistema, la conversación, otros skills y la petición del usuario. Cada token cuenta.
La estructura ideal tiene tres capas, y ahora conocemos su coste exacto:
| Capa | Cuándo se carga | Coste | Contenido |
|---|---|---|---|
| Metadatos | Siempre, al arrancar | ~100 tokens por skill | name y description |
| Instrucciones | Al activarse la skill | Menos de 5k tokens | El cuerpo de SKILL.md |
| Recursos | Bajo demanda | Cero hasta que se leen | scripts/, references/, assets/ |
Esa tercera fila es la que la gente desaprovecha. Los ficheros empaquetados no consumen contexto hasta que se leen, y los scripts se ejecutan por bash sin que su código entre en contexto: solo entra su salida. No hay límite práctico al material que puedes empaquetar.
La primera fila, en cambio, sí se paga siempre y se acumula. Si quieres el número real de tu carpeta, en el análisis de un repo con 163 skills y su contrato en CI hay un script de veinte líneas que suma los description de todas tus skills instaladas.
❌ Todo en un solo archivo 
mi-skill/
└── SKILL.md  (800 líneas con todo incluido)
Esto fuerza al agente a cargar 800 líneas cada vez que activa el skill, aunque solo necesite una parte.
✅ Estructura con carga progresiva 
mi-skill/
├── SKILL.md           (150 líneas: routing y decisiones)
├── references/
│   ├── api-details.md (documentación técnica detallada)
│   └── examples.md    (ejemplos extensos)
└── scripts/
    └── process.py     (script ejecutable)
El límite recomendado sigue siendo el mismo: por debajo de 500 líneas en SKILL.md. Si te acercas, añade un nivel de jerarquía con punteros claros hacia dónde debe ir el modelo después.
Pero no basta con separar los archivos. Necesitas decirle al agente CUÁNDO cargar cada uno. Un ejemplo bien resuelto de este patrón es Visual Explainer, que mantiene un SKILL.md ligero con el workflow principal y delega CSS, librerías, plantillas y patrones de slides a archivos references/ que el agente solo lee cuando la tarea concreta lo necesita.
❌ Referencias listadas sin triggers 
## Referencias

- api-details.md - para detalles de la API
- examples.md - para ver ejemplos
El agente no sabe cuándo cargar estos archivos. Probablemente nunca lo haga.
✅ Triggers de carga integrados en el workflow 
## Crear documento nuevo

Antes de continuar, lee [`references/docx-structure.md`](references/docx-structure.md)
(~300 líneas) de principio a fin: contiene la estructura de nodos que necesitas para
que Word no rechace el fichero. No leas rangos parciales, el orden de los nodos importa.

No hace falta que cargues `references/redlining.md` ni `references/forms.md` para
esta tarea: cubren flujos distintos.

## Editar documento existente con cambios registrados

Lee [`references/redlining.md`](references/redlining.md) antes de modificar nada.
El marcado de cambios registrados se corrompe si tocas el XML sin conocer su formato.
Fíjate en que la versión buena hace tres cosas: dice qué leer, dice qué no leer, y explica por qué. Esa última parte es la que sobrevive cuando el modelo se encuentra un caso raro.
Nunca anides referencias a más de un nivel 
Esto es nuevo en la documentación y explica un fallo muy difícil de diagnosticar. Cuando un fichero de referencia apunta a otro, Claude tiende a leerlo de forma parcial: usa comandos como head -100 para echar un vistazo en lugar de leerlo entero. Resultado: información incompleta y comportamiento errático.
# ❌ Demasiado profundo
SKILL.md → advanced.md → details.md → aquí está la información de verdad

# ✅ Un solo nivel
SKILL.md → advanced.md
SKILL.md → reference.md
SKILL.md → examples.md
Todos los ficheros de referencia deben enlazarse directamente desde SKILL.md.
Y para ficheros de referencia largos —a partir de unas 100 líneas— pon un índice al principio. Así, aunque el agente haga una lectura parcial, ve el alcance completo de lo que hay dentro y puede decidir si necesita leer más.
6. ¿Cuánta libertad darle al modelo según la fragilidad de la tarea? 
No todas las tareas necesitan el mismo nivel de detalle en las instrucciones. Una tarea creativa se beneficia de principios amplios. Una tarea técnica delicada necesita pasos exactos.
La documentación oficial usa una analogía que se queda grabada: piensa en el modelo como un robot recorriendo un camino. Si es un puente estrecho con precipicios a los lados, hay una sola forma segura de avanzar y necesitas barandillas exactas. Si es un campo abierto sin peligros, muchos caminos llevan al destino y basta con dar la dirección.
❌ Libertad mal calibrada 
## Diseño de interfaz (tarea creativa)

1. Abre Figma
2. Crea un frame de 1920x1080
3. Añade un rectángulo de 200x50 para el botón
4. Usa color #3B82F6 para el fondo
5. Añade texto "Enviar" centrado
Esto es demasiado rígido para una tarea creativa. No deja espacio para diferenciación.
## Edición de archivos XLSX (tarea frágil)

Modifica las celdas según sea necesario. Ten cuidado con los formatos.
Esto es demasiado vago para una tarea donde un error corrompe el archivo.
✅ Libertad calibrada correctamente 
## Diseño de interfaz (alta libertad)

Comprométete con una dirección estética AUDAZ. Elige un extremo:
minimalismo brutal, caos maximalista, retro-futurista, orgánico natural...

Principios a mantener:
- Jerarquía visual clara (qué ve primero el usuario)
- Contraste suficiente para legibilidad
- Consistencia interna (si empiezas rounded, mantén rounded)

Lo que hay que evitar: un diseño genérico que podría ser de cualquier web SaaS.
## Edición de archivos XLSX (baja libertad)

Ejecuta exactamente este script: `scripts/edit-xlsx.py`

Parámetros obligatorios:
- `--input`: archivo original
- `--output`: archivo destino (no sobrescribas el original: si el script falla
  a mitad, pierdes los datos de partida y no hay vuelta atrás)
- `--changes`: JSON con modificaciones

No modifiques el script. Otras skills dependen de su salida y un cambio aquí
rompe flujos que no ves. Si necesitas funcionalidad adicional, crea uno nuevo
basado en este.

Después de cada edición:
1. Abre el archivo en Excel/LibreCalc
2. Verifica que las fórmulas recalculan
3. Comprueba que no hay #REF! ni #VALUE!
La tarea creativa recibe principios y anti-patrones. La tarea frágil recibe scripts exactos y verificaciones obligatorias. Y en ambos casos, las restricciones vienen con su motivo.
Un caso intermedio que la documentación llama “libertad media”: pseudocódigo o scripts con parámetros, cuando existe un patrón preferido pero cierta variación es aceptable.
7. ¿Cómo eliminar la ambigüedad con árboles de decisión? 
Cuando una tarea tiene varios caminos posibles, el modelo necesita saber cómo elegir. Un simple “usa la herramienta apropiada” no sirve. Necesita criterios concretos.
❌ Guía vaga 
## Procesamiento de imágenes

Usa la herramienta más apropiada para cada caso. Considera el formato
de entrada y la salida deseada.
✅ Árbol de decisión explícito 
## Procesamiento de imágenes: árbol de decisión

```
¿La imagen es vectorial (SVG)?
├── SÍ → Usa Inkscape CLI para transformaciones
│        `inkscape --export-type=png input.svg`
└── NO → ¿Necesitas preservar transparencia?
         ├── SÍ → Usa PNG como formato intermedio
         │        ImageMagick: `convert input.jpg -alpha set output.png`
         └── NO → ¿Es fotografía o ilustración?
                  ├── Fotografía → JPEG con calidad 85
                  │                `convert input.png -quality 85 output.jpg`
                  └── Ilustración → PNG-8 con paleta reducida
                                    `pngquant --quality=65-80 input.png`
```

### Fallbacks para cuando falla el camino principal

| Operación        | Herramienta primaria | Fallback    | Señal para cambiar         |
| ---------------- | -------------------- | ----------- | -------------------------- |
| Redimensionar    | ImageMagick          | PIL/Pillow  | ImageMagick no instalado   |
| Comprimir PNG    | pngquant             | optipng     | pngquant produce artifacts |
| Convertir a WebP | cwebp                | ImageMagick | cwebp no soporta animación |
El árbol de decisión elimina la ambigüedad. El modelo sabe exactamente qué preguntas hacerse y qué camino tomar según las respuestas.
Para flujos con muchos pasos hay un patrón que funciona todavía mejor: el checklist copiable. Le pides al agente que copie una lista de tareas en su respuesta y la vaya marcando conforme avanza.
## Workflow de relleno de formularios

Copia este checklist y ve marcando lo que completes:

Task Progress:
- [ ] Paso 1: Analizar el formulario (ejecuta analyze_form.py)
- [ ] Paso 2: Crear el mapeo de campos (edita fields.json)
- [ ] Paso 3: Validar el mapeo (ejecuta validate_fields.py)
- [ ] Paso 4: Rellenar el formulario (ejecuta fill_form.py)
- [ ] Paso 5: Verificar la salida (ejecuta verify_output.py)
El checklist evita que el agente se salte pasos de validación, que es exactamente lo que hace cuando cree que va bien encaminado.
8. ¿Por qué tus ejemplos tienen que ser ejecutables? 
Parece obvio, pero muchos skills incluyen pseudocódigo o ejemplos incompletos que el modelo no puede ejecutar directamente.
❌ Ejemplo incompleto 
# Procesa el archivo
result = process(input_file)
# Guarda el resultado
save(result)
¿Qué es process? ¿De dónde viene save? El modelo tiene que inventar estas funciones.
✅ Ejemplo ejecutable 
import json
from pathlib import Path

def extract_metadata(pdf_path: str) -> dict:
    """
    Extrae metadatos de un PDF usando PyMuPDF.
    Retorna dict con título, autor, fecha de creación.
    """
    import fitz  # PyMuPDF

    doc = fitz.open(pdf_path)
    metadata = doc.metadata
    page_count = doc.page_count
    doc.close()

    return {
        "title": metadata.get("title", "Sin título"),
        "author": metadata.get("author", "Desconocido"),
        "created": metadata.get("creationDate", ""),
        "pages": page_count
    }

# Uso
if __name__ == "__main__":
    result = extract_metadata("documento.pdf")
    print(json.dumps(result, indent=2, ensure_ascii=False))
El ejemplo incluye imports, manejo de casos donde faltan datos, y un bloque de uso directo. El modelo puede copiarlo y adaptarlo sin tener que adivinar piezas faltantes.
Empaqueta el script en vez de dejar que lo reinvente 
Aquí hay una señal que casi nadie mira y que el skill-creator oficial señala como oro: si al probar tu skill ves que en todas las ejecuciones el agente acaba escribiendo un helper parecido —un create_docx.py, un build_chart.py—, eso es la skill pidiéndote a gritos que empaquetes ese script.
Escríbelo una vez, ponlo en scripts/ y dile a la skill que lo use. Las ventajas son cuatro y todas medibles:
- Más fiable que el código generado sobre la marcha
- Ahorra tokens: el código no entra en contexto, solo su salida
- Ahorra tiempo: no hay que generarlo
- Garantiza consistencia entre invocaciones
Y cuando escribas esos scripts, resuelve en lugar de delegar. Un script que revienta con FileNotFoundError y deja que el agente improvise es peor que uno que crea el fichero con contenido por defecto y sigue. Lo mismo con las constantes mágicas: si pones TIMEOUT = 47 sin explicar de dónde sale ese 47, ¿cómo va a saber el modelo si puede cambiarlo?
🛠️ Cada ejemplo de código en tu skill debería poder ejecutarse sin modificaciones. Si no es así, es pseudocódigo disfrazado.
9. ¿Cómo anticipar los errores antes de que ocurran? 
Un skill robusto anticipa qué puede salir mal y proporciona soluciones. No espera a que el modelo se quede atascado.
❌ Sin manejo de errores 
## Extracción de texto

Ejecuta pdftotext sobre el archivo y procesa el resultado.
¿Y si el PDF está encriptado? ¿Y si está escaneado? ¿Y si el archivo está corrupto?
✅ Con anticipación de problemas 
## Extracción de texto: problemas comunes

### PDF devuelve texto vacío
- **Causa probable**: PDF escaneado (imágenes, no texto)
- **Solución**: Aplica OCR primero con Tesseract
  ```bash
  pdftoppm -png documento.pdf temp
  tesseract temp-1.png output -l spa
  ```

### Error de permisos
- **Causa probable**: PDF encriptado o con restricciones
- **Solución**: Usa PyMuPDF con contraseña si la conoces
  ```python
  doc = fitz.open("documento.pdf")
  if doc.needs_pass:
      doc.authenticate("contraseña")
  ```
- **Si no hay contraseña**: Informa al usuario que el PDF tiene restricciones

### Texto extraído con caracteres raros
- **Causa probable**: Encoding incorrecto o fuentes embebidas no estándar
- **Solución**: Prueba con diferentes backends
  1. Primero pdftotext (más rápido)
  2. Si falla, PyMuPDF (mejor con fuentes raras)
  3. Último recurso: OCR sobre renderizado
Hay una vuelta de tuerca para operaciones destructivas o por lotes: el patrón planifica, valida, ejecuta. En vez de dejar que el agente aplique 50 cambios de golpe, le pides que escriba primero un fichero de plan (changes.json), lo valide con un script, y solo entonces ejecute.
Los errores se detectan antes de tocar nada, la verificación es objetiva porque la hace un script, y el agente puede iterar sobre el plan sin riesgo. Un consejo para los validadores: que sean verbosos. “Campo ‘signature_date’ no encontrado. Campos disponibles: customer_name, order_total, signature_date_signed” le da al modelo todo lo que necesita para arreglarlo solo.
10. ¿Cómo se nombra una skill y por qué ahora gana el gerundio? 
No importa tanto como la descripción, pero un nombre claro ayuda a identificar el propósito del skill de un vistazo. Y aquí hay un cambio de recomendación respecto a lo que decía este artículo en febrero.
La documentación oficial ahora sugiere gerundios en inglés (verbo + -ing), porque describen con más claridad la actividad que la skill aporta.
❌ Nombres problemáticos 
name: helper          # Demasiado genérico
name: MyAwesomeTool   # Mayúsculas no permitidas
name: doc_processor   # Guiones bajos no permitidos
name: -pdf-tool       # No puede empezar con guión
name: claude-tools    # Palabra reservada
✅ Nombres recomendados 
# Gerundio: la forma preferida
name: processing-pdfs
name: analyzing-spreadsheets
name: writing-documentation

# Sintagma nominal: aceptable
name: pdf-processing
name: spreadsheet-analysis

# Orientado a acción: aceptable
name: process-pdfs
Las reglas siguen siendo simples: minúsculas, números y guiones, máximo 64 caracteres, sin guiones al principio o al final. Lo nuevo es que anthropic y claude son palabras reservadas y no pueden aparecer en el nombre.
Un detalle que sorprende a mucha gente en Claude Code: en una skill personal o de proyecto, el campo name solo controla la etiqueta que se ve en los listados. El comando que escribes viene del nombre del directorio. En una skill de plugin sí que name cambia el último segmento del comando.
11. ¿Qué frontmatter sobrevive fuera de Claude Code? 
Esta práctica no existía en la versión anterior porque el problema tampoco existía. Ahora que SKILL.md es un estándar abierto que leen varias herramientas, la pregunta “¿dónde va a vivir esta skill?” tiene consecuencias.
El estándar define seis campos portables:
| Campo | Para qué sirve |
|---|---|
name |
Identificador de la skill |
description |
Qué hace y cuándo usarla |
license |
Licencia que cubre la skill |
compatibility |
Requisitos del entorno, hasta 500 caracteres |
metadata |
Mapa libre de datos propios, para tu tooling |
allowed-tools |
Herramientas preaprobadas |
Claude Code acepta esos seis y añade unos cuantos más que solo funcionan ahí. Si subes a claude.ai o a la Skills API una skill con campos extra, te encuentras un error del tipo Unexpected key(s) in SKILL.md frontmatter: argument-hint.
Estas son las extensiones que más rendimiento dan dentro de Claude Code:
disable-model-invocation: true→ solo tú puedes invocar la skill con/nombre. Imprescindible para flujos con efectos secundarios:/commit,/deploy,/send-slack-message. No quieres que el agente decida desplegar porque el código “parece listo”.allowed-tools→ herramientas que el agente puede usar sin pedirte permiso durante el turno que invoca la skill. El permiso se limpia en tu siguiente mensaje.disallowed-tools→ lo contrario: herramientas que desaparecen del catálogo mientras la skill está activa. Útil para skills autónomas que nunca deberían preguntarte nada.paths→ patrones glob que limitan cuándo se activa la skill. La skill de tests de la API solo se carga cuando tocas ficheros de la API.context: fork→ ejecuta la skill en un subagente aislado, sin tu historial de conversación. Desde julio de 2026 corre en segundo plano por defecto;background: falseespera el resultado en el mismo turno.modelyeffort→ cambian modelo o nivel de esfuerzo mientras la skill está activa.
⚠️
context: forksolo tiene sentido en skills con instrucciones ejecutables. Si tu skill contiene directrices del tipo “usa estas convenciones de API” sin una tarea concreta, el subagente recibe las directrices, no tiene nada que hacer y vuelve con las manos vacías.
Hay un aviso de seguridad que conviene leer dos veces: el campo allowed-tools no depende de que confíes en el workspace. Una skill de proyecto aplica su allowed-tools en cuanto se invoca, incluso en una carpeta que nunca has marcado como confiable. Una skill puede concederse a sí misma acceso amplio a herramientas, así que revisa el allowed-tools de las skills que vengan en un repositorio antes de ejecutar tu agente allí. Si quieres automatizar esa revisión, SkillSpector escanea skills en busca de patrones peligrosos.
12. ¿Cómo evitas que tu skill envejezca mal? 
Tres hábitos que separan una skill que aguanta un año de otra que hay que reescribir en marzo.
No metas información con fecha de caducidad 
# ❌ Caduca solo
Si estás haciendo esto antes de agosto de 2026, usa la API antigua.
Después de agosto de 2026, usa la nueva.

# ✅ Sección de patrones antiguos
## Método actual
Usa el endpoint v2: `api.example.com/v2/messages`

## Patrones antiguos
<details>
<summary>API v1 (obsoleta desde 2026-08)</summary>
La v1 usaba `api.example.com/v1/messages`. Ya no está soportada.
</details>
El contexto histórico va en una sección plegable. Así ni ensucia ni desaparece.
Usa la misma palabra para la misma cosa 
Suena a manía de correctora de estilo y es rendimiento puro. Si en tu skill alternas “endpoint”, “URL”, “ruta de API” y “path” para hablar de lo mismo, el modelo tiene que resolver esa ambigüedad en cada lectura.
Elige un término y mantenlo: siempre “campo”, nunca “campo” y “caja” y “elemento”. Siempre “extraer”, nunca “extraer” y “sacar” y “obtener”.
Escribe instrucciones permanentes, no pasos de usar y tirar 
Este detalle es específico de Claude Code y explica muchos comportamientos raros. Cuando se invoca una skill, el contenido renderizado de SKILL.md entra en la conversación como un único mensaje y se queda ahí el resto de la sesión. Claude Code no vuelve a leer el fichero en turnos posteriores.
La consecuencia práctica: si algo tiene que aplicarse durante toda una tarea, escríbelo como instrucción permanente (“mantén el estilo de commits convencional en todos los commits de esta sesión”), no como un paso puntual (“ahora haz el commit”). Lo que escribas como paso puntual, en el turno siguiente ya no se relee, pero sigue ocupando contexto.
Y si te preocupa cuánto están costando tus skills, /doctor en Claude Code encuentra skills, servidores MCP y plugins que no usas y los contrasta con su coste en contexto. Sobre este tema tienes más munición en cómo ahorrar tokens en Claude Code.
13. ¿Cómo sabes que tu skill sirve de algo? 
Aquí está el cambio más grande de todos, y también el que más gente se salta.
La documentación oficial es tajante: crea las evaluaciones ANTES de escribir la documentación extensa. No al revés. Así te aseguras de que tu skill resuelve problemas reales en lugar de documentar problemas imaginarios.
El ciclo tiene cinco pasos:
- Detecta el hueco: ejecuta el agente sobre tareas representativas sin la skill y documenta los fallos concretos
- Crea las evaluaciones: tres escenarios que ataquen esos huecos
- Establece el baseline: mide el rendimiento sin la skill
- Escribe lo mínimo: solo el contenido necesario para tapar el hueco y pasar las evaluaciones
- Itera: ejecuta, compara contra el baseline, refina
El truco del baseline: mide contra ti mismo 
Lo que hace el skill-creator oficial de Anthropic es más listo de lo que parece. Para cada caso de prueba lanza dos subagentes en el mismo turno: uno con la skill y otro sin ella (o con la versión anterior, si estás mejorando una skill existente).
Después agrega los resultados en un benchmark.json con tasa de acierto, tiempo y tokens, media y desviación típica, y el delta entre configuraciones. Si tu skill no mueve la aguja frente al baseline, no es una skill: es decoración cara.
En ese análisis hay dos patrones que las medias esconden y conviene mirar a mano:
- Aserciones que pasan siempre, con skill y sin ella. No discriminan, así que no te están diciendo nada.
- Evaluaciones con mucha varianza, que probablemente sean inestables y estén contaminando el resultado.
Optimiza la descripción con casos negativos de verdad 
El skill-creator incluye un optimizador de descripciones que merece la pena entender aunque no lo uses. Genera 20 consultas de prueba: entre 8 y 10 que deberían activar la skill y entre 8 y 10 que no deberían.
Y aquí está la clave, que es contraintuitiva: los casos negativos valiosos son los que casi aciertan. Consultas que comparten palabras o conceptos con tu skill pero que en realidad necesitan otra cosa.
[
  {"query": "ok mi jefa me acaba de mandar un xlsx (está en descargas, se llama algo como 'Q4 sales final FINAL v2.xlsx') y quiere que le añada una columna con el margen de beneficio en porcentaje. Los ingresos están en la columna C y los costes en la D creo", "should_trigger": true},
  {"query": "formatea estos datos", "should_trigger": false}
]
Poner “escribe una función de Fibonacci” como caso negativo de una skill de PDFs no prueba nada: es demasiado fácil. Y las consultas positivas tienen que ser realistas, con rutas de ficheros, nombres de columnas, contexto personal, minúsculas y hasta erratas. Como escribe la gente de verdad.
El bucle de optimización divide el set en 60% de entrenamiento y 40% reservado para test, ejecuta cada consulta tres veces para obtener una tasa de activación fiable, propone mejoras a partir de lo que falló, e itera hasta cinco veces. Al final elige la mejor descripción por la puntuación del test, no la del entrenamiento, justamente para no sobreajustar.
El peligro de sobreajustar a tus tres ejemplos 
Esta advertencia del skill-creator es la que más me ha hecho pensar. Estás iterando sobre dos o tres ejemplos que conoces al dedillo porque es rápido. Pero la skill va a usarse miles de veces sobre prompts que no has visto.
Si acabas metiendo parches quisquillosos que solo funcionan con tus ejemplos, la skill no sirve para nada. Cuando un problema se resiste, la recomendación no es apretar más las tuercas: es probar otra metáfora, otro patrón de trabajo, otro encuadre. Sale barato y a veces das con algo mucho mejor.
Prueba con los modelos que vas a usar 
Un detalle que se olvida: las skills son añadidos al modelo, así que su eficacia depende del modelo que hay debajo. Lo que funciona perfecto con Opus puede necesitar más detalle con Haiku. Si vas a usar la skill en varios modelos, apunta a instrucciones que funcionen bien con todos.
Si quieres ver este ciclo aplicado de principio a fin, en skill-creator: cómo crear y evaluar skills con datos reales está el recorrido completo. Y para el enfoque de TDD aplicado a las propias skills, el análisis del framework Superpowers detalla cómo su skill writing-skills valida cada skill con subagentes antes de darla por buena.
Resumen: los 3 consejos fundamentales 
Después de todo lo que hemos visto, si tuviera que quedarme con tres ideas serían estas.
1. La descripción es tu única oportunidad 
El agente decide qué skill activar basándose solo en las descripciones. Tu skill puede ser perfecto, pero si la descripción no responde QUÉ hace, CUÁNDO usarlo y con qué PALABRAS CLAVE se relaciona, nunca se activará. Escríbela en tercera persona, sé un poco insistente porque el modelo tiende a no activarlas, y pon el caso principal al principio porque la cola se trunca.
2. Aporta conocimiento que el modelo no tiene, y explica el porqué 
No expliques conceptos básicos. No hagas tutoriales de librerías estándar. Tu skill debe contener decisiones de experto, trade-offs, casos límite y anti-patrones. Pero cada regla con su razón: un MUST en mayúsculas se rompe en el primer caso raro, un criterio explicado aguanta.
3. Si no la mides contra un baseline, no sabes si funciona 
Ejecuta las mismas tareas con la skill y sin ella. Compara tasa de acierto, tiempo y tokens. Sin ese contraste, lo único que tienes es la sensación de que va mejor. Y las sensaciones, en algo que se va a ejecutar miles de veces, salen caras.
Aplica estos tres principios y tus skills pasarán de ser decoración a herramientas que transforman cómo el agente aborda los problemas. Para ver el enfoque opuesto —skills que invierten el flujo y ponen al agente a interrogarte a ti— echa un ojo a /grill-me y las 11 skills hermanas del repo de Matt Pocock. Y cuando tu skill esté lista para que la use más gente, publicarla en el registro es tan simple como subirla a un repo público: ni formularios ni colas de revisión.
TL;DR 
- 🎯 La
descriptiones el 80% del resultado: tercera persona, qué + cuándo + keywords, caso principal delante y un tono algo insistente porque los modelos tienden a infra-activar skills - 📉 Escribe menos: fuera lo que el modelo ya sabe, SKILL.md por debajo de 500 líneas y el resto en
references/enlazados a un solo nivel de profundidad - 🔕 Baja el volumen de los MUST en mayúsculas: la recomendación oficial ahora es explicar el porqué de cada regla, que es lo que sobrevive al caso límite
- 🧳
SKILL.mdes un estándar abierto con seis campos portables; todo lo demás (disable-model-invocation,paths,context: fork) es extensión de Claude Code - 📊 Mide contra un baseline: ejecuta cada caso con skill y sin skill, compara acierto, tiempo y tokens, y elige la descripción por la puntuación del test para no sobreajustar
Preguntas frecuentes sobre buenas prácticas en skills 
¿Cuánto debe ocupar un SKILL.md? 
Por debajo de 500 líneas en el cuerpo. El contenido detallado va a ficheros separados en references/ que el agente carga solo cuando la tarea lo pide. Los metadatos ocupan unos 100 tokens por skill y están siempre cargados; el cuerpo debería quedarse por debajo de 5k tokens.
¿Por qué mi skill no se activa nunca? 
Las tres causas habituales: la descripción no coincide con cómo formulas la petición, tiene disable-model-invocation: true en el frontmatter, o el fichero está en .claude/skills/nombre.md en lugar de en una carpeta con SKILL.md dentro. Y una cuarta menos evidente: la tarea de prueba era tan simple que el agente la resolvió sin consultar ninguna skill.
¿Debo escribir la descripción en primera o en tercera persona? 
En tercera persona, siempre. La descripción se inyecta en el prompt de sistema y mezclar puntos de vista provoca problemas de descubrimiento. “Procesa ficheros de Excel”, no “puedo ayudarte a procesar ficheros de Excel”.
¿Sigue siendo buena idea escribir NUNCA y SIEMPRE en mayúsculas? 
Los anti-patrones siguen siendo valiosos, pero la guía oficial de Anthropic marca los MUST y NEVER en mayúsculas como bandera amarilla. Es mejor explicar por qué esa regla importa: el modelo generaliza a partir del razonamiento y no a partir del énfasis tipográfico.
¿Cuál es la diferencia entre una skill y un comando personalizado? 
Ya casi ninguna. En Claude Code los comandos personalizados se fusionaron con las skills: .claude/commands/deploy.md y .claude/skills/deploy/SKILL.md crean el mismo /deploy. Las skills añaden directorio de apoyo, control de invocación y carga automática cuando son relevantes.
¿Qué campos del frontmatter funcionan fuera de Claude Code? 
Seis: name, description, license, compatibility, metadata y allowed-tools. Todo lo demás son extensiones de Claude Code y provocan un error de clave inesperada si subes la skill a claude.ai o a la Skills API.
¿Cómo evito que el agente ejecute una skill peligrosa por su cuenta? 
Con disable-model-invocation: true en el frontmatter, que reserva la invocación a que la escribas tú con /nombre. Es lo indicado para despliegues, commits, releases y cualquier flujo con efectos secundarios.
¿Cómo se evalúa si una skill funciona de verdad? 
Ejecutando cada caso de prueba dos veces: con la skill y sin ella. Comparas tasa de acierto, tiempo y tokens entre ambas configuraciones. Sin ese baseline no puedes distinguir la mejora real de la impresión de mejora.
¿Cuántos casos de prueba necesito? 
La documentación oficial recomienda al menos tres evaluaciones antes de compartir una skill. Para optimizar específicamente el disparo de la skill, el skill-creator usa 20 consultas: la mitad que deberían activarla y la mitad que no, priorizando los casos negativos difíciles.
¿Puedo confiar en una skill que me descargo de internet? 
Trátala como software que instalas. Revisa todos los ficheros del paquete, no solo SKILL.md: scripts, imágenes y recursos. Presta atención especial al campo allowed-tools, que concede permisos aunque no hayas marcado el workspace como confiable, y a las skills que descargan contenido de URLs externas.
Fuentes 
- Skill authoring best practices — documentación oficial de Anthropic
- Agent Skills overview — arquitectura, capas de carga y límites
- Extend Claude with skills — referencia de frontmatter de Claude Code
- anthropics/skills: skill-creator — el ciclo de evaluación y el optimizador de descripciones
- Agent Skills — el estándar abierto

Escrito con la ayuda de la IA generativa de Claude, fuentes fidedignas y con un human in the loop:
Dani Primo.
12 recursos para developers cada domingo en tu bandeja de entrada
Además de una skill práctica bien explicada, trucos para mejorar tu futuro profesional y una pizquita de humor útil para el resto de la semana. Gratis.