Qué modelo de GPT usar: Astra, Sol o Luna
Tabla de contenidos
En el post de qué modelo de Claude usar ordené a Fable, Opus, Sonnet y Haiku con una idea sencilla: pensadores, ejecutores y exploradores. Varios me habéis preguntado lo mismo para OpenAI, y la respuesta tiene más gracia de lo que parece.
Con Claude la escalera es casi lineal. Con GPT no. La familia GPT-6 tiene tres modelos, Luna, Sol y Astra, y el del medio se come buena parte del trabajo de los otros dos. OpenAI llega a decir que si el coste y la espera no te preocupan, uses Astra por defecto. Los datos de uso real dicen otra cosa.
El criterio es el mismo que con Claude: para elegir modelo importa cuánto camino está resuelto y cuánto juicio tiene que poner la IA, no el tamaño de la tarea. Lo que cambia es cómo cae cada modelo en ese criterio y cómo se maneja el esfuerzo de razonamiento, que en OpenAI tiene sus propias trampas.
Esto es lo que vas a encontrar aquí:
- El criterio para elegir entre Astra, Sol y Luna, aplicado a la familia de OpenAI
- La clasificación de pensadores, ejecutores y exploradores, y por qué Sol ocupa dos casillas
- Qué dicen las 50 tareas del selector de modelos de Web Reactiva sobre GPT
- Cuándo usar cada uno, con la señal que te dice que toca subir de nivel
- La tabla oficial de OpenAI que empareja modelo, esfuerzo y tipo de tarea
- Cuándo subir el razonamiento y cuándo cambiar de modelo, y una prueba de diez tareas para tu propia regla
Aquí no hay benchmarks por versión. Para eso están los análisis de GPT-6 Astra, GPT-6 Sol y Luna y GPT-6.1 Sol.
¿Cuál es el mejor criterio para elegir un modelo de GPT? 
Pregúntate cuánto del camino está ya resuelto antes de que el modelo empiece, y cuánto juicio tiene que aportar para terminar bien. El tamaño de la tarea, el número de ficheros o la longitud del prompt dicen muy poco.
Dos tareas para verlo:
- “Extrae de estos 3.000 tickets el producto, la versión y si es un bug o una petición, en JSON.”
- “Los clientes se quejan de que la exportación a PDF a veces sale en blanco. Encuentra por qué.”
La primera es enorme y no tiene dudas: hay una regla, un formato y un resultado que puedes validar con un script. Es trabajo de Luna. La segunda cabe en una línea y está llena de decisiones: dónde mirar, qué descartar, cuándo dejar de buscar. Es trabajo de Sol en un esfuerzo alto o de Astra.
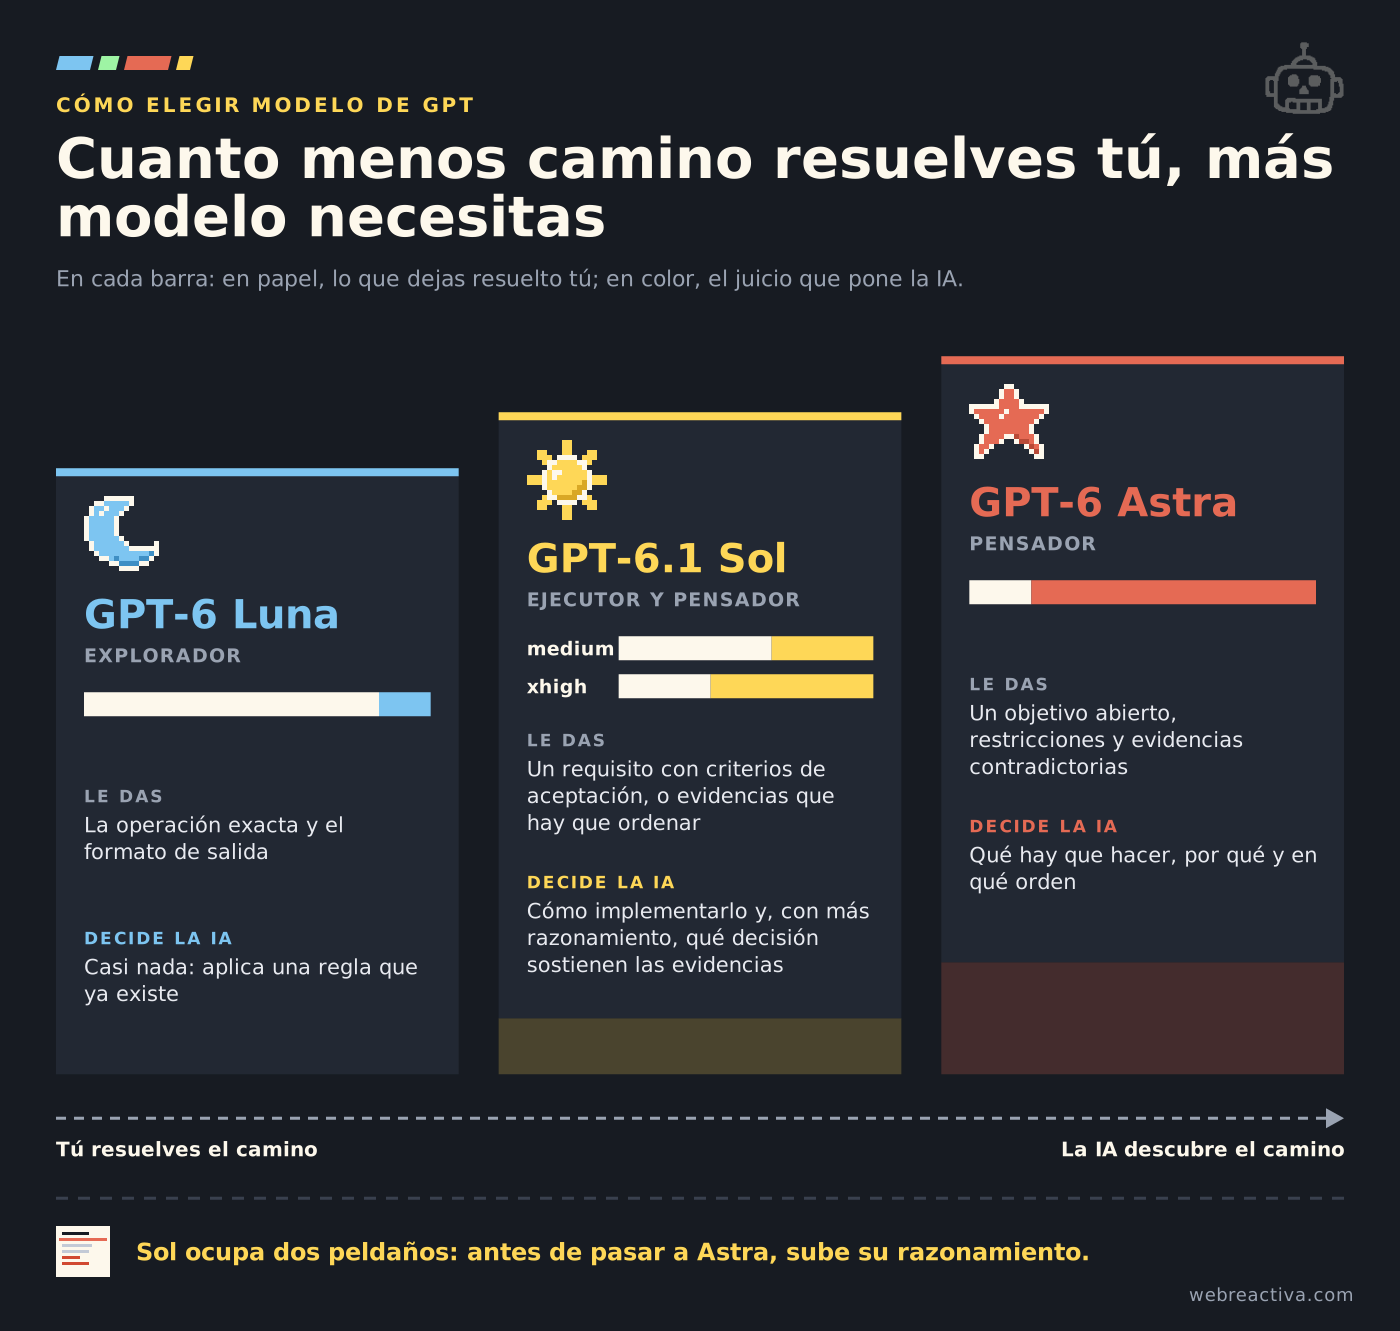
En OpenAI la escalera tiene tres peldaños y uno es muy ancho. Sol cubre desde la implementación bien definida hasta buena parte del trabajo de pensador, según el esfuerzo con el que lo uses. Por eso, en esta familia, la pregunta “¿subo de modelo o subo el razonamiento?” aparece mucho antes que con Claude.
Y la palanca funciona igual en las dos direcciones. Si quieres usar un modelo más barato, resuelve tú más camino antes de encargarle la tarea. Un buen plan convierte trabajo de Astra en trabajo de Sol, y trabajo de Sol en trabajo de Luna.
💡 Cambiar mil ficheros siguiendo una regla puede ser trabajo de Luna. Entender por qué un PDF sale en blanco una de cada cien veces no lo es, aunque el arreglo sean dos líneas.
Herramienta gratis · Selector
¿Luna, Sol o Astra para lo que tienes hoy?
La escalera te da el criterio. Lo que no te da es tu caso: elige la tarea que tienes delante y las suscripciones que pagas, y te digo qué modelo encaja, con la opción barata y la potente al lado.
Le das
Tu tarea y las suscripciones que ya pagas
Te devuelve
El modelo que te conviene, con alternativa barata
¿Qué son los modelos pensadores, ejecutores y exploradores en OpenAI? 
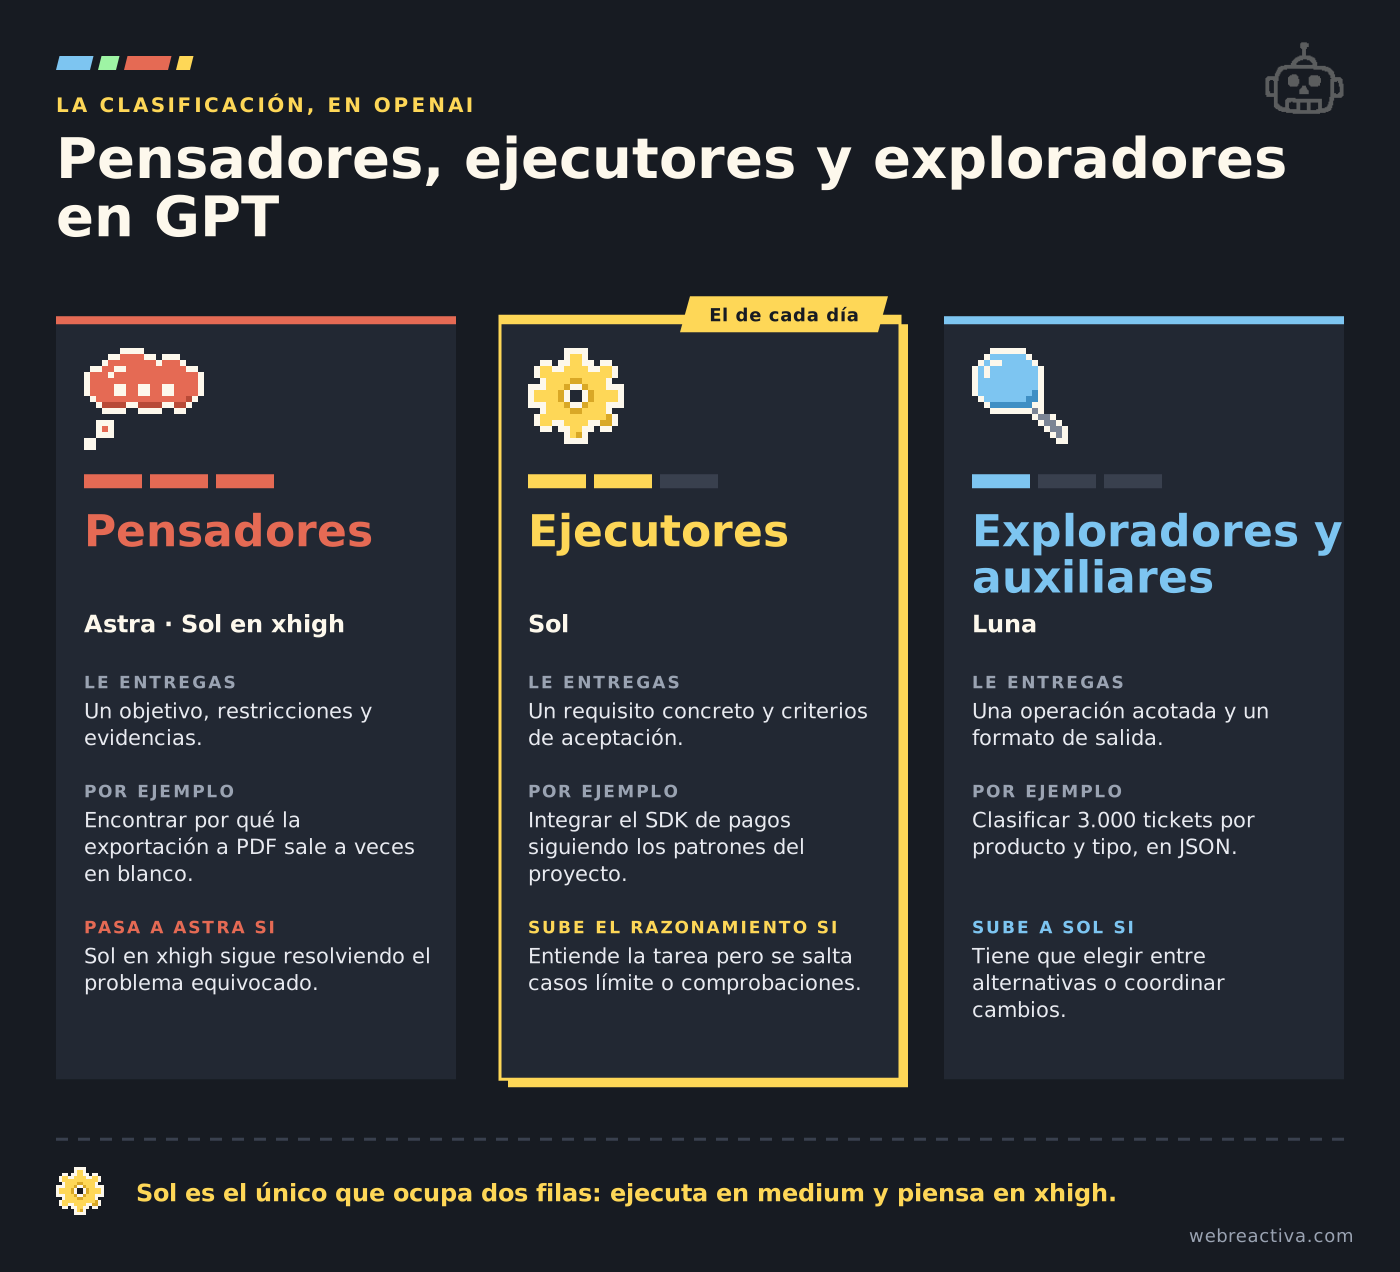
Un pensador descubre el enfoque, un ejecutor completa una tarea delimitada y un explorador localiza, extrae o transforma información con reglas claras. Son papeles, no especies: cualquier modelo puede hacer los tres, pero no en todos es fiable ni en todos sale a cuenta.
Así queda el reparto en la familia GPT-6:
| Grupo | Qué tiene que hacer el modelo | Qué le entregas tú | Modelos de OpenAI |
|---|---|---|---|
| Pensadores | Descubrir el enfoque, resolver ambigüedades y sostener decisiones relacionadas | Un objetivo, restricciones y evidencias | Astra, y Sol en xhigh para el trabajo habitual |
| Ejecutores | Completar una tarea delimitada, tomando decisiones de implementación | Un requisito concreto y criterios de aceptación | Sol |
| Exploradores y auxiliares | Localizar, extraer, transformar u ordenar información con reglas claras | Una búsqueda o transformación acotada y un formato de salida | Luna |
Esa celda de “Sol en xhigh” no es un invento mío. La guía de selección de modelos de OpenAI empareja Sol en xhigh con “decisiones construidas a partir de evidencias contradictorias”, que es trabajo de pensador de libro. Sol es el único modelo de la familia que ocupa dos filas.
Los tres retoques que le hice a la clasificación original en el post de Claude valen aquí, con matices propios.
Retoque 1: los ejecutores también piensan 
Con Sol se ve más claro que con nadie. OpenAI lo describe como “rendimiento cercano a Astra para trabajo complejo a menor coste”. Planifica, razona y decide. Llamarlo ejecutor solo dice dónde sale a cuenta por defecto, no lo que es capaz de hacer.
Retoque 2: explorar no siempre es sencillo 
OpenAI empareja Luna en xhigh con “encontrar contexto actual entre varias aplicaciones, priorizar trabajo y resolver problemas con restricciones claras”. Es exploración, pero ya con algo de criterio: priorizar exige decidir qué importa.
Hasta ahí llega Luna. “Busca dónde se usa esta API” es una búsqueda acotada. “Averigua por qué perdemos pedidos” también es explorar, pero sin reglas que digan qué es relevante. Eso es trabajo de pensador.
Retoque 3: los pensadores no son “los que más tokens gastan” 
Astra es el mejor ejemplo para desmontar esta idea. Artificial Analysis lo midió empatado con Fable 5.1 en su índice de inteligencia, con 53 puntos, usando unos 27.000 tokens de salida por tarea frente a los 78.000 de Fable. El modelo más caro de OpenAI es de los que menos escribe para llegar al resultado.
Y al revés: GPT-6.1 Sol gasta entre un 10 % y un 30 % más de salida que GPT-6 Sol, según el nivel de razonamiento. Lo que gasta un modelo se mide, no se deduce de su categoría.
Tu reparto de modelos, escrito una vez en el AGENTS.md
Codex lee el AGENTS.md en cada sesión, y ahí es donde acaba viviendo la regla de qué modelo y qué esfuerzo usar para cada tarea. En la lección 3 escribimos el AGENTS.md de un proyecto real, regla a regla, con la plantilla para llevártela.
Entra en el curso →¿Qué dice el selector de modelos sobre la familia GPT? 
Dentro de una suscripción de ChatGPT, GPT-6.1 Sol es el mejor modelo disponible en 15 de las 50 tareas del selector, GPT-6 Luna en 7, GPT-5.6 Terra en 6 y GPT-6 Astra en 4. En las otras 18 no hay ningún modelo de OpenAI en el top 5. Son los datos del selector de Web Reactiva a 18 de octubre de 2026, que salen de los rankings de uso real y benchmarks de OpenRouter.
Si miras el top 5 completo de cada tarea, con todos los modelos del mercado, GPT-6.1 Sol es el número uno en 10 de las 50. Solo Opus 5.5 gana más.
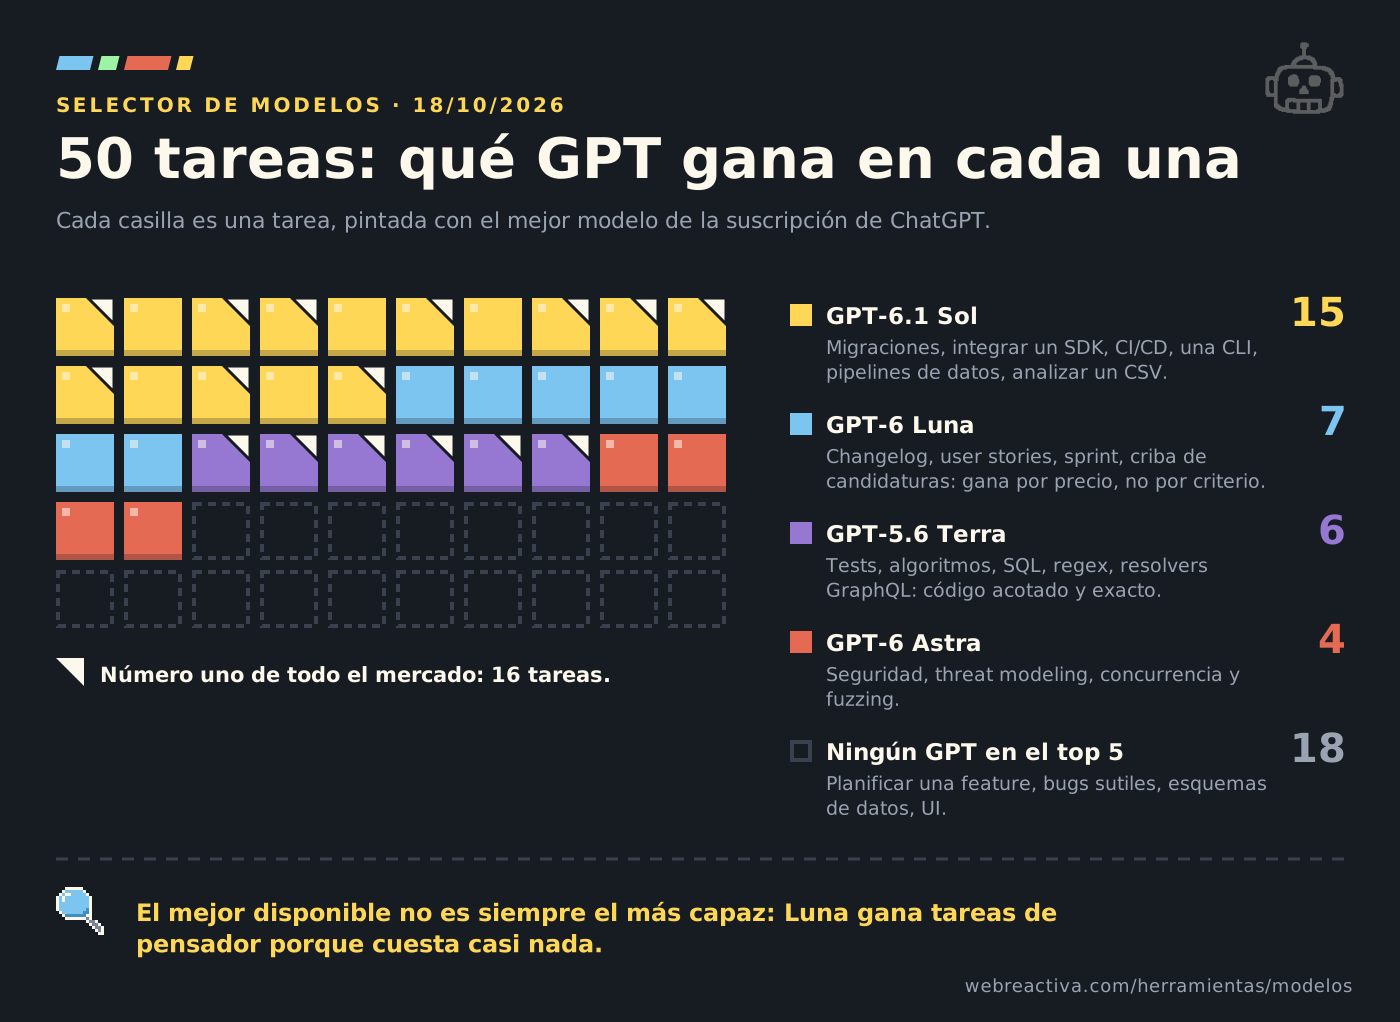
Ese reparto, leído con la clasificación de arriba:
- Sol se queda con el trabajo técnico con destino claro. Migraciones de versión, integrar un SDK, diseñar una API, CI/CD e infraestructura como código, una CLI, pipelines de datos, observabilidad. Es el retrato del ejecutor con criterio. Y en diez de esas tareas no es solo el mejor de OpenAI: es el mejor del mercado.
- Astra solo aparece donde un fallo sale carísimo. Revisión de seguridad, threat modeling, condiciones de carrera y fuzzing con invariantes. Nunca es el número uno del mercado, pero cuando pagas ChatGPT es el que tienes para esas cuatro.
- Terra es la sorpresa. Es de la generación anterior, GPT-5.6, y sigue siendo el número uno del mercado en tests, algoritmos concretos, SQL, regex, parsers y resolvers GraphQL. Código acotado y exacto. OpenAI ya no lo recomienda en ChatGPT Work y Codex, así que si no lo tienes, Sol en
mediumes el sustituto natural. - Luna “gana” tareas que no son suyas, y hay que leerlo con cuidado. Aparece como mejor opción de ChatGPT en el PRD, las user stories, la planificación de un sprint o la criba de candidaturas. No es que sea el mejor pensador: es que Sol y Astra no entran en el top 5 de esas tareas y Luna sí, en cuarto puesto, porque cuesta casi nada. En el carril Barato del selector, Luna sí brilla donde toca: revisión automática en cada push, mensajes de commit y un correo incómodo por céntimos.
La lectura honesta de esas 18 tareas sin OpenAI es que en planificar una feature, depurar un bug sutil o diseñar un esquema de datos, el mercado prefiere otros modelos, sobre todo Opus 5.5. Si pagas ChatGPT y esas son tus tareas del día, súbelas a Sol en xhigh o a Astra, y compara.
Las 50 tareas con su modelo las tienes en qué modelo usar con tu suscripción de ChatGPT. Y si quieres ver a los tres cara a cara, con precios y tareas donde compiten, abre el comparador de Luna, Sol y Astra.
¿Cuánto cuesta cada modelo de GPT por sesión de agente? 
Una sesión de agente de 25 pasos con caché de prompt cuesta unos 0,02 dólares con GPT-6 Luna, 0,34 con GPT-6.1 Sol y 2,09 con GPT-6 Astra. Es la misma cuenta que la calculadora de coste de un agente: un contexto que empieza en 4.000 tokens, crece 2.500 por paso y devuelve 400 de salida en cada vuelta.
| Modelo | Papel principal | Entrada / salida por 1M tokens | Lectura de caché / 1M | Sesión de 25 pasos con caché | Sin caché |
|---|---|---|---|---|---|
| GPT-6 Luna | Explorador y auxiliar | 0,10 $ / 0,50 $ | 0,01 $ | ~0,02 $ | ~0,09 $ |
| GPT-6.1 Sol | Ejecutor con criterio y pensador habitual | 2 $ / 10 $ | 0,10 $ | ~0,34 $ | ~1,80 $ |
| GPT-6 Astra | Pensador para lo más exigente | 10 $ / 50 $ | 1 $ | ~2,09 $ | ~9,00 $ |
Precios del catálogo de models.dev a 18 de octubre de 2026. La sesión no cuenta los tokens de razonamiento ni los reintentos, así que es un suelo, no una factura.
Tres lecturas rápidas:
- Entre Luna y Astra hay un factor de unas 100 veces por sesión. Con Claude, entre Haiku y Fable eran unas 70. La caché de Astra cuesta diez veces la de Sol, y en un agente que relee su contexto en cada paso eso se nota.
- Sol y Sonnet 5.5 cuestan casi lo mismo por sesión, unos 0,34 dólares. Si dudas entre ecosistemas, el precio no decide.
- Sol tiene recargo por contexto largo. Por encima de 272.000 tokens de entrada, toda la petición pasa a pagar el doble en entrada y 1,5 veces en salida. Si tu agente arrastra repositorios enteros, vigílalo.
Con suscripción no pagas tokens, pero la cuenta tiene la misma forma: cuota consumida, espera y correcciones. Y ojo con un detalle que la propia OpenAI subraya: la disponibilidad, las herramientas, los niveles de razonamiento y los límites de uso cambian según el producto y la versión del modelo. Lo que ves en Codex, en ChatGPT Work y en la API no es el mismo menú.
⚠️ La caché es la palanca más gorda de la factura. Si todavía no la aprovechas bien, empieza por ahí antes de bajar de modelo: lo cuento en la guía de prompt caching.
¿Cuándo usar GPT-6 Luna? 
Usa Luna cuando puedas describir bien la operación y comprobar fácilmente el resultado. OpenAI lo presenta como su modelo “más eficiente para tareas focalizadas y de alto volumen, como resúmenes, extracción y programación acotada”.
Ejemplos que encajan:
- Clasificar tickets, logs o incidencias con una taxonomía que ya existe.
- Extraer campos de documentos con una estructura conocida.
- Buscar referencias en el repositorio o hacer cambios localizados.
- Generar resúmenes con el mismo formato cada vez.
- Escribir el mensaje de commit de cada cambio o revisar cada push con criterios explícitos.
La guía de OpenAI lo empareja con low para “ediciones finas, problemas bien acotados y extracción sencilla de datos”. La regla que se repite en quien lo usa en producción es buena: usa Luna cuando lo que produce lo va a consumir código, y piénsatelo dos veces cuando el texto o el código generado es el entregable final.
No lo confundas con un Sol barato. Artificial Analysis lo mide en 37 puntos de su índice de inteligencia en max, frente a los 52 de Sol. Esa distancia no la compensa el precio si la tarea es “implementa esta funcionalidad tú solo”. Su sitio natural son los subagentes de lectura; en cómo crear subagentes tienes los prompts. Y si te mueves entre ecosistemas, su rival directo al mismo precio es Claude Haiku 5.5.
🔼 Señal para subir a Sol: Luna empieza a tener que elegir entre alternativas, coordinar cambios entre ficheros o decidir qué información importa sin una regla que lo diga.
Un apunte técnico: en Chat Completions, Luna solo admite llamadas a funciones con el razonamiento en none. Si tu subagente necesita herramientas y razonar a la vez, pásalo a la Responses API.
¿Cuándo usar GPT-6.1 Sol? 
Usa Sol cuando conoces el destino y necesitas que resuelva el recorrido, y también para buena parte del trabajo de pensador del día a día. Es el modelo de OpenAI que tiene más sentido por defecto para programar.
Ejemplos que encajan:
- Implementar requisitos definidos en código que ya existe.
- Integrar un SDK o una API de terceros.
- Diagnosticar errores cuando tienes evidencias suficientes.
- Refactorizar varias piezas relacionadas.
- Preparar entregables que vas a revisar e iterar.
La guía oficial lo empareja con medium para “trabajo técnico complejo y entregables coordinados que esperas revisar”, y con xhigh para “entregables pulidos, sistemas visuales conectados y decisiones construidas a partir de evidencias contradictorias”. Dos usos muy distintos con el mismo modelo, separados solo por el esfuerzo.
Su posición intermedia no significa que solo ejecute planes escritos por otro modelo. En DeepSWE 1.1 iguala a Astra (75,2 % frente a 74,1 %) y en el índice de Artificial Analysis se queda a un punto, por una quinta parte del precio por token. Lo cuento con detalle en el análisis de GPT-6.1 Sol.
🔼 Señal para subir a Astra: Sol en
xhighsigue proponiendo soluciones plausibles al problema equivocado, o pierde restricciones cuando la tarea cruza varios sistemas.
Antes de subir de modelo, prueba a subir el esfuerzo. Con Sol, el salto de medium a xhigh es más grande que con casi cualquier otro modelo: en Artificial Analysis, GPT-6 Sol en medium se quedaba en 40 puntos y en max llegaba a 47.
Con OpenAI la pregunta ya no es qué modelo es más listo, sino cuánto razonamiento le pides a cada uno y cuánto camino le dejas resuelto. De eso hablamos cada domingo en la newsletter: cómo usamos la IA en el desarrollo real, con lo que funciona y lo que no. Gratis, ya somos +7.200.
Suscríbete gratis →¿Cuándo compensa GPT-6 Astra frente a Sol? 
Astra compensa cuando el juicio determina la calidad del resultado y Sol en xhigh ya no llega, o cuando lo has comparado en tu caso y la mejora paga el precio. OpenAI lo define como su modelo “más capaz para trabajo complejo en código, aplicaciones e investigación”.
Ejemplos que encajan:
- Aclarar un requisito ambiguo y convertirlo en una solución coherente.
- Resolver un fallo que cruza varios sistemas.
- Sintetizar evidencias contradictorias en una decisión.
- Revisar decisiones cuyo error sería difícil de detectar después: seguridad, concurrencia, invariantes.
- Investigación técnica o científica de razonamiento muy largo.
En ese último punto tiene una ventaja clara: 68,1 % en Terminal-Bench Science frente al 57 % de Sol. En programación con agentes del día a día, la distancia casi desaparece.
Aquí hay un choque interesante entre fuentes. La guía de OpenAI dice: “si el coste y la latencia no te preocupan, puedes usar Astra por defecto”. Es verdad, y conviene leerlo bien: reservar Astra para lo difícil es una decisión de eficiencia, no una obligación técnica. Pero el uso real va por otro lado. En el selector, Astra no es el número uno del mercado en ninguna de las 50 tareas, y el propio OpenAI coloca a Sol “cerca de Astra a menor coste”. Si te preocupan el coste o la espera, que es lo normal, Sol va primero.
Un dato que debes conocer: no habrá GPT-6.1 Astra de momento. OpenAI lo canceló la víspera del DevDay porque en sus pruebas mentía más que GPT-6 Astra sobre lo que había hecho o dejado de hacer. El Astra que tienes es el de septiembre.
🔽 Señal para bajar a Sol: llevas dos semanas con Astra y no recuerdas una tarea que Sol en
xhighno hubiera sacado. Eso es pagar cinco veces más por token a cambio de tranquilidad.
¿Qué criterios usar para decidir entre Luna, Sol y Astra? 
Siete criterios: ambigüedad, dependencias, verificación, autonomía, coste del fallo, frecuencia y espera tolerable. Cuantos más caen a la derecha de la tabla, más capaz tiene que ser el modelo, o más esfuerzo tiene que poner Sol.
| Criterio | Favorece Luna o Sol en esfuerzo bajo | Favorece Sol en esfuerzo alto o Astra |
|---|---|---|
| Ambigüedad | Está claro qué significa terminar | Hay que descubrir el problema o definir la solución |
| Dependencias | La tarea es local e independiente | Una decisión afecta a varias partes |
| Verificación | Puedes comprobar la salida automáticamente | Una respuesta convincente puede ocultar errores |
| Autonomía | Vas a revisar cada paso relevante | Tiene que trabajar y recuperarse sin supervisión frecuente |
| Coste del fallo | Repetir la tarea es barato | Un mal enfoque provoca mucho retrabajo |
| Frecuencia | Se repite cientos de veces | Es una decisión ocasional de mucho valor |
| Espera tolerable | Necesitas respuesta inmediata | Puedes esperar a cambio de una mejora que puedas comprobar |
Con OpenAI, la frecuencia pesa todavía más que con Claude, porque el salto de precio es mayor. Una tarea que repites trescientas veces al mes en Sol merece una tarde de pruebas para ver si Luna la saca. Una decisión de arquitectura al trimestre no merece ese ahorro.
Y la verificación es el criterio que más deja bajar. Si un test o un esquema JSON te dice si el resultado vale, puedes probar con un modelo más ligero y dejar que la comprobación haga de red. Si el resultado es una decisión que nadie puede comprobar en el momento, sube.
Planes que se pueden ejecutar
Un buen plan convierte trabajo de Astra en trabajo de Sol
Cuanto más camino resuelves antes de encargar la tarea, más barato es el modelo que la saca. En este audio te llevas el método para que tu agente produzca planes ejecutables: subagentes antagónicos que estresan el plan, un plan-reviewer y el cierre con checklist y prueba de concepto.
Escuchar el audio →Audio premium · Suscripción Web Reactiva Premium
¿Subo el razonamiento o cambio de modelo? 
Primero eliges la capacidad adecuada para el problema y después ajustas el esfuerzo de razonamiento. La propia OpenAI lo plantea así: el esfuerzo es “una palanca de ajuste, no la forma principal de recuperar calidad”.
El esfuerzo (reasoning.effort en la API) guía cuánto piensa el modelo antes de responder. Es adaptativo: con el mismo nivel, el modelo gasta menos en lo sencillo y más en lo complejo. No es un control de longitud y no garantiza una respuesta correcta. Tampoco es el modo: reasoning.mode elige entre ejecución estándar y pro, y el esfuerzo se ajusta dentro de cada modo.
El menú cambia según dónde lo uses:
- En la API, los niveles son
low,medium,high,xhighymax. Luna admite ademásnone; GPT-6.1 Sol y Astra no. Luna y Sol parten demedium. - En ChatGPT Work y Codex, el razonamiento va de Light a Ultra: Light, Medium, High, Extra High, Max y Ultra. Light es lo que la CLI llama Low, y Ultra reparte el trabajo entre subagentes en paralelo, así que no es “más Max”: es otra forma de trabajar.
Y aquí viene la trampa que más me gusta de OpenAI: un modelo superior no implica un esfuerzo superior. Su guía de ChatGPT recomienda empezar con Luna en High y Astra en Light, y con Sol en el nivel que tu cliente traiga por defecto. El más barato arranca pensando mucho y el más caro arranca pensando poco.
La guía de selección de modelos de la API va más allá y empareja cada modelo con su esfuerzo y su tipo de tarea. Es la mejor tabla oficial que conozco para esto:
| Modelo y esfuerzo | Para qué lo recomienda OpenAI |
|---|---|
Luna · low |
Ediciones finas, problemas bien acotados y extracción sencilla de datos |
Luna · xhigh |
Encontrar contexto actual entre varias aplicaciones, priorizar trabajo y resolver problemas con restricciones claras |
Sol · medium |
Trabajo técnico complejo y entregables coordinados que esperas revisar |
Sol · xhigh |
Entregables pulidos, sistemas visuales conectados y decisiones a partir de evidencias contradictorias |
Astra · low |
Redacción concisa y adaptación de contenido que conserva hechos y matices |
Astra · medium |
Proyectos ambiciosos que necesitan contexto amplio, interacciones fiables y resultados completos |
Astra · xhigh |
Análisis exigente y entregables complejos con requisitos estrictos |
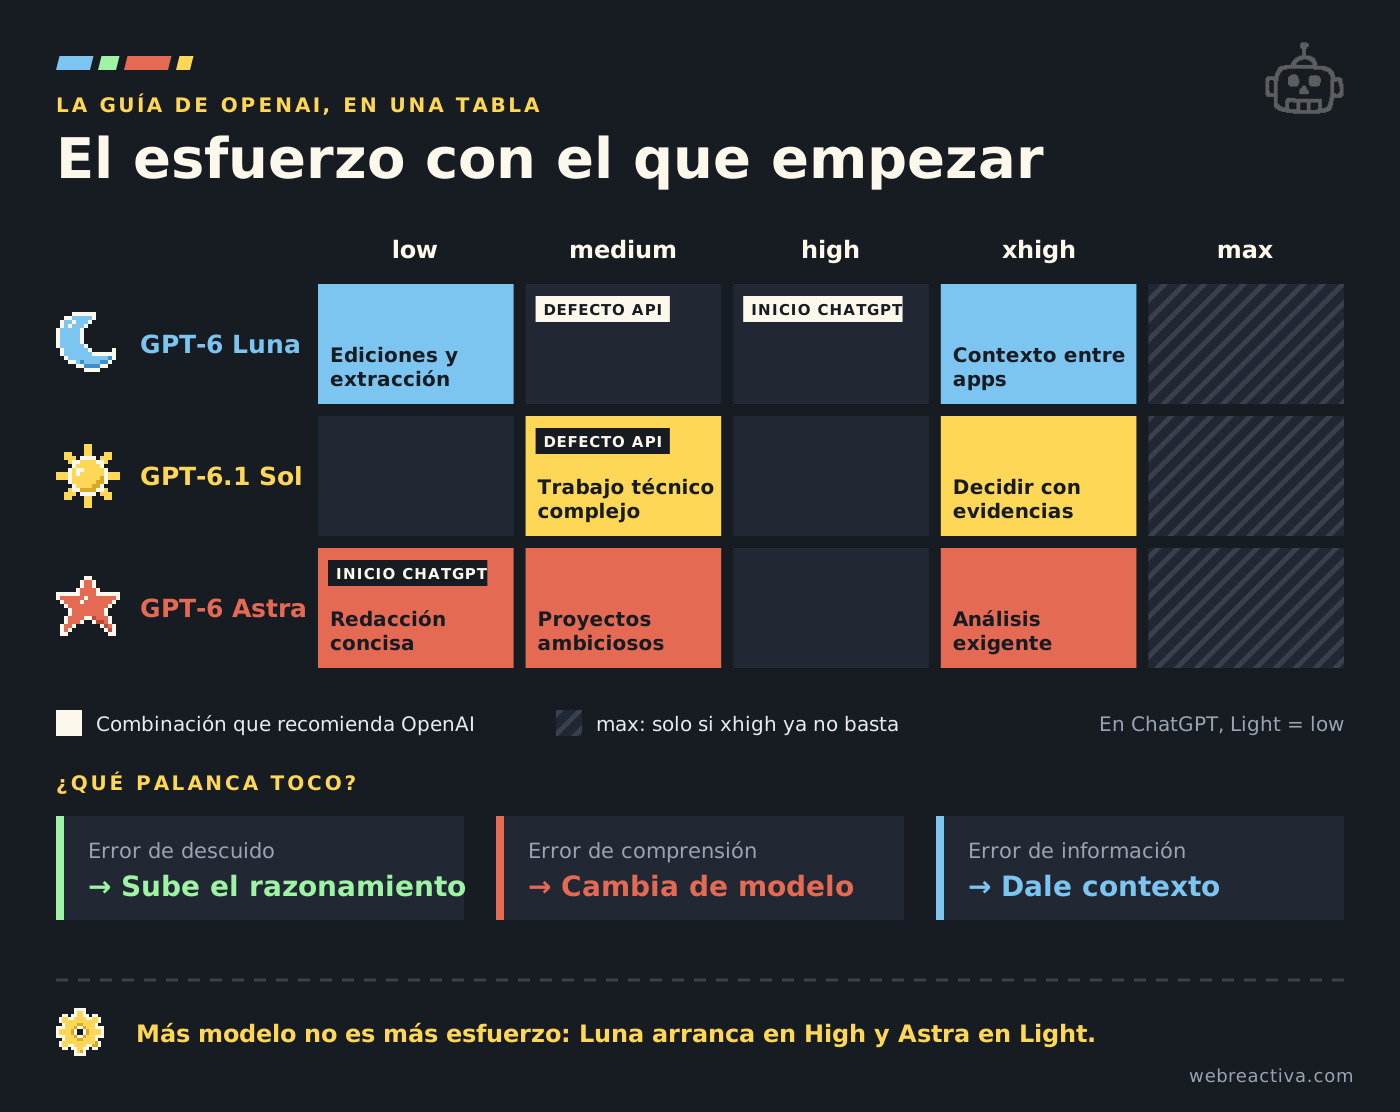
Para xhigh y max la documentación es tajante: xhigh solo cuando tus evaluaciones muestren un beneficio claro que justifique la espera y el coste, y max para lo más complejo, comprobando antes que mejora a xhigh. Los niveles altos se deciden midiendo, no por costumbre.
Y la regla que uso para saber qué palanca tocar según lo que veo:
| Lo que observas | Qué probar |
|---|---|
| Entiende el problema, pero se salta comprobaciones o casos límite | Subir el razonamiento |
| La respuesta es correcta, pero tarda demasiado | Bajar el razonamiento |
| Insiste en un enfoque equivocado o pierde restricciones importantes | Cambiar a un modelo más capaz |
| Le faltan datos, acceso al código o una reproducción | Darle esas evidencias |
| Resuelve bien una tarea que se repite mucho | Probar Luna o un esfuerzo más bajo |
| Encadena intentos sin aprender de los errores | Parar y revisar contexto, enfoque y modelo |
No asumas que “Luna al máximo equivale a Sol” ni que “Sol en max es un Astra barato”. Son configuraciones distintas y no hay una conversión universal entre capacidad y esfuerzo. Lo que sí puedes asumir es que con Sol tienes mucho recorrido de esfuerzo antes de necesitar Astra.
🧭 Si no sabes qué palanca tocar, mira qué tipo de error comete. Errores de descuido piden razonamiento. Errores de comprensión piden modelo. Errores de información piden contexto.
OpenAI tiene seis niveles de razonamiento en ChatGPT, cinco en la API y uno que reparte el trabajo entre subagentes. Cada domingo te cuento con calma qué configuraciones merecen la pena para programar y cómo las estamos usando, junto a 12 recursos seleccionados. +7.200 developers, gratis desde 2018.
Quiero esa dinamita 🧨¿Cómo comprobar con tus propias tareas qué modelo de GPT te conviene? 
Coge diez tareas reales, pásalas por dos configuraciones con el mismo contexto y anota cuatro cosas: si aceptaste el resultado, el tiempo total, el consumo y las correcciones que tuviste que hacer. OpenAI lo resume en su guía: usa las mismas entradas y “quédate con el ajuste más ligero que cumpla tu nivel de calidad”.
El orden importa:
- Compara modelos con un esfuerzo razonable: Luna en
low, Sol enmedium, Astra enlowomedium. No mezcles las dos variables a la vez. - Elige el modelo más ligero que acepta el resultado en la mayoría de tareas de cada tipo.
- Después afina el esfuerzo del elegido. Con Sol, prueba
xhighantes de pasar a Astra.
Una plantilla para la hoja de cálculo:
| Tarea | Tipo (pensador / ejecutor / explorador) | Modelo y esfuerzo | ¿Aceptado? | Tiempo | Consumo | Correcciones |
|---|---|---|---|---|---|---|
| Clasificar los tickets de la semana en JSON | Explorador | Luna · low |
Sí | 1 min | 0,02 $ | 0 |
| Integrar el SDK de pagos en el checkout | Ejecutor | Sol · medium |
Sí | 8 min | 0,40 $ | 1 |
| Encontrar por qué el PDF sale a veces en blanco | Pensador | Sol · xhigh |
No | 20 min | 0,90 $ | 3 |
| Encontrar por qué el PDF sale a veces en blanco | Pensador | Astra · medium |
Sí | 18 min | 2,40 $ | 1 |
Las cifras de la plantilla son de ejemplo: lo que importa es medir las tuyas. Fíjate en las dos últimas filas: la misma tarea con dos configuraciones es la forma de saber si Astra paga su precio en tu caso.
Cuando tengas la tabla, la regla sale casi sola. Algo como: “explorador a Luna en low; ejecutor a Sol en medium; pensador a Sol en xhigh, y a Astra si falla dos veces o si es seguridad”. Escríbela en tu AGENTS.md, que Codex lee en cada sesión, y deja de decidirlo cada vez. Si vienes de Claude Code y quieres probarlo, en qué es Codex CLI tienes por dónde empezar.
TL;DR 
- Elige modelo por cuánto camino está resuelto y cuánto juicio tiene que poner la IA, no por el tamaño de la tarea.
- Pensadores (Astra, y Sol en
xhigh) descubren el enfoque. Ejecutores (Sol) completan tareas delimitadas. Exploradores y auxiliares (Luna) buscan, extraen y transforman con reglas claras. - Sol ocupa dos casillas: con OpenAI, subir el razonamiento de Sol suele ir antes que cambiar a Astra.
- En el selector de Web Reactiva, dentro de ChatGPT, Sol gana 15 de 50 tareas, Luna 7, Terra 6 y Astra 4. Sol es el número uno de todo el mercado en 10.
- Una sesión de agente de 25 pasos con caché cuesta ~0,02 $ con Luna, ~0,34 $ con Sol y ~2,09 $ con Astra.
- Un modelo superior no implica más esfuerzo: OpenAI recomienda empezar con Luna en High y Astra en Light.
xhighymaxse deciden con evaluaciones, no por defecto. Errores de descuido piden razonamiento, de comprensión piden modelo y de información piden contexto.- Mide con diez tareas reales y escribe tu regla en el
AGENTS.md.
Preguntas frecuentes 
¿Qué modelo de GPT es mejor para programar? 
Para casi todo, GPT-6.1 Sol: implementar, integrar, refactorizar y depurar con evidencias. Para tareas acotadas y repetitivas, GPT-6 Luna. Para revisiones de seguridad, concurrencia o problemas que cruzan varios sistemas, GPT-6 Astra o Sol en xhigh.
¿Cuál es la diferencia entre GPT-6 Astra, Sol y Luna? 
Cuánta incertidumbre resuelven con fiabilidad y cuánto cuestan. Luna necesita que le digas la operación y cuesta 0,10 $ el millón de tokens de entrada. Sol resuelve el recorrido, y con esfuerzo alto parte del destino, a 2 $. Astra está pensado para el trabajo más exigente, a 10 $.
¿Merece la pena pagar GPT-6 Astra? 
Si el coste y la espera no te importan, OpenAI dice que puedes usarlo por defecto. Si te importan, prueba antes Sol en xhigh: se queda a un punto de Astra en el índice de Artificial Analysis por una quinta parte del precio por token. Astra marca diferencias en razonamiento científico y en tareas largas donde un fallo sale caro.
¿Con qué esfuerzo de razonamiento empiezo en cada modelo de GPT? 
En la API, Luna y Sol parten de medium. En ChatGPT Work y Codex, OpenAI recomienda empezar con Luna en High, Astra en Light y Sol en el nivel por defecto de tu cliente. Sube solo donde veas errores de descuido.
¿Qué es el nivel Ultra de Codex y ChatGPT? 
Es el nivel más alto del selector de razonamiento en ChatGPT Work y Codex. A diferencia de Max, que da más tiempo al modelo en una sola tarea, Ultra reparte el trabajo entre subagentes que atacan partes en paralelo.
¿Puedo usar GPT-6 Luna para programar? 
Sí, para trabajo acotado y comprobable: cambios localizados, búsquedas en el repositorio, extracción, mensajes de commit y revisiones con criterios explícitos. No es buena opción para llevar una funcionalidad entera de forma autónoma.
¿GPT-5.6 Terra sigue teniendo sentido? 
El selector lo sigue poniendo como número uno del mercado en tests, algoritmos, SQL, regex y resolvers GraphQL. Si lo tienes disponible, úsalo para ese código acotado y exacto. Si no, GPT-6.1 Sol en medium es el sustituto natural.
¿Subir Sol a max lo iguala a Astra? 
No hay una equivalencia universal entre esfuerzo y capacidad. Sol en xhigh o max saca mucho trabajo de pensador, pero si el fallo es de comprensión y no de descuido, cambiar a Astra es lo que toca. Compáralo con tus tareas.
¿Cómo combino varios modelos de GPT en el mismo proyecto? 
Con subagentes: una sesión principal en Sol, o en Astra si el problema lo pide, que planifica y revisa, y subagentes en Luna para búsquedas, extracción y revisiones baratas. Si los montas sobre Chat Completions, recuerda que Luna solo admite herramientas con el razonamiento en none.
¿Esta clasificación sirve también para Claude? 
Sí, el criterio es el mismo. En qué modelo de Claude usar tienes el reparto entre Fable, Opus, Sonnet y Haiku. La diferencia es que en Claude el modelo de por defecto es el pensador, Opus, y en OpenAI es el ejecutor, Sol.
Fuentes 
- OpenAI, Using the latest model
- OpenAI, Model selection
- OpenAI, Reasoning models
- ChatGPT Learn, Models in ChatGPT Work and Codex
- Artificial Analysis, Benchmarking GPT-6 Astra
- Selector de modelos de Web Reactiva (datos de OpenRouter a 18 de octubre de 2026)
- Catálogo de precios de models.dev (a 18 de octubre de 2026)
🧨 Última oportunidad para recibir la dinamita que mereces sobre programación con IA el próximo domingo: Suscríbete gratis a Web Reactiva en https://webreactiva.com/newsletter
Escrito con la ayuda de la IA generativa de Claude, fuentes fidedignas y con un human in the loop:
Dani Primo.
12 recursos para developers cada domingo en tu bandeja de entrada
Además de una skill práctica bien explicada, trucos para mejorar tu futuro profesional y una pizquita de humor útil para el resto de la semana. Gratis.