Qué modelo de Claude usar: Fable, Opus, Sonnet o Haiku
Tabla de contenidos
Hace unos días circulaba una diapositiva con una clasificación muy maja de los modelos de IA: pensadores, ejecutores y exploradores. Los pensadores planifican y resuelven lo que no tienes claro. Los ejecutores hacen bien lo que ya está planificado. Los exploradores buscan en ficheros y agrupan información.
La idea es buena. La he usado para ordenar la familia de Claude y me ha servido, pero con tres retoques que cambian bastante las decisiones que tomas con ella.
El criterio que me llevo es este: para elegir modelo importa cuánto camino está resuelto y cuánto juicio tiene que poner la IA. No el tamaño de la tarea. Una tarea de dos líneas puede pedir el modelo más capaz. Una tarea de cien ficheros, si es mecánica, encaja en el más ligero.
Esto es lo que vas a encontrar aquí:
- El criterio para elegir entre Fable, Opus, Sonnet y Haiku, y por qué no es “lo grande con el grande”
- La clasificación de pensadores, ejecutores y exploradores, retocada para que no te engañe
- Qué dicen las 50 tareas del selector de modelos de Web Reactiva sobre la familia Claude
- Cuándo usar cada uno, con la señal concreta que te dice que toca subir de nivel
- La matriz de siete criterios para decidir y la regla para tocar el esfuerzo antes que el modelo
- Una prueba de diez tareas para construir tu propia regla
Este post no repasa benchmarks de cada versión. Para eso están los análisis de Haiku 5.5, Sonnet 5.5, Opus 5.5 y Fable 5.1. Aquí va el criterio que sigue valiendo cuando salga la siguiente versión.
¿Cuál es el mejor criterio para elegir un modelo de Claude? 
Pregúntate cuánto del camino está ya resuelto antes de que el modelo empiece, y cuánto juicio tiene que aportar para terminar bien. Ese es el criterio. Lo demás son matices.
Mira estas dos tareas:
- “Renombra
getUserafetchUseren los 140 ficheros donde aparece y actualiza los imports.” - “Los pedidos de los martes por la noche se pierden a veces. Averigua por qué.”
La primera es enorme y no tiene ninguna duda. Sabes qué significa terminar, puedes comprobarlo con el compilador y los tests, y no hay que decidir nada. La segunda cabe en una línea y está llena de decisiones: dónde mirar, qué descartar, qué hipótesis sostener, cuándo parar.
Si eliges modelo por el tamaño, mandas la primera a Opus y la segunda a Haiku. Al revés de lo que toca.
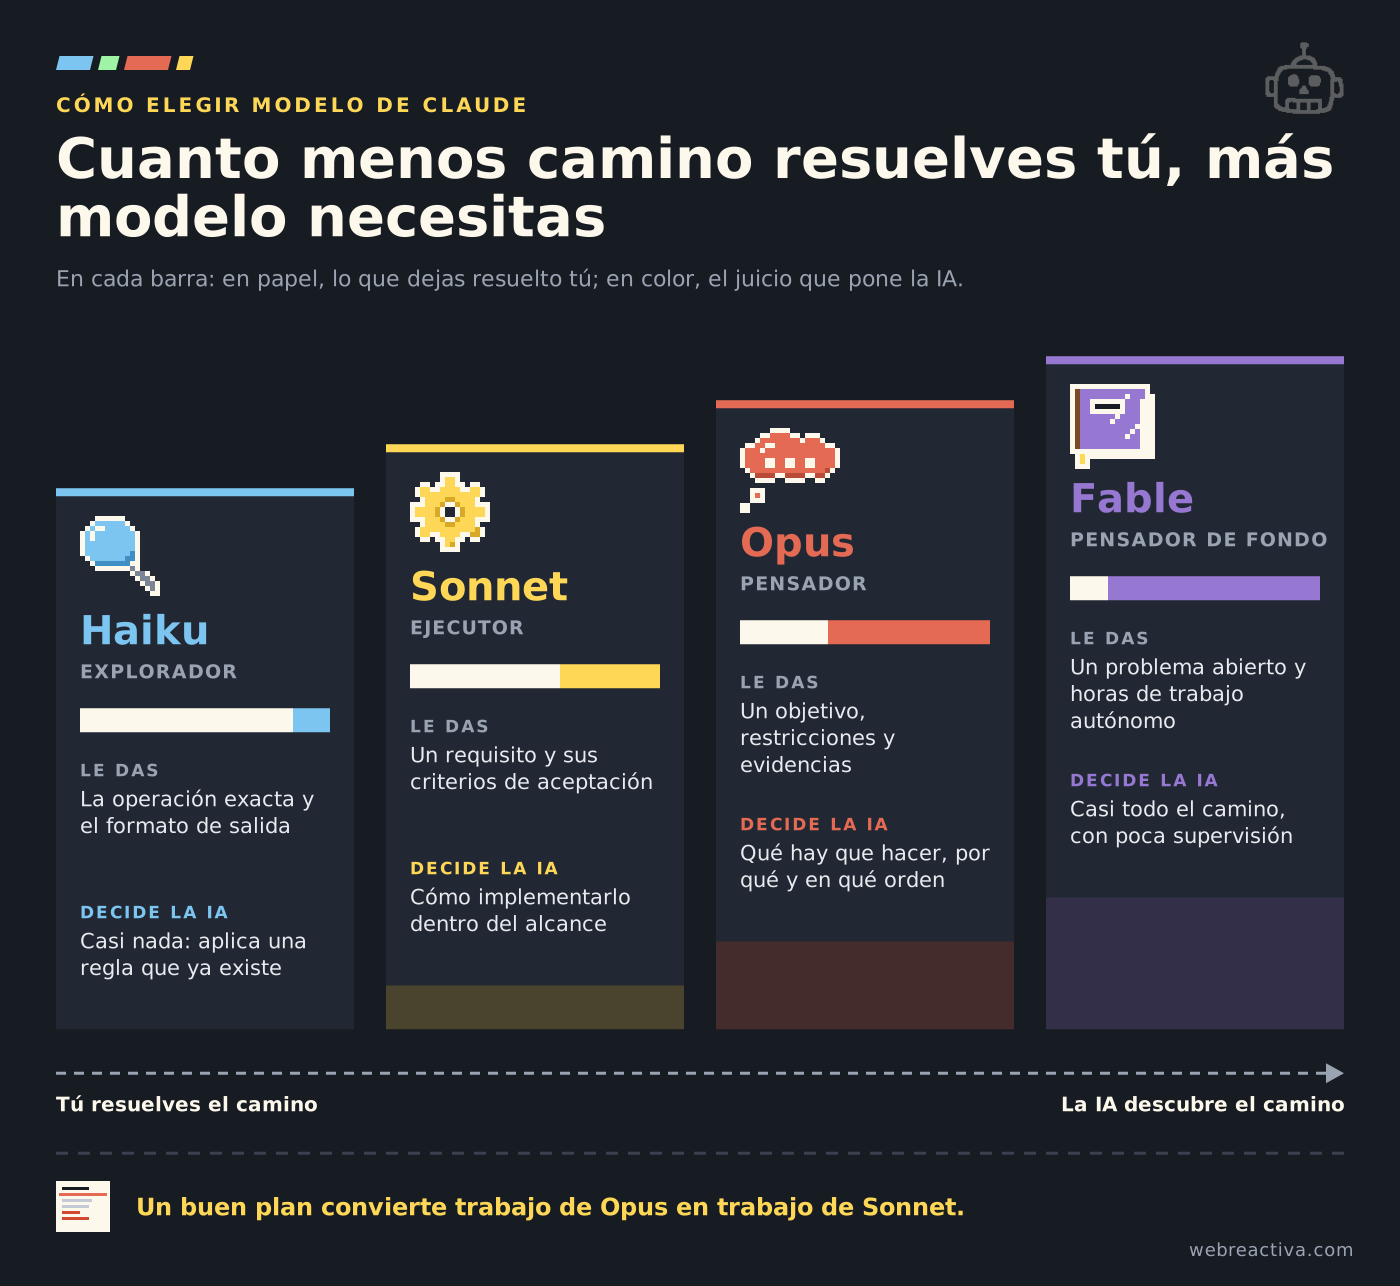
A la izquierda de la escalera, tú has resuelto casi todo y el modelo ejecuta. A la derecha, le das un objetivo y el modelo tiene que descubrir el camino. Cuanto más camino dejas sin resolver, más capacidad necesitas.
Y funciona en las dos direcciones. Si quieres usar un modelo más barato, la palanca no es pedirle que se esfuerce: es resolver tú más camino antes de encargarle la tarea. Un buen plan convierte trabajo de Opus en trabajo de Sonnet.
💡 El número de ficheros y la longitud del prompt engañan. Cambiar cien ficheros siguiendo una regla es más sencillo que entender una condición de carrera en dos funciones.
Herramienta gratis · Selector
¿Y tu tarea de hoy, en qué peldaño cae?
La escalera te da el criterio general. Tu caso depende de la tarea concreta que tienes delante y de las suscripciones que ya pagas: elige la tarea y te digo qué modelo encaja, con la alternativa barata y la potente al lado.
Le das
Tu tarea y las suscripciones que ya pagas
Te devuelve
El modelo que te conviene, con alternativa barata
¿Qué son los modelos pensadores, ejecutores y exploradores? 
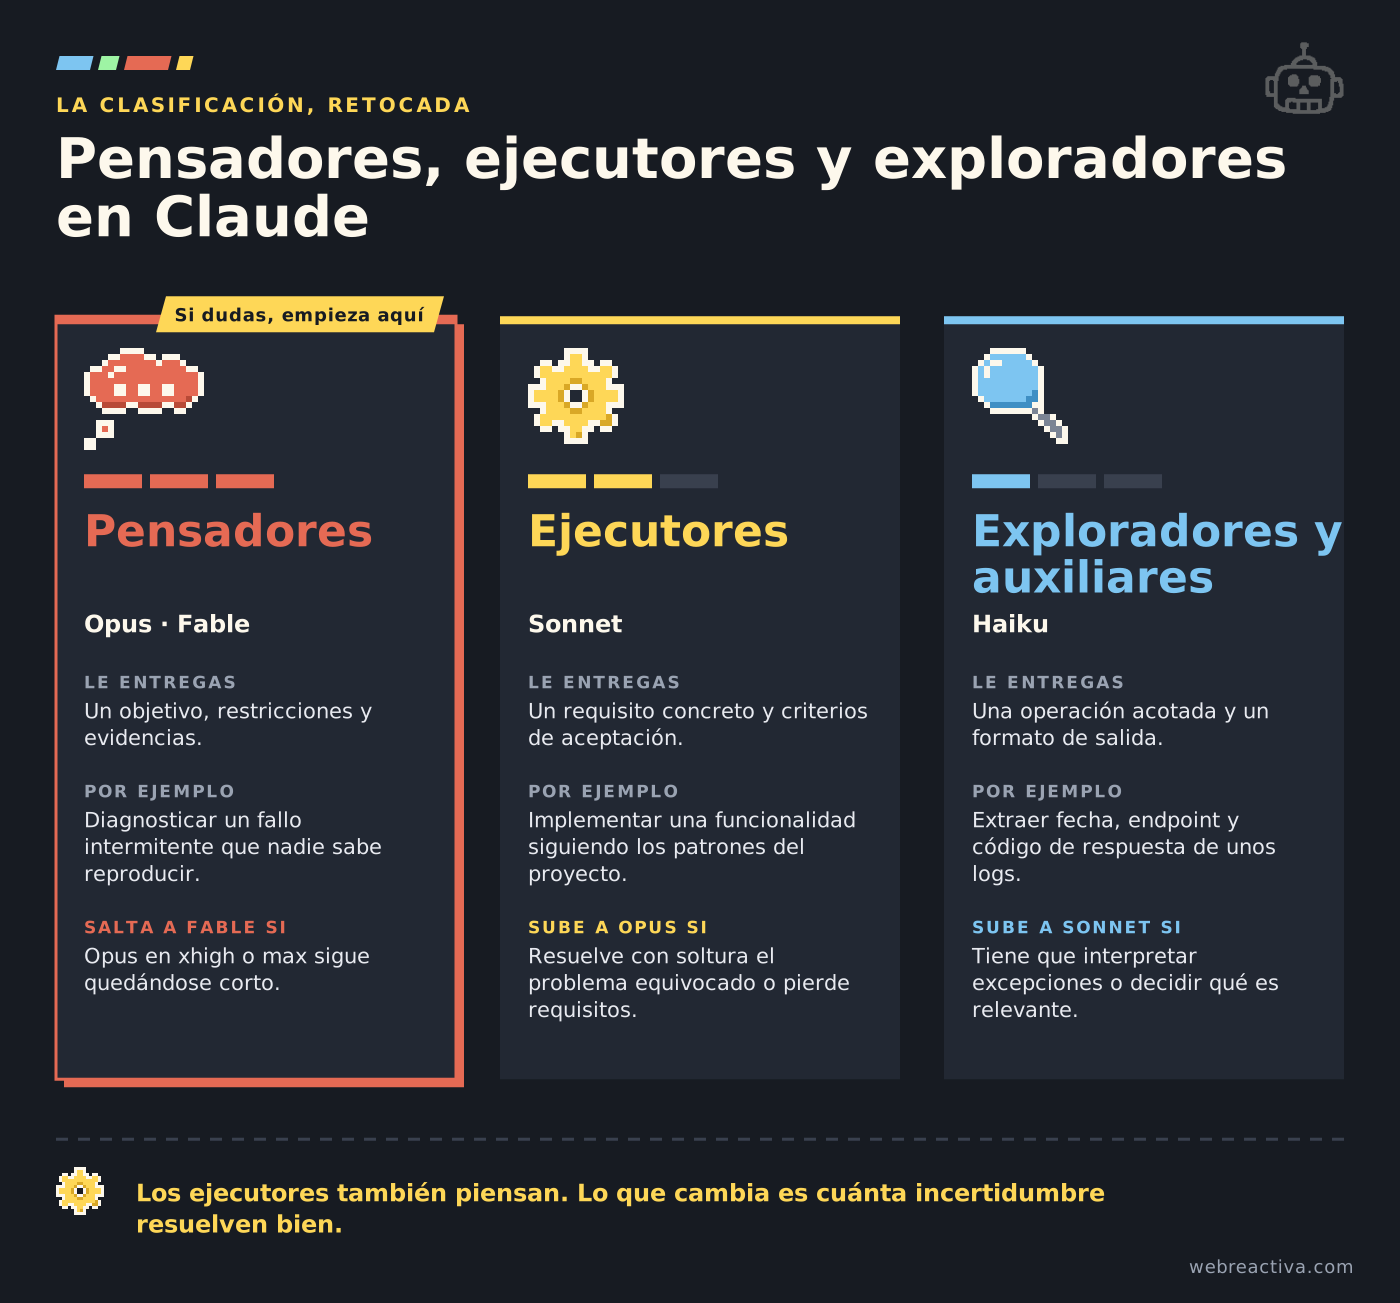
Son tres papeles, no tres especies. Un pensador descubre el enfoque, un ejecutor completa una tarea delimitada y un explorador localiza, extrae o transforma información con reglas claras. Cualquier modelo puede hacer los tres papeles; lo que cambia es en cuál es fiable y en cuál sale a cuenta.
Así queda la clasificación con los retoques que te cuento justo debajo:
| Grupo | Qué tiene que hacer el modelo | Qué le entregas tú | Modelos de Claude |
|---|---|---|---|
| Pensadores | Descubrir el enfoque, resolver ambigüedades y sostener decisiones relacionadas | Un objetivo, restricciones y evidencias | Opus y Fable |
| Ejecutores | Completar una tarea delimitada, tomando decisiones de implementación | Un requisito concreto y criterios de aceptación | Sonnet (y Opus cuando hay mucho en juego) |
| Exploradores y auxiliares | Localizar, extraer, transformar u ordenar información con reglas claras | Una búsqueda o transformación acotada y un formato de salida | Haiku |
La columna que más me importa es la tercera: qué le entregas. Si no puedes rellenarla, todavía no sabes qué modelo usar, porque todavía no sabes qué tarea es.
Retoque 1: los ejecutores también piensan 
Sonnet planifica, razona y toma decisiones. Llamarlo “ejecutor” no significa que siga un plan paso a paso escrito por otro modelo. La diferencia con un pensador está en cuánta incertidumbre resuelve con fiabilidad.
Anthropic lo cuenta con estas palabras: Sonnet destaca en el trabajo cotidiano bien delimitado y Opus conserva la ventaja en el trabajo abierto y complejo que exige juicio sostenido. Lo avisa incluso cuando Sonnet saca cifras parecidas en algunos benchmarks.
Retoque 2: explorar no siempre es sencillo 
“Localiza todos los consumidores de esta función” es una búsqueda acotada. Haiku la resuelve bien y barato.
“Descubre por qué perdemos pedidos” también es explorar, pero es una investigación. Hay que decidir qué es relevante sin reglas que lo digan. Esa exploración es trabajo de pensador y puede pedir el modelo más capaz que tengas.
Por eso el tercer grupo se llama aquí “exploradores y auxiliares”, y su definición habla de reglas claras, no de buscar.
Retoque 3: los pensadores no son “los que más tokens gastan” 
La diapositiva original decía que los pensadores son los que más tokens gastan. Lo quitaría. El consumo depende del modelo, del nivel de esfuerzo y de los pasos que necesite para terminar.
Artificial Analysis lo ha medido. En su índice de inteligencia, GPT-6 Astra empata con Fable 5.1 a 53 puntos usando unos 27.000 tokens de salida por tarea, frente a los 78.000 de Fable: un tercio. Y en su índice de agentes de código, Astra supera a GPT-5.6 Sol gastando también un tercio de sus tokens. Y al revés: en el análisis de Sonnet 5.5 vimos que en max gasta más tokens por tarea que ningún otro modelo medido. Lo que gasta un modelo se mide, no se deduce de su categoría.
Resuelve el camino antes de encargarlo y te sirve un modelo más barato
Una tarea de pensador se convierte en tarea de ejecutor cuando resuelves sus dudas antes. En la lección 4, «Fríeme a preguntas», el agente te pregunta por rondas hasta convertir un requisito de una línea en decisiones.
Entra en el curso →¿Qué dice el selector de modelos sobre la familia Claude? 
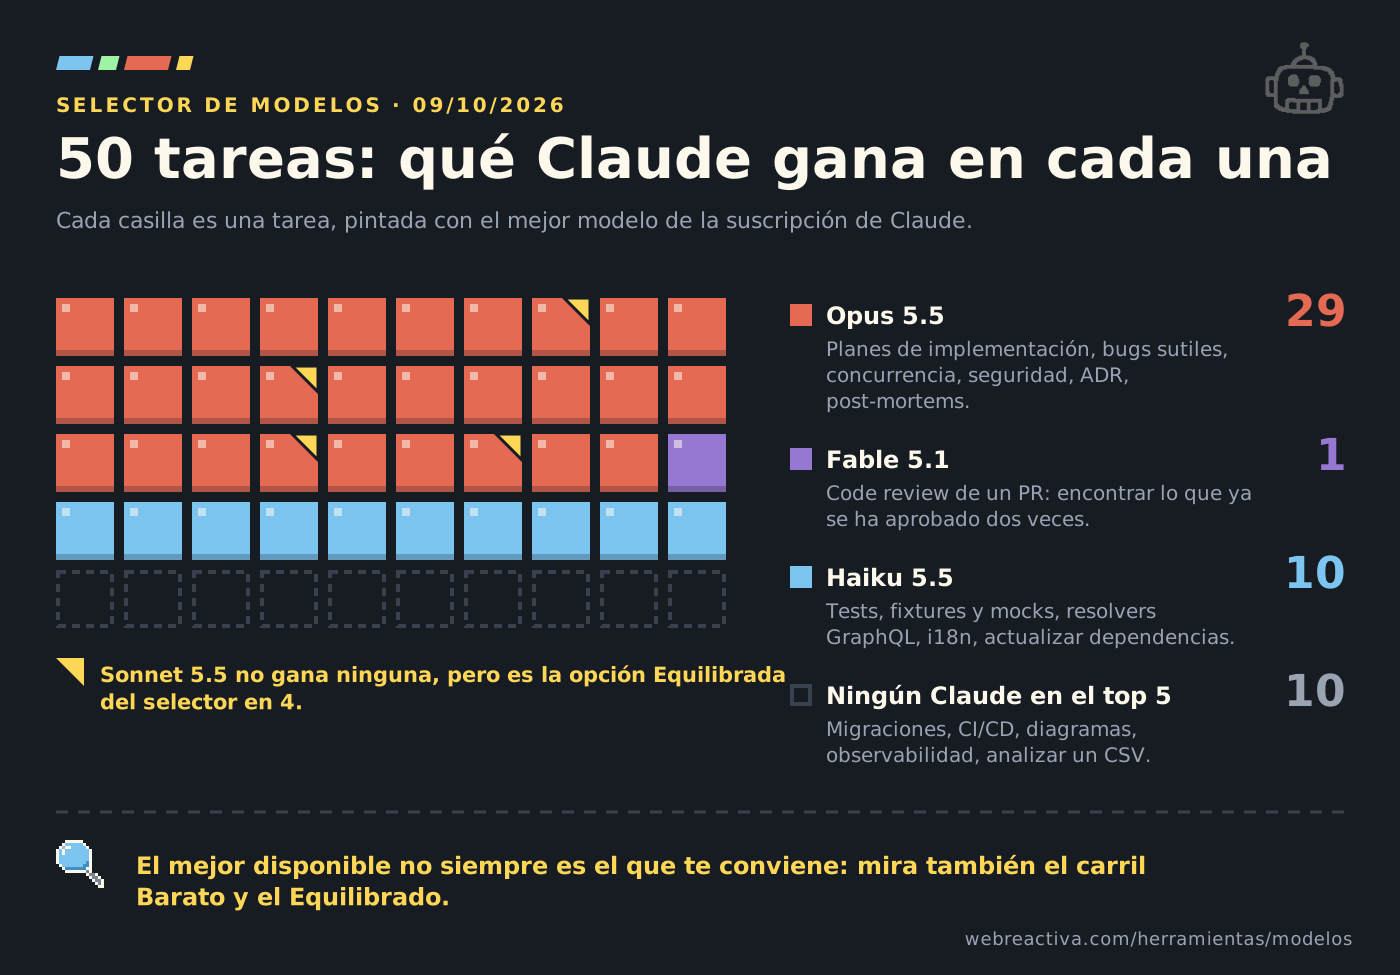
Dentro de una suscripción de Claude, Opus 5.5 es el mejor modelo disponible en 29 de las 50 tareas del selector, Haiku 5.5 en 10, Fable 5.1 en una y Sonnet 5.5 en ninguna. En las otras 10, ningún Claude entra en el top 5. Son los datos del selector de Web Reactiva a 9 de octubre de 2026, que salen de los rankings de uso real y benchmarks de OpenRouter.
Y si miras el top 5 completo de cada tarea, con todos los modelos del mercado y no solo los de Claude, Opus 5.5 es el número uno en 28 de las 50. Ningún otro modelo pasa de 10.
Ese reparto se lee mejor con la clasificación de arriba:
- Opus se queda con casi todo lo que exige juicio. De sus 29 tareas, 18 son de razonamiento: planes de implementación, ADR, esquemas de datos, threat modeling, post-mortems, comunicación difícil. Y las de código que gana son las que tienen trampa: concurrencia, autenticación, bugs sutiles.
- Haiku se queda con lo que tiene reglas claras. Tests, fixtures y mocks, resolvers GraphQL repetitivos, extracción de strings para i18n, actualizar dependencias. Trabajo de alcance cerrado que se puede comprobar. Entra en el top 5 de 13 tareas, casi siempre en tercer o cuarto puesto: no es el mejor en nada, pero cuesta 0,50 $ el millón de salida frente a los 20 $ de Opus.
- Fable gana una sola: el code review de un PR. Ahí lo que cuenta es encontrar lo que nadie ha visto, y un fallo que se escapa sale carísimo. Aparece también en el top 5 de la revisión de seguridad y de la caza de condiciones de carrera: siempre tareas de revisor severo.
- Sonnet nunca gana porque siempre aparece detrás de Opus. Está en el top 5 de nueve tareas, y en las nueve Opus va por delante. Lo curioso es cuáles son: componentes de UI, PRD, ADR, threat modeling, contratos, feedback de desempeño, post-mortems. Tareas de criterio y redacción, ninguna de código puro. En cuatro de ellas el selector lo elige como opción equilibrada: casi el gusto de Opus a la mitad de precio.
Que Sonnet no salga en las tareas de código no significa que programe mal: saca un 70,6 % en Terminal-Bench 4.0, cerca de Opus. Significa que en un ranking que pesa el precio, en código le comen el sitio modelos como GLM-5.3 Flash o Gemini 3.8 Flash, que cuestan una fracción. Si pagas Claude, esos no están en tu selector, y Sonnet vuelve a ser tu ejecutor.
Fíjate en lo de Sonnet. Si siempre eliges “el mejor disponible”, nunca usarías Sonnet. Si eliges “el que resuelve bien la tarea a menor coste”, Sonnet aparece en cuanto el camino está claro. El selector separa las dos preguntas en tres carriles por tarea: Equilibrado, Barato y Potente.
Si pagas Claude y quieres ver las 50 tareas con su modelo, la tienes en qué modelo usar con tu suscripción de Claude. Y si quieres ver a tres de ellos cara a cara, con precios y tareas donde compiten, abre el comparador de Haiku 5.5, Sonnet 5.5 y Opus 5.5.
¿Cuánto cuesta cada modelo de Claude por sesión de agente? 
Una sesión de agente de 25 pasos con caché de prompt cuesta unos 0,02 dólares con Haiku 5.5, 0,34 con Sonnet 5.5, 0,68 con Opus 5.5 y 1,50 con Fable 5.1. Es la misma cuenta que hace la calculadora de coste de un agente: un contexto que empieza en 4.000 tokens, crece 2.500 por paso y devuelve 400 de salida en cada vuelta.
| Modelo | Papel principal | Entrada / salida por 1M tokens | Sesión de 25 pasos con caché | Sin caché | Esfuerzo por defecto (API) |
|---|---|---|---|---|---|
| Haiku 5.5 | Explorador y auxiliar | 0,10 $ / 0,50 $ | ~0,02 $ | ~0,09 $ | medium |
| Sonnet 5.5 | Ejecutor con criterio | 2 $ / 10 $ | ~0,34 $ | ~1,80 $ | high |
| Opus 5.5 | Pensador y ejecutor de trabajo complejo | 4 $ / 20 $ | ~0,68 $ | ~3,60 $ | medium |
| Fable 5.1 | Pensador para los casos más exigentes | 10 $ / 50 $ | ~1,50 $ | ~9,00 $ | high |
Precios del catálogo de models.dev a 9 de octubre de 2026. La sesión no cuenta los tokens de razonamiento ni las llamadas que fallan, así que es un suelo, no una factura.
Dos lecturas rápidas:
- Entre Haiku y Fable hay un factor de unas 70 veces por sesión. Mandar trabajo mecánico al modelo grande no es “ir sobrado”: es pagar setenta veces lo mismo.
- La caché pesa más que el modelo. Opus con caché sale más barato que Sonnet sin ella. Si no la tienes bien montada, empieza por ahí antes de bajar de modelo; lo explico en la guía de prompt caching.
⚠️ Haiku 5.5 tiene una tarifa más alta para peticiones de más de 100.000 tokens. Si lo usas como agente principal con mucho contexto, pagarás esa tarifa casi siempre. Lo cuento con números en el análisis de Haiku 5.5.
Con suscripción la cuenta cambia de forma, pero no de fondo. Ahí no pagas tokens: pagas cuota consumida, espera y correcciones. Fable gasta tu límite semanal bastante más deprisa que Haiku, y eso también es coste.
¿Cuándo usar Claude Haiku? 
Usa Haiku cuando puedas describir bien la operación y comprobar fácilmente el resultado. La tarea tiene poco espacio para interpretar qué significa hacerla bien.
Ejemplos que encajan:
- Extraer de unos logs la fecha, el endpoint y el código de respuesta.
- Localizar los ficheros que usan una API concreta.
- Clasificar incidencias con una taxonomía que ya existe.
- Resumir cada documento con los mismos cinco campos.
- Aplicar una transformación repetitiva cuya salida puedes validar con un script.
Anthropic lo coloca justo ahí: resúmenes, clasificación, consultas, extracción y trabajo auxiliar para modelos más grandes. Y separa ese trabajo de la programación agéntica compleja, donde recomienda Sonnet u Opus. Que Haiku pueda escribir código no lo convierte en la mejor opción para llevar una funcionalidad entera. En Terminal-Bench 4.0 saca un 39,2 % frente al 70,6 % de Sonnet 5.5, y esa distancia no la compensa el precio si la tarea es “arregla este bug complicado tú solo”.
Donde brilla es multiplicado. Seis Haiku revisando un diff con seis criterios distintos cuestan menos que un Sonnet, y un modelo grande arbitra lo que encuentran. Si te interesa ese patrón, en cómo crear subagentes tienes los prompts de los subagentes de lectura, que son trabajo típico de Haiku.
🔼 Señal para subir a Sonnet: Haiku empieza a necesitar interpretar excepciones, relacionar resultados dispersos o decidir qué información es relevante sin una regla que lo diga.
Ojo con un detalle de la documentación: en low y con prompts largos de agente, Haiku es más propenso a saltarse una búsqueda, parar antes de tiempo o saltarse una comprobación. Para programar, la guía recomienda dejarlo en medium, su nivel por defecto, y pedirle explícitamente que verifique antes de cerrar.
¿Cuándo usar Claude Sonnet? 
Usa Sonnet cuando conoces el destino y necesitas que resuelva el recorrido. El requisito es verificable, pero implementarlo exige decisiones.
Ejemplos que encajan:
- Implementar una funcionalidad siguiendo los patrones del proyecto.
- Corregir un bug que sabes reproducir.
- Refactorizar un módulo con límites claros.
- Añadir tests a un comportamiento definido.
- Revisar un cambio contra unos criterios concretos.
No necesita que le des cada paso. Sí rinde bastante mejor cuando tiene claros el alcance, las restricciones y el resultado esperado. Es lo que en un equipo llamarías “una tarea bien escrita”.
Sonnet es también el que más se beneficia de que alguien haya pensado antes. Un plan de Opus partido en tareas cerradas es justo lo que Sonnet ejecuta bien y deprisa. Si ese reparto te suena, en Sonnet 5.5 vs Opus 5.5 explico cómo montar un Opus que coordina a varios Sonnet con subagentes de Claude Code.
🔼 Señal para subir a Opus: Sonnet implementa soluciones plausibles, pero no identifica el problema correcto, no anticipa efectos entre módulos o se le caen requisitos por el camino.
La pista más fiable es la segunda vuelta. Si después de corregirle una vez vuelve con otra solución plausible al mismo problema equivocado, no le falta esfuerzo. Le falta capacidad para ver el problema.
¿Cuándo usar Claude Opus? 
Usa Opus cuando una parte importante de la tarea consiste en decidir qué hay que hacer y por qué. Descubrir, decidir y ejecutar, en la misma sesión.
Ejemplos que encajan:
- Diagnosticar un fallo intermitente sin una reproducción sencilla.
- Diseñar una migración que afecta a varios subsistemas.
- Comparar alternativas de arquitectura y sus consecuencias.
- Auditar un repositorio y priorizar lo que encuentras.
- Ejecutar un cambio largo ajustando el plan a lo que va apareciendo.
Anthropic pone justo migraciones y auditorías amplias entre los ejemplos de Opus 5.5, y su guía de selección lo dice sin rodeos: “la mayoría de cargas de trabajo empiezan con Claude Opus 5.5”. Para tareas complejas propone empezar por Opus y optimizar después, bajando el esfuerzo o pasando a un modelo más eficiente. Es el “si dudas, empieza aquí” de la familia.
Mi regla para decidir si compensa:
🎯 Si un enfoque equivocado puede generar mucho trabajo con pinta de correcto, invierte capacidad antes de implementar.
El peligro de un modelo menos capaz en una tarea de pensador no es que falle. Es que acierte en apariencia. Te entrega cuatrocientas líneas limpias, con tests en verde, que resuelven un problema que no era el tuyo. Revisar eso cuesta más que haber pagado Opus desde el principio.
Y no hace falta Opus al máximo. En el análisis de Opus 5.5 vimos que en medium, su nivel por defecto, rinde en el índice de Artificial Analysis como Opus 5 en max.
Elegir modelo ya no va de cuál es el más listo, sino de qué le encargas a cada uno y cuánto camino le dejas resuelto. De eso hablamos cada domingo en la newsletter: cómo usamos la IA en el desarrollo real, con lo que funciona y lo que no. Gratis, ya somos +7.200.
Quiero esa dinamita 🧨¿Cuándo compensa Claude Fable frente a Opus? 
Fable compensa cuando Opus, incluso en xhigh o max, se queda corto en tu tarea, o cuando lo has comparado en tu caso y la mejora paga el consumo y la espera. No es el siguiente peldaño automático.
Encaja en la parte más alta de los pensadores: proyectos ambiciosos, investigaciones largas y sesiones autónomas de muchas horas que cruzan repositorios y etapas con poca supervisión. Así lo presenta Anthropic.
Pero no te montes una escalera rígida de “Fable siempre gana a Opus”. Artificial Analysis pone a Opus 5.5 en max en lo más alto de su índice de inteligencia, con 58 puntos, y por delante de Fable 5.1 en sus evaluaciones de trabajo profesional: 111 puntos Elo más en GDPval-AA y 143 más en AA-Briefcase. La documentación oficial va en la misma línea: Fable es para cuando tus pruebas con Opus en xhigh o max siguen quedándose cortas en razonamiento exigente o trabajo agéntico de largo recorrido. El nombre de la gama no sustituye a probar las versiones que tienes disponibles hoy.
Dónde sí lo veo claro:
- Revisión de código de un PR que importa. Es la única tarea donde el selector lo pone por delante de Opus: encontrar lo que el equipo ya ha aprobado dos veces.
- Sesiones autónomas muy largas donde quieres un orquestador que aguante horas sin perder el hilo.
- El atasco de verdad: el bug que lleva tres días resistiéndose a Opus en
high.
Si te decides, empieza en high, no en max. En el análisis de Fable 5.1 cuento por qué high es el punto dulce y max dispara el gasto sin una mejora proporcional.
🔽 Señal para bajar a Opus: has usado Fable dos semanas y no recuerdas ninguna tarea que Opus no hubiera sacado. Eso es pagar dos veces y media por tranquilidad.
¿Qué criterios usar para decidir entre un modelo ligero y uno más capaz? 
Siete criterios: ambigüedad, dependencias, verificación, autonomía, coste del fallo, frecuencia y espera tolerable. Cuantos más caen a la derecha de la tabla, más capaz tiene que ser el modelo.
| Criterio | Favorece un modelo ligero (Haiku, Sonnet) | Favorece un modelo más capaz (Opus, Fable) |
|---|---|---|
| Ambigüedad | Está claro qué significa terminar | Hay que descubrir el problema o definir la solución |
| Dependencias | La tarea es local e independiente | Una decisión afecta a varias partes |
| Verificación | Puedes comprobar la salida automáticamente | Una respuesta convincente puede ocultar errores |
| Autonomía | Vas a revisar cada paso relevante | Tiene que trabajar y recuperarse sin supervisión frecuente |
| Coste del fallo | Repetir la tarea es barato | Un mal enfoque provoca mucho retrabajo |
| Frecuencia | Se repite cientos de veces | Es una decisión ocasional de mucho valor |
| Espera tolerable | Necesitas respuesta inmediata | Puedes esperar a cambio de una mejora que puedas comprobar |
Dos criterios mandan más que el resto en el día a día: ambigüedad y verificación.
Si la tarea es ambigua pero el resultado se verifica solo (un test que pasa o no pasa), puedes probar con un modelo más ligero y dejar que los tests hagan de red. Si la tarea está clara pero el resultado no se puede verificar fácilmente (una decisión de arquitectura, un texto para un cliente), el modelo capaz te ahorra el riesgo de no enterarte del error.
La frecuencia es el criterio que más dinero mueve. Una tarea que repites trescientas veces al mes merece una tarde de pruebas para ver si Haiku la saca. Una decisión de arquitectura al trimestre no merece ese ahorro.
Tu IA puede mentirte
Si lo puedes verificar, lo puedes delegar en un modelo más barato
La verificación es el criterio que más deja bajar de modelo. En esta masterclass montamos el ciclo anticaos: skills que revisan, pruebas en navegador con Playwright, casos Gherkin y revisión adversarial entre modelos, para que un ejecutor barato no te cuele una respuesta convincente.
Ver la masterclass →Masterclass en directo · Métodos + casos Gherkin
¿Subo el esfuerzo o cambio de modelo? 
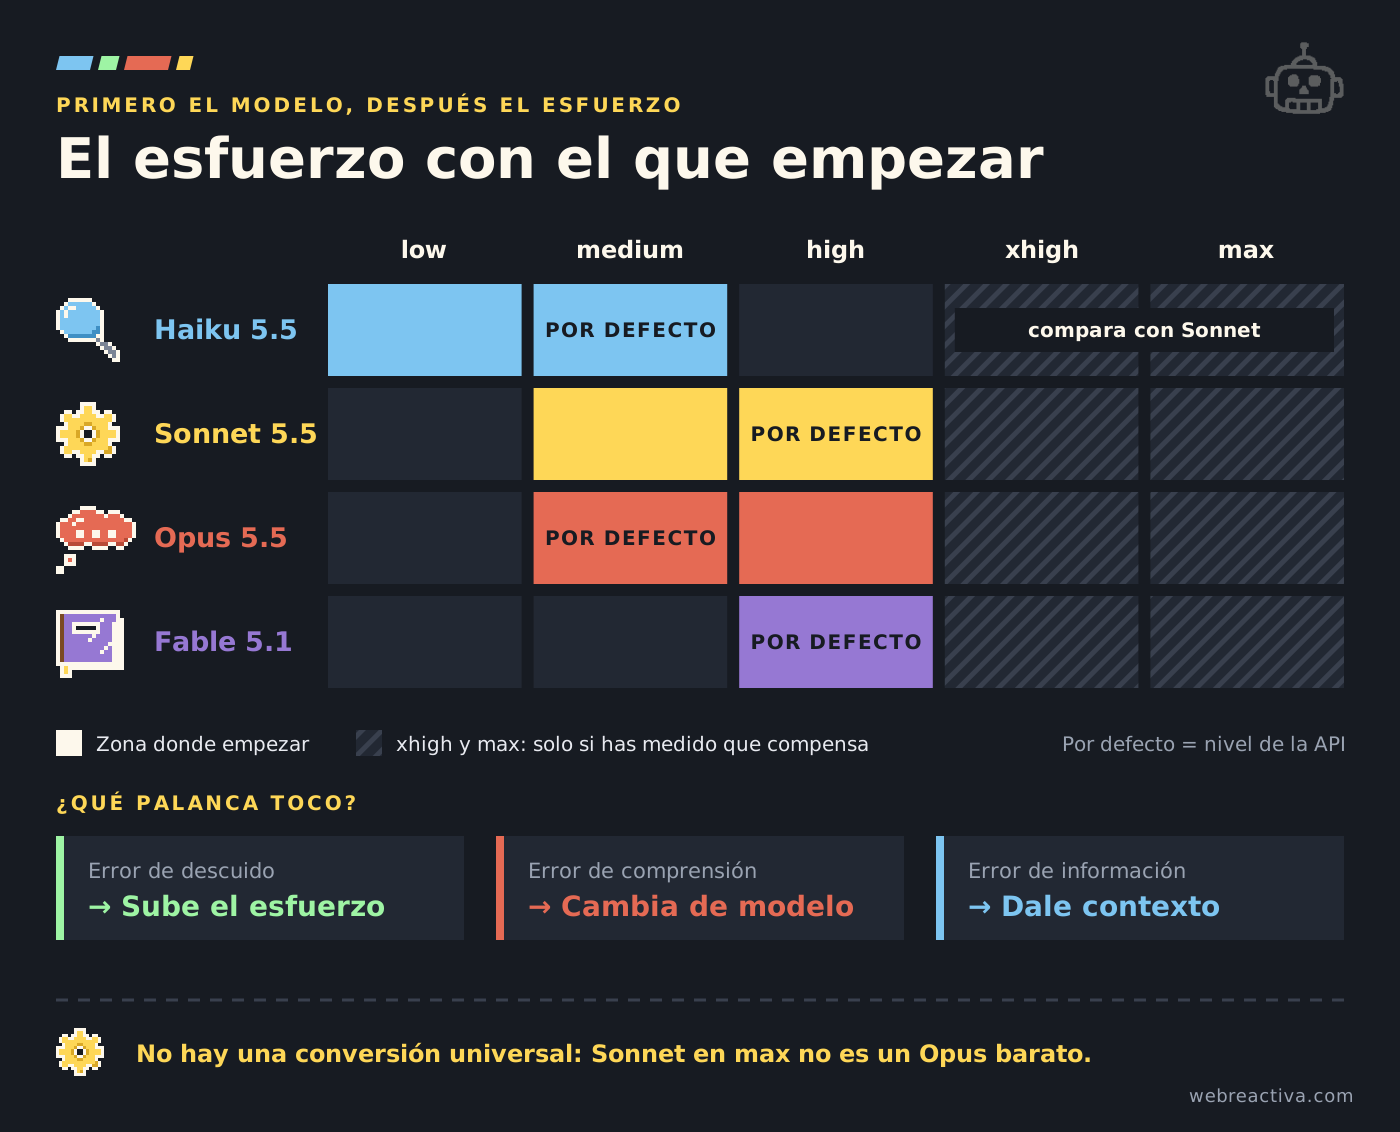
Primero eliges la capacidad adecuada para el problema y después ajustas el esfuerzo. El modelo decide qué problemas puede resolver. El esfuerzo decide cuánto trabajo dedica a resolverlos.
Una vez estás en un modelo razonable, el esfuerzo suele ser la palanca más barata. La propia guía de Anthropic lo dice: ajustar el esfuerzo es a menudo mejor palanca que cambiar de modelo. Cambia de modelo cuando el fallo es de comprensión, no de cuidado.
El esfuerzo (effort en la API, los niveles low, medium, high, xhigh y max) cambia cuánto razona el modelo antes de responder. En Claude afecta a todos los tokens de la respuesta: el texto, el razonamiento y las llamadas a herramientas. Con menos esfuerzo hace menos llamadas y más escuetas. No es un control de longitud y no garantiza una respuesta correcta.
Hay diferencias entre modelos que conviene saber:
- Opus y Haiku parten de
mediumen la API; Sonnet y Fable, dehigh. Un modelo más capaz no implica más esfuerzo por defecto. - Para Sonnet en programación agéntica bien especificada, la guía recomienda empezar en
mediumy pasar ahighen tareas más difíciles o largas. - Para Haiku, la guía recomienda
mediumtambién para programar,lowpara chat y tareas cortas, yxhighomaxsolo si lo has medido, comparándolo antes con Sonnet en rendimiento, coste y velocidad.
Como punto de partida:
| Esfuerzo | Cuándo lo probaría |
|---|---|
low |
Extracción, transformación, cambios locales y respuestas directas |
medium |
Implementación delimitada, diagnóstico habitual y comparar opciones |
high |
Depuración difícil, revisión cuidadosa y muchas restricciones relacionadas |
xhigh o max |
Solo donde hayas comprobado que la mejora compensa la espera y el consumo |
Y esta es la regla que uso para saber qué palanca tocar según lo que veo:
| Lo que observas | Qué probar |
|---|---|
| Entiende el problema, pero se salta comprobaciones o casos límite | Subir el esfuerzo |
| La respuesta es correcta, pero tarda demasiado | Bajar el esfuerzo |
| Insiste en un enfoque equivocado o pierde restricciones importantes | Cambiar a un modelo más capaz |
| Le faltan datos, acceso al código o una reproducción | Darle esas evidencias (ningún modelo las adivina) |
| Resuelve bien una tarea que se repite mucho | Probar un modelo más ligero |
| Encadena intentos sin aprender de los errores | Parar y revisar contexto, enfoque y modelo |
No asumas que “Sonnet al máximo equivale a Opus” o que “Haiku en max es un Sonnet barato”. Son configuraciones distintas que hay que comparar, y no hay una conversión universal entre capacidad y esfuerzo. De hecho, Sonnet en max es de los que más tokens gasta por tarea: puede salirte más caro que Opus en medium y resolver peor.
🧭 Si no sabes qué palanca tocar, mira qué tipo de error comete. Errores de descuido (se salta un caso) piden esfuerzo. Errores de comprensión (resuelve otro problema) piden modelo. Errores de información (inventa lo que no ve) piden contexto.
Cada semana sale un modelo nuevo y cada uno trae su propio nivel de esfuerzo por defecto. Cada domingo te cuento con calma cuáles merecen la pena para programar y cómo los estamos usando, junto a 12 recursos seleccionados. +7.200 developers, gratis desde 2018.
Suscríbete gratis →¿Cómo comprobar con tus propias tareas qué modelo te conviene? 
Coge diez tareas reales, pásalas por dos o tres modelos con el mismo contexto y anota cuatro cosas: si aceptaste el resultado, el tiempo total, el consumo y las correcciones que tuviste que hacer. Con eso tienes una regla tuya que sigue valiendo cuando cambien las versiones.
El orden importa:
- Compara modelos con un esfuerzo razonable (el de por defecto o
medium). No mezcles las dos variables a la vez. - Elige el modelo más ligero que acepta el resultado en la mayoría de tareas de cada tipo.
- Después afina el esfuerzo del elegido, subiendo solo donde veas errores de descuido.
Una plantilla para la hoja de cálculo:
| Tarea | Tipo (pensador / ejecutor / explorador) | Modelo y esfuerzo | ¿Aceptado? | Tiempo | Consumo | Correcciones |
|---|---|---|---|---|---|---|
| Extraer errores 5xx de los logs de ayer | Explorador | Haiku · low |
Sí | 40 s | 0,01 $ | 0 |
| Añadir paginación al listado de pedidos | Ejecutor | Sonnet · medium |
Sí | 6 min | 0,30 $ | 1 |
| Diagnosticar la pérdida de pedidos de los martes | Pensador | Opus · high |
Sí | 25 min | 1,10 $ | 2 |
Las cifras de la plantilla son de ejemplo: lo que importa es medir las tuyas.
Elige tareas que de verdad haces, no ejercicios. Mezcla los tres tipos. Y mete al menos una tarea con trampa, de las que parecen de ejecutor pero esconden una decisión. Es ahí donde descubres si tu clasificación está bien calibrada.
Cuando tengas la tabla, la regla sale casi sola. Algo como: “explorador a Haiku siempre; ejecutor a Sonnet salvo que toque autenticación o datos; pensador a Opus en medium, a high si es un bug; Fable solo para revisar PR grandes”. Escríbela en tu CLAUDE.md o en la definición de tus subagentes y deja de decidirlo cada vez.
TL;DR 
- Elige modelo por cuánto camino está resuelto y cuánto juicio tiene que poner la IA, no por el tamaño de la tarea ni la longitud del prompt.
- Pensadores (Opus y Fable) descubren el enfoque: les das un objetivo, restricciones y evidencias. Ejecutores (Sonnet) completan tareas delimitadas: les das un requisito y criterios de aceptación. Exploradores y auxiliares (Haiku) buscan, extraen y transforman con reglas claras.
- Los ejecutores también piensan, explorar no siempre es sencillo y la categoría no te dice cuántos tokens va a gastar un modelo.
- En el selector de Web Reactiva, dentro de Claude, Opus gana 29 de 50 tareas, Haiku 10 y Fable una. Sonnet es la opción equilibrada en cuatro.
- Una sesión de agente de 25 pasos con caché cuesta ~0,02 $ con Haiku, ~0,34 $ con Sonnet, ~0,68 $ con Opus y ~1,50 $ con Fable.
- Fable no es el siguiente peldaño automático: pruébalo cuando Opus en
xhighomaxse quede corto. - Primero el modelo, después el esfuerzo. Errores de descuido piden esfuerzo, errores de comprensión piden modelo y errores de información piden contexto.
- Mide con diez tareas reales y escribe tu regla en el
CLAUDE.md.
Preguntas frecuentes 
¿Qué modelo de Claude es mejor para programar? 
Depende de la tarea. Para planificar, depurar lo difícil y decidir arquitectura, Opus 5.5. Para implementar tareas bien definidas, Sonnet 5.5. Para tests, fixtures y cambios mecánicos, Haiku 5.5. Si dudas, la propia Anthropic recomienda empezar por Opus y bajar después.
¿Cuál es la diferencia entre Haiku, Sonnet y Opus? 
Cuánta incertidumbre resuelven con fiabilidad y cuánto cuestan. Haiku necesita que le digas la operación y cuesta 0,10 $ el millón de tokens de entrada. Sonnet resuelve el recorrido si el destino está claro, a 2 $. Opus descubre el destino y el recorrido, a 4 $.
¿Cuándo merece la pena Claude Fable en lugar de Opus? 
Cuando Opus, incluso en xhigh o max, no llega al nivel que necesitas, o cuando lo has comparado con tus tareas y la mejora compensa pagar dos veces y media más. Encaja en revisiones de código críticas y sesiones autónomas muy largas.
¿Es Sonnet un “Opus barato”? 
Depende de la tarea. En las de criterio y redacción, el selector lo coloca justo así: detrás de Opus y a la mitad de precio. En código es otra cosa: un ejecutor rápido para tareas con el camino claro. Y en trabajo abierto, Opus mantiene la ventaja aunque los benchmarks se parezcan.
¿Puedo usar Haiku para programar? 
Sí, para trabajo de alcance cerrado y comprobable: tests, funciones concretas, regex, resolvers repetitivos, migraciones mecánicas. No es buena opción para llevar una funcionalidad entera de forma autónoma.
¿Subir el esfuerzo de Sonnet al máximo lo iguala a Opus? 
No hay una equivalencia universal. Sonnet en max puede gastar más tokens que Opus en medium y seguir sin ver un problema de comprensión. Si el fallo es de enfoque, cambia de modelo; si es de descuido, sube el esfuerzo.
¿Qué esfuerzo usa cada modelo de Claude por defecto? 
En la API, Opus 5.5 y Haiku 5.5 parten de medium, y Sonnet 5.5 y Fable 5.1 de high. Para Sonnet en programación agéntica bien especificada, la guía de Anthropic recomienda empezar en medium.
¿Cómo combino varios modelos de Claude en el mismo proyecto? 
Con subagentes. Una sesión principal en Opus que planifica y revisa, subagentes en Sonnet que implementan tareas cerradas y subagentes en Haiku para búsquedas, extracción y revisiones baratas. En Claude Code se elige el modelo con el campo model de cada subagente.
¿El número de ficheros que toca una tarea sirve para elegir modelo? 
Poco. Cambiar cien ficheros siguiendo una regla es trabajo de Haiku. Entender una condición de carrera en dos funciones es trabajo de Opus. Lo que cuenta es la ambigüedad y lo que cuesta equivocarse, no el volumen.
¿Esta clasificación vale para otras familias de modelos? 
El criterio sí: cuánto camino está resuelto y cuánto juicio aporta el modelo vale para cualquier familia. Los modelos concretos cambian. Si usas OpenAI, en GPT-6 Sol y Luna vs Opus 5.5 tienes su reparto, y el selector te da el modelo por tarea en cada suscripción.
Fuentes 
- Anthropic, Models overview (Claude Platform Docs)
- Anthropic, Choosing the right model
- Anthropic, Effort
- Anthropic, Claude Haiku 5.5
- Anthropic, Claude Sonnet 5.5
- Anthropic, Claude Opus 5.5
- Anthropic, Claude Fable
- Artificial Analysis, análisis de Claude Opus 5.5
- Artificial Analysis, Benchmarking GPT-6 Astra
- Selector de modelos de Web Reactiva (datos de OpenRouter a 9 de octubre de 2026)
- Catálogo de precios de models.dev (a 9 de octubre de 2026)
🧨 Última oportunidad para recibir la dinamita que mereces sobre programación con IA el próximo domingo: Suscríbete gratis a Web Reactiva en https://webreactiva.com/newsletter

Escrito con la ayuda de la IA generativa de Claude, fuentes fidedignas y con un human in the loop:
Dani Primo.
12 recursos para developers cada domingo en tu bandeja de entrada
Además de una skill práctica bien explicada, trucos para mejorar tu futuro profesional y una pizquita de humor útil para el resto de la semana. Gratis.