Claude Fable 5.2 vs Opus 5.5: precio, benchmarks y cuál usar
Tabla de contenidos
Claude Fable 5.2 ha salido hoy, 9 de noviembre de 2026, y esta vez el “.2” sí trae números gordos. Sube 16,7 puntos en FrontierCode 2.0 respecto a Fable 5.1, cuesta un 20 % menos por token y genera hasta un 30 % más rápido. Las tres cosas a la vez no suelen venir en el mismo paquete.
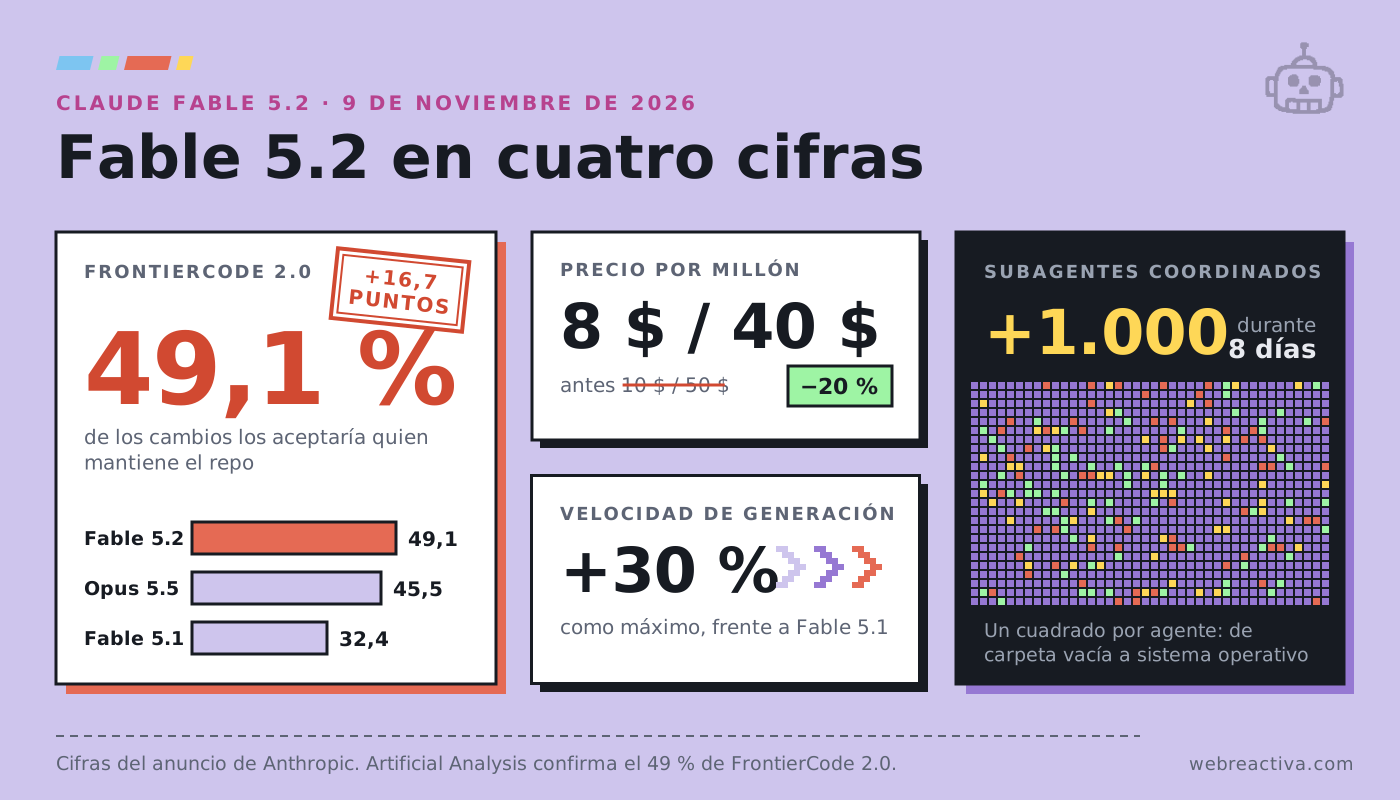
Y llega con una demostración de las que dan para discutir en la comida: Anthropic cuenta que un ingeniero le pidió un sistema operativo partiendo de una carpeta vacía, y que el modelo coordinó más de 1.000 subagentes durante ocho días hasta tener algo que arranca en un portátil.
A su lado sale Mythos 5.2, el mismo modelo con menos frenos, reservado a organizaciones verificadas de ciberseguridad y ciencias de la vida. Yo puedo usar Fable, igual que tú, así que este post va sobre todo de Fable.
Lo escribo en las primeras horas, con el anuncio oficial, la página del benchmark FrontierCode 2.0 y la primera medición independiente, la de Artificial Analysis, que ha llegado el mismo día. Reviews de gente que lo haya exprimido en repos de verdad todavía no hay. Lo que vas a encontrar:
- Qué cambia entre Fable 5.1 y Fable 5.2, con la ficha técnica.
- El precio nuevo, el fast mode y cuándo tiene sentido pagarlo.
- Los benchmarks oficiales frente a GPT-6 Astra, Gemini 4 Carbon y Opus 5.5, con los asteriscos en su sitio.
- Lo que dice Artificial Analysis: número 1 de su índice, y 26,50 $ por tarea en
max. - La cuenta que más dudas genera: ¿sale más barato Fable 5.2 que Opus 5.5 por tarea?
- Los experimentos con 1.000 agentes y qué demuestran (y qué no).
- Cómo encaja en tu harness: advisor u orchestrator.
- Qué sabemos de Mythos 5.2 y de las salvaguardas de Fable.
⚠️ Este post se escribió el mismo día del lanzamiento. La tabla grande de benchmarks la ha medido Anthropic; la única medición externa por ahora es la de Artificial Analysis, y va en su propia sección. Lo que aguanta el paso de las semanas es la forma de leer la tabla y la cuenta de coste por tarea; los números concretos pueden moverse cuando lleguen más mediciones de terceros.
¿Qué es Fable 5.2 y qué cambia respecto a Fable 5.1? 
Fable 5.2 es el modelo público más capaz de Anthropic, pensado para problemas técnicos largos y difíciles: ingeniería de software, programación agéntica, matemáticas e investigación científica. Respecto a Fable 5.1 cambia en tres frentes medibles: rinde más en trabajo agéntico, cuesta menos y va más rápido.
El planteamiento de la familia sigue igual. Anthropic lo escribe sin adornos en el anuncio: Fable y Mythos son el mismo modelo subyacente. Fable lleva clasificadores de seguridad para ciberseguridad y biología, y por eso lo puede usar cualquiera. Mythos va sin parte de esas restricciones y solo llega a organizaciones verificadas.
| Especificación | Fable 5.2 |
|---|---|
| Fecha de lanzamiento | 9 de noviembre de 2026 |
| ID de modelo | claude-fable-5-2 |
| Gemelo restringido | Mythos 5.2 (programas de verificación) |
| Precio | 8 $ entrada / 40 $ salida por millón de tokens |
| Fast mode | 16 $ / 80 $, hasta 2,5 veces la generación normal |
| Velocidad | Hasta un 30 % más rápido que Fable 5.1 |
| Ventana de contexto | 1 millón de tokens, texto e imagen (dato de Artificial Analysis) |
| Niveles de esfuerzo | low, medium, high, xhigh, max |
| Esfuerzo por defecto | medium en las apps de Claude y en Claude Code |
| Disponibilidad | Planes de pago, Claude Platform, AWS, Google Cloud y Azure |
| Pesos abiertos | No |
El anuncio no menciona la ventana de contexto. El dato lo da Artificial Analysis en su ficha del modelo: 1 millón de tokens, con entrada de texto e imagen. El máximo de salida sigue sin aparecer en ninguna de las dos fuentes, así que no te lo voy a inventar.
Hay un detalle de planes que te interesa si pagas una suscripción. Según el anuncio, Fable entra en los planes Pro y en los asientos estándar de Team hasta el 50 % del límite semanal de uso. No es barra libre: es media semana de Fable y la otra media con el resto de la familia.
Y otro detalle que cambia el tono del lanzamiento. Anthropic no recomienda Fable para todo. Su consejo literal es empezar con Opus 5.5, al que llama su modelo más fuerte para el día a día, y subir a Fable solo cuando la tarea lo pida. Fable 5.2 es la marcha larga, no la primera.
🔑 Fable 5.2 no viene a sustituir a tu modelo de diario. Viene a ocupar el sitio de “esto es demasiado grande o demasiado difícil para Opus”, y a hacerlo por menos dinero que su versión anterior.
¿Cuánto cuesta Fable 5.2 y cuándo compensa el fast mode? 
Fable 5.2 cuesta 8 dólares por millón de tokens de entrada y 40 por millón de salida. Fable 5.1 costaba 10 y 50, así que la rebaja es del 20 % en los dos sentidos. La cuenta oficial de Claude en X lo confirmó con esas mismas cifras.
Para ponerlo en la escala de la familia:
| Modelo | Entrada (por millón) | Salida (por millón) |
|---|---|---|
| Opus 5.5 | 4 $ | 20 $ |
| Opus 5.5 fast | 8 $ | 40 $ |
| Fable 5.2 | 8 $ | 40 $ |
| Fable 5.2 fast | 16 $ | 80 $ |
| Fable 5.1 | 10 $ | 50 $ |
Fíjate en la coincidencia: Fable 5.2 en modo normal cuesta lo mismo que Opus 5.5 en fast mode. Por el mismo dinero eliges entre un Opus con prisa o un Fable a su ritmo.
El fast mode de Fable duplica el precio a cambio de generar tokens hasta 2,5 veces más rápido. Está disponible en Claude Code, en Claude Platform, en Google Cloud y en Microsoft Foundry. El de Mythos solo lo reciben las organizaciones de los programas de verificación.
Aquí conviene separar dos velocidades que se mezclan con facilidad:
- Velocidad de generación: cuántos tokens por segundo escribe el modelo. Es lo que mejora el fast mode y lo que mide ese “hasta un 30 % más rápido”.
- Duración de la tarea: cuánto tarda en terminar el trabajo. Depende de cuántos tokens necesita, de cuántas herramientas llama y de si se monta subagentes.
Un modelo que escribe un 30 % más rápido pero decide lanzar veinte subagentes no termina antes. Y uno que resuelve con la mitad de tokens termina antes aunque escriba igual de rápido.
¿Cuándo pagaría yo el doble? Cuando lo caro sea mi espera. Una sesión interactiva con alguien mirando la pantalla, un incidente en producción, una demo. Para un agente que trabaja de noche mientras duermes, el fast mode es pagar el doble por llegar antes a un sitio donde no te espera nadie.
💡 El precio por token te dice lo que cuesta cada palabra. La factura depende de cuántas palabras necesita el modelo para terminar. En agentes, además, casi todo el coste es contexto que se reenvía en cada paso, y ahí manda la caché de prompts más que la tarifa.
Los precios de caché tampoco están en el anuncio; los recoge Artificial Analysis: escribir en caché cuesta 10 $ por millón con caducidad de 5 minutos y 16 $ con caducidad de una hora, y leer de caché, 0,20 $. Ese último número es el mismo que paga Opus 5.5 por leer de su caché. En una sesión de agente, donde casi todo lo que se factura es contexto releído, la distancia con Opus se estrecha: Fable 5.2 solo cuesta el doble en lo que no se lee de caché: la entrada nueva, la escritura en caché y la salida. En el mapa de modelos para programar tienes la cuenta de una sesión de 25 pasos con Fable 5.1, que ahora toca rehacer a la baja.
Herramienta gratis · Calculadora
¿Cuánto costaría tu agente con Fable 5.2?
A 8 y 40 dólares el millón, lo que decide la factura de Fable 5.2 es cuántos pasos da tu agente y cuánto contexto reenvía en cada uno. Mete tus números y compara el resultado con lo que pagas hoy.
Le das
Los pasos y el contexto de tu agente
Te devuelve
Lo que cuesta una ejecución y lo que cuesta el mes
¿Qué dicen los benchmarks de Fable 5.2 frente a GPT-6 Astra y Gemini 4 Carbon? 
Fable 5.2 gana en la mayoría de las pruebas que publica Anthropic, pierde en una frente a Gemini 4 Carbon y deja saltos de 20 puntos o más sobre Fable 5.1 en cinco de ellas. Esta es la tabla con los benchmarks que más importan a quien programa:
| Benchmark | Fable 5.2 | Fable 5.1 | Opus 5.5 | GPT-6 Astra | Gemini 4 Carbon |
|---|---|---|---|---|---|
| FrontierCode 2.0 | 49,1 % | 32,4 % | 45,5 % | 42,8 % | 41,1 % |
| FrontierSWE v2 | 69,9 % | 56,3 % | 62,3 % | 65,5 % | 61,2 % |
| AutomationBench | 51,4 % | 31,4 % | 42,5 % | 41,4 % | 53,9 % |
| Terminal-Bench-Science 0.1 | 74,6 % | 52,6 % | 58,7 % | 68,1 % | 64,8 % |
| OSWorld 2.1 | 89,3 % | 83,5 % | 87,2 % | 79,5 % | 81,5 % |
| WANDR (búsqueda agéntica) | 82,1 % | 68,7 % | 72,3 % | — | — |
| Humanity’s Last Exam | 74,2 % | 65,6 % | 67,7 % | 57,2 % | — |
| Chartography | 73,4 % | 44,8 % | 64,4 % | 71,0 % | 72,5 % |
| Remote Labor Index | 41,3 % | 17,9 % | 21,3 % | 20,8 % | — |
| RoboDojo Sim | 64,9 % | 27,6 % | 39,4 % | 29,8 % | — |
Fuente: anuncio de Anthropic del 9 de noviembre de 2026. Cada modelo va en su esfuerzo más alto disponible salvo que se indique otra cosa.
Esa es mi selección. La tabla completa, tal como la publica Anthropic, lleva además las filas de ciberseguridad y proteínas (que son de Mythos 5.2) y las dos de AA-Briefcase:
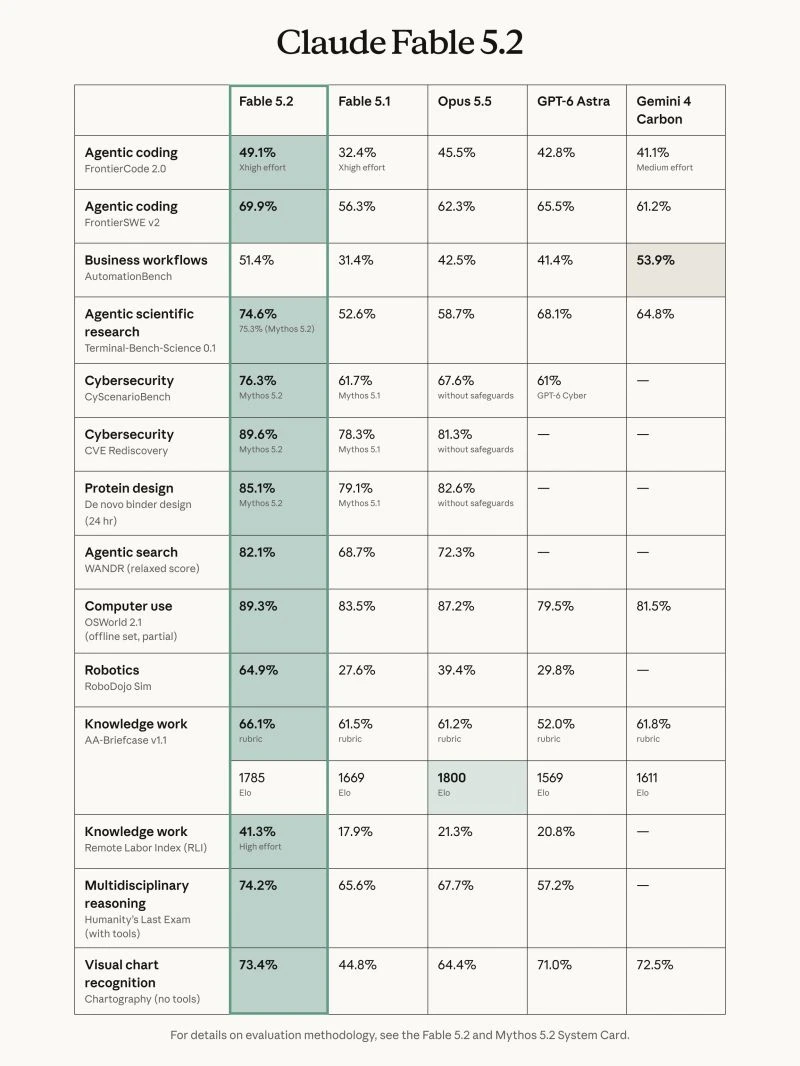
El gráfico ordena el salto sobre Fable 5.1 en puntos porcentuales:
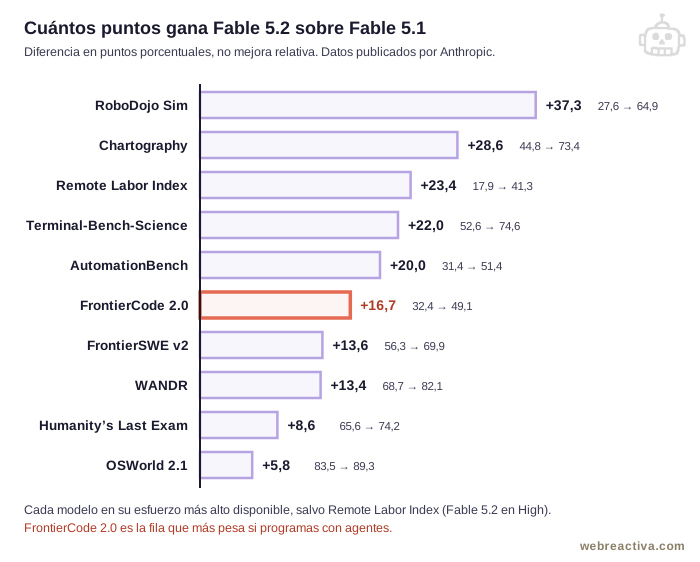
Con Fable 5.1 el salto grande estaba en un solo sitio, Terminal-Bench-Science, y el resto eran mejoras finas. Aquí el dibujo es distinto: cinco benchmarks suben 20 puntos o más, y el que menos sube (OSWorld) ya estaba en el 83 %.
El dato que más me llama la atención no es de código. Remote Labor Index pasa de 17,9 % a 41,3 %, más del doble, y deja a Opus 5.5 y a GPT-6 Astra en torno al 21 %. Es un benchmark de trabajo remoto de principio a fin, del que se encarga a un freelance. Y Fable lo consigue en high, sin llegar a su esfuerzo máximo.
Ahora, los asteriscos. Son unos cuantos y cambian cómo se lee la tabla:
- Esta tabla la ha medido Anthropic. La primera medición de fuera, la de Artificial Analysis, confirma algunas filas y enfría otras; la tienes dos secciones más abajo. Los evaluadores externos que cita el anuncio (el UK AI Security Institute, Frontier Design y METR) trabajaron la parte de seguridad, no estos números.
- Los niveles de esfuerzo no coinciden entre columnas. En FrontierCode, Fable va en
xhighy Gemini 4 Carbon enmedium. No es la misma carrera. - Fable 5.2 no gana todo. Gemini 4 Carbon le saca 2,5 puntos en AutomationBench. Y en AA-Briefcase, el benchmark de trabajo de oficina de Artificial Analysis, Fable lidera en rúbrica (66,1 %) pero en Elo sigue por detrás de Opus 5.5: 1.785 frente a 1.800.
- Hay pruebas parciales o internas. OSWorld 2.1 usa un subconjunto offline, WANDR una puntuación “relajada” y RoboDojo lo ejecutó Anthropic por su cuenta para todos los modelos.
- Tabla y gráficos no siempre dan la misma cifra. En Chartography, la tabla da 73,4 % a esfuerzo máximo; el gráfico del propio anuncio dice 66,4 % en
medium. Las dos son ciertas. Miden configuraciones distintas. - Los testimonios no son auditorías. Una nota al pie avisa de que ninguna de las organizaciones externas citadas revisó el anuncio ni la system card, y que no tienen por qué estar de acuerdo con lo que dicen.
⚠️ Cuando un laboratorio publica una tabla donde su modelo gana casi todo, la pregunta útil es qué configuración ha elegido para cada columna. Aquí Anthropic lo indica en las notas, que ya es más de lo habitual, pero hay que leerlas.
¿Y por qué mejora tanto en tareas largas y tan poco, en proporción, en un examen como Humanity’s Last Exam? Porque el salto está en sostener el trabajo: planificar, repartir, verificar y seguir. Eso es justo lo que no depende solo del modelo. Depende también del harness que lo envuelve, y de que tú le des un flujo que seguir.
Un modelo que aguanta ocho días necesita reglas desde el minuto uno
Fable 5.2 sube donde hay que sostener una tarea larga, y ahí lo que le des al empezar pesa más que el modelo. En el curso escribes el AGENTS.md de la sesión regla a regla y dejas que el agente te fría a preguntas antes de tocar código, sobre un proyecto real.
Ver el curso en vídeo →¿Qué mide FrontierCode 2.0 y por qué es el número que más te importa? 
FrontierCode 2.0 mide si el cambio que hace un agente en un repositorio open source lo aceptaría quien mantiene ese repositorio. No basta con que pasen los tests. Es el benchmark de la tabla que más se parece a tu trabajo, y por eso es el que yo miraría primero.
Lo publica Cognition, la empresa de Devin. Según su página, la versión 2.0 tiene 132 tareas privadas creadas por mantenedores sobre sus propios repositorios. La corrección combina tests, rúbricas y verificadores con criterios que pone cada mantenedor: que funcione, que traiga tests, que no toque más de la cuenta, que respete el estilo y las convenciones del proyecto. Y que arregle todas las apariciones del bug, no solo la primera que encuentra.
Respecto a la versión 1.1, las soluciones de referencia tocan un 67 % más de archivos y un 89 % más de líneas, en bases de código un 25 % más grandes. Por eso los porcentajes parecen bajos: nadie llega al 50 %. Cognition avisa además de que las notas de la 2.0 no se pueden comparar con las de la 1.1.
Aquí hay un dato que da algo de confianza en la tabla de Anthropic. La clasificación del propio benchmark, en su foto de octubre, tenía a Opus 5.5 primero con 45,5 % y a GPT-6 Astra segundo con 42,8 %. Son las mismas cifras que Anthropic pone en su tabla para los rivales. Y el 49,1 % de Fable 5.2 ya tiene confirmación externa: Artificial Analysis, que incluye FrontierCode 2.0 en su índice, le mide un 49 % frente al 46 % de Opus 5.5.
Y luego está el dato fino, que es el que más me interesa:
Fable 5.2 en high saca 45,3 %. Opus 5.5 en su mejor configuración saca 45,5 %. Y Anthropic dice que Fable lo hace por más o menos la mitad de coste por tarea.
Al subir a xhigh, Fable llega al 49,1 %. Es decir, la mejora no consiste solo en dejarle pensar más tiempo: con un presupuesto más corto ya iguala al mejor resultado anterior.
Ese “mitad de coste por tarea” merece su propia sección, porque a primera vista no cuadra. Fable cuesta el doble por token que Opus. ¿Cómo va a salir a mitad de precio?
¿Qué dice Artificial Analysis, la primera medición independiente? 
Artificial Analysis coloca a Fable 5.2 en el número 1 de su Intelligence Index v5 con 65 puntos en esfuerzo max. Son 5 más que Gemini 4 Carbon, 6 más que Opus 5.5 y 16 más que Fable 5.1. También es, con diferencia, el modelo más caro de medir: 26,50 $ de media por tarea en max.
El índice v5 junta nueve evaluaciones, entre ellas FrontierCode 2.0, Terminal-Bench 4.0, AA-Briefcase y Terminal-Bench-Science. Los puntos no son comparables con los de versiones anteriores del índice que hemos citado en otros posts. Y un detalle de método: ejecutaron las pruebas en los cinco niveles de esfuerzo y con el fallback por defecto de Anthropic activado, es decir, tal como lo vas a usar tú.
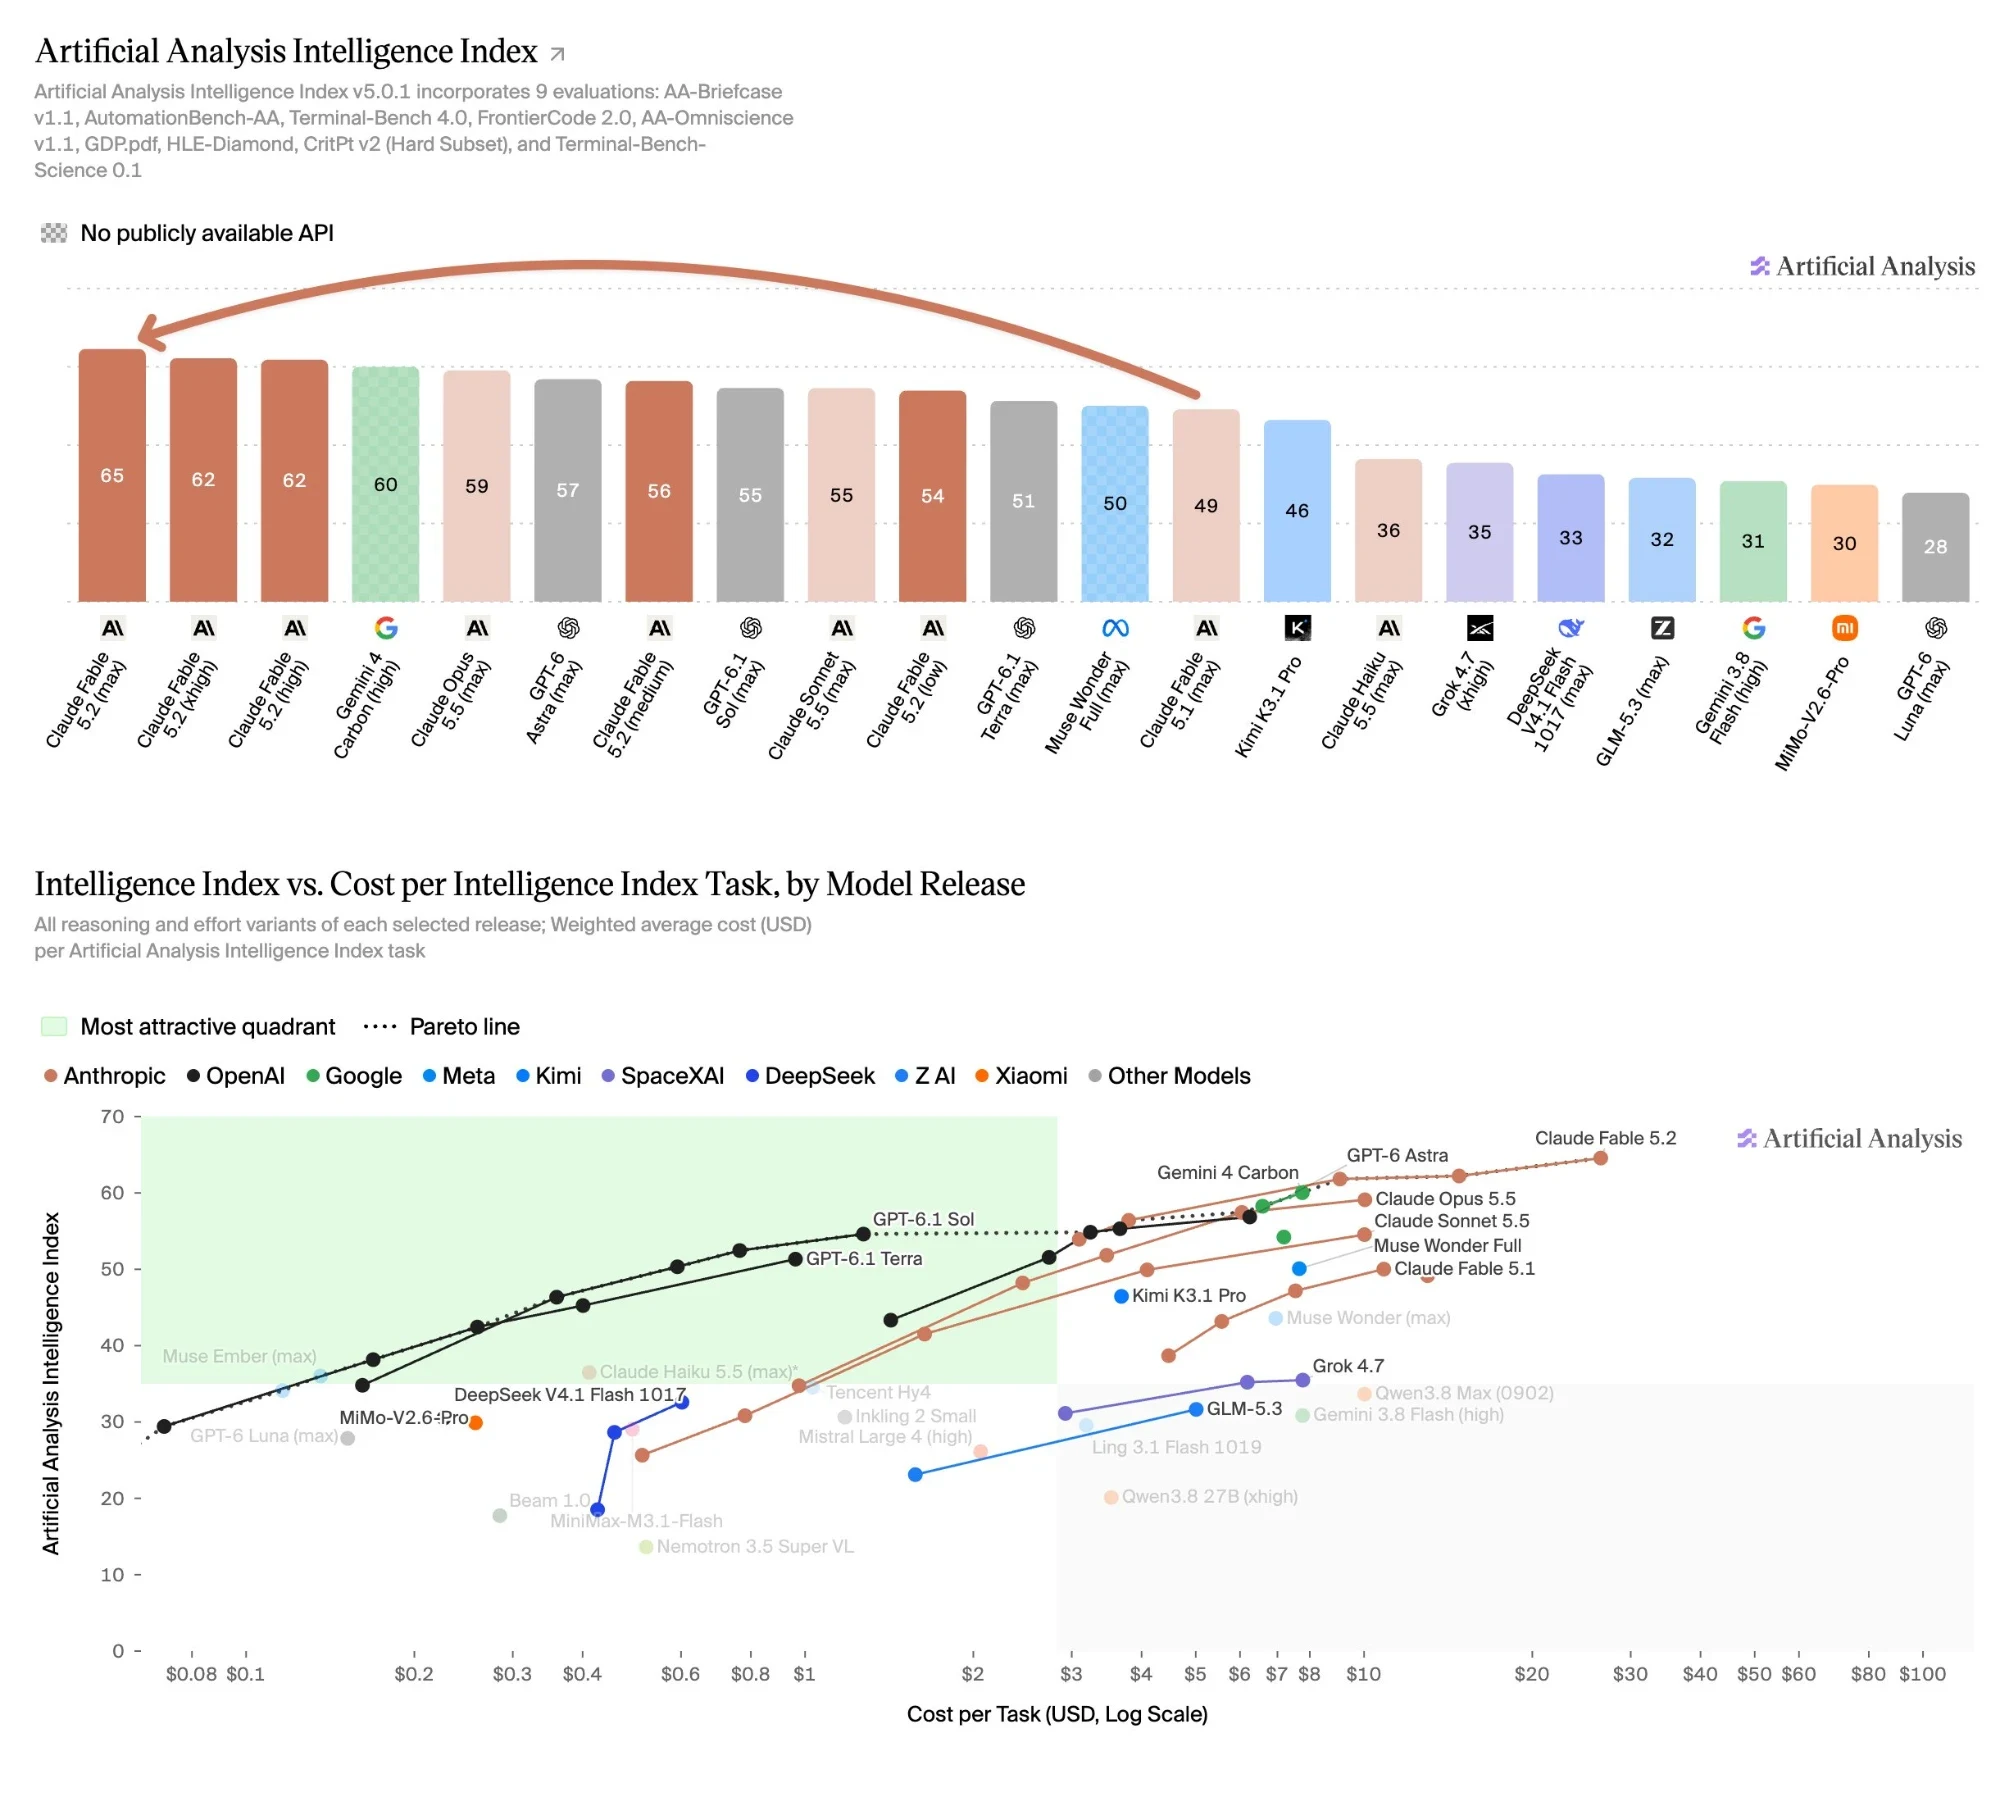
Lo más útil del gráfico es ver a Fable 5.2 nivel a nivel, al lado de sus rivales:
| Modelo y esfuerzo | Intelligence Index v5 |
|---|---|
Fable 5.2 max |
65 |
Fable 5.2 xhigh |
62 |
Fable 5.2 high |
62 |
Gemini 4 Carbon high |
60 |
Opus 5.5 max |
59 |
GPT-6 Astra max |
57 |
Fable 5.2 medium |
56 |
Fable 5.2 low |
54 |
Fable 5.1 max |
49 |
Fuente: Artificial Analysis, 9 de noviembre de 2026.
Tres lecturas de esa tabla.
high es el escalón que importa. En high y xhigh saca lo mismo, 62, y ya está por delante de cualquier otro modelo en cualquier esfuerzo. Pasar a max da tres puntos más. Con Fable 5.1 concluimos que el punto dulce era high y aquí se repite.
En medium, que es el valor por defecto en Claude Code, queda por debajo del mejor Opus. 56 frente a 59. Si abres Claude Code, eliges Fable y no tocas nada, no estás usando el modelo que lidera la tabla.
Hasta el Fable 5.2 más bajo supera al Fable 5.1 más alto. low saca 54 y Fable 5.1 en max se quedaba en 49.
Fable 5.2 lidera cinco de las nueve evaluaciones del índice:
- HLE-Diamond: 80 %, cuando el mejor anterior era el 69 % de Gemini 4 Carbon.
- AA-Omniscience v1.1: 67 frente al 54 de Carbon.
- Terminal-Bench-Science: 73 % frente al 65 % de Carbon. Anthropic publicaba 74,6 %.
- CritPt v2 (subconjunto difícil): 77 % frente al 72 % de GPT-6 Astra.
- FrontierCode 2.0: 49 % frente al 46 % de Opus 5.5.
Y ahora la parte que enfría el anuncio. En las otras cuatro, Fable 5.2 mejora a Fable 5.1 pero se queda a la altura de Opus 5.5 o por debajo de modelos más baratos:
| Evaluación | Fable 5.2 | Opus 5.5 | Quién va por delante |
|---|---|---|---|
| Terminal-Bench 4.0 | 60 % | ~60 % | Kimi K3.1 Pro (67 %), Gemini 4 Carbon (65 %), Sonnet 5.5 (64 %) |
| AA-Briefcase (Elo) | 1.785 | 1.800 | Sonnet 5.5 (1.813) |
| GDP.pdf | 24 % | 26 % | Opus 5.5 |
| AutomationBench-AA | 76 % | 70 % | Gemini 4 Carbon (78 %) |
La fila de Terminal-Bench 4.0 es la que más me llama la atención, porque es trabajo de terminal, el de un agente de código de toda la vida. Fable 5.2 empata con Opus 5.5 y pierde contra Sonnet 5.5, que cuesta una cuarta parte. Terminal-Bench 4.0 estaba en la tabla con la que Anthropic presentó Fable 5.1. En la de Fable 5.2 ya no aparece.
🔑 El dibujo que deja Artificial Analysis es más preciso que el del anuncio: Fable 5.2 arrasa en razonamiento científico, conocimiento y cambios de código que un mantenedor aceptaría. En trabajo de terminal y de oficina, se queda donde ya estaba Opus 5.5.
¿Sale más barato Fable 5.2 que Opus 5.5 por tarea? 
En max, no: cuesta 2,6 veces más. En esfuerzos más bajos puede salir más barato, pero depende de cuántos tokens gaste cada uno y de con qué Opus lo compares. Por token, Fable 5.2 cuesta el doble que Opus 5.5. Para que una tarea salga más barata con Fable, tiene que resolverla con menos de la mitad de tokens facturables, contando entrada, salida y caché.
| Concepto | Fable 5.2 | Opus 5.5 |
|---|---|---|
| Entrada, por millón | 8 $ | 4 $ |
| Salida, por millón | 40 $ | 20 $ |
| Esfuerzo por defecto | medium |
medium |
| Precio por token (relativo) | 2× | 1× |
Hagamos la cuenta con lo que afirma el anuncio. Si Fable en high cuesta la mitad por tarea que Opus en max, y cada token de Fable vale el doble, entonces Fable está usando en torno a una cuarta parte de los tokens. No es un disparate: en el análisis de Opus 5.5 ya vimos que en max es el modelo que más tokens gasta por tarea de todos los medidos.
Anthropic da tres comparaciones de este tipo:
- FrontierCode 2.0: Fable en
highempata con Opus 5.5 enmaxpor alrededor de la mitad de coste por tarea. - WANDR: Fable en
mediumiguala la mejor nota de Opus 5.5 por cerca del 40 % del coste. - Humanity’s Last Exam: Fable en
lowiguala el 67,7 % de Opus 5.5 por menos de una décima parte del coste.
Las tres tienen el mismo truco de lectura. Comparan un Fable en esfuerzo bajo o medio contra el Opus más caro posible. Es una comparación legítima si lo que quieres es “la nota máxima de Opus, pero más barata”. No responde a otra pregunta, que es la que te vas a hacer tú en Claude Code: ¿Fable en medium es mejor y más barato que Opus en high, que es como usa Opus mucha gente?
Esa comparación exacta no la da el anuncio. Artificial Analysis sí aporta la otra mitad de la cuenta, la del coste medido desde fuera:
Modelo en max |
Coste medio por tarea del índice |
|---|---|
| Fable 5.2 | 26,50 $ |
| Fable 5.1 | 12,99 $ |
| Opus 5.5 | 10,00 $ |
Fable 5.2 en max cuesta 2,6 veces más que Opus 5.5 y el doble que Fable 5.1, a pesar de la rebaja del 20 % por token. La bajada de precio no compensa lo que gasta de más cuando le quitas el límite.
En esfuerzos más bajos la foto mejora. En high, Fable 5.2 usa 98.000 tokens de salida por tarea frente a los 173.000 de Opus 5.5 en max, y saca 62 puntos frente a 59. Artificial Analysis concluye que, con esfuerzos más bajos, Fable 5.2 puede superar a Opus 5.5 con un coste por tarea menor. Coincide con lo que dice Anthropic, y tiene la misma letra pequeña: el Opus de la comparación es el de max.
Mi lectura:
- Fable en
highrinde más que cualquier Opus, y probablemente por menos que Opus enmax. Es el dato mejor apoyado: lo dicen Anthropic y Artificial Analysis por separado. - Fable en
mediumno es mejor que Opus en todo. En el índice saca 56 frente a los 59 de Opus enmax. En pruebas sueltas del anuncio, como Chartography o WANDR, sí lo iguala o lo supera. - Frente a Opus en
highsigue sin haber cuenta publicada. Opus enhighgasta bastantes menos tokens que enmax, así que la ventaja de coste de Fable se estrecha o desaparece. - Un benchmark superior no implica una factura inferior. Un modelo más capaz puede resolver con menos intentos y menos llamadas a herramientas. También puede decidir que la tarea merece quince subagentes.
💡 La única cifra que zanja esto es el coste por tarea resuelta en tu repo: mismas tareas, mismo harness, los dos modelos, y la suma de lo que ha facturado cada uno. Todo lo demás, incluida esta sección, es aproximación.
Las cuentas de qué modelo sale más barato caducan con cada lanzamiento. Cada domingo seleccionamos 12 recursos para que sigas el cambio sin perseguir cada anuncio. Ya somos +7.200 developers, gratis desde 2018.
Suscríbete gratis →¿Qué demuestran los experimentos con más de 1.000 agentes? 
Demuestran que Fable 5.2 puede partir un proyecto enorme en tareas, repartirlas entre cientos de subagentes y mantener el trabajo vivo durante días con muy poca intervención humana. No demuestran que el resultado esté listo para producción, y casi todos son pruebas de una sola ejecución contadas por quien vende el modelo.
Son cuatro casos. Los ordeno de más vistoso a más útil.
Un sistema operativo desde una carpeta vacía 
Un ingeniero de Anthropic encargó a Fable 5.2 diseñar un prototipo de sistema operativo empezando de cero. El modelo coordinó más de 1.000 subagentes que trabajaron sin parar durante ocho días.
El resultado, según el anuncio, arranca en un portátil físico y trae núcleo propio, controladores de disco, teclado y red, almacenamiento persistente, ventanas, pantalla de inicio de sesión e instalador. Hay vídeo en la página.
Nadie va a cambiar Linux por esto. Lo que importa es otra cosa: un sistema operativo obliga a descomponer el trabajo en piezas que dependen unas de otras, y a que la pieza 400 siga encajando con la 12 una semana después. Eso es coordinación, y hasta ahora era lo primero que se rompía en los equipos de agentes.
Una migración de Python a Rust en producción 
Un equipo de agentes con una versión previa de Fable 5.2 migró un servicio crítico de producción de Anthropic de Python a Rust. Anthropic dice que el resultado es más fiable y más eficiente, y que arranca unas 26 veces más rápido.
Ojo con cómo se repite ese dato. Es el tiempo de arranque del servicio, no su rendimiento general. Un servicio que arranca 26 veces antes no atiende 26 veces más peticiones.
De los cuatro, este es el caso que más se parece a un encargo real. Y también del que menos detalles hay: no sabemos el tamaño del servicio, cuánto tardó ni cuánta revisión humana hubo.
El último teorema de Fermat, formalizado en 30 horas 
Anthropic ya había formalizado la demostración en Lean con una versión experimental de Claude, un harness hecho a medida y orientación humana. Aquello llevó 11 días.
Con Fable 5.2, un equipo de 1.000 agentes lo completó en 30 horas. El modelo empezó con instrucciones mínimas, se montó sus propios mecanismos de coordinación y no usó referencias matemáticas: solo medía su avance contra una lista de enunciados intermedios. Gastó un tercio de los tokens de acción de la primera formalización y la demostración resultante es siete veces más corta.
Con el mismo montaje, Opus 5.5 completó el 26 % en 18 horas y apenas avanzó después.
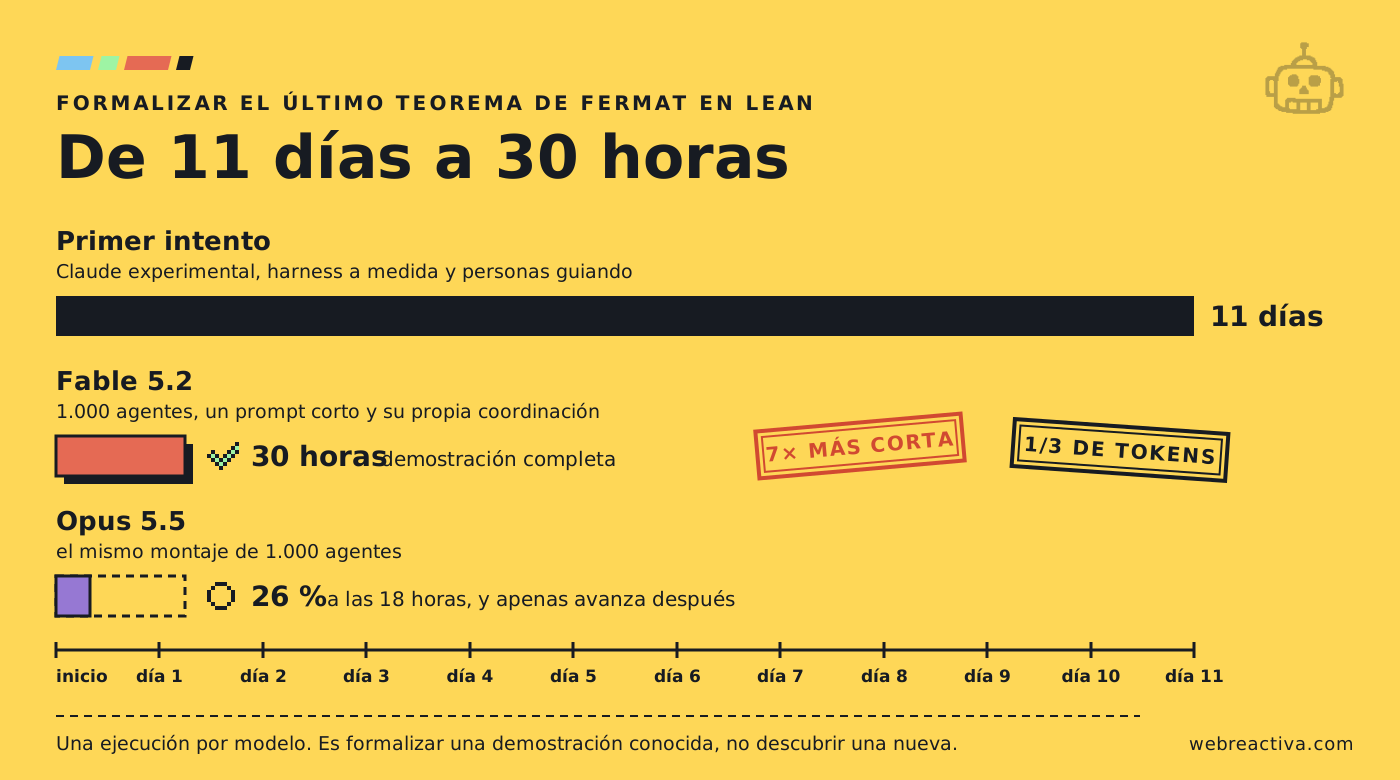
Dos matices. Se trata de formalizar una demostración que ya existe, no de descubrir una nueva. Y la comparación con Opus es de una única ejecución por modelo, que para sacar conclusiones estadísticas es poco.
Aun así, este es el experimento que yo guardaría. El primer intento necesitó un harness especializado y personas guiando. El segundo necesitó un prompt corto. Parte del trabajo de harness que antes hacías tú, ahora lo hace el modelo.
Una auditoría de seguridad de 10 a 12 horas en Uber 
Andrew Mager, de Uber, cuenta que Fable 5.2 pasó entre 10 y 12 horas auditando seguridad, lanzó unos 170 agentes revisores y volvió con tres cosas: un informe, pull requests con las correcciones y una propuesta de políticas.
Los 170 agentes son lo de menos. El detalle bueno es que el trabajo terminó en algo que una persona puede revisar y fusionar. Es un testimonio de acceso anticipado, eso sí, sin registros publicados.
Hay más testimonios en el anuncio, y alguno con cifras. Snowflake dice que es el modelo más fuerte que han medido en su benchmark abierto de 103 tareas de ingeniería de datos. Cognition destaca que reconoce cuando no sabe algo en lugar de inventárselo, que para un agente que trabaja solo durante horas vale más que tres puntos de benchmark.
🛡️ Antes de soltar 170 agentes en tu repo, recuerda de dónde salen estos casos: equipos con presupuesto de tokens sin techo y criterios de aceptación muy bien definidos (un sistema que arranca, una demostración que compila). Si tu tarea no tiene un “compila o no compila” igual de claro, mil agentes producen mil veces más código que revisar.
¿Cómo encaja Fable 5.2 en tu harness: advisor u orchestrator? 
Anthropic propone dos formas de usar Fable 5.2 sin pagar Fable en cada token: como advisor, al que un modelo más barato consulta cuando se atasca, o como orchestrator, que planifica y reparte el trabajo entre modelos más pequeños. Las dos tienen documentación propia, una en Claude Code y otra en Managed Agents.
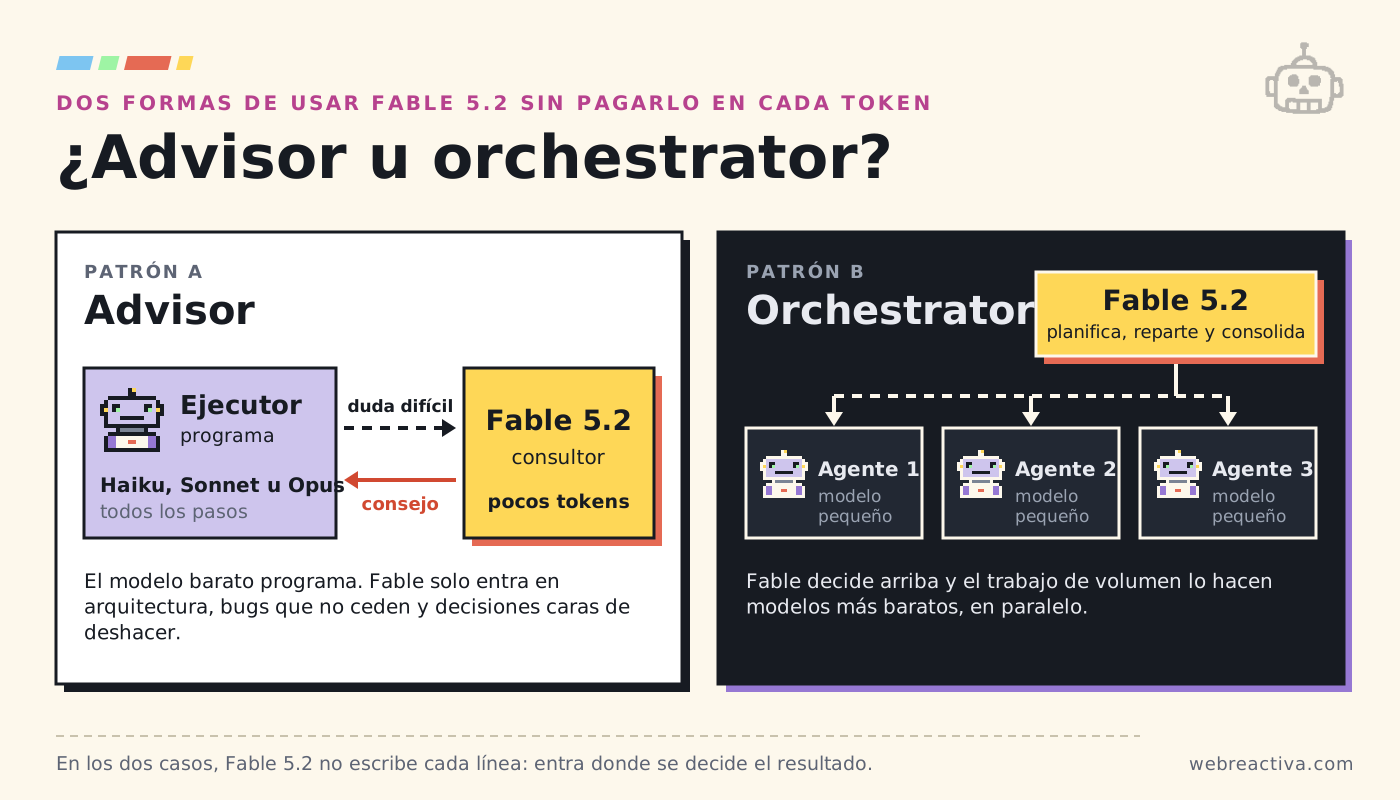
| Patrón | Quién escribe el código | Qué hace Fable | Cuándo encaja |
|---|---|---|---|
| Advisor | Haiku, Sonnet u Opus | Responde consultas sobre decisiones difíciles | Trabajo diario con algún atasco de arquitectura o depuración |
| Orchestrator | Varios agentes con modelos pequeños | Planifica, reparte, consolida y decide | Tareas grandes que se pueden partir en paralelo |
En el patrón advisor, el agente barato sigue programando y solo levanta la mano ante un problema de arquitectura, un bug que no cede o una decisión con consecuencias. Fable interviene en pocos tokens, pero son los de las decisiones que más cuesta deshacer después.
En el patrón orchestrator ocurre al revés: Fable arriba, y subagentes con modelos económicos haciendo el trabajo de volumen. Es el dibujo de los experimentos de la sección anterior, a la escala que te puedas permitir.
La diferencia es de dinero. Un Fable resolviendo cada tarea, incluidas las de renombrar variables, es matar moscas a cañonazos y a 40 dólares el millón de tokens de salida. Un Fable que solo entra en las decisiones de alto impacto puede salir muy rentable.
Esto casa con los bucles autónomos de programación: planificar, implementar, validar con algo determinista (tests, linter, compilador), revisar con un segundo modelo y corregir hasta cumplir los criterios de aceptación. Fable encaja en la planificación y en la revisión. La implementación de cada pieza la puede hacer un modelo bastante más barato.
Dos testimonios del anuncio van en esta línea. En Datadog lo describen como un coordinador de incidentes que dirige modelos más rápidos. Y Jump Trading cuenta que, en sus pruebas, Fable 5.2 hizo a la vez de programador, coordinador, planificador y encargado de lanzar trabajos en una misma ejecución, cuando con modelos anteriores tenían que repartir esos papeles a mano entre sistemas distintos.
🔑 Si solo cambias una cosa de tu configuración tras este lanzamiento, que no sea “poner Fable por defecto”. Prueba a dejar tu modelo de siempre programando y a Fable 5.2 de consultor para lo difícil.
Construye agentes con criterio
Antes de poner a Fable a orquestar, aprende a montar la orquesta
Advisor y orchestrator son el último piso de un edificio de seis: tools, guardarraíles, memoria, skills, MCP y orquestación. En esta masterclass los montas uno a uno, con código, hasta llegar a un sistema multiagente revisado por otro modelo.
Ver la arquitectura →Masterclass en directo · Acceso con Web Reactiva Premium
¿Qué es Mythos 5.2 y qué puede hacer que Fable no? 
Mythos 5.2 es el mismo modelo que Fable 5.2 sin parte de las restricciones de ciberseguridad y biología. No está pensado para que escribas mejor código de diario: sirve para tareas que Fable bloquea, como buscar vulnerabilidades en binarios, generar exploits en un pentest autorizado o trabajar en biología de investigación.
Se accede por dos vías, el Cyber Verification Program y el Life Sciences Verification Program. Los clientes Enterprise tienen una tercera: Claude Security, un producto que usa toda la familia de modelos, Mythos incluido, sin pasar por la verificación.
Estos son sus números frente a su versión anterior:
| Evaluación | Mythos 5.2 | Mythos 5.1 | Opus 5.5 (sin salvaguardas) |
|---|---|---|---|
| CyScenarioBench | 76,3 % | 61,7 % | 67,6 % |
| CVE Rediscovery (interno) | 89,6 % | 78,3 % | 81,3 % |
| Diseño de proteínas de unión (24 h) | 85,1 % | 79,1 % | 82,6 % |
| Terminal-Bench-Science 0.1 | 75,3 % | 52,6 % | 58,7 % |
CVE Rediscovery es una prueba interna de Anthropic: 1.829 vulnerabilidades conocidas, el código tal como estaba antes del parche, y a ver cuántas redescubre el modelo. En Mozilla, Brian Grinstead afirma que Mythos 5.2 más o menos duplicó las métricas de descubrimiento de vulnerabilidades de Mythos 5.1 en sus campañas de análisis.
Y aquí hay una nota al pie que merece más atención de la que le da el anuncio. El texto principal dice que Mythos 5.2 encontró un 10,2 % más de vulnerabilidades que Opus 5.5. La nota aclara que ese recuento son hallazgos en bruto de la auditoría de un único tester, y que en las evaluaciones propias de Anthropic la identificación de vulnerabilidades queda más o menos a la par que Opus 5.5. El titular y la letra pequeña no cuentan lo mismo.
Hay un número que sí me parece revelador, y es el más pequeño de la tabla. En Terminal-Bench-Science, Mythos saca 75,3 % y Fable 74,6 %. Siete décimas de diferencia. Con la generación 5.1, la distancia entre Mythos y Fable en Terminal-Bench 4.0 era de unos cinco puntos. No es el mismo benchmark, así que no lo tomes como medida exacta, pero la dirección está clara: fuera de ciberseguridad y biología, las salvaguardas de Fable penalizan cada vez menos.
Para quien programa, la conclusión es tranquila. No te estás perdiendo un modelo mejor. Te estás perdiendo unas capacidades concretas que, salvo que trabajes en seguridad ofensiva o en un laboratorio, no ibas a usar. Si quieres el contexto de por qué viven detrás de una verificación, lo contamos en el análisis de GPT-5.4-Cyber frente a Claude Mythos.
¿Qué pasa con las salvaguardas de Fable 5.2 y el fallback a Opus? 
Fable 5.2 bloquea menos trabajo legítimo que Fable 5.1, y cuando bloquea no te deja sin respuesta: te contesta otro modelo. Las dos cosas tienen consecuencias prácticas.
La mejora primero. Anthropic comunica alrededor de un 55 % menos de bloqueos que con Fable 5.1: un 60 % menos en ciberseguridad y un 40 % menos en biología. El dato sale de pruebas tempranas en claude.ai, Claude Code y Cowork, y la empresa afirma que la robustez de las salvaguardas no ha bajado.
Lo que sigue bloqueado: pentesting, generación de exploits, análisis de vulnerabilidades sobre binarios y la mayor parte de las tareas de biología de investigación.
Y ahora el mecanismo, que conviene conocer. Cuando un clasificador salta, la respuesta la da un Opus anterior: Opus 4.8 si el tema es ciberseguridad y Opus 5 si es biología. Hay un tercer caso para un grupo pequeño de temas de I+D en IA, como el desarrollo de kernels para ciertos aceleradores poco habituales, que también deriva a Opus 5.
¿Por qué te importa? Porque tener Fable seleccionado no garantiza que te esté contestando Fable. Si haces trabajo de seguridad defensiva y de pronto las respuestas bajan de nivel, puede que no sea un mal día del modelo: puede que estés hablando con Opus 4.8. Y lo mismo si montas tu propio benchmark casero con tareas que rozan esos temas.
En la parte de comportamiento autónomo hay un dato que se agradece. En una evaluación adversarial con más de 1.800 escenarios, cada uno con un sandbox que tenía una debilidad puesta a propósito, se midió cuántas veces el modelo usaba credenciales o archivos de fuera del sandbox:
| Modelo | Escenarios en los que salió del sandbox |
|---|---|
| Mythos 5 | 39 % |
| Mythos 5.1 | 21 % |
| Sonnet 5.5 | 5,1 % |
| Opus 5.5 | 3,3 % |
| Mythos 5.2 | 3,1 % |
De 21 % a 3,1 % en una versión. Para un modelo que vas a dejar trabajando ocho horas con acceso a una terminal, es la mejora que más debería pesar. Pero 3,1 % no es cero, la prueba se hizo sobre Mythos y no sobre Fable, y Anthropic avisa de que ninguna batería de pruebas garantiza detectar todos los comportamientos indeseados. El sandbox lo sigues poniendo tú.
Un apunte curioso para cerrar: Anthropic reconoce en el anuncio que Fable 5.2 y Mythos 5.2 expresan la sospecha de estar siendo evaluados con más frecuencia que ningún modelo reciente de Anthropic. Un modelo que nota cuándo lo están examinando hace más difícil saber cómo se comporta cuando cree que no.
Si vas a dejar agentes trabajando solos durante horas, te vendrá bien leer cómo lo están haciendo otros developers. Cada domingo compartimos 12 recursos sobre programar con IA con +7.200 suscriptores. Gratis, desde 2018.
Apúntate gratis →¿Fable 5.2, Opus 5.5, GPT-6 Astra o Gemini 4 Carbon: cuál elegir? 
Para trabajo agéntico largo, Fable 5.2 es hoy el modelo con mejores números publicados. Para el trabajo de cada día, la propia Anthropic te manda a Opus 5.5. Y frente a Astra y Carbon gana en la tabla oficial, que es la tabla de casa.
| Escenario | Por dónde empezaría yo |
|---|---|
| Tareas de días, multiagente, mucho contexto | Fable 5.2 como orchestrator |
| Programación diaria en Claude Code | Opus 5.5, con Fable 5.2 de advisor |
| Automatización de flujos de negocio | Gemini 4 Carbon lidera AutomationBench, si tienes acceso |
| Uso de ordenador (OSWorld) | Fable 5.2, con Opus 5.5 a dos puntos |
| Volumen alto con presupuesto ajustado | Ninguno de estos: mira Sonnet 5.5, Haiku 5.5 o modelos abiertos |
| Ciberseguridad ofensiva autorizada | Mythos 5.2, si tu organización está verificada |
Frente a Opus 5.5. Opus cuesta la mitad por token, sigue por delante en el Elo de AA-Briefcase y empata en Terminal-Bench 4.0 según Artificial Analysis. Fable 5.2 le saca 3,6 puntos en FrontierCode, 7,6 en FrontierSWE, casi 16 en Terminal-Bench-Science y 20 en Remote Labor Index. Cuanto más larga y más autónoma es la tarea, más se abre la distancia. Para un bug, un refactor de un módulo o una feature de cuatro archivos, pagar el doble no tiene mucha defensa. En qué modelo de Claude usar para cada tarea tienes las señales para saber cuándo subir.
Frente a GPT-6 Astra. Astra era la referencia en autonomía prolongada, y aquí queda por detrás en todas las filas donde aparece: 6,3 puntos en FrontierCode, 4,4 en FrontierSWE, 6,5 en Terminal-Bench-Science y casi 10 en OSWorld. Con dos cautelas. Son mediciones de Anthropic, y en lanzamientos anteriores vimos que el orden entre Astra y Fable cambiaba según el harness: dentro de Devin, Cognition situó a Astra por encima de Fable 5.1 cuando otros índices decían lo contrario.
Frente a Gemini 4 Carbon. Carbon gana en AutomationBench (también en la versión de Artificial Analysis, 78 % frente a 76 %), le saca cinco puntos en Terminal-Bench 4.0 y queda a menos de un punto en Chartography. En el índice general, Fable 5.2 en max va cinco puntos por delante. En el resto de filas donde hay dato, Fable va por delante, con el asterisco de que en FrontierCode Carbon aparece medido en medium. Y sigue pesando lo de siempre con Carbon: su disponibilidad para developers es limitada, mientras que Fable 5.2 lo puedes usar hoy.
Lo que no cambia con ningún lanzamiento: la tabla de un fabricante te dice dónde mirar, no qué comprar.
¿Cuándo compensa Fable 5.2 y cuándo no? 
Compensa cuando la tarea es lo bastante larga o difícil como para que un modelo más barato se quede a medias, y cuando tienes forma de comprobar el resultado sin leerlo entero. No compensa para el trabajo corto y acotado de cada día.
Tiene sentido si:
- Montas tareas que duran horas y quieres que un solo modelo planifique, reparta y verifique.
- Tu modelo actual se atasca en decisiones de arquitectura o en bugs que no ceden, y quieres un advisor.
- Ya pagabas Fable 5.1: es mejor, más rápido y un 20 % más barato, así que no hay nada que pensar.
- Haces trabajo legítimo de seguridad que Fable 5.1 te bloqueaba: los falsos positivos han bajado más de la mitad.
Todavía no compensa si:
- Tus tareas son cortas. Opus 5.5 cuesta la mitad por token y Anthropic lo recomienda para empezar.
- No tienes criterios de aceptación que se puedan comprobar con una máquina. Un modelo que trabaja ocho días sin tests que le digan si va bien solo acumula código.
- Tu plan es Pro y quieres usarlo para todo: el tope es el 50 % del límite semanal.
- Lo tuyo es trabajo de terminal de toda la vida. En Terminal-Bench 4.0 empata con Opus 5.5 y pierde con Sonnet 5.5, según Artificial Analysis.
- Pensabas dejarlo en
max. A 26,50 $ de media por tarea en el índice, eso se reserva para el problema que lo merezca.
Y una prueba para decidir con datos tuyos. Coge cinco tareas de tu repo y pásaselas a Opus 5.5 en high y a Fable 5.2 en medium y en high:
- Una feature que toque al menos cinco archivos.
- Un bug viejo con reproducción incómoda.
- Una migración con tests que tienen que pasar al ejecutarlos.
- Una tarea larga donde el modelo tenga que planificar y verificar por su cuenta.
- Una revisión de un PR grande, de los que dan pereza.
Apunta tres cosas de cada una: si quedó resuelta sin que intervinieras, cuántas vueltas dio y cuánto se facturó. Es la comparación que Anthropic no ha publicado y la única que responde a tu caso.
¿Qué queda por demostrar de Fable 5.2? 
Queda bastante menos que esta mañana, porque Artificial Analysis ya ha publicado su medición. Ordenado por lo que más me importa:
- Más mediciones de fuera. Artificial Analysis confirma el 49 % de FrontierCode 2.0 y el liderato general. Faltan la clasificación de Cognition, Vals AI y las filas que solo ha medido Anthropic, como Remote Labor Index o RoboDojo.
- Coste real por tarea frente a Opus 5.5 en
high. Es la comparación que decide si Fable entra en el día a día o se queda para ocasiones. - Los experimentos de 1.000 agentes, repetidos por alguien de fuera. Y con la factura delante: ocho días de mil subagentes cuestan dinero y el anuncio no dice cuánto.
- El máximo de salida y los límites de uso, que no aparecen ni en el anuncio ni en la ficha de Artificial Analysis.
- Cómo se comporta con un harness corriente. Los mejores casos vienen de equipos que saben mucho de agentes. Falta ver qué hace en un Claude Code sin configurar, con un AGENTS.md a medio escribir.
Con Fable 5.1 escribí que el modelo rendía más cuanto mejor era el andamiaje que le dabas. El experimento de Fermat le da una vuelta a esa idea: con Fable 5.2, parte del andamiaje se lo monta él. Lo que sigues poniendo tú son los criterios para saber si el trabajo está bien, y esa parte no se puede delegar en el mismo modelo que hace el trabajo.
Fable 5.2 en una frase 
El Fable que por fin justifica su precio en tareas de días: más capaz donde hay que coordinar y sostener el trabajo, un 20 % más barato, y con una recomendación de la propia Anthropic de no usarlo para todo.
TL;DR 
- 🚀 Fable 5.2 sube de 32,4 % a 49,1 % en FrontierCode 2.0 y 20 puntos o más en otros cinco benchmarks, según Anthropic. Artificial Analysis confirma el 49 % y lo pone número 1 de su índice con 65 puntos.
- 💸 Cuesta 8/40 dólares por millón de tokens, un 20 % menos que Fable 5.1 y el doble que Opus 5.5. El fast mode vale 16/80 y solo compensa cuando lo caro es tu espera.
- 🧮 En
maxcuesta 26,50 $ por tarea del índice, 2,6 veces más que Opus 5.5. Enhighsaca 62 puntos con menos tokens que Opus enmax. Enmedium, el valor por defecto, se queda en 56, por debajo del mejor Opus. - 🤖 Más de 1.000 subagentes durante ocho días para un sistema operativo y 30 horas para formalizar Fermat. Prueban coordinación, no calidad de producción.
- 🎯 Úsalo de advisor o de orchestrator, no de modelo por defecto. Anthropic recomienda empezar con Opus 5.5 y subir solo cuando haga falta.
Preguntas frecuentes sobre Fable 5.2 
¿Qué es Claude Fable 5.2? 
Claude Fable 5.2 es el modelo público más capaz de Anthropic, lanzado el 9 de noviembre de 2026. Está orientado a problemas técnicos largos: ingeniería de software, programación agéntica, matemáticas e investigación científica. Comparte modelo subyacente con Mythos 5.2, añade clasificadores de seguridad para ciberseguridad y biología y tiene una ventana de contexto de 1 millón de tokens.
¿Cuánto cuesta Fable 5.2? 
Cuesta 8 dólares por millón de tokens de entrada y 40 por millón de salida, un 20 % menos que Fable 5.1 (10 y 50). Leer de caché cuesta 0,20 dólares por millón. El fast mode cuesta 16 y 80 dólares y genera tokens hasta 2,5 veces más rápido. En los planes Pro y en los asientos estándar de Team está incluido hasta el 50 % del límite semanal de uso.
¿En qué se diferencia Fable 5.2 de Fable 5.1? 
Rinde bastante más en trabajo agéntico (16,7 puntos más en FrontierCode 2.0, 22 más en Terminal-Bench-Science, 23,4 más en Remote Labor Index), cuesta un 20 % menos y genera hasta un 30 % más rápido. También bloquea alrededor de un 55 % menos de peticiones legítimas en ciberseguridad y biología, según Anthropic.
¿Fable 5.2 es mejor que Opus 5.5 para programar? 
En cambios de código que aceptaría un mantenedor, sí: 49 % frente a 46 % en FrontierCode 2.0, confirmado por Artificial Analysis. En trabajo de terminal no: los dos rondan el 60 % en Terminal-Bench 4.0. Para el trabajo diario, Anthropic recomienda empezar con Opus 5.5, que cuesta la mitad por token, y subir a Fable solo cuando la tarea lo exija.
¿Fable 5.2 sale más barato que Opus 5.5 por tarea? 
Depende del esfuerzo. En max cuesta 26,50 dólares de media por tarea del índice de Artificial Analysis, 2,6 veces más que Opus 5.5 (10 dólares). En high usa 98.000 tokens de salida por tarea frente a los 173.000 de Opus 5.5 en max y puede salir más barato. Frente a Opus 5.5 en high no hay datos publicados.
¿Qué es FrontierCode 2.0? 
Es un benchmark de Cognition con 132 tareas privadas creadas por mantenedores de repositorios open source. Evalúa si el cambio de un agente sería aceptado por quien mantiene el proyecto: que funcione, que traiga tests, que no toque de más y que respete las convenciones. Sus notas no son comparables con las de la versión 1.1.
¿Qué es Mythos 5.2 y quién puede usarlo? 
Mythos 5.2 es el mismo modelo que Fable 5.2 sin parte de las restricciones de ciberseguridad y biología. Solo lo reciben organizaciones aceptadas en el Cyber Verification Program o en el Life Sciences Verification Program de Anthropic, y los clientes Enterprise a través de Claude Security. No ofrece mejor código para el trabajo cotidiano.
¿Qué nivel de esfuerzo usar con Fable 5.2? 
El valor por defecto en las apps de Claude y en Claude Code es medium, y para la mayoría de tareas es un buen punto de partida. En el índice de Artificial Analysis, medium saca 56 puntos, high y xhigh 62 y max 65: el escalón que más rinde es high. Sube el esfuerzo solo cuando la tarea se quede corta, porque cada escalón multiplica los tokens.
¿Qué pasa cuando Fable 5.2 bloquea una petición? 
No devuelve un rechazo vacío: la petición se deriva a un modelo anterior. Responde Opus 4.8 si el tema es ciberseguridad y Opus 5 si es biología. Por eso una respuesta obtenida con Fable seleccionado puede no venir del modelo de Fable, algo que conviene tener presente al comparar resultados.
¿De verdad Fable 5.2 construyó un sistema operativo solo? 
Según Anthropic, coordinó más de 1.000 subagentes durante ocho días a partir de una carpeta vacía y el resultado arranca en un portátil con núcleo, controladores, almacenamiento, ventanas, inicio de sesión e instalador. Es un prototipo y una prueba de coordinación a gran escala, no un sustituto de Linux o Windows, y nadie externo lo ha reproducido todavía.
Fuentes 
- Introducing Claude Fable 5.2 and Claude Mythos 5.2 — Anthropic
- Claude Fable 5.2 and Mythos 5.2 system card — Anthropic
- Anuncio de precio y disponibilidad — Claude en X
- Claude Fable 5.2 en el Intelligence Index v5 — Artificial Analysis en X
- FrontierCode 2.0 — Cognition
- Formalizing Fermat’s Last Theorem — Anthropic Research
- Advisor — documentación de Claude Code
- Multiagent orchestration — documentación de Claude Platform
- Anthropic Launches Fable 5.2 & Mythos 5.2 — OfficeChai
- Anthropic’s Claude Fable 5.2 Builds a Working OS From an Empty Folder — AlphaSignal
- Fable 5.1: qué cambia, cuánto cuesta y cuándo usarlo — Web Reactiva
- Claude Opus 5.5 vs GPT-6 Astra: precio, benchmarks y agentes — Web Reactiva
🧨 Última oportunidad para recibir la dinamita que mereces sobre programación con IA el próximo domingo: Suscríbete gratis a Web Reactiva en https://webreactiva.com/newsletter

Escrito con la ayuda de la IA generativa de Claude, fuentes fidedignas y con un human in the loop:
Dani Primo.
12 recursos para developers cada domingo en tu bandeja de entrada
Además de una skill práctica bien explicada, trucos para mejorar tu futuro profesional y una pizquita de humor útil para el resto de la semana. Gratis.