Prompt caching: la caché de tokens en Claude, GPT y Gemini
Tabla de contenidos
Cada vez que le escribes a tu agente de IA, el modelo vuelve a leer la conversación entera.
Desde el primer mensaje. El system prompt, tu CLAUDE.md, los ficheros que abrió hace una hora, cada resultado de cada herramienta. Todo. El modelo no recuerda nada entre una petición y la siguiente, así que el agente se lo reenvía en cada turno como quien le cuenta la película entera a un amigo que llega tarde al cine.
Si eso se cobrara a precio completo, una sesión larga de Claude Code costaría una fortuna y cada respuesta tardaría una eternidad en arrancar.
No pasa porque existe la caché de prompts (prompt caching). Es la pieza que hace viables los agentes de programación, y se suele ignorar hasta que la factura o los límites del plan dan un susto.
En este post vas a ver:
- Qué es la caché de prompts y por qué funciona por prefijo exacto
- Cómo la organiza Claude Code y qué acciones tuyas la rompen sin que te des cuenta
- Cómo elegir entre la caché de 5 minutos y la de 1 hora, y cómo medir tu tasa de aciertos
- Cómo funciona en OpenAI, Gemini y DeepSeek, con una tabla comparativa
- Hábitos concretos para que tu agente lea casi todo desde la caché
¿Qué es la caché de prompts y por qué tu agente depende de ella? 
La caché de prompts es un mecanismo del proveedor del modelo que guarda el trabajo ya procesado del principio de una petición para reutilizarlo en la siguiente. Si la nueva petición empieza exactamente igual que una reciente, el modelo se salta esa parte y solo procesa lo nuevo.
Piensa en una conversación con tu agente como una pila de folios. En cada turno, el agente coge todos los folios anteriores, añade uno nuevo encima y se lo entrega al modelo. Casi toda la pila es idéntica a la del turno anterior. Lo único que cambia es el último folio.
Sin caché, el modelo leería la pila completa cada vez. Con caché, reconoce los folios que ya leyó y solo lee el nuevo.
Según la documentación de Claude Code, sin caché “la API reprocesaría todo tu historial en cada turno”. Con ella, reutiliza lo que ya procesó, cobra esa relectura a la tarifa de tokens cacheados y solo procesa del todo lo que ha cambiado.
¿Y cuánto más barata es esa relectura? En la API de Anthropic, leer de la caché cuesta 0,1× el precio base de entrada: una décima parte. En Opus 5.5 y Sonnet 5.5 baja a 0,05×, y en Fable 5.1 a 0,025× (precios de prompt caching de Anthropic).
🔑 La caché no cambia lo que responde el modelo. Cambia lo que pagas y lo que tardas en recibir el primer token.
La caché también recorta la latencia, y eso lo notas antes que en la factura. Un turno que lee 150.000 tokens de la caché arranca mucho antes que uno que tiene que procesarlos desde cero. Por eso, cuando vuelves de comer y le escribes al agente, la primera respuesta tarda más. La caché ya caducó.
Cómo funciona la caché por prefijo exacto 
La caché compara el principio de cada petición (el prefijo) con contenido que procesó hace poco. La documentación de Claude Code lo deja claro: “la coincidencia es exacta, así que un cambio en cualquier punto del prefijo recalcula todo lo que viene después”. No existe caché por fichero ni por fragmento.
Si cambias una coma en el system prompt, todo lo que va detrás —tu CLAUDE.md, la conversación, los resultados de herramientas— se procesa de nuevo. Da igual que sea idéntico. Está detrás de un prefijo distinto.
Es como una partida guardada en un videojuego. Puedes continuar desde el último punto de guardado mientras no toques nada de lo que pasó antes. En cuanto cambias una decisión del capítulo 1, toca rejugar todo desde ahí.
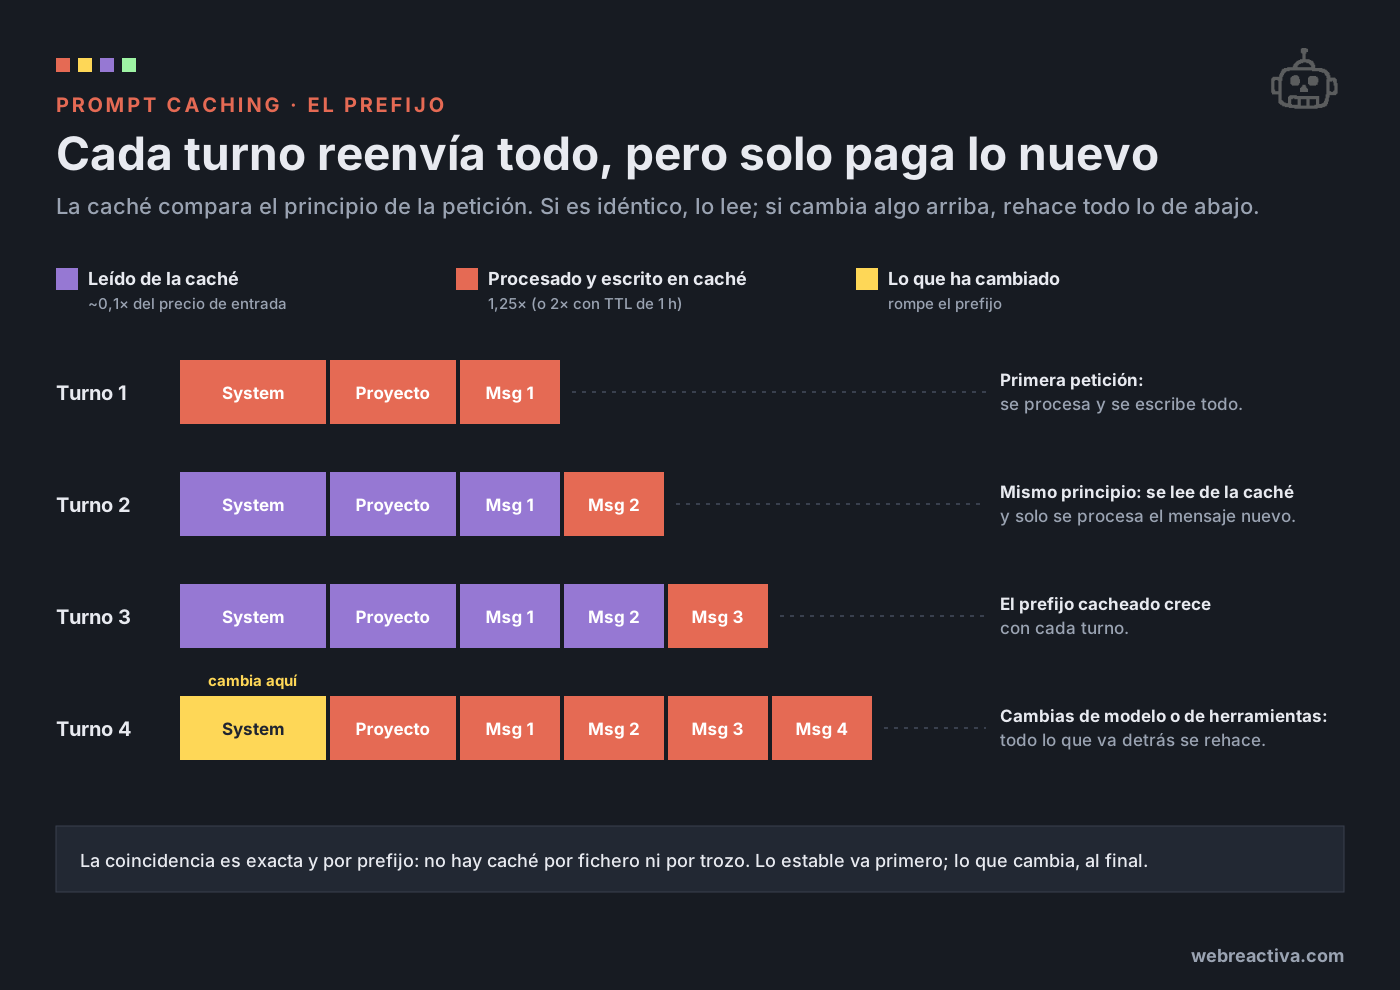
En la API de Anthropic, el orden del prefijo es fijo: primero tools, luego system y después messages. Por eso un cambio en las definiciones de herramientas invalida la caché entera, y un mensaje nuevo al final no invalida nada.
Tres reglas más completan el cuadro:
- Tamaño mínimo. Los prompts demasiado cortos no se cachean y no te avisan con ningún error. En Anthropic el mínimo va de 512 tokens (Opus 5.5, Sonnet 5.5, Haiku 5.5, Fable 5.1) a 4.096 (Opus 4.6, Haiku 4.5).
- La entrada solo existe cuando empieza la respuesta. Si lanzas diez peticiones en paralelo con el mismo prefijo, no se aprovechan entre ellas hasta que la primera empieza a responder.
- Cada modelo tiene su propia caché. El mismo texto enviado a Opus y a Haiku son dos entradas distintas.
Lo fijo, arriba y escrito una vez: las reglas de tu sesión con el agente
En la lección 3 escribimos las reglas de toda la sesión en un AGENTS.md, regla a regla, y te explicamos por qué van ahí y no en la memoria del agente.
Entra en el curso →¿Cómo organiza Claude Code la caché en cada petición? 
Claude Code ordena cada petición para que lo que casi nunca cambia vaya primero. Son tres capas:
| Capa | Contenido | Cambia cuando |
|---|---|---|
| System prompt | Instrucciones base y definiciones de herramientas | Cambia el conjunto de herramientas cargadas |
| Contexto del proyecto | CLAUDE.md, memoria automática, reglas sin ámbito | Al empezar sesión, tras /clear o /compact |
| Conversación | Tus mensajes, respuestas de Claude, resultados de herramientas | En cada turno |
Un cambio en la capa de conversación deja intactas las dos de arriba. Un cambio en el system prompt invalida todo.
Thariq Shihipar, del equipo de Claude Code, explica el porqué en Prompt caching is everything: el equipo vigila la tasa de aciertos de caché con alertas y declara incidencias (SEV) cuando baja demasiado. Según el artículo, “unos pocos puntos de fallo de caché pueden afectar de forma drástica al coste y a la latencia”.
Varias funciones de Claude Code existen tal y como las conoces por culpa de la caché:
- El modo plan no quita herramientas. En lugar de cambiar a un juego de herramientas de solo lectura (eso rompería la caché),
EnterPlanModeyExitPlanModeson herramientas más, y el modo se comunica con un mensaje. - Las herramientas MCP se cargan bajo demanda. Con la búsqueda de herramientas (tool search), Claude Code envía solo stubs ligeros con el nombre, siempre los mismos y en el mismo orden. El esquema completo llega cuando el modelo elige la herramienta.
- Los avisos van como mensajes. Cuando cambia un fichero, Claude Code no toca el system prompt: añade un
<system-reminder>al final de la conversación.
💡 Si alguna vez te has preguntado por qué editar tu CLAUDE.md a mitad de sesión no tiene efecto, la respuesta es la caché. Claude Code lo lee una vez al empezar y lo mantiene en memoria. El cambio llega con el siguiente
/clear,/compacto reinicio.
Cosas como el modo plan o la carga diferida de herramientas cambian de una versión a otra. Cada domingo, +7.200 developers compartimos lo que vamos aprendiendo al trabajar con agentes de IA.
Quiero esa dinamita 🧨Qué acciones rompen la caché en Claude Code 
La documentación oficial enumera las acciones que provocan que la siguiente petición pierda parte o toda la caché. Verás un turno más lento y más caro, y después el nuevo prefijo queda cacheado.
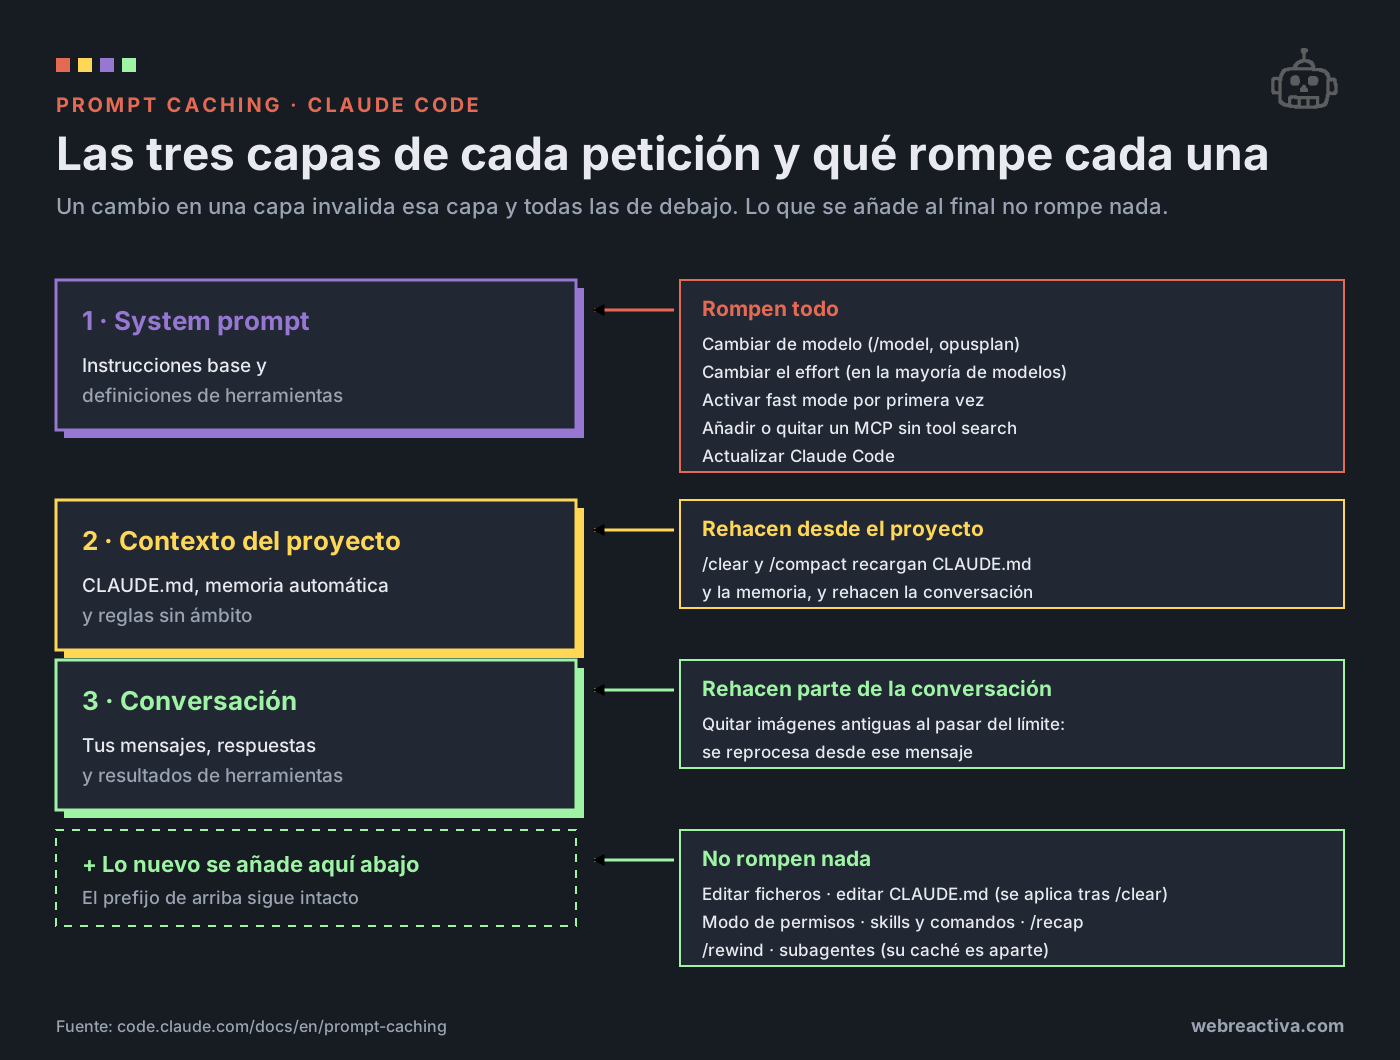
Estas son las que más se cuelan en el trabajo diario.
Cambiar de modelo a mitad de tarea 
Cada modelo tiene su caché. Si cambias con /model, la siguiente petición lee todo el historial sin un solo acierto, aunque el contenido sea idéntico.
El artículo de Thariq Shihipar pone un ejemplo que duele: con 100.000 tokens de conversación en Opus, pasar a Haiku sale más caro que dejar que Opus responda. Haiku tiene que procesar desde cero lo que Opus ya tenía cacheado.
Claude Code te pide confirmación al cambiar de modelo mientras la caché sigue caliente. Ojo también con opusplan: usa Opus en el modo plan y Sonnet al ejecutar, así que cada vez que entras o sales del modo plan cambias de modelo y empiezas una caché nueva.
Cambiar el nivel de esfuerzo (effort) 
En la mayoría de modelos, cada nivel de esfuerzo tiene su propia caché. La excepción son Opus 5.5, Sonnet 5.5, Haiku 5.5 y Fable 5.1 con API key o suscripción de Claude: ahí puedes cambiar el esfuerzo sin perderla. En Amazon Bedrock y en Google Cloud no aplica esa excepción.
Activar el modo rápido (fast mode) 
Activar el modo rápido añade una cabecera que forma parte de la clave de la caché. El primer turno con fast mode relee todo el historial sin aciertos, y además a tarifa de fast mode. Por eso sale más barato activarlo al principio de la sesión que en mitad de una conversación larga. El coste se paga una vez por conversación: apagarlo y volver a encenderlo después ya no rompe nada.
Conectar o quitar un servidor MCP 
Las definiciones de herramientas viven en el system prompt. Si tu modelo usa búsqueda de herramientas (lo normal en los modelos compatibles), Claude Code congela la lista del primer turno y conectar un servidor a mitad de sesión no molesta. Sin búsqueda de herramientas, añadir una definición o quitar una a propósito invalida la caché.
Compactar la conversación 
/compact sustituye el historial por un resumen, así que la capa de conversación se rehace. El matiz está en cuándo lo haces. Con la caché caliente, la petición que genera el resumen lee tu prefijo desde la caché y sale barata. Tras una pausa larga, ese resumen se procesa entero sin caché.
El resto de la lista 
La documentación completa la lista con cuatro casos más:
- Habilitar o deshabilitar un plugin que aporte servidores MCP. Las skills, comandos, agentes y hooks de un plugin no rompen la caché: se añaden al final.
- Denegar una herramienta entera (por ejemplo
Bashen las reglas de permisos) cuando no hay búsqueda de herramientas. - Acumular muchas imágenes. Cuando superas el límite, Claude Code quita un lote de las más antiguas y reprocesa desde ese punto.
- Actualizar Claude Code. Una versión nueva suele cambiar el system prompt, así que la primera conversación tras actualizar construye su caché desde arriba.
⚠️ Elige modelo y nivel de esfuerzo al principio de la sesión. Cuantos menos cambios hagas a mitad de tarea, más alta será tu tasa de aciertos.
¿Qué puedes hacer sin perder la caché? 
Todo lo que añade al final de la conversación o no toca la petición es seguro:
- Editar ficheros del repositorio. El contenido de un fichero solo entra en el contexto cuando Claude lo lee. Si lo editas después, Claude Code añade un aviso y Claude lo vuelve a leer si hace falta.
- Cambiar el modo de permisos (por ejemplo, a aceptar ediciones). Salvo con
opusplan, que cambia de modelo. - Cambiar el estilo de salida con
/output-style. Llega como un mensaje. - Invocar skills y comandos. Sus instrucciones se inyectan como mensajes de usuario.
- Ejecutar
/recap. Añade el resumen como salida, sin sustituir el historial. - Rebobinar con
/rewind. Vuelve a un prefijo que ya estaba cacheado.
Con /rewind también ahorras. Si el agente se ha metido por un camino que quieres abandonar, /rewind es más barato que /compact: recorta hasta un punto ya cacheado en lugar de construir un prefijo nuevo.
Subagentes y forks 
Un subagente arranca su propia conversación con su propio system prompt, así que no lee la caché del padre y calienta una caché propia. La del padre no sufre: desde su lado, la llamada y el resultado del subagente se añaden al final.
Un fork es lo contrario. Hereda el system prompt, las herramientas y el historial exactos del padre, así que su primera petición sí lee la caché. Si te interesa diseñar subagentes que no te disparen el gasto, en la guía de cómo crear subagentes tienes la parte práctica.
¿Caché de 5 minutos o de 1 hora? 
La caché caduca tras un rato de inactividad. Cada petición que acierta reinicia el contador, así que mientras trabajes se mantiene caliente. La API de Anthropic ofrece dos duraciones (TTL):
| TTL | Coste de escritura | Coste de lectura | Cuándo compensa |
|---|---|---|---|
| 5 minutos | 1,25× el precio base | 0,1× (menos en los modelos 5.5 y Fable 5.1) | Rachas de trabajo continuo sin pausas |
| 1 hora | 2× el precio base | Igual que la de 5 minutos | Sesiones con pausas largas: reuniones, comida, revisar un PR |
La escritura de 1 hora cuesta más, pero te ahorra reprocesar todo el prefijo cuando vuelves de una pausa. Si nunca paras más de cinco minutos, pagas de más por una duración que no usas.
Qué TTL usa Claude Code por defecto 
Depende de cómo pagues. Con una suscripción de Claude y dentro del uso incluido en tu plan, la conversación principal usa 1 hora. Con API key, créditos de uso o un proveedor cloud, 5 minutos. Los subagentes, workflows, forks y la compactación van con 5 minutos salvo que lo cambies.
Si superas el límite de tu plan y Claude Code tira de créditos de uso, baja la conversación principal a 5 minutos para que pagues menos por cada escritura.
Puedes fijarlo tú con la opción promptCacheTtl o con variables de entorno:
# Conversación principal con caché de 1 hora (útil con API key)
export CLAUDE_CODE_PROMPT_CACHE_TTL=1h

# Subagentes, workflows y compactación con caché de 1 hora
export CLAUDE_CODE_SUBAGENT_PROMPT_CACHE_TTL=1h

# Forzar 5 minutos en todo (para depurar o comparar)
export FORCE_PROMPT_CACHING_5M=1
Ambas opciones admiten solo 5m o 1h, y requieren Claude Code v2.1.242 o posterior. Para comprobar qué TTL están usando tus escrituras, ejecuta claude -p "hello" --output-format json y mira usage.cache_creation: las de 1 hora salen en ephemeral_1h_input_tokens y las de 5 minutos en ephemeral_5m_input_tokens.
Domina la herramienta a fondo
Claude Code a fondo: modelos, modos y CLAUDE.md sin pagar de más
Verás los precios reales, los modos de operación, CLAUDE.md, hooks, agentes y MCP en dos horas y media de taller práctico.
Entrar a la masterclass →Masterclass en directo · 2h30
Cómo medir tu tasa de aciertos de caché 
Cada respuesta de la API trae dos contadores:
cache_creation_input_tokens: tokens escritos en la caché en este turno, a precio de escritura.cache_read_input_tokens: tokens leídos de la caché, a precio de token cacheado.
Una proporción alta de lecturas frente a escrituras significa que la caché trabaja bien. Si las escrituras se mantienen altas turno tras turno, algo está cambiando tu prefijo.
En Claude Code tienes tres formas de verlo:
/usage: desde la v2.1.251 añade una líneaPrompt cache (main)con la tasa de aciertos de la sesión, los fallos y si la caché sigue caliente. Desde la v2.1.260 incluye la causa probable del último fallo, por ejemplolikely cause: tool definitions changed.- Una statusline que lea el objeto
current_usageoprompt_cachepara verlo en vivo. En el tutorial de mods de Claude Code tienes cómo construir una barra así. - OpenTelemetry, si necesitas verlo por usuario y sesión en toda la organización.
🛡️ Si trabajas detrás de un gateway LLM o una
ANTHROPIC_BASE_URLpropia, comprueba que reenvía los marcadorescache_controlsin tocarlos. Un gateway que los elimina y responde con éxito hace que pagues todo el historial como entrada sin caché en cada turno.
¿Cómo funciona la caché de prompts en OpenAI, Gemini y DeepSeek? 
El principio es el mismo en todos: prefijo idéntico, contenido estable al principio. Lo que cambia es si la caché es automática, cuánto dura y cuánto descuenta.
OpenAI 
En OpenAI la caché está activada por defecto en los modelos compatibles. No hay que marcar nada. Según la guía de prompt caching de OpenAI:
- Desde GPT-5.6, el prefijo mínimo es de 1.024 tokens visibles, la lectura cuesta 0,1× la entrada sin caché (0,05× en GPT-6.1 Sol) y la escritura 1,25×. La duración se controla con
prompt_cache_options.ttl, cuyo único valor es30m. - En modelos anteriores,
prompt_cache_retentionaceptain_memory(entradas activas unos 5-10 minutos de inactividad, hasta una hora) o24h(unos 30 minutos habituales y hasta 24 horas). prompt_cache_keyayuda a enrutar peticiones con el mismo prefijo a la misma máquina. La guía recomienda no pasar de unas 15 peticiones por minuto por clave.
Los tokens cacheados aparecen en usage.input_tokens_details.cached_tokens. Ojo, porque siguen contando para tus límites de tokens por minuto.
Gemini 
Google tiene dos modalidades. La caché implícita está activada por defecto en Gemini 2.5 y posteriores: si aciertas, te aplican el ahorro sin hacer nada (docs de caché de Gemini). El mínimo es de 4.096 tokens en Gemini 3.8 Flash y 3.1 Pro Preview, y de 2.048 en Gemini 2.5.
La caché explícita la creas tú con la API generateContent, le pones un TTL (1 hora si no lo indicas) y pagas un almacenamiento por hora. En la tabla de precios de Gemini, el token cacheado de Gemini 3.8 Flash cuesta 0,075 $ por millón frente a 0,75 $ de entrada normal (precios hasta el 31 de diciembre de 2026), y el almacenamiento, 0,50 $ por millón de tokens y hora.
Con ese almacenamiento por medio, una caché explícita solo compensa si la reutilizas muchas veces dentro de su vida.
DeepSeek 
DeepSeek cachea en disco y de forma automática desde 2024. La respuesta trae prompt_cache_hit_tokens y prompt_cache_miss_tokens para que veas qué parte salió de la caché (guía de caché de DeepSeek). El acierto solo llega cuando la petición coincide entera con una unidad de prefijo ya guardada. Los precios han cambiado varias veces con cada versión del modelo, así que consulta su página oficial antes de hacer cuentas.
Comparativa rápida 
| Proveedor | ¿Automática? | Duración | Descuento en lectura | Particularidad |
|---|---|---|---|---|
| Anthropic (API) | Opcional: automática con un cache_control en la raíz, o marcadores explícitos |
5 min o 1 h | Muy alto (0,1× o menos) | Pagas la escritura (1,25× o 2×) |
| Claude Code | Sí, la gestiona el agente | 1 h con suscripción; 5 min con API | Igual que la API | Varias acciones tuyas la rompen |
| OpenAI | Sí, por defecto | 30 min (GPT-5.6+); de minutos a 24 h en modelos anteriores | Muy alto (0,1× desde GPT-5.6) | prompt_cache_key para enrutar |
| Gemini | Implícita sí; explícita a mano | Explícita: 1 h por defecto, configurable | Alto (unas 10 veces más barato en 3.8 Flash) | La explícita cobra almacenamiento por hora |
| DeepSeek | Sí, en disco | No documentada como TTL fijo | Muy alto | Coincidencia por unidades de prefijo |
Cada proveedor mueve sus precios y sus reglas de caché cada pocos meses. En la newsletter seleccionamos cada domingo 12 recursos para que no te pille a contrapié. Gratis, desde 2018.
Quiero esa dinamita 🧨Cómo usar la caché en tus propias llamadas a la API 
Si construyes algo encima de un modelo —un bot, un pipeline de revisión, tu propio agente—, la caché es lo primero que tienes que diseñar. En Anthropic tienes dos formas de activarla.
La automática usa un único cache_control en la raíz de la petición. El punto de corte se coloca en el último bloque cacheable y avanza a medida que crece la conversación:
import anthropic

client = anthropic.Anthropic()

# Caché automática: un solo cache_control en la raíz de la petición
response = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=1024,
    cache_control={"type": "ephemeral"},
    system=LONG_STABLE_INSTRUCTIONS,  # instrucciones largas y fijas, primero
    messages=conversation,            # lo que cambia, al final
)

# Comprueba qué ha salido de la caché
print(response.usage.cache_read_input_tokens)
print(response.usage.cache_creation_input_tokens)
La explícita pone cache_control en bloques concretos, con un máximo de 4 puntos de corte por petición. Es útil cuando tienes varias capas que cambian a ritmos distintos (herramientas, documentación de referencia, historial). Si quieres la duración de una hora, añade "ttl": "1h" al marcador.
Antes de lanzarte, revisa tres cosas:
- Lo estable, primero. Instrucciones y material de referencia arriba; marcas de tiempo, IDs de petición y datos del usuario, abajo.
- Nada aleatorio en el prefijo. Ordena las herramientas siempre igual. Thariq Shihipar cuenta que el equipo de Claude Code rompió la caché alguna vez por meter una marca de tiempo en el system prompt y por desordenar definiciones de herramientas.
- Añade, no reescribas. Si resumes o editas turnos antiguos del historial, pierdes la caché desde ese punto.
Hábitos para que tu agente lea casi todo desde la caché 
Si te quedas con siete hábitos, que sean estos:
- Decide modelo y esfuerzo al empezar. Si necesitas otro modelo para una subtarea, usa un subagente en lugar de
/model. - Configura tus servidores MCP antes de arrancar. Los cambios en la configuración se aplican al reiniciar, no a mitad de sesión.
- Compacta en los cortes naturales. Entre tareas, con la caché caliente,
/compactsale barato. Esperar a que salte la compactación automática en mitad de una tarea es peor. - Rebobina en lugar de compactar cuando quieras abandonar un camino.
- Activa fast mode al principio, no a la mitad de una conversación larga.
- Usa la caché de 1 hora si trabajas con API key y haces pausas largas.
- Mira
/usagecuando el gasto te sorprenda. La causa del último fallo suele explicarlo todo.
Si quieres ir más allá de la caché, en cómo ahorrar tokens en Claude Code tienes 25 técnicas para recortar el contexto.
TL;DR 
- 🧠 Tu agente reenvía la conversación entera en cada turno; la caché de prompts evita reprocesar el prefijo que no ha cambiado.
- 🎯 La coincidencia es por prefijo exacto: un cambio arriba (system prompt, herramientas, modelo) invalida todo lo que va debajo.
- ⚠️ En Claude Code rompen la caché cambiar de modelo o esfuerzo, activar fast mode, tocar servidores MCP, compactar y actualizar.
- ⏱️ La caché dura 5 minutos o 1 hora; con suscripción, Claude Code usa 1 hora en la conversación principal.
- 📊 Mide con
/usage: si las escrituras de caché no bajan turno tras turno, algo cambia en tu prefijo.
Preguntas frecuentes 
¿Qué es el prompt caching? 
Es un mecanismo de los proveedores de modelos que guarda el procesamiento del principio de una petición para reutilizarlo si la siguiente empieza igual. Así el modelo solo procesa lo nuevo, y la parte reutilizada se cobra a una fracción del precio de entrada.
¿Cuánto ahorra la caché de prompts en Claude? 
En la API de Anthropic, leer de la caché cuesta 0,1× el precio base de entrada, 0,05× en Opus 5.5 y Sonnet 5.5 y 0,025× en Fable 5.1. A cambio, escribir en la caché cuesta 1,25× (5 minutos) o 2× (1 hora).
¿Por qué Claude Code tarda más cuando vuelvo de una pausa? 
Porque la caché caducó. Si pasa más tiempo que su duración (5 minutos o 1 hora según tu plan) sin peticiones, el siguiente turno tiene que procesar todo el contexto desde cero y volver a escribirlo en la caché.
¿Cambiar de modelo en Claude Code rompe la caché? 
Sí. Cada modelo tiene su propia caché, así que tras /model el siguiente turno lee todo el historial sin aciertos. Con conversaciones largas puede salir más caro cambiar a un modelo barato que seguir con el actual.
¿Por qué no se aplica mi cambio en CLAUDE.md a mitad de sesión? 
Claude Code lee el CLAUDE.md raíz y el de usuario una vez al empezar la sesión y lo mantiene en memoria para no romper la caché. El cambio se aplica tras /clear, /compact o reiniciar.
¿Cómo sé si la caché está funcionando en Claude Code? 
Ejecuta /usage y mira la línea Prompt cache (main), con la tasa de aciertos, los fallos y si la caché está caliente. También puedes leer cache_read_input_tokens y cache_creation_input_tokens desde una statusline.
¿Cómo configuro la caché de 1 hora en Claude Code? 
Pon promptCacheTtl a 1h en tu configuración o exporta CLAUDE_CODE_PROMPT_CACHE_TTL=1h. Para subagentes y workflows usa subagentPromptCacheTtl o CLAUDE_CODE_SUBAGENT_PROMPT_CACHE_TTL. Requiere Claude Code v2.1.242 o posterior.
¿La caché de OpenAI es automática? 
Sí. Está activada por defecto en los modelos compatibles. Desde GPT-5.6 el prefijo mínimo es de 1.024 tokens y los tokens cacheados aparecen en usage.input_tokens_details.cached_tokens.
¿Qué diferencia hay entre la caché implícita y la explícita de Gemini? 
La implícita es automática en Gemini 2.5 y posteriores y no requiere cambios en el código. La explícita la creas tú con un TTL (1 hora por defecto) y cobra un almacenamiento por hora, así que solo compensa si reutilizas mucho ese contenido.
¿La caché de prompts cambia las respuestas del modelo? 
No. Tanto Anthropic como OpenAI indican que la caché no altera la generación de la salida. Solo cambia el coste y la latencia de procesar la entrada.
Fuentes 
- How Claude Code uses prompt caching — documentación oficial de Claude Code
- Prompt caching — API de Anthropic: precios, TTL, mínimos y puntos de corte
- Lessons from building Claude Code: Prompt caching is everything — Thariq Shihipar, Anthropic
- Prompt caching — guía oficial de OpenAI
- Context caching y precios de Gemini — Google AI for Developers
- Context caching on disk — documentación de DeepSeek
🧨 Última oprtunidad para recibir la dinamita que mereces sobre programación con IA el próximo domingo: Suscríbete gratis a Web Reactiva en https://webreactiva.com/newsletter

Escrito con la ayuda de la IA generativa de Claude, fuentes fidedignas y con un human in the loop:
Dani Primo.
12 recursos para developers cada domingo en tu bandeja de entrada
Además de una skill práctica bien explicada, trucos para mejorar tu futuro profesional y una pizquita de humor útil para el resto de la semana. Gratis.