Mejor modelo de IA para programar en 2026: ranking por tarea
(actualizado )
Tabla de contenidos
El mejor modelo de IA para programar depende de si miras el precio. A 26 de octubre de 2026, en las 50 tareas de nuestro selector de modelos, GLM-5.3 Flash y Grok 4.7 son la opción equilibrada en 17 tareas cada uno, y Claude Opus 5.5 es la opción potente en 27. Si escribes tests o documentación, entra Gemini 3.8 Flash. Si haces interfaz, Claude Sonnet 5.5.
Esa es la respuesta corta. La larga cambia en cuanto metes lo que ya pagas: con una suscripción de ChatGPT no vas a usar GLM, por muy bien que salga en una tabla.
Comparador de modelos
¿Dudas entre dos? Ponlos cara a cara
Precio, lo que cuesta una sesión de agente, en qué suscripciones están y en qué tareas gana cada uno. Empieza por GLM-5.3 Flash o elige otro modelo.
En este artículo vas a encontrar:
- El reparto de las 50 tareas y qué modelo gana en cada carril
- Una tabla con el modelo para cada tarea habitual, de planificar a escribir el changelog
- Lo que cuesta de verdad una sesión de agente con cada uno
- Qué modelo te toca según la suscripción que ya tienes
- Una ficha corta de cada modelo, con sus pegas y un enlace a su análisis completo
- Hasta dónde llega lo que sabemos, que no es todo
¿Cuál es el mejor modelo de IA para programar ahora mismo? 
Hay tres ganadores, según cuánto pese el precio en tu decisión. El selector da tres opciones para cada tarea (equilibrada, barata y potente), y cada carril tiene un dominador distinto.
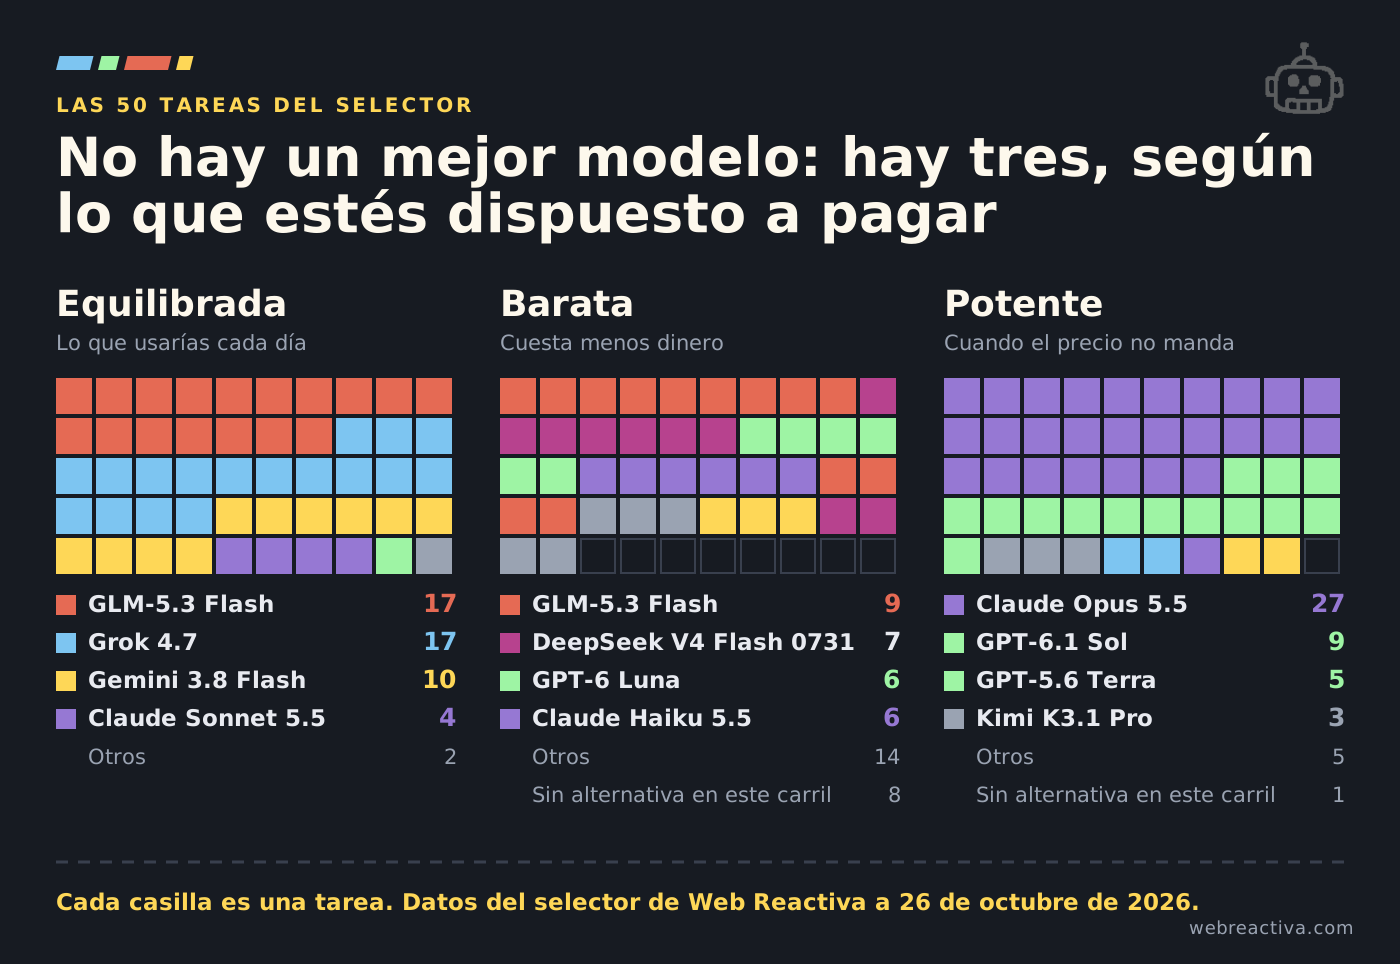
Tres lecturas que puedes llevarte de esa imagen:
- El carril equilibrado es de dos modelos que no existían hace tres meses. Entre GLM-5.3 Flash y Grok 4.7 se reparten 34 de las 50 tareas. El primero se queda con el trabajo de construir: features, refactors, migraciones. El segundo, con el de pensar: planes, depuración, code review, diseño de esquemas.
- Cuando el dinero no manda, sigue mandando Opus. Es la opción potente en 27 de las 49 tareas que tienen ese carril, y las que deja se las reparten sobre todo GPT-6.1 Sol y GPT-5.6 Terra.
- El carril barato es el más abierto. Ningún modelo pasa de 9 tareas, y aquí la competencia está entre el chino de pesos abiertos, DeepSeek y los pequeños de OpenAI y Anthropic.
Si quieres la versión breve para decidir hoy:
| Si tu prioridad es… | Empieza por | Por qué |
|---|---|---|
| Construir mucho por poco dinero | GLM-5.3 Flash | 0,15 $ / 0,50 $ por millón de tokens y es la opción equilibrada de casi todo el trabajo de agente |
| Razonar: planes, bugs y revisión | Grok 4.7 | Es la opción equilibrada en la mayoría de tareas de razonamiento |
| Lo más difícil, sin mirar el precio | Claude Opus 5.5 | La opción potente en 27 tareas |
| Interfaz y componentes | Claude Sonnet 5.5 | La opción equilibrada para construir UI |
| Tests, SQL y documentación | Gemini 3.8 Flash | Equilibrada en esas tareas a 0,75 $ / 3,75 $ (precio promocional) |
| Subagentes y trabajo mecánico | Claude Haiku 5.5 o GPT-6 Luna | 0,10 $ / 0,50 $ por millón |
¿Te abruma tanto nombre? Es normal. Si estás empezando, no te hace falta memorizar nada de esto todavía.
¿Tanto modelo y todavía sin tu primer proyecto con IA?
El curso-juego te asienta las bases en 17 paradas: qué es un modelo y qué es un agente, cuánto presupuesto necesitas y cuál elegir para arrancar.
Entra en el curso gratis →Cómo sabemos lo que sabemos (y dónde acaba) 
Este ranking cruza tres fuentes que publicamos y revisamos, y ninguna de ellas es una prueba propia de laboratorio. Conviene decirlo antes de seguir, porque de eso depende cuánto te puedes fiar del orden.
- El selector de modelos. Parte de rankings reales de uso y de benchmarks recogidos en OpenRouter, se revisa cada mes y reparte cada una de las 50 tareas en tres carriles. Los datos de este artículo son del 26 de octubre de 2026.
- El catálogo de precios. Sale de models.dev, y con él calculamos el coste por sesión de la calculadora de coste de un agente.
- Los análisis del blog. Cada lanzamiento lleva su post, con los benchmarks del fabricante separados de las mediciones de Artificial Analysis, Vals AI y otros independientes.
Y esto es lo que no sabemos:
- No medimos los modelos sobre tu código. Un ranking que pesa el precio te dice por dónde empezar, no cuál rendirá mejor en tu repositorio.
- Grok 4.7 y Gemini 3.8 Flash no tienen análisis propio en el blog. Lo que contamos de ellos sale del selector y del catálogo, y su peso aquí se apoya en esa única fuente.
- Los modelos cambian más rápido que este texto. Gemini 4 Carbon se presentó el 28 de octubre, dos días después de estos datos, y todavía no se puede contratar.
💡 Si te vas a quedar con una sola regla: usa esta tabla para elegir los candidatos y tu propia tarea para decidir. Una tarde con dos modelos sobre un ticket real te dice más que cualquier índice.
¿Qué modelo de IA usar según la tarea? 
Depende de la fase: el modelo que conviene para planificar casi nunca es el que conviene para implementar o para escribir la documentación. Estas son once tareas habituales del selector, con sus tres carriles.
| Tarea | Equilibrada | Barata | Potente |
|---|---|---|---|
| Implementar una feature de principio a fin | GLM-5.3 Flash | Laguna S 2.1 | Opus 5.5 |
| Refactor en muchos ficheros | GLM-5.3 Flash | DeepSeek V4 Flash 0731 | Opus 5.5 |
| Depurar un bug sutil | Grok 4.7 | GLM-5.3 Flash | Opus 5.5 |
| Plan de implementación y arquitectura | Grok 4.7 | GLM-5.3 | Opus 5.5 |
| Code review de un PR | Grok 4.7 | GPT-6 Luna | Fable 5.1 |
| Revisión de seguridad | Grok 4.7 | Gemini 3.8 Flash | Opus 5.5 |
| Autenticación y autorización | GPT-6.1 Sol | DeepSeek V4 Pro 0813 | Opus 5.5 |
| Escribir tests | Gemini 3.8 Flash | Haiku 5.5 | GPT-5.6 Terra |
| Consultas SQL | Gemini 3.8 Flash | Haiku 5.5 | GPT-5.6 Terra |
| Componente de UI | Sonnet 5.5 | Gemini 3.8 Flash | Kimi K3.1 Pro |
| Documentación, commits y changelog | Gemini 3.8 Flash | GPT-6 Luna | Opus 5.5 |
Fíjate en cómo cambia todo a lo largo de una misma feature. Ninguna columna repite el mismo modelo de principio a fin.
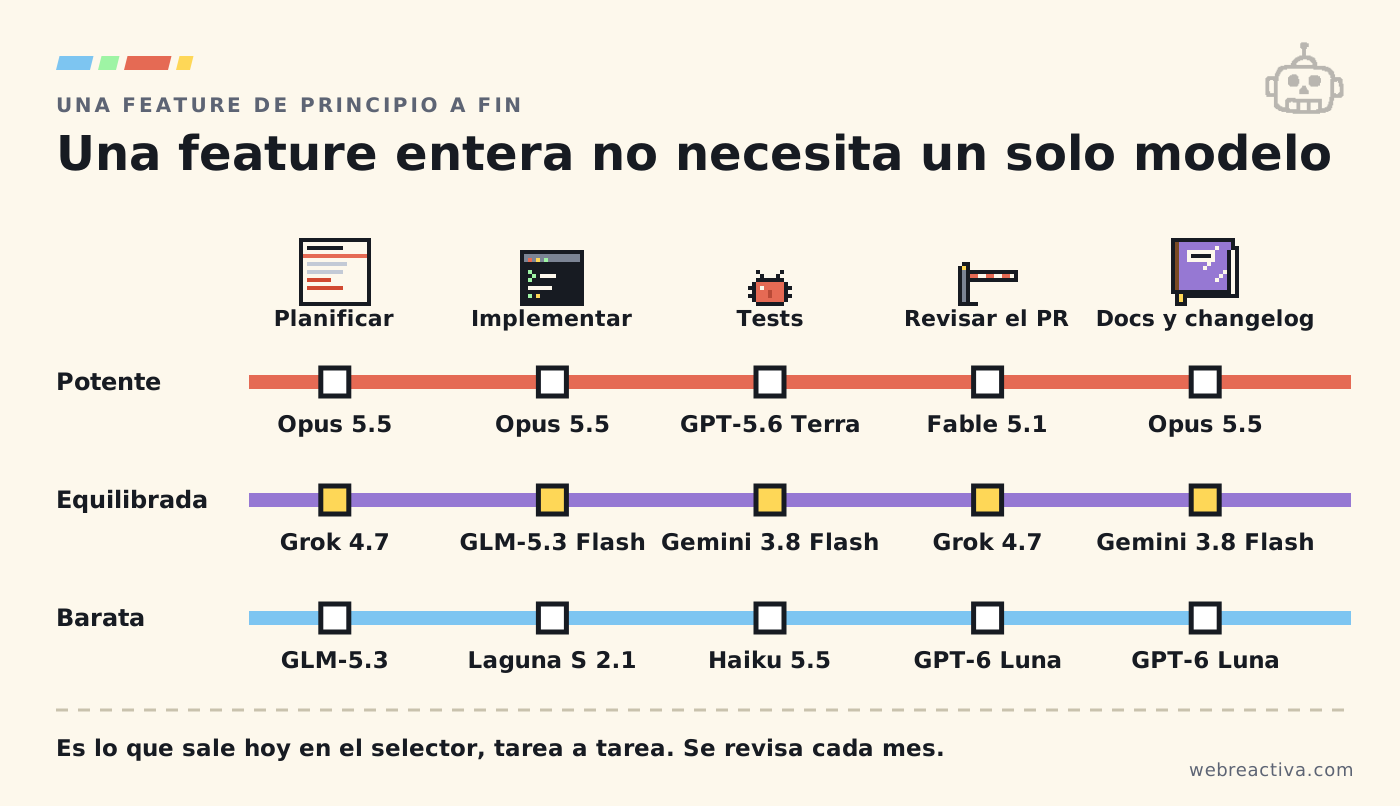
En la práctica pocos cambian de modelo cinco veces por feature, y no hace falta. Con dos ya notas la diferencia: uno bueno para planificar y revisar, y otro barato para ejecutar. Es el mismo reparto de pensadores y ejecutores que explicamos en qué modelo de Claude usar y en qué modelo de GPT usar.
Herramienta gratis · Selector
¿Tu tarea no está en la tabla?
Aquí hay once y el selector tiene cincuenta. Escríbele lo que vas a hacer, márcale lo que ya pagas y te dice qué modelo te conviene y cuál hace casi lo mismo por menos.
Le das
Tu tarea y las suscripciones que ya pagas
Te devuelve
El modelo que te conviene, con alternativa barata
¿Cuánto cuesta programar con cada modelo? 
Una sesión de agente de 25 pasos con caché de prompt cuesta unos 0,02 $ con Haiku 5.5 o GPT-6 Luna, 0,04 $ con GLM-5.3 Flash, 0,34 $ con Sonnet 5.5, 0,68 $ con Opus 5.5 y 1,50 $ con Fable 5.1. Son precios de catálogo a 26 de octubre, para un contexto que empieza en 4.000 tokens, crece 2.500 por paso y devuelve 400 de salida en cada vuelta.
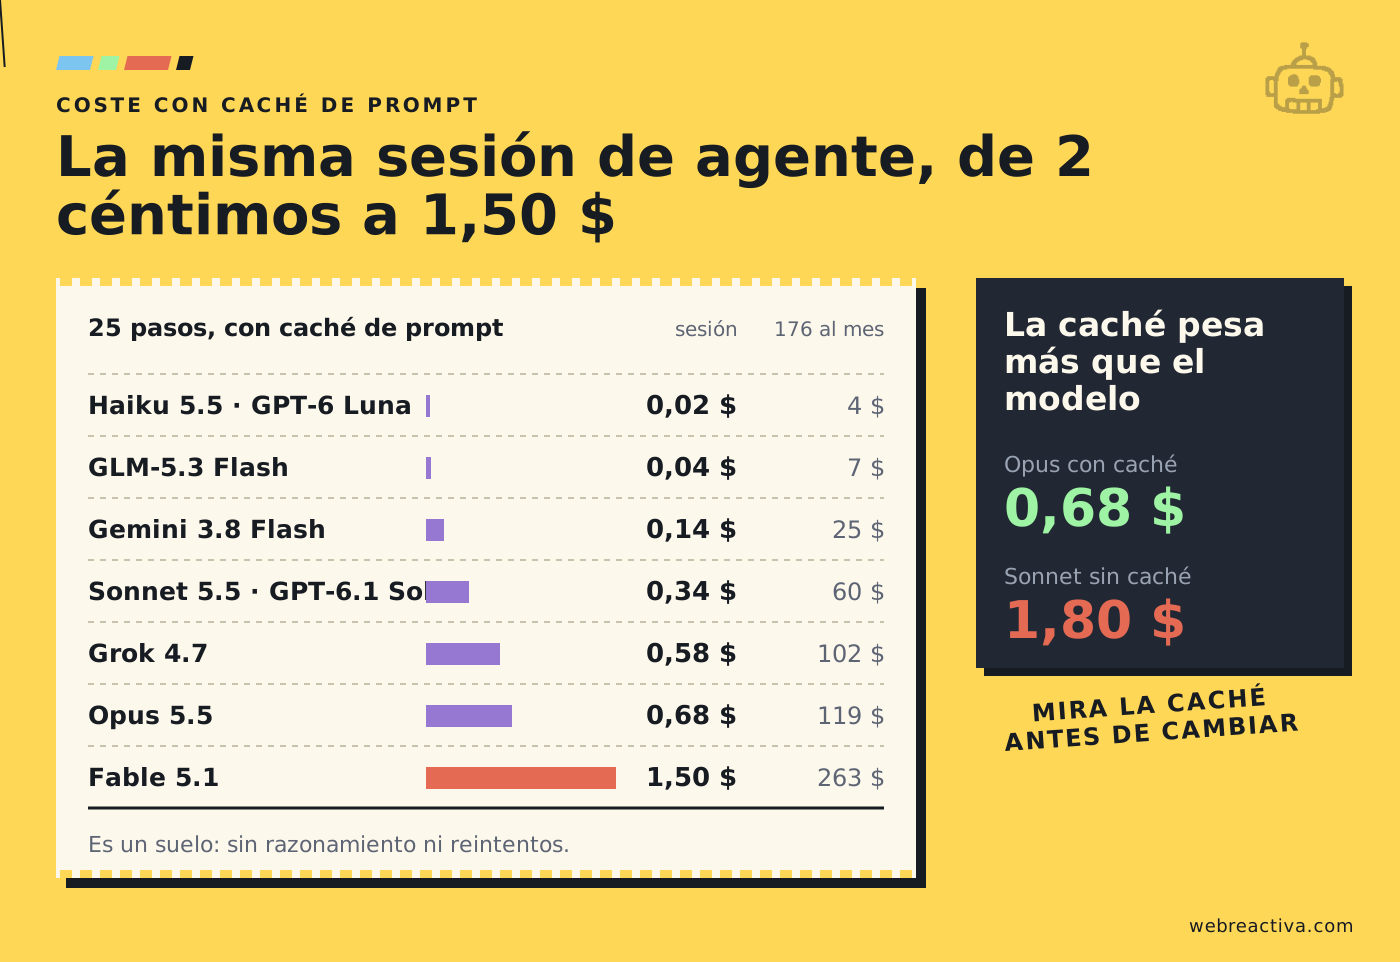
Hay dos cosas en ese recibo que no se ven mirando solo el precio por millón:
La caché pesa más que el modelo. Opus 5.5 con caché sale más barato que Sonnet 5.5 sin ella. Antes de bajar de modelo para ahorrar, revisa que la tengas bien montada; lo explicamos en la guía de prompt caching.
El precio de salida no lo es todo. Grok 4.7 cobra 6 $ por millón de salida frente a los 10 $ de Sonnet 5.5, y aun así su sesión sale más cara (0,58 $ frente a 0,34 $). La razón está en su caché, que cuesta 0,50 $ por millón frente a 0,10 $, y un agente vive de releer su contexto.
Esa cifra es un suelo. No cuenta los tokens de razonamiento, los reintentos ni las horas que pierdes revisando un resultado flojo, que suele ser la partida más cara. Y el nivel de esfuerzo la dispara: Artificial Analysis midió 7,60 $ por tarea con Sonnet 5.5 en max, y Opus 5.5 en max pasa de 1,34 $ en medium a 5,98 $.
⚠️ Haiku 5.5 tiene una trampa: por encima de 100.000 tokens de entrada, la petición entera sale cinco veces más cara. Va muy bien para subagentes y no tanto como agente principal con mucho contexto. Los números están en el análisis de Haiku 5.5.
Para hacer la cuenta con tus propios pasos, usa la calculadora de coste de un agente. Y si dudas entre suscripción y pago por tokens, la de suscripción frente a API.
Qué modelo te toca según lo que ya pagas 
Si ya tienes suscripción, la pregunta pasa a ser cuál es el mejor modelo al que puedes llegar con ella. Esta tabla cuenta en cuántas de las 50 tareas hay algún modelo de esa suscripción entre los cinco mejores, y cuál aparece más veces.
| Suscripción | Tareas cubiertas | Modelo que más veces es tu mejor opción |
|---|---|---|
| Claude | 39 de 50 | Opus 5.5 (27), Haiku 5.5 (10) |
| ChatGPT | 33 de 50 | GPT-6.1 Sol (15), GPT-6 Luna (7) |
| Cursor, solo lo incluido en la cuota | 24 de 50 | Grok 4.7 (24) |
| GitHub Copilot | 50 de 50 | Opus 5.5 (26), GPT-6.1 Sol (10) |
| Google Gemini | 34 de 50 | Gemini 3.8 Flash (34) |
| Grok | 24 de 50 | Grok 4.7 (24) |
| GLM Coding Plan | 41 de 50 | GLM-5.3 Flash (37), GLM-5.3 (4) |
| OpenCode Go | 46 de 50 | GLM-5.3 Flash (36), GLM-5.3 (4) |
| Ollama Cloud | 43 de 50 | GLM-5.3 Flash (37), GLM-5.3 (4) |
Copilot llega a las 50 tareas porque junta modelos de varios laboratorios, mientras que quien paga solo Grok o solo Gemini se queda fuera de la mitad o de un tercio de ellas.
⚠️ Cursor te deja usar los mismos modelos, pero solo Grok y Composer entran en la cuota semanal. Claude, GPT o Gemini se pagan aparte, a precio de API y con crédito prepago, desde el plan Premium. Por eso aquí contamos solo lo incluido, aunque la página del selector para Cursor todavía cuente también esos modelos.
La otra mitad de la decisión es la herramienta, y de eso va la mejor IA para programar.
Esta tabla cambia cada mes, y a veces cada semana. Cada domingo te cuento en la newsletter qué modelo ha salido, qué ha cambiado y si merece que toques tu configuración.
Suscríbete gratis →Los modelos que importan, uno a uno 
Aquí va lo que hemos sacado en limpio de cada uno. Los precios son por millón de tokens de entrada y salida.
GLM-5.3 Flash: el nuevo defecto para construir 
Cuesta 0,15 $ / 0,50 $, tiene un millón de tokens de contexto y pesos publicados con licencia MIT. Antes de tener nombre fue Ox Alpha, el modelo sigiloso más usado de su semana en OpenRouter. Artificial Analysis le dio 57 puntos frente a los 60 de GLM-5.3 en la versión del índice de entonces, con un coste nueve veces menor. La pega: «Flash» describe el coste y no la velocidad (50 tokens por segundo), y tiende a enrollarse.
Grok 4.7: criterio a precio contenido 
Cuesta 2 $ / 6 $ con 500.000 tokens de contexto. Es la opción equilibrada en 17 tareas, casi todas de razonamiento, y la potente en otras 2. Sin análisis propio todavía; el más cercano es el de Grok 4.5 frente a Opus 4.8, con el mismo planteamiento de competir en coste por tarea. Está en GitHub Copilot, T3 Chat y en la suscripción de xAI, y en Cursor entra en la cuota semanal de todos los planes de pago.
Claude Opus 5.5: el techo que se puede pagar 
Cuesta 4 $ / 20 $, con lectura de caché a 0,20 $. Es la opción potente por mayoría, y CodeRabbit le vio detectar 10 de 13 bugs difíciles, frente a los 5 de su configuración de producción. En max puede agotar los 128.000 tokens de salida sin llegar a responder, y en esa misma prueba de CodeRabbit el esfuerzo bajo rindió mejor que el alto. Empieza en medium.
Claude Sonnet 5.5: el ejecutor con criterio 
Cuesta 2 $ / 10 $. Según Anthropic supera a Opus 5.5 en Terminal-Bench 4.0 (70,6 % frente a 66,4 %) y pierde en FrontierCode (46,2 % frente a 54,4 %), así que el reparto natural es Sonnet para ejecutar y Opus para planificar y revisar. En el índice de Vals AI va primero, con un 70,85 %. El selector lo elige en tareas de criterio y de interfaz, y no en código puro, donde el precio le da ventaja a otros.
GPT-6.1 Sol: el mismo precio que Sonnet, en el otro bando 
Cuesta 2 $ / 10 $ con caché a 0,10 $. Según OpenAI iguala a GPT-6 Astra en DeepSWE con un 75,2 %, y Artificial Analysis lo deja a un punto de Astra por menos de una cuarta parte del coste por tarea. Es el modelo por defecto para programar en Codex. Gasta entre un 10 % y un 30 % más de salida que su predecesor y lleva recargo por encima de 272.000 tokens de entrada. Si dudas entre los dos, tienes Sonnet 5.5 y GPT-6.1 Sol en el comparador.
Gemini 3.8 Flash: tests, SQL y documentación a buen precio 
Cuesta 0,75 $ / 3,75 $ en precio promocional hasta final de año y tiene un millón de tokens de contexto. Es la opción equilibrada en tests, SQL, documentación y recreación de interfaces desde una captura. Igual que Grok 4.7, todavía no tiene análisis propio en el blog. Vigila ese precio cuando acabe la promoción.
Haiku 5.5 y GPT-6 Luna: los que hacen el trabajo de abajo 
Los dos cuestan 0,10 $ / 0,50 $ y salen 6 veces cada uno en el carril barato. Haiku 5.5 va bien en subagentes, clasificación, extracción y revisores: seis comprobaciones cuestan menos que una en Sonnet. GPT-6 Luna es barato sin ser más listo que su predecesor, y a 7 céntimos por tarea sigue siendo buen candidato para subagentes.
Fable 5.1 y GPT-6 Astra: solo si has medido que compensan 
Fable 5.1 cuesta 10 $ / 50 $ y en el selector gana una sola tarea, el code review, en el carril potente. El nivel que compensa es high: Simon Willison pagó 3,30 $ por un solo SVG en max. Su sucesor, Fable 5.2, baja a 8 $ / 40 $ y sube a 49,1 % en FrontierCode 2.0 y lidera el índice de Artificial Analysis con 65 puntos, a 26,50 $ de media por tarea en max. GPT-6 Astra cuesta lo mismo y brilla haciendo trabajo autónomo de días, aunque es más difícil de dirigir. Y su famoso 98,6 % en ARC-AGI-3 baja a 62,7 % con un harness estándar.
Gemini 4 Argon y Carbon: los que acaban de llegar 
Gemini 4 Argon se abrió a suscriptores de pago el 13 de octubre. Cuesta 2 $ / 10 $ de lanzamiento y 4 $ / 20 $ después, y su coste por tarea en Artificial Analysis fue de 1,99 $ frente a los 0,72 $ de Sol, porque escribe más del doble de tokens. Gemini 4 Carbon es el número 1 de Artificial Analysis con 59 puntos, uno más que Opus 5.5, pero solo lo tiene un grupo de defensores de ciberseguridad. Todavía no es una opción.
¿Qué modelo open source es mejor para programar? 
GLM-5.3 Flash es el modelo de pesos abiertos mejor colocado del selector, con 26 apariciones entre los carriles equilibrado y barato. Detrás hay dos opciones con propósitos distintos.
| Modelo | Licencia | Para qué |
|---|---|---|
| GLM-5.3 Flash | MIT | El mejor reparto entre capacidad y precio para trabajo de agente |
| DeepSeek V4.1 Flash | MIT | Agentes de código, tests y lotes: 45 en Artificial Analysis y 204 tokens por segundo |
| Qwen3.8-27B | Apache 2.0 | Ejecutar en local: GGUF de unos 17 GB y 24,5 tokens por segundo en un Ryzen AI Max+ 395 |
Abierto no significa gratis ni privado por sí solo. Si usas la API del fabricante, tu código sigue saliendo de tu máquina; la ventaja es que puedes elegir quién lo sirve, o servirlo tú. Qwen3.8-27B además viene pensando demasiado por defecto, con su esfuerzo en xhigh y hasta 50.000 tokens de razonamiento para generar una aplicación.
Por qué los benchmarks no cuentan lo mismo 
Porque miden cosas distintas, los publica a menudo quien vende el modelo y cambian de versión. Tres ejemplos del último mes bastan para desconfiar de cualquier ganador absoluto.
El primero es el índice de Vals AI: Sonnet 5.5 saca un 70,85 %, Gemini 4 Carbon un 70,36 % y Opus 5.5 un 70,18 %. Tres modelos en siete décimas, en un orden que no coincide con el de Artificial Analysis, donde Carbon va primero y Opus segundo.
El segundo es Terminal-Bench 4.0, donde Carbon saca un 65,2 % según Artificial Analysis y un 63,13 % según Vals. La misma prueba y el mismo modelo dan números distintos según quién la ejecute, y Mistral Large 4 repite el patrón: 28,3 % según Mistral, 22,73 % según Vals.
El tercero viene de FrontierCS. Allí, con tareas de hasta cinco horas, Carbon superó 24 de 48 tareas frente a las 26 de Argon, gastando 36,90 $ por ejecución frente a 19,52 $. El modelo más nuevo y mejor valorado rindió peor y costó casi el doble en esa prueba. Cognition también vio a Astra por encima de Fable 5.1 dentro de Devin, cuando Artificial Analysis decía lo contrario: el harness decide tanto como el modelo.
🔑 Usa los benchmarks para descartar. Si un modelo va muy por detrás en lo tuyo, fuera. Si dos están a tres puntos, decide por el precio, por lo que ya pagas y por lo que te dé tu propio ticket de prueba.
Más allá de elegir modelo
Construye agentes con criterio: arquitectura, capas y orquestación
Elegir modelo es solo el principio. Te llevas los 6 niveles de arquitectura para que tu agente no se descontrole en producción: tools, guardarraíles, memoria, skills, MCP y orquestación multiagéntica.
Asomarme a la masterclass →Masterclass en directo · 6 niveles de arquitectura
Cómo elegir tu modelo en una tarde 
Puedes dejar esto resuelto sin leer un benchmark más:
- Abre el selector con lo que ya pagas y tu tarea más frecuente.
- Compara los dos candidatos en el comparador de modelos, mirando el coste por sesión y no solo el precio por millón.
- Dales el mismo ticket real. Uno de tamaño medio, que ya sepas cómo debería quedar.
- Mide tres cosas: cuánto costó, cuántas veces tuviste que corregirlo y si aceptarías el diff tal cual.
- Escribe la regla en tu
AGENTS.mdoCLAUDE.md, para no volver a decidirlo en cada sesión. Si no sabes si te ha quedado bien, pásalo por el revisor de AGENTS.md.
Repítelo cuando salga algo que de verdad te afecte. No cada semana.
TL;DR 
- 🏆 Equilibrio: GLM-5.3 Flash para construir y Grok 4.7 para razonar, con 17 de las 50 tareas del selector cada uno.
- 🧠 Techo: Claude Opus 5.5 es la opción potente en 27 tareas, a 0,68 $ por sesión con caché.
- 💸 Coste: de 0,02 $ por sesión con Haiku 5.5 a 1,50 $ con Fable 5.1, y la caché pesa más que el modelo.
- 🧾 Suscripción: manda lo que ya pagas. Copilot llega a las 50 tareas; Grok, a 24.
- 🧪 Benchmarks: sirven para descartar. Para decidir, un ticket real con dos candidatos.
Preguntas frecuentes 
¿Cuál es el mejor modelo de IA para programar en 2026? 
Depende del carril. Según el selector de Web Reactiva a 26 de octubre de 2026, GLM-5.3 Flash y Grok 4.7 son la opción equilibrada en 17 de las 50 tareas cada uno, y Claude Opus 5.5 es la opción potente en 27. No hay un ganador único porque el orden cambia al pesar el precio.
¿Qué modelo de IA es mejor para programar, Claude o GPT? 
Con precio igual, 2 $ / 10 $ por millón, Sonnet 5.5 y GPT-6.1 Sol están muy cerca: el primero va delante en el índice de Vals AI y el segundo es el modelo por defecto de Codex. En el carril potente, Opus 5.5 aparece 27 veces y Sol 9. Lo normal es que decida la herramienta que ya usas.
¿Cuál es el modelo más barato que sirve para programar? 
Claude Haiku 5.5 y GPT-6 Luna cuestan 0,10 $ / 0,50 $ por millón, unos 0,02 $ por sesión de agente con caché. Para trabajo de agente principal, GLM-5.3 Flash cuesta casi el doble por sesión (0,04 $), pero es la opción equilibrada en muchas más tareas.
¿Qué modelo de IA es mejor para escribir tests? 
En el selector, Gemini 3.8 Flash es la opción equilibrada, Claude Haiku 5.5 la barata y GPT-5.6 Terra la potente. Es un trabajo con reglas claras y fácil de comprobar, así que rara vez compensa pagar un modelo caro.
¿Qué modelo usar para code review? 
Grok 4.7 es la opción equilibrada, GPT-6 Luna la barata y Claude Fable 5.1 la potente. Es la única tarea en la que Fable gana su carril: aquí cuenta encontrar lo que nadie ha visto, y un fallo que se escapa cuesta más que el modelo.
¿Cuál es el mejor modelo open source para programar? 
GLM-5.3 Flash, con pesos MIT, es el modelo abierto mejor colocado del selector. Para ejecutar en local, Qwen3.8-27B con licencia Apache 2.0 cabe en un GGUF de unos 17 GB. DeepSeek V4.1 Flash, también MIT, destaca en agentes de código y trabajos por lotes.
¿Cuánto cuesta programar con un agente de IA al mes? 
Con 176 sesiones de 25 pasos al mes y caché de prompt, unos 4 $ con Haiku 5.5, 7 $ con GLM-5.3 Flash, 60 $ con Sonnet 5.5, 119 $ con Opus 5.5 y 263 $ con Fable 5.1. Es un suelo: no incluye razonamiento ni reintentos. Puedes ajustar los pasos en la calculadora de coste de un agente.
¿Qué modelo usar si ya pago Claude o ChatGPT? 
Con Claude, Opus 5.5 es tu mejor opción en 27 tareas y Haiku 5.5 en 10. Con ChatGPT, GPT-6.1 Sol en 15 y GPT-6 Luna en 7. Las dos suscripciones se quedan sin ningún modelo entre los cinco mejores en parte de las 50 tareas: 11 en Claude y 17 en ChatGPT.
¿Merece la pena pagar Claude Fable 5.1 o GPT-6 Astra? 
Solo si has medido que te compensan. Cuestan 10 $ / 50 $ por millón, 2,5 veces lo que Opus 5.5. Tienen sentido en revisión muy exigente o en trabajo autónomo largo, con el esfuerzo moderado: max puede salir muy caro.
¿Cada cuánto se actualiza este ranking? 
Los datos del selector se revisan cada mes. Este artículo recoge el corte del 26 de octubre de 2026, y los modelos lanzados después pueden no estar en la tabla hasta el corte siguiente. El selector y el comparador siempre tienen el último.
Si buscabas un modelo anterior 
Este artículo solo cubre lo vigente. Si llegaste buscando otra generación, cada una conserva su análisis: Sonnet 5, Opus 5, Fable 5, Opus 4.8, GPT-5.6, GPT-5.5, Sonnet 4.6 frente a Opus 4.6, Gemini 3.1 Pro, GLM-5, Kimi K3, Kimi K2.7, Kimi K2.5 y MiniMax M3.
Fuentes 
Datos propios:
- Selector de modelos de Web Reactiva, corte del 26 de octubre de 2026 (rankings de uso y benchmarks de OpenRouter)
- Comparador de modelos de Web Reactiva, con precios de models.dev
Documentación de los fabricantes:
- Anthropic: Claude Opus 5.5
- Anthropic: Claude Sonnet 5.5
- Anthropic: Claude Haiku 5.5
- OpenAI: Introducing GPT-6.1 Sol
- Z.ai: GLM-5.3-Flash
- Google: Gemini 4 Carbon
- DeepSeek: Models & Pricing
- Cursor: Models & Pricing
Las mediciones de Artificial Analysis, Vals AI, CodeRabbit y Cognition están citadas y enlazadas en el análisis de cada modelo.

Escrito con la ayuda de la IA generativa de Claude, fuentes fidedignas y con un human in the loop:
Dani Primo.
12 recursos para developers cada domingo en tu bandeja de entrada
Además de una skill práctica bien explicada, trucos para mejorar tu futuro profesional y una pizquita de humor útil para el resto de la semana. Gratis.