Claude Haiku 5.5: precio, benchmarks y para qué usarlo
Tabla de contenidos
Anthropic ha presentado hoy, 7 de octubre de 2026, Claude Haiku 5.5. Es el tercer modelo de la familia 5.5, quince días después de Opus 5.5 y nueve después de Sonnet 5.5.
Para quien construye agentes, Haiku 5.5 puede pesar más que Sonnet 5.5. No porque sea mejor modelo: no lo es, y la tabla oficial lo deja claro. Pesa porque su precio te deja montar otra arquitectura.
Con Haiku 4.5 la pregunta era “¿vale la pena hacer otra llamada al modelo?”. Con un modelo a 0,10 dólares el millón de tokens de entrada, la pregunta pasa a ser “¿por qué no hacer cinco comprobaciones independientes?”.
Esto es lo que vas a encontrar aquí:
- Qué es Haiku 5.5, qué cambia frente a Haiku 4.5 y dónde encaja en la familia
- El precio real, con la trampa de los 100.000 tokens que conviene leer antes de migrar
- Los benchmarks con su letra pequeña y la primera medición independiente
- Haiku 5.5 frente a GPT-6 Luna, el rival al que apunta su tarifa
- El patrón que más me interesa: revisores diferenciales baratos y un modelo grande que arbitra
- Lo que no hace bien, lo que dice la comunidad y cómo empezar hoy
Un aviso antes de empezar: el modelo lleva unas horas disponible. Lo que hay son datos del fabricante, una ficha preliminar de Artificial Analysis y las primeras impresiones en Hacker News y Reddit. Voy a separar cada cosa.
¿Qué es Claude Haiku 5.5? 
Claude Haiku 5.5 es el modelo pequeño de la familia 5.5 de Anthropic, pensado para trabajo de alto volumen y baja latencia: clasificación, extracción, enrutado, resúmenes, compactación de contexto y, sobre todo, subagentes que trabajan para Sonnet u Opus. Anthropic lo presenta como “el modelo pequeño más barato, rápido y capaz” que ha publicado.
La ficha técnica, según la documentación oficial:
| Especificación | Claude Haiku 5.5 | Claude Haiku 4.5 | Claude Sonnet 5.5 |
|---|---|---|---|
| ID en la API | claude-haiku-5-5 |
claude-haiku-4-5 |
claude-sonnet-5-5 |
| Contexto | 1M tokens | 200k tokens | 1M tokens |
| Salida máxima | 128k tokens | 64k tokens | 128k tokens |
| Thinking | Adaptativo | Manual (budget) | Adaptativo |
| Effort por defecto (API) | medium |
— | high |
| Precio entrada / salida | desde 0,10$ / 0,50$ | 1$ / 5$ | 2$ / 10$ |
| Latencia relativa | La más rápida | — | Rápida |
| Corte de conocimiento | Junio 2026 | — | Junio 2026 |
Fuente: documentación de modelos de Claude y guía “What’s new in Claude Haiku 5.5”.
Tres novedades afectan a tu código desde el primer día:
- Es el primer Haiku con niveles de esfuerzo (
low,medium,high,xhigh,max) y thinking adaptativo. Haiku 4.5 usaba un presupuesto de tokens manual. Ahora el modelo decide cuánto piensa y tú lo orientas con el effort. - El contexto pasa de 200k a 1M tokens, y la salida de 64k a 128k. Ojo, porque cobrar ese millón tiene truco (lo vemos en el precio).
- Usa el tokenizador nuevo de Claude 4.7 en adelante. El mismo texto cuenta en torno a un 30 % más de tokens que en Haiku 4.5, según la documentación. Si migras, vuelve a contar tus prompts.
Con Haiku 5.5 el catálogo queda completo: Fable 5.1 para el razonamiento más exigente, Opus 5.5 como punto de partida, Sonnet 5.5 para velocidad e iteración y Haiku 5.5 para volumen. Haiku 4.5 pasa a la lista de modelos legacy.
🔑 Mi resumen de la familia en tres palabras: Opus decide. Sonnet hace. Haiku curra.
¿Haiku 5.5, Sonnet 5.5 u Opus 5.5? La respuesta corta 
Si tienes prisa: Haiku 5.5 para todo lo que se repite mucho, es acotado y se puede comprobar. Sonnet 5.5 para implementar. Opus 5.5 para planificar, decidir y revisar lo difícil.
La documentación lo dice con sus palabras: Haiku 5.5 es para “tareas de alto volumen y sensibles a la latencia, como clasificación, extracción y enrutado”. Y la guía de prompting añade algo que conviene leer dos veces: en xhigh y max las respuestas se alargan mucho, así que compara también con Sonnet 5.5 antes de quedarte con Haiku en esfuerzo alto.
Traducido: Haiku 5.5 no es “un Sonnet barato”. Es otra pieza del harness. Rinde cuando le das trabajo de alcance cerrado y lo multiplicas.
¿Y dónde está la frontera? En los benchmarks de coding agéntico. Haiku 5.5 saca un 39,2 % en Terminal-Bench 4.0, frente al 70,6 % de Sonnet 5.5. Esa distancia no se compensa con precio si la tarea es “arregla este bug complicado tú solo”. Sí se compensa si la tarea es “lee este diff y dime si hay un secreto en claro”.
Herramienta gratis · Selector
¿Haiku, Sonnet u Opus para lo tuyo?
La regla de arriba vale para el caso general. Tu caso depende de lo que programas hoy y de las suscripciones que ya pagas: cuéntamelo y te digo qué modelo encaja, con la alternativa barata al lado.
Le das
Tu tarea y las suscripciones que ya pagas
Te devuelve
El modelo que te conviene, con alternativa barata
¿Cuánto cuesta Claude Haiku 5.5? 
Haiku 5.5 cuesta 0,10 dólares por millón de tokens de entrada y 0,50 por millón de salida, siempre que el prompt no pase de 100.000 tokens. Por encima, todo se multiplica por cinco: 0,50$ de entrada y 2,50$ de salida.
La tabla completa, según la página de precios de Claude:
| Haiku 5.5 (≤100k) | Haiku 5.5 (>100k) | Haiku 4.5 | Sonnet 5.5 | Opus 5.5 | |
|---|---|---|---|---|---|
| Entrada / 1M | 0,10$ | 0,50$ | 1$ | 2$ | 4$ |
| Salida / 1M | 0,50$ | 2,50$ | 5$ | 10$ | 20$ |
| Escritura de caché 5 min | 0,125$ | 0,625$ | 1,25$ | 2,50$ | 5$ |
| Lectura de caché / 1M | 0,01$ | 0,05$ | 0,10$ | 0,10$ ¹ | 0,20$ |
| Batch (entrada / salida) | 0,05$ / 0,25$ | 0,25$ / 1,25$ | 0,50$ / 2,50$ | 1$ / 5$ | 2$ / 10$ |
Fuente: página de precios de la documentación de Claude y anuncio de Haiku 5.5.
¹ Anthropic ha aprovechado el lanzamiento para bajar a la mitad la lectura de caché de Sonnet 5.5, de 0,20 a 0,10 dólares el millón. Según la empresa, eso abarata un 20 % la mayoría de cargas agénticas con Sonnet. En el momento de escribir esto, la tabla principal de la página de precios aún muestra 0,20$, aunque el texto de la misma página ya habla de 0,10$. Hasta que cuadren, fíate de tu factura.
Visto en barras, la distancia con sus hermanos mayores es enorme:
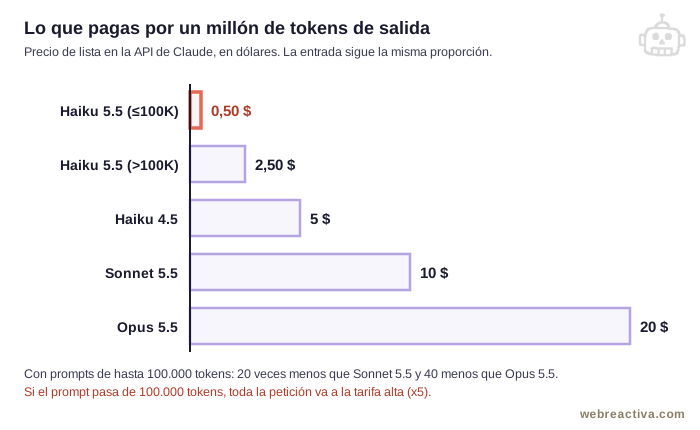
Con prompts cortos, Haiku 5.5 cobra 20 veces menos que Sonnet 5.5 y 40 veces menos que Opus 5.5 por token. Frente a Haiku 4.5, un 90 % menos.
La trampa de los 100.000 tokens 
La letra pequeña que más se discute en Hacker News va de esto. El precio no depende del modelo, depende de la longitud del prompt de cada petición. La documentación lo dice así: “un prompt de más de 100.000 tokens paga precios más altos”. Haiku 5.5 es, además, la excepción en la familia: el resto de modelos 4.6 y posteriores cobran el millón de contexto entero a tarifa estándar.
Una cuenta rápida (mía, no de Anthropic) con una petición que genera 4.000 tokens de salida:
| Prompt | Tarifa | Entrada | Salida | Total por petición |
|---|---|---|---|---|
| 95.000 tokens | Baja | 0,0095$ | 0,002$ | ≈ 0,012$ |
| 105.000 tokens | Alta | 0,0525$ | 0,010$ | ≈ 0,063$ |
Diez mil tokens más de prompt y la petición cuesta cinco veces más. Y recuerda que con el tokenizador nuevo el mismo texto ocupa más tokens que en Haiku 4.5: un prompt que antes medía 80.000 tokens puede pasar ahora de 100.000.
En Hacker News, minimaxir lo resumía así: “100k tokens es un corte absurdamente bajo […] lo vas a superar enseguida si haces cualquier cosa con agentes”. La réplica vino del propio anuncio: según Anthropic, el 90 % de las peticiones a Haiku 4.5 caían por debajo de 100.000 tokens. Y otro usuario, alexchamberlain, lo bajaba a tierra: como subagente que investiga o resume, 100.000 tokens no es poco.
⚠️ Si usas Haiku 5.5 como agente principal con mucho contexto, vas a pagar la tarifa alta casi siempre, y entonces ya no está tan lejos de Sonnet 5.5. Haiku 5.5 brilla cuando cada petición es corta y hay muchas. Diseña para eso.
El 75 % de Anthropic: por tarea, no por token 
La cifra de cabecera del anuncio es otra: Haiku 5.5 cuesta de media un 75 % menos por tarea que Haiku 4.5. Es menos que el 90 % por token porque el tokenizador nuevo gasta algo más de tokens y porque una parte de las peticiones cae en el tramo caro. Anthropic lo reconoce en una nota al pie.
La primera medición independiente matiza otra cosa: la verbosidad. En su ficha preliminar, Artificial Analysis coloca a Haiku 5.5 en max con 43 puntos en su Intelligence Index y un coste de 0,21 dólares por tarea del índice. Para completar el índice generó 440 millones de tokens de salida, frente a una mediana de 120 millones en modelos comparables. Lo califican de “muy verboso”. En max, Haiku piensa mucho, y eso se paga aunque el token sea barato.
Un regalo más del día: Anthropic va a dar créditos mensuales de API a los planes Max y Team: 100 dólares en Max 5x, 200 en Max 20x y hasta 500 compartidos en Team. Con los precios de Haiku 5.5, eso da para muchos experimentos.
Un modelo barato rinde con tareas claras. Aclararlas es tu parte
Haiku 5.5 sale a cuenta cuando cada petición es corta y está bien definida. En la lección 4, Fríeme a preguntas, el agente te interroga por rondas hasta convertir un requisito de una línea en decisiones que ya puedes repartir.
Entra en el curso →¿Qué dicen los benchmarks de Haiku 5.5? 
Los benchmarks oficiales ponen a Haiku 5.5 muy por encima de Haiku 4.5, por delante de GPT-6 Luna en todo lo que Anthropic compara y bastante por debajo de Sonnet 5.5. Esta es la tabla del anuncio:
| Benchmark | Haiku 4.5 | Haiku 5.5 | GPT-6 Luna | Sonnet 5.5 |
|---|---|---|---|---|
| GDPval-AA v2.1 (Elo) | 735 | 1.620 | 1.437 | 1.840 |
| AA-Briefcase v1.1 (Elo) | 614 | 1.578 | 1.336 | 1.824 |
| OSWorld 2.1 (subconjunto offline) | 15,7 % | 72,4 % | 48,9 % | 83,9 % |
| Terminal-Bench 4.0 | 0,0 % | 39,2 % | 16,4 % | 70,6 % |
| FrontierCode 1.1 (Main) | — | 46,4 % | 42,4 % | 52,1 % (xhigh) |
| Humanity’s Last Exam (sin herramientas) | 10,2 % | 45,9 % | — | 56,9 % |
| Humanity’s Last Exam (con herramientas) | 18,7 % | 57,4 % | — | 64,5 % |
| Chartography (sin herramientas) | 6,4 % | 46,4 % | 29,1 % | 61,6 % |
Fuente: anuncio oficial de Anthropic. Todos los resultados los publica el fabricante.
Tres lecturas, de más a menos útil para ti.
La primera: OSWorld. Pasar de un 15,7 % a un 72,4 % en uso de ordenador es el salto más relevante de la tabla. Es el benchmark que mide si el modelo maneja una interfaz: hacer clic, rellenar, navegar. Junto a eso, los SDK de Python y TypeScript añaden soporte en beta para computer use y browser use. Un Haiku que navega bien y cuesta céntimos abre la puerta a agentes de navegador que antes no salían a cuenta.
La segunda: Terminal-Bench 4.0. De un 0,0 % a un 39,2 %. El salto es enorme, pero lee la letra pequeña: según VentureBeat, ese 39 % es en esfuerzo máximo, y en medium (el valor por defecto) se queda en torno al 20 %. Haiku 4.5 era inservible como agente de terminal. Haiku 5.5 empieza a servir, pero lejos de Sonnet.
La tercera: FrontierCode. Un 46,4 % de Haiku frente al 52,1 % de Sonnet 5.5 en xhigh. Un detalle curioso: en la tabla de lanzamiento de Sonnet 5.5, el propio Sonnet en max sacaba un 46,2 %. Es decir, en código mergeable, Haiku 5.5 se mueve en la zona de Sonnet 5.5 en max, que en esa prueba rendía peor que en xhigh. No es comparable punto a punto (configuraciones distintas), pero da una idea de la escala.
⚠️ El salto de Haiku 4.5 a Haiku 5.5 parece de otra liga en todas las filas, pero ninguna de esas cifras está reproducida todavía por terceros. Trátalas como el techo que ha conseguido Anthropic en sus condiciones.
CursorBench: lo que ves depende de cómo lo configures 
Cursor ha publicado su propia ficha del modelo, y es la más útil para un developer porque desglosa el resultado por configuración en CursorBench 4.0:
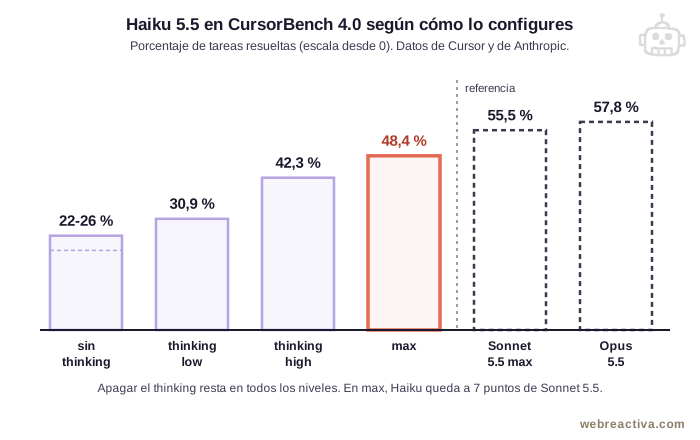
Con thinking activado, Haiku 5.5 va del 30,9 % en low al 42,3 % en high, y llega al 48,4 % en max. Sin thinking se queda entre el 22,1 % y el 26,2 %. Cursor lo dice sin rodeos: apagar el thinking resta en todos los niveles de esfuerzo.
La frase más interesante de esa ficha es otra: Cursor afirma que Haiku 5.5 está en la misma curva de coste y rendimiento que Sonnet 5.5 y Opus 5.5, y que los modelos grandes puntúan más en las tareas difíciles. Traducido: no es un modelo “con trampa” que rinde más de lo que cuesta. Es el punto bajo de la misma curva. Pagas menos, obtienes menos, y la relación se mantiene.
Como referencia, Sonnet 5.5 sacaba un 55,5 % en max y Opus 5.5 un 57,8 %, aunque con configuraciones que no son idénticas.
Lo que dice Artificial Analysis 
En el índice general de Artificial Analysis, los números de la ficha preliminar dejan este cuadro:
| Modelo (esfuerzo) | Intelligence Index | Coste por tarea del índice |
|---|---|---|
| Opus 5.5 (max) | 58 | — |
| Sonnet 5.5 (max) | 56 | 7,60$ |
| Haiku 5.5 (max) | 43 | 0,21$ |
| GPT-6 Luna (max) | 37 | 0,07$ |
Fuente: fichas de Artificial Analysis, recogidas en nuestros análisis de Sonnet 5.5 y GPT-6 Sol y Luna.
Haiku 5.5 queda seis puntos por encima de Luna y trece por debajo de Sonnet 5.5. Por coste, sale a tres veces lo que Luna por tarea y unas 36 veces más barato que Sonnet 5.5 en max. Es una ficha preliminar y faltan datos de velocidad, así que la tomo como primera foto, no como veredicto.
Elegir modelo ya va de qué le encargas a cada uno y cuánto te cuesta cada vuelta del agente. De eso hablamos cada domingo en la newsletter: cómo adoptamos la IA en el día a día del desarrollo, con lo que funciona y lo que no. Gratis, ya somos +7.200.
Suscríbete gratis →Claude Haiku 5.5 vs GPT-6 Luna: el duelo de los 10 céntimos 
Haiku 5.5 y GPT-6 Luna cuestan lo mismo con prompts cortos: 0,10 dólares de entrada, 0,50 de salida y un céntimo de lectura de caché. No es casualidad. En Hacker News, esafak lo llamaba “su forma creativa de igualar los precios de Luna”.
La diferencia está en el umbral:
| Dimensión | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| Entrada / salida (prompt corto) | 0,10$ / 0,50$ | 0,10$ / 0,50$ |
| Lectura de caché | 0,01$ | 0,01$ |
| Umbral de tarifa alta | 100.000 tokens | 272.000 tokens |
| Recargo por encima | x5 en todo | x2 entrada y caché, x1,5 salida |
| Contexto | 1M | 1,05M |
| Intelligence Index (max, AA) | 43 | 37 |
| Coste por tarea del índice | 0,21$ | 0,07$ |
Fuentes: documentación de precios de Claude, anuncio de Haiku 5.5, VentureBeat, la ficha de GPT-6 Luna de OpenAI (citada en Hacker News) y Artificial Analysis.
Hay un matiz más que señalaba Tiberium en Hacker News: los tokenizadores no miden igual. Según su cálculo, 100.000 tokens de Claude equivalen a unos 60.000-65.000 tokens de GPT, así que el umbral de Haiku está todavía más cerca de lo que parece frente al de Luna.
Mi lectura:
- Si tu carga son peticiones cortas (clasificar, extraer, resumir un documento, revisar un diff), Haiku 5.5 te da más capacidad al mismo precio por token, aunque gaste más tokens por tarea.
- Si tu carga son contextos largos, Luna sale bastante más barato. Entre 100.000 y 272.000 tokens, Haiku cuesta cinco veces lo que Luna. Por encima de 272.000, cuando Luna aplica su recargo, Haiku sigue costando más del doble.
- Si ya vives en Claude Code, Haiku 5.5 es el cambio natural para tus subagentes. Si vives en Codex, Luna sigue siendo muy buena opción.
Los comentarios del día van en las dos direcciones. dannyw escribía que Haiku 5.5 es “notablemente más listo que GPT-6 Luna” y que se parece más a un “Sonnet 5.2”. WinstonSmith84 le respondía que eso “está por ver en la práctica” y que, como no tiene trabajo agéntico por debajo de 100.000 tokens, a él le saldría cinco veces más caro de lo que enseñan los gráficos.
Y la comparación no acaba en Luna. Según la tabla de VentureBeat, Gemini 3.5 Flash-Lite cuesta 0,30$ / 2,50$ y Gemini 3.8 Flash 0,75$ / 3,75$ (precio promocional hasta final de año). En el terreno de la clasificación pura, HarHarVeryFunny recordaba que Jev cobra 0,04 dólares el millón, dos veces y media menos. Haiku 5.5 no es el más barato del mercado. Es el más barato que tiene Anthropic, con una capacidad que hace un año costaba diez veces más.
¿Por qué Haiku 5.5 puede importar más que Sonnet 5.5 para tus agentes? 
Porque el coste marginal de una llamada decide qué arquitecturas te puedes permitir. Y Haiku 5.5 baja ese coste lo suficiente como para cambiar el diseño, no solo la factura.
Piensa en cómo has montado tus agentes hasta ahora. Cada llamada extra al modelo era una decisión: “¿compensa añadir una comprobación más?”. Casi siempre la respuesta era no. Así que juntabas todo en un prompt gigante: “revisa seguridad, alcance, tests y arquitectura”. Un solo revisor, con cuatro sombreros, que acaba haciendo cuatro cosas a medias.
Con Haiku 4.5 a 1$ / 5$, separar eso en cuatro llamadas costaba lo mismo que una llamada a Sonnet. No había incentivo. Con Haiku 5.5 a 0,10$ / 0,50$, separar en seis revisores independientes cuesta menos que una sola pasada de Sonnet.
Ese es el cambio de mentalidad:
- Antes: ¿vale la pena otra llamada al LLM?
- Ahora: ¿por qué no hacer cinco comprobaciones independientes?
La comunidad ya está llegando a esa conclusión por su cuenta. En el hilo de lanzamiento de r/ClaudeAI, un usuario que mantiene 18 tareas programadas con OpenClaw lo resumía así, según el hilo: Haiku se ha convertido en el caballo de batalla, y “no necesita ganar a Sonnet”. Necesita ser lo bastante bueno para el trabajo repetitivo. En Hacker News, Philpax lo decía de otra forma: “la gente no usaba Haiku 4.5 para agentes. El 5.5 es lo bastante bueno como para que sí”. Y mnicky apuntaba el uso obvio: subagente al que un orquestador en Sonnet u Opus le pasa tareas que caben de sobra en 100.000 tokens.
Esto encaja con la jerarquía que dibujé en el post de Sonnet 5.5, donde la última capa estaba pendiente de este lanzamiento:
Opus 5.5    →  planifica, divide el trabajo y decide
   │
   ├── Sonnet 5.5  →  implementa (alcance cerrado)
   │
   └── Haiku 5.5 ×N  →  busca, lee, clasifica, resume, comprueba
                        (muchas llamadas cortas, en paralelo)
Las tareas que le encajan a Haiku 5.5 en un harness de programación:
- Exploración: buscar archivos, leer módulos y devolver un resumen corto al orquestador.
- Compactación: resumir el historial de una sesión larga antes de que se llene el contexto.
- Clasificación y enrutado: decidir a qué subagente va cada tarea, etiquetar issues, triar bugs.
- Extracción: sacar datos estructurados de logs, documentos o respuestas de APIs.
- Comprobaciones independientes: el caso que más me interesa, y que tiene sección propia.
Si nunca has montado un subagente, en cómo crear subagentes para programar con IA tienes doce prompts listos para copiar, con el campo model explicado.
Revisores diferenciales: seis Haiku miran, uno decide 
La idea es sencilla: en lugar de un revisor generalista, varios revisores especializados en Haiku 5.5, cada uno con una sola pregunta, y un modelo grande que arbitra. Los llamo diferenciales porque cada uno mira el mismo cambio desde un ángulo distinto, como en un diagnóstico médico.
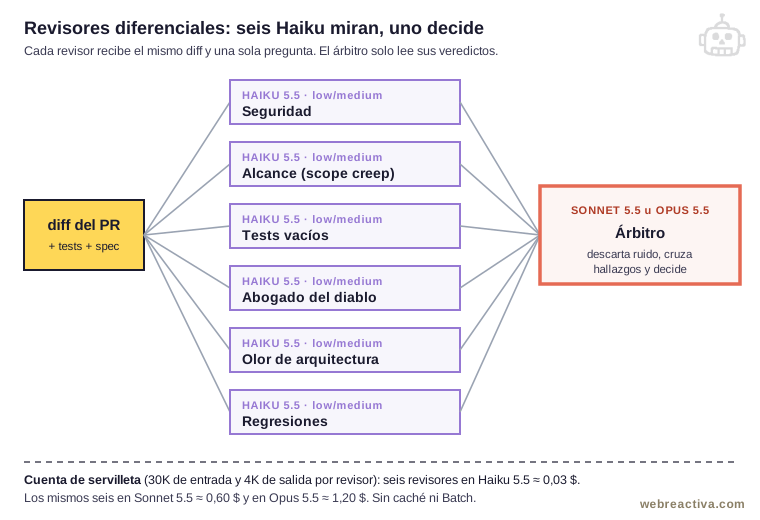
Los seis que yo pondría:
| Revisor | La única pregunta que responde |
|---|---|
| Seguridad | ¿Hay secretos, inyecciones, permisos abiertos o validaciones que faltan? |
| Alcance | ¿El cambio hace algo que la tarea no pedía? |
| Tests vacíos | ¿Los tests nuevos comprueban algo de verdad o pasan siempre? |
| Abogado del diablo | ¿En qué caso concreto se rompe esto? |
| Olor de arquitectura | ¿Rompe capas, duplica lógica o mete dependencias raras? |
| Regresiones | ¿Qué comportamiento anterior puede cambiar sin que nadie lo note? |
El árbitro, en Sonnet 5.5 u Opus 5.5, no vuelve a revisar el código entero. Lee seis veredictos cortos, descarta los falsos positivos, cruza lo que se repite y decide: merge, cambios o un humano.
¿Por qué funciona mejor que un revisor único? Por tres motivos:
- Cada revisor tiene un prompt corto y una sola tarea. La guía oficial de prompting de Haiku 5.5 avisa de que, con prompts largos de agente en
low, el modelo tiende a parar antes de tiempo. Prompts cortos y tareas cerradas son su terreno. - Los errores son independientes. Si el revisor de seguridad no ve algo, no arrastra al de regresiones. Un revisor con seis sombreros se equivoca en bloque.
- El modelo caro solo lee conclusiones. Opus no gasta tokens buscando, gasta tokens decidiendo, que es donde rinde.
La cuenta de servilleta (mía, con precios de lista, sin caché ni Batch): si cada revisor lee 30.000 tokens entre diff, tests y spec, y genera 4.000 de salida contando el thinking:
| Seis revisores en… | Por revisor | Total |
|---|---|---|
| Haiku 5.5 | 0,005$ | 0,03$ |
| Sonnet 5.5 | 0,10$ | 0,60$ |
| Opus 5.5 | 0,20$ | 1,20$ |
Súmale el árbitro en Sonnet (unos 0,11$ leyendo el diff y los seis veredictos) y toda la revisión sale por unos 15 céntimos, menos que dos revisores en Sonnet. Fíjate en que cada revisor queda muy por debajo de los 100.000 tokens: es justo el perfil de petición para el que está pensado el precio.
En Claude Code, cada revisor es un subagente. Uno de ejemplo:
---
name: vacuous-test-reviewer
description: Revisa si los tests nuevos de un diff comprueban algo real. Úsalo en cada PR que añada o cambie tests.
model: claude-haiku-5-5
tools: Read, Grep, Glob
---

Recibes un diff. Responde a UNA sola pregunta:
¿los tests nuevos fallarían si el código que prueban estuviera mal?

Busca tests que no tienen aserciones, que solo comprueban que algo
"no lanza", que mockean justo lo que deberían probar o que pasan
con cualquier implementación.

Devuelve como máximo 5 hallazgos, cada uno con fichero, línea y por qué.
Si no encuentras nada, responde "SIN HALLAZGOS". No propongas arreglos.
El campo model acepta el alias haiku o el ID completo. Pongo el ID para no depender de a qué versión apunta el alias en tu instalación.
🛡️ Más revisores no te libran de verificar. Un revisor barato que se equivoca rápido produce ruido rápido. Por eso existe el árbitro, y por eso cada revisor tiene que devolver hallazgos concretos (fichero, línea, motivo), no opiniones.
Si te interesa el lado del proceso, en ¿necesitas revisar todo el código que genera la IA? repasamos las técnicas para confiar en código que no has escrito tú.
Tu IA puede mentirte
Revisores baratos, sí. Pero alguien tiene que comprobar a los revisores
Verás cómo montar una revisión entre modelos que se contradicen a propósito, pruebas en navegador con Playwright y casos Gherkin para que lo que dice el agente se pueda comprobar, no solo creer.
Destripar el método →Masterclass en directo · métodos + casos Gherkin
Lo que Haiku 5.5 no hace bien 
Que sea barato no lo hace bueno para todo. Las primeras horas ya han dejado varios límites a la vista.
Interfaces complejas desde una imagen. jjcm probó en Hacker News a convertir un diseño denso en HTML. Su conclusión: Haiku 5.5 “no era lo bastante bueno para UI compleja”. Opus 5.5 replicaba el diseño casi al píxel y Haiku “construyó otra cosa”. Lo curioso es que Haiku, al ver la tarea, intentó delegarla en Opus 5.5. Sabe lo que no sabe hacer.
Resultados irregulares al migrar. d1l contaba que en su empresa usan Haiku 4.5 para tareas sencillas sensibles a la latencia, y que sus primeras pruebas con 5.5 eran malas: “fuga del prompt incluso. Y es más lento”. Otro usuario le sugería revisar los prompts para el modelo nuevo. Con el thinking activado por defecto, un prompt pensado para Haiku 4.5 puede comportarse distinto.
Verbosidad en esfuerzo alto. Lo hemos visto con Artificial Analysis: en max genera muchísimos tokens. La propia guía de Anthropic recomienda comparar con Sonnet 5.5 antes de usar Haiku en xhigh o max.
Parar antes de tiempo y no comprobar. La guía de prompting reconoce dos comportamientos en esfuerzos bajos: con prompts largos de agente en low, a veces para antes de acabar y devuelve la tarea al usuario, y en low y medium a veces da un cambio de código por terminado sin ejecutar ninguna comprobación. Anthropic incluye párrafos de prompt para corregir las dos cosas, y los tienes en la sección de cómo empezar.
Velocidad. Anthropic dice que es su modelo más rápido “a velocidad estándar”, aunque más lento que Opus en Fast Mode. Topfi midió en OpenRouter unos 131 tokens por segundo de mediana en las primeras horas, en torno al doble que Luna según su comentario. Es una cifra temprana que puede moverse.
💡 Haiku 5.5 rinde con tareas cortas, bien definidas y comprobables. Si la tarea es larga, ambigua o visual, sube a Sonnet. Ese es su sitio en la familia.
¿Qué dice la comunidad? 
Con unas horas de vida, lo que hay son primeras impresiones, no reviews. El anuncio subió a lo más alto de Hacker News en unos 17 minutos (un usuario bromeaba con qué hacemos mientras trabajan los agentes) y rondaba los 300 puntos esa misma tarde.
Las ganas venían de antes. En el hilo de Opus 5.5, sznio decía que le emocionaba más el anuncio de Haiku 5.5 “enterrado” en el post que el propio Opus, con la esperanza de tener por fin “un modelo rápido decentemente capaz”. mchusma iba más al grano: “espero que Haiku sea Pareto mejor que Luna/Deepseek”. Y en el de Sonnet 5.5, aniceperson hablaba de una “revolución silenciosa de los modelos pequeños” con Luna y Jev: rutinas en segundo plano que por fin salen a cuenta.
El entusiasmo viene sobre todo de quien ya usaba modelos pequeños en producción:
- swalsh: usa GPT-6 Luna “para casi todos mis flujos de agentes” y se cambiaría si Haiku 5.5 es mejor al mismo precio, “con la salvedad de los 100k”.
- axthauvin: “lo voy a usar para sustituir a Luna en producción”.
- steve_adams_86: lo usa para parsear documentos barato y en sus skills le dice a Claude que use Haiku “para el trabajo pesado de poco razonamiento”.
- insanitybit: lo usa para una primera pasada de triaje de bugs, agrupando incidencias relacionadas, y luego deja que Sonnet investigue.
En Reddit, el hilo de lanzamiento de r/ClaudeAI va en la misma línea, según los comentarios recopilados: además del usuario de las 18 tareas de OpenClaw, otro usa Gemini Flash Lite y va a compararlos, otro usaba Luna para tests y pipelines de datos, y otro usa Haiku para recoger pedidos personalizados preguntando al cliente, sin formulario.
El escepticismo también tiene peso. Hace unos días, en el hilo de Sonnet 5.5 en Artificial Analysis, epolanski resumía el problema de fondo: “el problema de los benchmarks es que son de extremo a extremo”, y ramon156 hablaba de “benchmaxxing” (afinar el modelo para las pruebas). En r/SillyTavernAI la reacción a la tabla oficial fue parecida: esos números “ya no significan mucho”. Y en el hilo de hoy, oh_no sospechaba que Anthropic está optimizando el coste por tarea de sus gráficos y que los benchmarks de terceros se parecerán más al gráfico menos favorable del anuncio.
Hay contexto que explica el tono. Haiku 4.5 llevaba casi un año sin relevo, y en el hilo de Sonnet 5.5 había quien daba Haiku por muerto: “Haiku 5.5 nace muerto sin un recorte de precio enorme”, escribía ac29. El recorte ha llegado. Ahora toca ver si el rendimiento acompaña fuera de la tabla oficial.
Las primeras impresiones de cada modelo cambian en días. Cada domingo te cuento con calma qué estamos aprendiendo al usarlos en proyectos reales, junto a 12 recursos seleccionados. +7.200 developers, gratis desde 2018.
Apúntate gratis →¿Es seguro Haiku 5.5? Salvaguardas y rechazos 
Haiku 5.5 tiene salvaguardas de ciberseguridad más estrictas que Haiku 4.5, pero menos que Sonnet 5.5. Según el anuncio, permiten más tareas defensivas que las de Sonnet 5.5, pero siguen bloqueando las pruebas de penetración y otras técnicas más propias de atacantes. En biología, las salvaguardas son las mismas que en Sonnet 5, Sonnet 5.5 y Opus 5.
El detalle técnico que te afecta si lo integras por API: Haiku 5.5 puede rechazar una petición con stop_reason: "refusal", y la respuesta indica la categoría (cyber, bio, frontier_llm o general_harms). Con Haiku 4.5 esto no pasaba. Y a diferencia de Sonnet 5.5, no tiene cambio automático de modelo en el servidor: si se rechaza, te toca gestionarlo en tu cliente. Reenviar la misma petición suele devolver otro rechazo.
La documentación aclara que buscar vulnerabilidades en código fuente está permitido. Aun así, en Hacker News caaqil se preguntaba qué significa “permitir más tareas defensivas” si se bloquea el pentesting. Es una pregunta razonable que todavía no tiene respuesta práctica.
⚠️ Si vas a usar Haiku 5.5 como revisor de seguridad, prueba antes con tus diffs reales. Un rechazo en mitad de un pipeline de revisión rompe el flujo si tu código no gestiona
stop_reason: "refusal".
Cómo empezar a usar Haiku 5.5 hoy 
Haiku 5.5 está disponible desde hoy en la API con el identificador claude-haiku-5-5, en Amazon Bedrock (anthropic.claude-haiku-5-5), Google Cloud, Microsoft Foundry y Claude Platform on AWS. En Cursor se activa desde Settings > Models, con acceso a todas las herramientas del agente. Y en Claude Code, según la guía de prompting, arranca en medium, igual que en la API.
Un ejemplo mínimo en Python para un clasificador, fijando el effort:
import anthropic

client = anthropic.Anthropic()

# Haiku 5.5 como clasificador barato: effort bajo y respuesta corta
response = client.messages.create(
    model="claude-haiku-5-5",
    max_tokens=2000,  # el thinking cuenta dentro de max_tokens
    output_config={"effort": "low"},
    messages=[
        {
            "role": "user",
            "content": "Clasifica este issue como bug, feature o pregunta. "
                       "Responde solo con la etiqueta.\n\n" + issue_text,
        }
    ],
)

# La respuesta puede empezar con bloques de thinking: filtra por tipo
answer = next(b.text for b in response.content if b.type == "text")
print(answer)
Fíjate en la última línea. Con el thinking adaptativo activado por defecto, la respuesta puede empezar por un bloque de thinking. Si tu código leía response.content[0].text, se rompe.
Si vienes de Haiku 4.5, la guía de novedades lista cinco cambios que devuelven error 400:
- El thinking manual con
budget_tokensya no vale: usa el thinking adaptativo y el effort. temperature,top_pytop_kcon valores no por defecto dan error. Quítalos.- El prefill del mensaje del asistente da error: termina siempre con un turno de usuario.
- Computer use necesita el toolset nuevo,
computer_toolset_20260801, en la API y Google Cloud. - Si modificas turnos anteriores, los bloques de thinking que reenvíes dejan de ser válidos. Mantén las conversaciones en modo solo-añadir.
Y tres consejos de la guía de prompting que conviene aplicar desde el primer día:
- Empieza en
mediumy pruebalowyhighcon tus evals.lowpara chat y peticiones simples de mucho volumen;highpara trabajo de conocimiento e instrucciones estrictas. Puedes apagar el thinking conthinking: {"type": "disabled"}enlow,mediumyhigh, pero enxhighymaxdevuelve un 400. - Si lo usas como agente de código, pídele que verifique. Anthropic propone añadir al system prompt un párrafo que obliga a ejecutar tests, type-checker o build antes de dar un cambio por terminado.
- Si busca en la web, dale la fecha de hoy en el system prompt. En las pruebas de Anthropic, eso basta para que se apoye en resultados recientes.
Lo que merece una tarde de tu tiempo: coge diez peticiones reales de tu flujo, pásalas por Haiku 4.5, Haiku 5.5 en low y en medium, y anota coste, latencia, tokens y aciertos. Esa es la cifra que acaba en tu factura.
¿Qué vigilar en los próximos días? 
Haiku 5.5 tiene horas de vida y faltan piezas importantes. Esto es lo que yo miraría entre hoy y el fin de semana:
- La evaluación completa de Artificial Analysis, con velocidad medida y los niveles de esfuerzo bajos, no solo
max. Ahí se verá si el coste por tarea enlowymediumaguanta frente a Luna. - Reproducciones independientes de Terminal-Bench y OSWorld. El 72,4 % en uso de ordenador es la cifra que más cambia lo que se puede construir. Si se confirma, los agentes de navegador baratos van a multiplicarse.
- Experiencias reales migrando desde Haiku 4.5, sobre todo en tareas sensibles a la latencia, donde ya hay quejas de lentitud.
- Cómo se comporta el umbral de 100.000 tokens en agentes reales con caché. La documentación no aclara si los tokens leídos de caché cuentan para el umbral. Hasta que lo confirmes con tu factura, asume que sí.
- Falsos positivos de las salvaguardas en tareas de seguridad defensiva.
La lectura que me llevo 
Si quito el ruido del lanzamiento, me quedo con cinco ideas:
- Haiku 5.5 no compite con Sonnet, lo multiplica. Su sitio es debajo, haciendo muchas tareas pequeñas que antes no se hacían por coste.
- El precio es la noticia: 0,10$ / 0,50$ por millón, un 90 % menos que Haiku 4.5 por token y un 75 % menos por tarea según Anthropic. Pero solo con prompts de hasta 100.000 tokens.
- El salto de capacidad frente a Haiku 4.5 es enorme en todas las filas, con OSWorld (de 15,7 % a 72,4 %) como el dato que más puertas abre. Falta confirmarlo fuera.
- Frente a GPT-6 Luna, más capacidad al mismo precio por token en prompts cortos, pero más caro por tarea y mucho más caro en contextos largos.
- La arquitectura cambia: de “¿vale la pena otra llamada?” a “¿por qué no cinco comprobaciones independientes?”.
Opus decide. Sonnet hace. Haiku curra. Y con este precio, por fin compensa tener a varios Haiku currando a la vez.
¿Qué comprobación de tu flujo dejarías hoy en manos de seis revisores baratos?
TL;DR 
- 🚀 Claude Haiku 5.5 sale el 7 de octubre de 2026:
claude-haiku-5-5, 1M de contexto, 128k de salida y, por primera vez en un Haiku, niveles de esfuerzo (mediumpor defecto). - 💰 Cuesta 0,10$ / 0,50$ por millón con prompts de hasta 100.000 tokens, 20 veces menos que Sonnet 5.5. Por encima del umbral, la petición entera sale cinco veces más cara.
- ⚡ Frente a Haiku 4.5: OSWorld de 15,7 % a 72,4 % y Terminal-Bench 4.0 de 0 % a 39,2 % (en
max). Supera a GPT-6 Luna en todas las pruebas que publica Anthropic. - 🎯 Su sitio está en subagentes, clasificación, extracción, compactación y revisores diferenciales: seis comprobaciones en Haiku cuestan menos que una en Sonnet.
- ⚠️ Artificial Analysis lo pone en 43 puntos en
maxcon 0,21$ por tarea, pero muy verboso. Faltan evaluaciones independientes completas.
Preguntas frecuentes sobre Claude Haiku 5.5 
¿Cuándo salió Claude Haiku 5.5?
Anthropic lanzó Claude Haiku 5.5 el 7 de octubre de 2026, quince días después de Opus 5.5 y nueve después de Sonnet 5.5. Está disponible desde el primer día en la API de Claude, Amazon Bedrock, Google Cloud, Microsoft Foundry y Claude Platform on AWS, además de en Claude Code y Cursor.
¿Cuánto cuesta Claude Haiku 5.5?
Con prompts de hasta 100.000 tokens cuesta 0,10 dólares por millón de entrada, 0,50 por millón de salida y 0,01 la lectura de caché. Por encima de 100.000 tokens, todas las tarifas se multiplican por cinco: 0,50$ de entrada y 2,50$ de salida. El Batch API aplica un 50 % de descuento.
¿Cuál es el identificador de Haiku 5.5 en la API?
El identificador es claude-haiku-5-5 en la API de Claude, Google Cloud, Microsoft Foundry y Claude Platform on AWS. En Amazon Bedrock es anthropic.claude-haiku-5-5.
¿Qué diferencia hay entre Haiku 5.5 y Haiku 4.5?
Haiku 5.5 cuesta un 90 % menos por token en prompts cortos, tiene 1M de contexto (frente a 200k), 128k de salida (frente a 64k), thinking adaptativo con niveles de esfuerzo y mejora todos los benchmarks publicados. A cambio, usa un tokenizador que cuenta un 30 % más de tokens para el mismo texto y rompe cinco cosas de la API, como temperature o el prefill.
¿Haiku 5.5 es mejor que GPT-6 Luna?
En la tabla de Anthropic supera a Luna en todas las pruebas, y Artificial Analysis le da 43 puntos frente a 37 en esfuerzo máximo. Cuestan lo mismo por token con prompts cortos, pero Haiku gasta más tokens y sale a unos 0,21 dólares por tarea frente a 0,07 de Luna. En contextos largos, Luna es más barato.
¿Cuándo conviene usar Haiku 5.5 en lugar de Sonnet 5.5?
Para tareas cortas, bien definidas y de mucho volumen: clasificación, extracción, resúmenes, compactación de contexto, exploración de código y subagentes de revisión. Para implementar cambios complejos, tareas largas o interfaces a partir de diseños, Sonnet 5.5 sigue siendo mejor opción.
¿Qué es la tarifa de más de 100.000 tokens de Haiku 5.5?
Haiku 5.5 es el único modelo actual de Claude que cobra según la longitud del prompt. Si una petición supera los 100.000 tokens de prompt, toda la petición se cobra a la tarifa alta, cinco veces más cara. Según Anthropic, el 90 % de las peticiones a Haiku 4.5 quedaban por debajo de ese umbral.
¿Haiku 5.5 sirve para programar con agentes?
Sirve como subagente y para tareas de código acotadas, pero no como agente principal en tareas difíciles. Saca un 39,2 % en Terminal-Bench 4.0 en esfuerzo máximo (en torno al 20 % en medium) frente al 70,6 % de Sonnet 5.5, y Cursor lo sitúa entre un 30,9 % y un 48,4 % en CursorBench con thinking.
¿Se puede desactivar el thinking en Haiku 5.5?
Sí, con thinking: {"type": "disabled"}, pero solo en los esfuerzos low, medium y high. En xhigh y max devuelve un error 400. Según Cursor, apagar el thinking baja el rendimiento en todos los niveles, así que Anthropic recomienda controlar el coste con el effort.
¿Tiene Haiku 5.5 restricciones de seguridad?
Sí. Sus salvaguardas de ciberseguridad son más estrictas que las de Haiku 4.5 y menos que las de Sonnet 5.5, y bloquean el pentesting. Puede rechazar peticiones con stop_reason: "refusal" y no tiene cambio automático de modelo en el servidor, así que tu cliente debe gestionar esos rechazos.
Fuentes 
- Anthropic, “Introducing Claude Haiku 5.5”
- Claude Platform Docs, “Claude Haiku 5.5”
- Claude Platform Docs, “What’s new in Claude Haiku 5.5”
- Claude Platform Docs, “Prompting Claude Haiku 5.5”
- Claude Platform Docs, “Models overview”
- Claude Platform Docs, “Pricing”
- Cursor Docs, “Claude Haiku 5.5”
- The Decoder, “Claude Haiku 5.5 arrives with massive price cuts”
- VentureBeat, “Anthropic launches Claude Haiku 5.5 with 90% API price reduction, matching GPT-6 Luna”
- Artificial Analysis, ficha de Claude Haiku 5.5
- Hacker News, hilo del lanzamiento de Claude Haiku 5.5
- Hacker News, hilo de Sonnet 5.5 en Artificial Analysis
- Hacker News, comentarios sobre Haiku 5.5 en el hilo de Opus 5.5
- Hacker News, comentarios sobre modelos pequeños en el hilo de Sonnet 5.5
- Reddit r/ClaudeAI, “Introducing Claude Haiku 5.5”
- Reddit r/SillyTavernAI, “Looks like Claude Haiku 5.5 is out”
🧨 Última oprtunidad para recibir la dinamita que mereces sobre programación con IA el próximo domingo: Suscríbete gratis a Web Reactiva en https://webreactiva.com/newsletter

Escrito con la ayuda de la IA generativa de Claude, fuentes fidedignas y con un human in the loop:
Dani Primo.
12 recursos para developers cada domingo en tu bandeja de entrada
Además de una skill práctica bien explicada, trucos para mejorar tu futuro profesional y una pizquita de humor útil para el resto de la semana. Gratis.