Cómo implantar la IA en un equipo de desarrollo sin caos
Tabla de contenidos
Comprar licencias es la parte fácil.
Lo difícil llega un mes después. Cada persona del equipo usa el agente a su manera, con sus prompts guardados en local y sus trucos en la cabeza. Uno lo exprime, otra lo ha dejado de abrir y el tercero manda PR enormes que nadie se atreve a revisar. La IA ha entrado en el equipo, pero el equipo no ha cambiado su forma de trabajar.
Llevo un tiempo dando formaciones en directo a equipos de desarrollo que quieren programar con agentes. Equipos distintos, con repos distintos y problemas que se parecen muchísimo. Este artículo es el método que ha salido de ahí, contado sin nombres ni detalles de nadie, y contrastado con lo que están publicando otros equipos y referentes del sector.
Está escrito para quien tiene que decidir: CTO, engineering manager, tech lead con presupuesto. Si eres dev y te toca convencer a alguien, también te sirve para reenviarlo. Vas a encontrar:
- Los problemas que aparecen siempre cuando un equipo empieza con agentes, y qué hay detrás de cada uno.
- Qué tiene que ser común para todo el equipo y qué puede elegir cada dev.
- El método «Resuelve, rompe, repite», fase a fase, con lo que deja escrito en el repo cada una.
- Cómo se verifica el código de un agente sin convertir la revisión en un atasco.
- Un piloto de cuatro semanas y las métricas que sirven (y las que engañan).
¿Por qué no basta con dar acceso a los agentes? 
Porque la implantación de IA empieza como un problema de herramientas y enseguida se convierte en un problema de coordinación. Dar acceso a un agente mejora a la persona que lo usa bien. No mejora al equipo.
El patrón se repite en casi todos los sitios: los developers producen código más deprisa, pero las funcionalidades no llegan antes a producción en la misma proporción. El cuello de botella se muda de escribir código a integrarlo, revisarlo y confiar en él. Es lo que concluyó el segundo retiro de Thoughtworks y Martin Fowler, que repasamos en verificar el código de la IA es el nuevo cuello de botella: generar ya no es el problema, confiar sí.
Los datos van en la misma dirección. Faros AI analizó la telemetría de más de 10.000 developers: en los equipos con más adopción de IA se fusionaban un 98 % más de PR, pero esas PR eran un 154 % más grandes y el tiempo de revisión crecía un 91 %. Las métricas de entrega de la organización no mejoraban. Es un estudio de un proveedor y muestra correlación, no causa, pero cuadra con lo que vemos en las formaciones.
El informe DORA de 2025 lo resume en una idea: la IA es un amplificador. Hace más grandes las virtudes y los defectos que la organización ya tenía. Y en Microsoft, cuando contaron cómo reorganizaron su desarrollo, llegaron a la misma conclusión: las ganancias individuales no se convertían en productividad del equipo, y el problema no eran las herramientas, sino el proceso que las rodeaba.
Así que la pregunta útil no es «¿qué herramienta compramos?». Esa la tienes resuelta en la comparativa de Copilot Business, Claude Team y Cursor Teams. La pregunta es otra:
🔑 ¿Qué tenemos que cambiar en cómo trabajamos para que la IA beneficie al equipo entero y no solo a quien mejor la usa?
Los problemas que aparecen siempre 
Da igual el tamaño del equipo o el stack. En las primeras sesiones salen los mismos síntomas. Casi ninguno se arregla con una herramienta mejor. Se arreglan dejando algo escrito en el repo.
| Lo que ve el equipo | Qué hay detrás | Qué se deja en el repo |
|---|---|---|
| Cada dev con su agente, sus prompts y sus skills en local | No hay un estándar compartido | Un AGENTS.md, skills del equipo y configuración comunes, válidos para cualquier agente |
| El agente respeta una convención con una persona y con otra no | Las reglas viven en el chat o en la memoria privada del agente | Reglas versionadas: idioma, ramas, commits, qué no se toca |
| «Nos quedamos sin el prompt» y se repite la misma conversación | El conocimiento vive en prompts sueltos | Esa conversación convertida en una skill del proyecto |
| El agente decide cosas que nadie pidió (librerías, proveedores) | El requisito tiene huecos | Una ronda de preguntas antes de construir y una spec con lo que queda fuera |
| Nadie nuevo entiende el repo heredado, y el agente tampoco | El conocimiento está en cabezas | Un onboarding generado por el agente con citas a ficheros reales |
| «Ya está», y no está | El agente avanza sin mirar atrás | Una definición de «terminado» que puede comprobar una máquina |
| Revisiones con listas interminables de hallazgos | No hay criterio de severidad | Un semáforo: rojo bloquea, naranja se comenta, amarillo es aviso |
| Mucho código que nadie ha leído | El agente escribe más rápido de lo que el equipo revisa | Registro de decisiones y un resumen de qué se hizo y por qué |
| Miedo a que el agente toque secretos | Credenciales accesibles en ficheros | Permisos, hooks y secretos inyectados en ejecución |
Fíjate en la última columna. Lo que solo queda en el chat se pierde; lo que queda en el repo, no. Sobre esa idea se monta todo lo que viene.
El penúltimo problema tiene nombre propio: deuda cognitiva. Es la distancia entre el código que existe y el código que el equipo entiende. Con agentes crece al ritmo al que escribe el agente, y no aparece en ningún dashboard hasta que algo se rompe en producción y nadie sabe por dónde empezar.
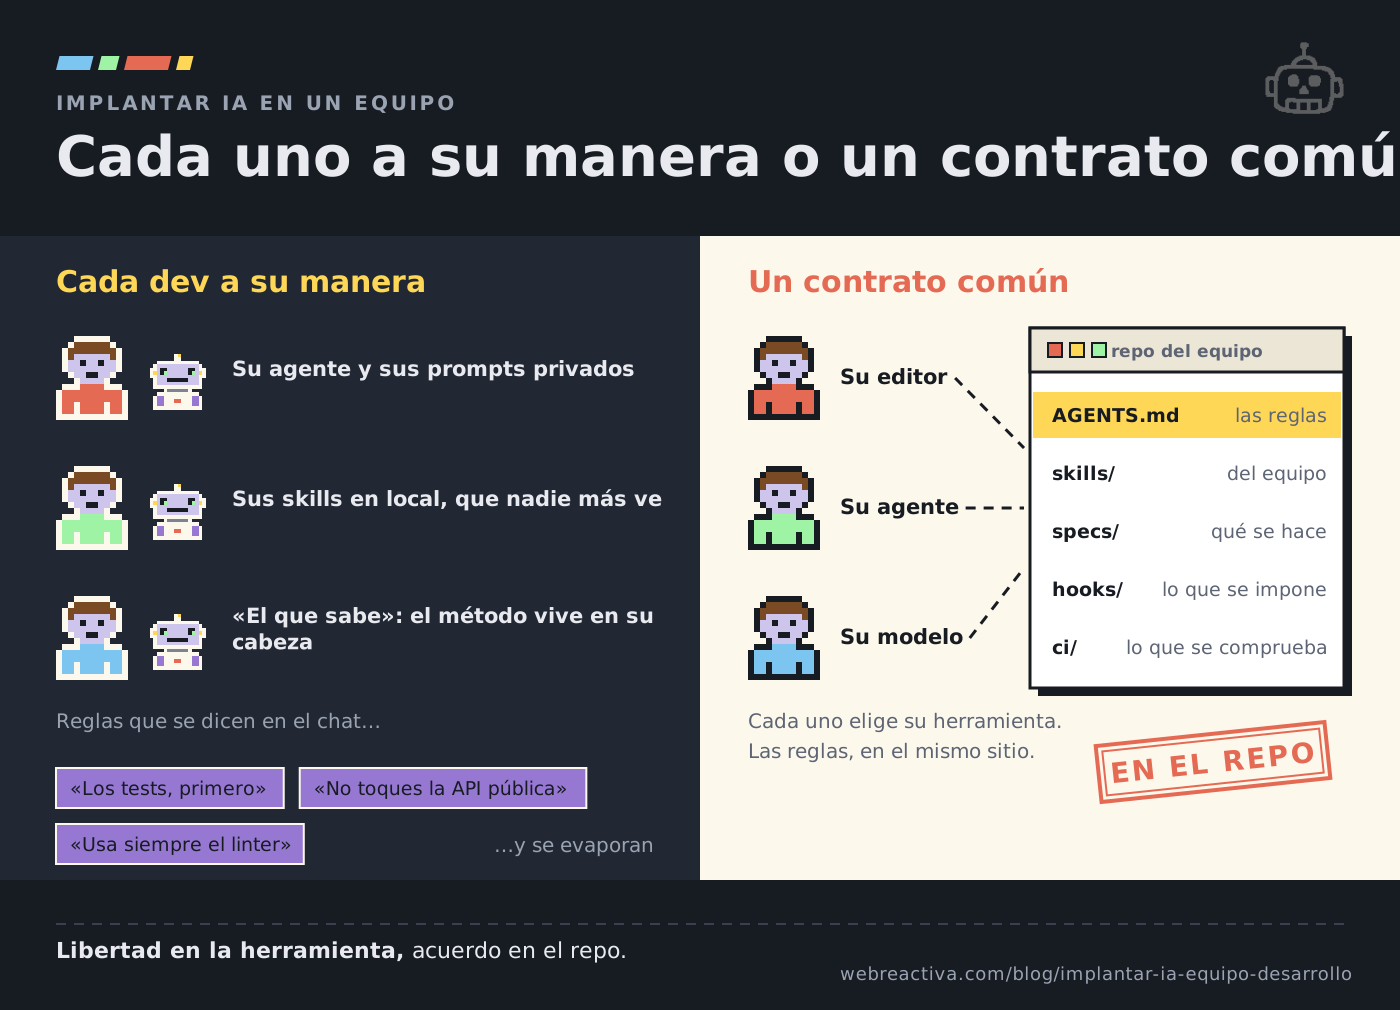
¿Qué comparte el equipo y qué elige cada dev? 
El error típico es irse a un extremo. O se impone una herramienta, un modelo y una forma de escribir prompts para todos, o se deja que cada cual haga lo que quiera. Lo primero mata la experimentación. Lo segundo mata el aprendizaje del equipo.
Lo que funciona es un contrato común de trabajo que no obligue a todos a usar lo mismo:
| Común para el equipo | Libre para cada developer |
|---|---|
| Políticas de datos y permisos | Editor o interfaz |
| Convenciones de arquitectura | Agente autorizado que prefiera |
| Comandos de validación (tests, tipos, lint) | Modelo y nivel de razonamiento |
| Criterios de aceptación | Cómo prepara sus prompts |
| Revisión y aprobación de PR | Skills experimentales |
| Registro de decisiones | Cómo organiza sus sesiones |
Para que esto aguante, el contrato tiene que ser independiente de la herramienta. Estándares abiertos y una sola fuente de reglas para todos los agentes: un AGENTS.md en el repo que cada agente importa a su manera. Si mañana cambiáis de proveedor, las reglas se quedan. Lo explicamos con detalle en AGENTS.md y las reglas de contexto.
💡 Un detalle práctico que siempre sale: si instalas una skill para un agente, no aparece en el otro. Una carpeta única de skills compartidas, enlazada desde la carpeta de cada agente, evita tener cuatro copias que divergen.
El método: resuelve, rompe, repite 
Este es el ciclo que hacemos en las formaciones con un requisito real del equipo. Tiene ocho fases, del 0 al 7, y cada una deja un artefacto versionado. Parece burocracia hasta que llega alguien nuevo, persona o agente, y no tiene que empezar de cero.
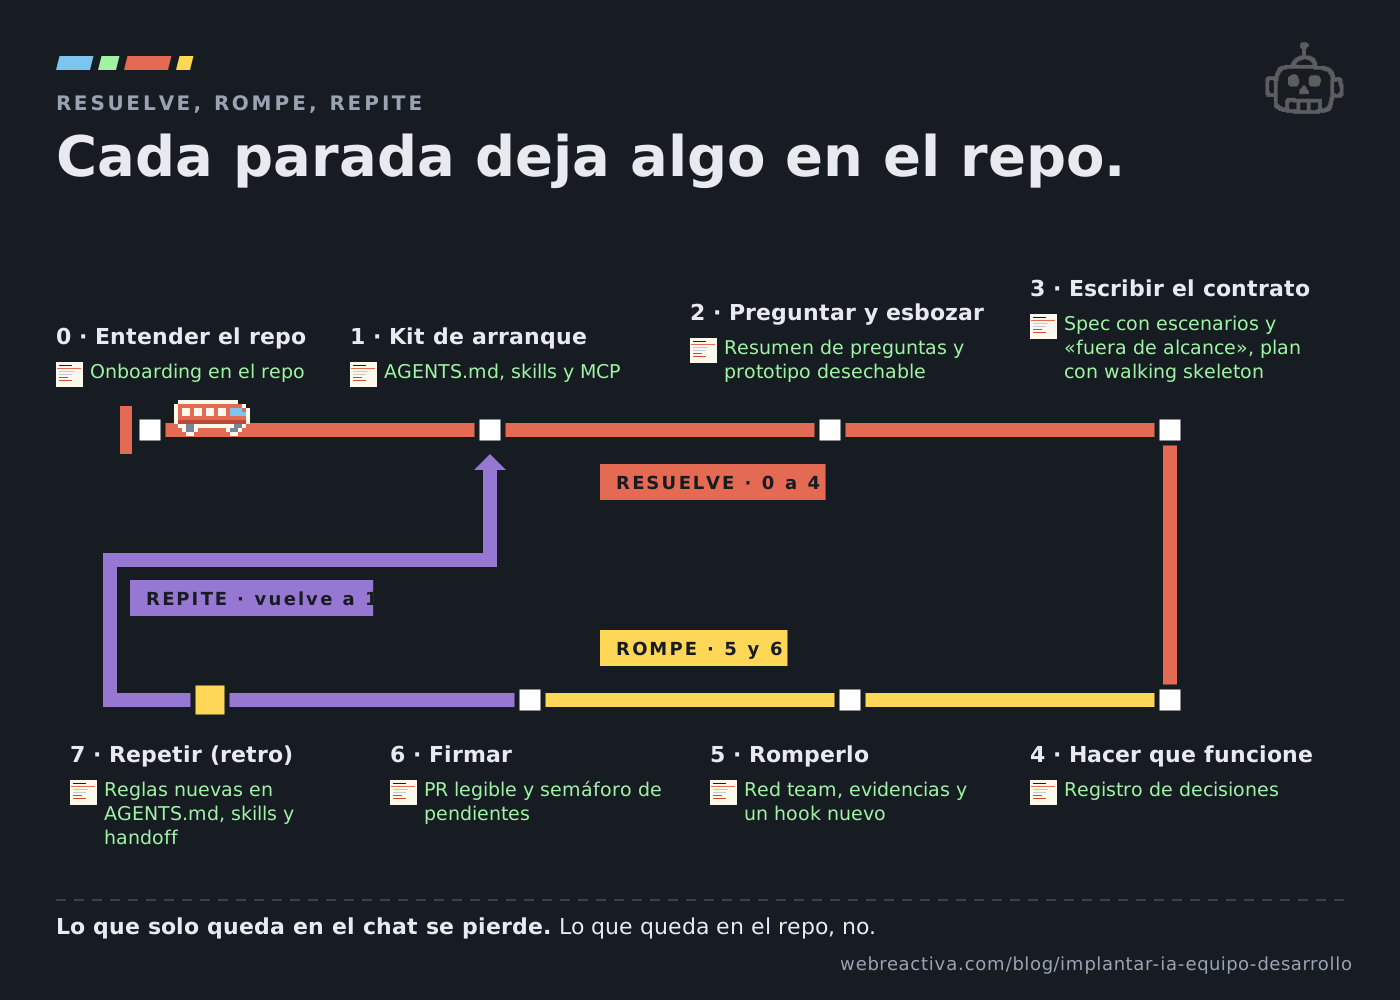
Antes de las fases, una regla que evita que esto se convierta en un ritual: la validación escala con el riesgo. Una errata se arregla y se revisa. Un fallo medio pide un test de regresión y comprobar que cumple la spec. Un cambio que cruza varias capas pide el ciclo entero.
Resuelve: de entender el repo a hacer que funcione 
0. Entender el repo antes de tocarlo. Se le pide al agente un onboarding profundo, con varios subagentes mirando arquitectura, forma de desarrollar, errores, tests y calidad. Como si fuera su primer día. Y después se le pregunta qué le falta saber, con urgencia por colores. Ahí salen las cosas que el agente no sabe que no sabe y que una persona del equipo sí.
1. Kit de arranque. El AGENTS.md con las reglas de sesión (idioma, una rama por funcionalidad, commits atómicos con convención, carpeta temporal fuera de git), las skills esenciales revisadas antes de instalarlas y los MCP que traen el mundo real: documentación oficial al día y un navegador que el agente pueda manejar.
2. Preguntar y esbozar. Antes de escribir una línea, una ronda de preguntas: una cada vez, siempre con una respuesta recomendada y con un límite. El agente suele cazar contradicciones en requisitos que parecían claros. Si el requisito no cabe en una iteración, se parte. Si no está claro el camino, prototipos desechables en paralelo.
3. Escribir el contrato. Una spec con criterios de aceptación en escenarios, actores, precondiciones y una sección de fuera de alcance. Luego un plan cuyo primer paso es un walking skeleton: el camino principal de punta a punta con lo mínimo en cada capa. Para funcionalidades con valor encaja una herramienta de Spec-Driven Development como OpenSpec. Para un bug rápido, no.
4. Hacer que funcione. El agente implementa el plan en bucle hasta completarlo. Y registra una decisión solo cuando entra una dependencia, un patrón nuevo o algo caro de revertir. Ese criterio tiene que estar escrito, porque si no el agente registra de menos.
La fase del contrato, vista entera sobre un proyecto que ya existe
En la lección 4 escribimos la proposal y la spec con OpenSpec, y en la 6 se archiva el cambio para que quede documentado en el repo. Seis vídeos, sin registro.
Entra en el curso →Rompe: lo que separa una demo de un proyecto 
5. Romperlo. Programar solo hacia delante con IA sale caro. Aquí se verifica contra la spec y se lanza un red team de subagentes en paralelo: calidad, seguridad, arquitectura, un premortem («esto falla dentro de unos meses: ¿por qué?») y un abogado del diablo. De cada fallo encontrado sale una propuesta: un único hook que lo habría evitado. Y se prueba como lo haría alguien que usa la aplicación, con navegador, casos límite y un informe con capturas.
⚠️ Pídele que pruebe «como si fueras el usuario». Si no, el agente puede dar la prueba por buena ejecutando código por detrás en lugar de usar la interfaz.
6. Firmar el trabajo. Los informes se convierten en una lista de pendientes numerada con semáforo. La persona juzga contra la spec: lo que estaba fuera de alcance no es rojo. Después, una PR legible, con un resumen sin jerga y diagramas actualizados.
Repite: la retro que hace que el equipo mejore 
7. La retro. Es la fase que más equipos se saltan, y la que convierte el trabajo de una persona en aprendizaje del equipo. Primero un mapa mental del trabajo: intención, decisiones reversibles e irreversibles, qué se asumió sin verificar y dónde mirar si falla en producción. Después la retro de correcciones: cada vez que hubo que corregir al agente se propone una regla para el AGENTS.md, un test o un comando, y se decide si una máquina podría comprobarlo. Lo que se repitió se destila en una skill. Y antes de parar, un handoff en un fichero con fecha.
Cada error se convierte en una regla y no se repite.
Implantar IA en un equipo es más coordinación que herramientas. Cada domingo, +7.200 developers compartimos qué nos funciona y qué no. Gratis, desde 2018.
Apúntate gratis →¿Cómo se escribe un AGENTS.md para todo el equipo? 
Corto, específico y comprobable. Un AGENTS.md de equipo no es un manual: es la lista de cosas que no se ven en el código y que el agente necesita para no meter la pata. Estas son las reglas que repetimos en todas las formaciones:
- En la raíz, solo lo que aplica a todas las tareas. Lo específico, en un AGENTS.md anidado dentro de su carpeta, que se carga por proximidad.
- Números, no adjetivos. «Ficheros de menos de N líneas» se puede comprobar; «código limpio», no.
- Recetas de comandos con alcance. Lo rápido sobre lo que has tocado; la suite completa, preguntando antes.
- «Copia esto, no aquello». Señala los módulos modelo y avisa del código heredado. El agente imita lo que ve, sea bueno o malo.
- Tres niveles de permiso: sin preguntar, preguntando antes y nunca. Y lo que es «nunca» se aplica también con permisos, hooks y CI.
- Capacidades, no rutas exactas. Las rutas caducan y el agente se las cree a ciegas.
- «Terminado» definido de forma mecánica, más un protocolo para cuando se bloquea: objetivo, qué falló, evidencia y siguiente paso.
- Cada regla nace de un error real. Lo que ya aplica el tooling se borra. Un AGENTS.md desactualizado es peor que no tenerlo.
Hay otra idea que cuesta aceptar: cuanto más capaz es el modelo, menos contexto necesita. No le expliques React ni Git. Explícale lo particular de tu sistema: el servicio interno que nadie documentó, la diferencia entre el entorno de desarrollo y producción, el comando propio que no conoce.
🛡️ AGENTS.md es para agentes; el README, para personas. Si mezclas los dos, ninguno sirve bien.
Lo que pueda comprobar una máquina, que lo compruebe ella 
Una regla escrita en prosa es una recomendación. El agente la seguirá casi siempre, y ese «casi» es donde se cuelan los fallos. Por eso el método se apoya en varias capas de control imperfectas en lugar de una perfecta, como el modelo del queso suizo: cada loncha tiene agujeros, pero es difícil que se alineen todos.
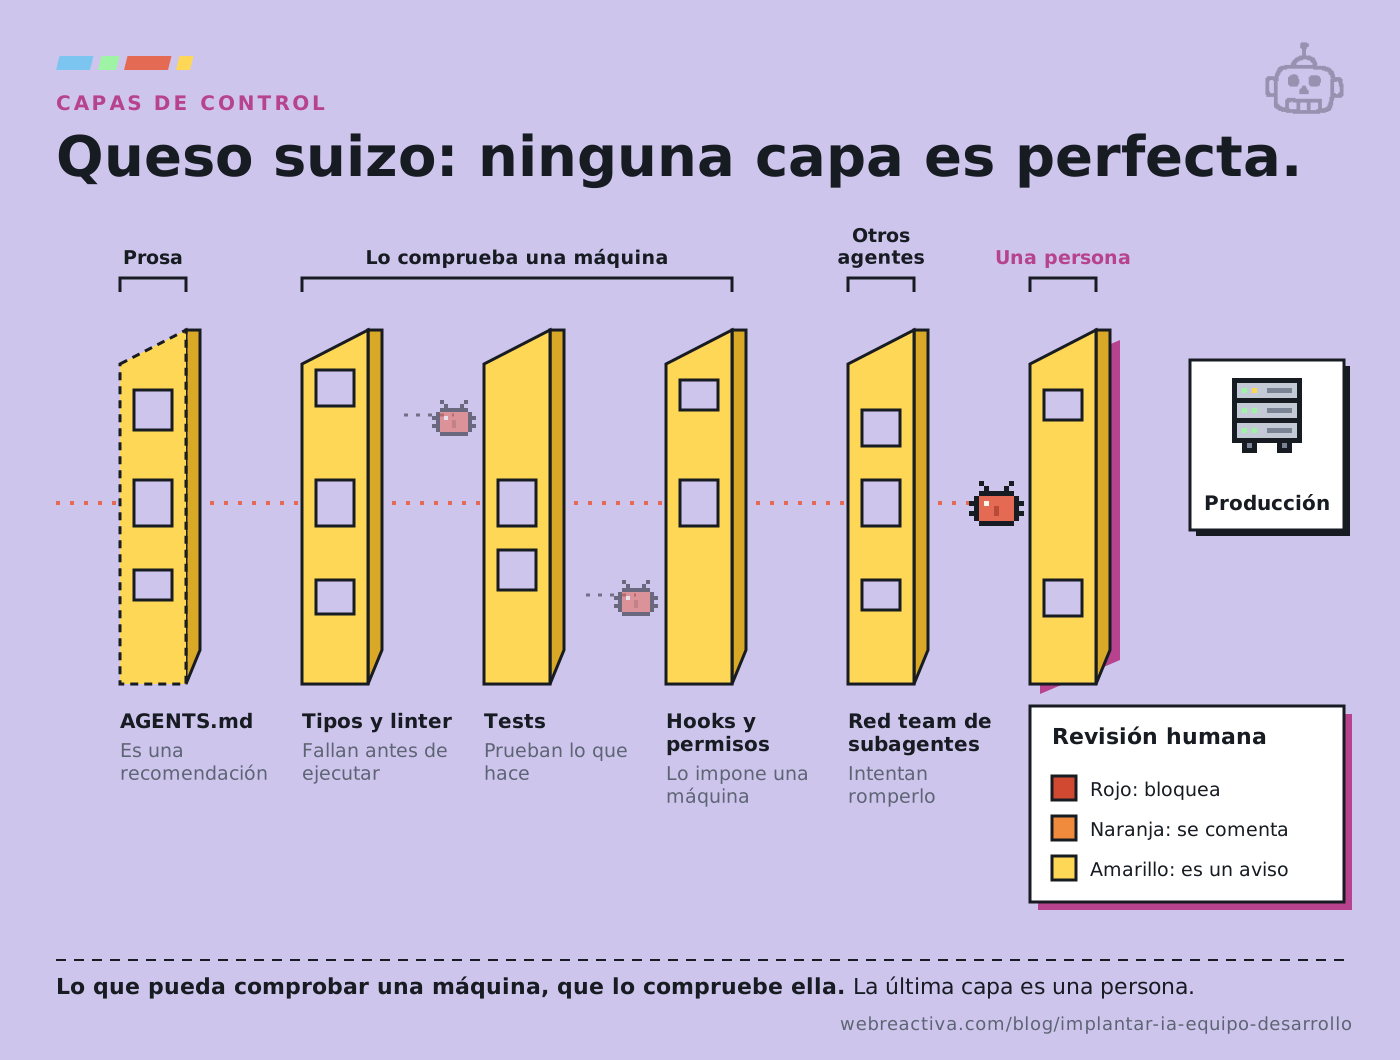
En la práctica, las capas son estas:
- El AGENTS.md: orienta, pero no obliga.
- Tipos y linter cableados en el proyecto, que el agente ejecuta solo.
- Tests, con una regla explícita: nunca se cambia un test para que pase.
- Hooks y permisos: lo crítico lo impone una máquina, no la buena voluntad. Un hook que lanza tipos y lint cuando el agente termina, otro que bloquea si quedan procesos abiertos.
- Red team de subagentes con criterios distintos.
- Una persona que decide con el semáforo en la mano.
Michael Tweed, ingeniero principal en Skyscanner, lo explicaba en una entrevista a raíz de un agente que cambió un test para que pasara: que los checks estén en verde no basta si el agente puede debilitar la evidencia. Y añadía otra idea: la autonomía del agente tiene que depender de las consecuencias. No es lo mismo una herramienta interna que un sistema de cara al cliente.
La última capa es la que no se automatiza. Una revisión de IA siempre encuentra algo; sin un criterio de severidad, el equipo acaba revisando listas en lugar de código. Si te interesa automatizar parte de esa revisión, en PR-Agent y en skills para revisión de código tienes por dónde empezar.
Formación para equipos
¿Quieres llevar este método a tu equipo?
Hablemos 20 minutos: me cuentas cómo trabajáis y te digo con sinceridad si puedo ayudaros.
¿Qué errores se repiten al implantar agentes en un equipo? 
Cada uno de estos ha salido en alguna formación, y de cada uno ha salido una regla:
- La spec acabó en la carpeta temporal y se perdió al cerrar la sesión. Regla: decir qué sobrevive a la sesión y leer lo que escribe el agente.
- Prompts de una línea en un proyecto real. Valen para una demo; en un repo con historia el agente se inventa la mitad.
- Creerse la revisión entera. La IA siempre encuentra algo. Severidad por semáforo y criterio humano.
- Corregir a mano los documentos generados. Mejor pedírselo al agente, que mantiene la coherencia entre spec, plan y código.
- Frameworks con decenas de skills que deslumbran el primer día. Acabas haciendo las tuyas; lo sencillo es más controlable. Mide antes de adoptar.
- Modelos baratos para tareas complejas. Dan más vueltas y acaban gastando más. Cada modelo para su tarea, como contamos en cómo ahorrar tokens.
- Volver a una sesión larga al día siguiente. La caché ha caducado y lo pagas entero. Compacta o haz un handoff antes de parar.
- Instalar skills de terceros sin revisarlas. Riesgo de inyección de prompts: se auditan antes, como cualquier dependencia.
🔑 Un patrón detrás de casi todos: el agente tiende a la media. Se le saca de ahí con condiciones claras, ejemplos buenos y pensamiento contrario (abogado del diablo, premortem).
¿Cómo empiezo? Un piloto de cuatro semanas 
No hace falta reorganizar el departamento. Un piloto pequeño, con voluntarios y un repositorio, te dice en un mes si vale la pena y qué hay que ajustar. Este plan es una síntesis de lo que han publicado varios equipos, cruzada con lo que vemos en las formaciones.
Semana 1. Preparar el terreno. Unos pocos voluntarios y una persona responsable. Un repo. Un puñado de tareas representativas. Se documentan los comandos de test, las normas de seguridad y las reglas de revisión, y se mide el punto de partida. Una variante que funciona bien: dedicar esta semana a revisar si las tareas del backlog están lo bastante especificadas para delegarlas.
Semana 2. Tareas reales con IA. Bugs, tests, refactorizaciones acotadas, documentación técnica. Se compara con tareas parecidas del histórico y se apuntan errores, tiempo y coste.
Semana 3. Compartir lo aprendido. Se publican las reglas comunes y las primeras skills. Una sesión para enseñar los casos que salieron bien y, sobre todo, los que salieron mal. Tests o checks que eviten repetir esos errores.
Semana 4. Evaluar y decidir. Calidad, velocidad, coste, cómo lo ha vivido el equipo y cuánto cuesta mantenerlo. Qué tareas funcionan, cuáles necesitan más intervención humana, qué permisos se pueden ampliar. Y una decisión: ampliar, ajustar o parar.
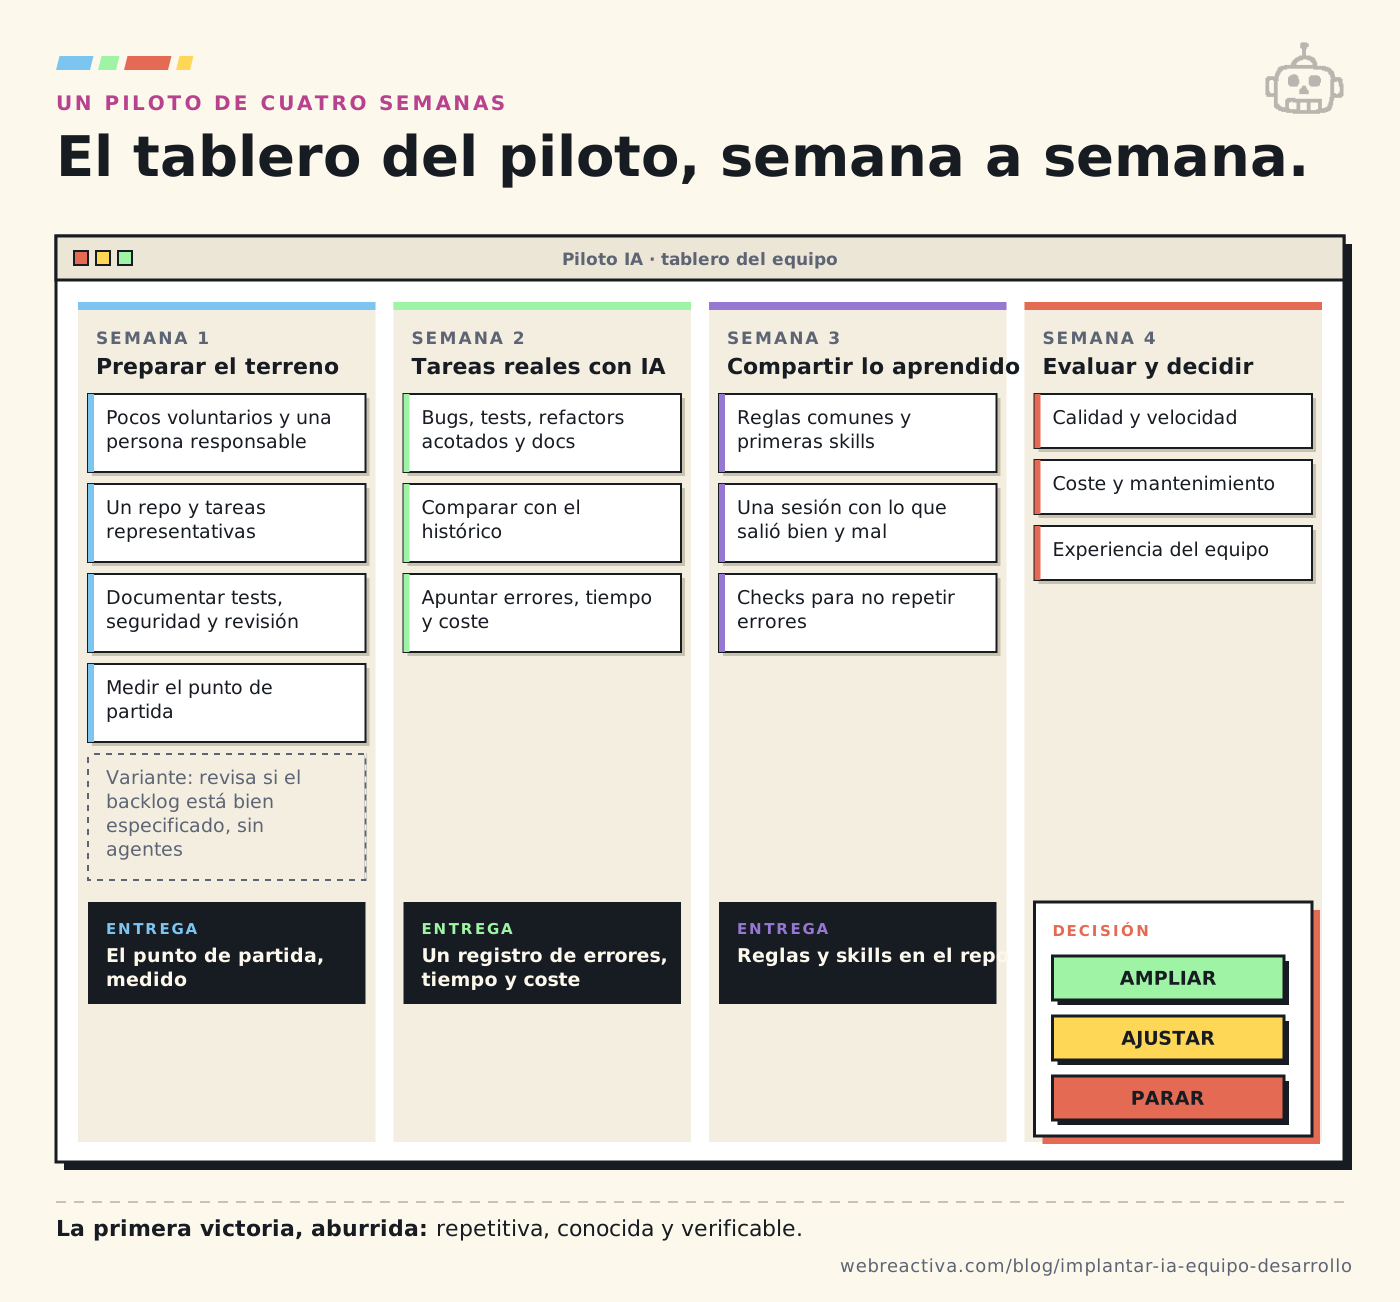
💡 La primera victoria conviene que sea aburrida: una tarea repetitiva, con entradas conocidas y un resultado que se puede verificar. Lo espectacular, para cuando haya red.
Si estás montando un piloto con tu equipo, en la newsletter de los domingos contamos qué está funcionando en otros equipos y qué no. Ya somos +7.200 developers.
Apúntate gratis →¿Cómo se mide si la IA está ayudando al equipo? 
Midiendo resultados del equipo, no cantidad de IA. Alguien puede tardar la mitad en implementar y el tiempo hasta producción quedarse igual, porque la revisión o el despliegue son ahora el atasco.
| Indicador | Qué te dice |
|---|---|
| Tiempo de ciclo | Si las funcionalidades llegan antes a producción |
| Tiempo en revisión | Si las PR se están quedando paradas |
| Defectos tras el merge | Si la calidad empeora o mejora |
| Retrabajo | Cuánto cuestan las correcciones |
| Coste por tarea aceptada | Si el ahorro compensa licencias, tokens y horas de revisión |
| Experiencia del equipo | Si la IA ayuda o frustra |
Lo que no sirve como indicador principal: líneas generadas, número de prompts o porcentaje de sugerencias aceptadas. Son métricas de vanidad. Y separa lo verificado de lo estimado: una tarea hecha más rápido no es el mismo ahorro para la empresa.
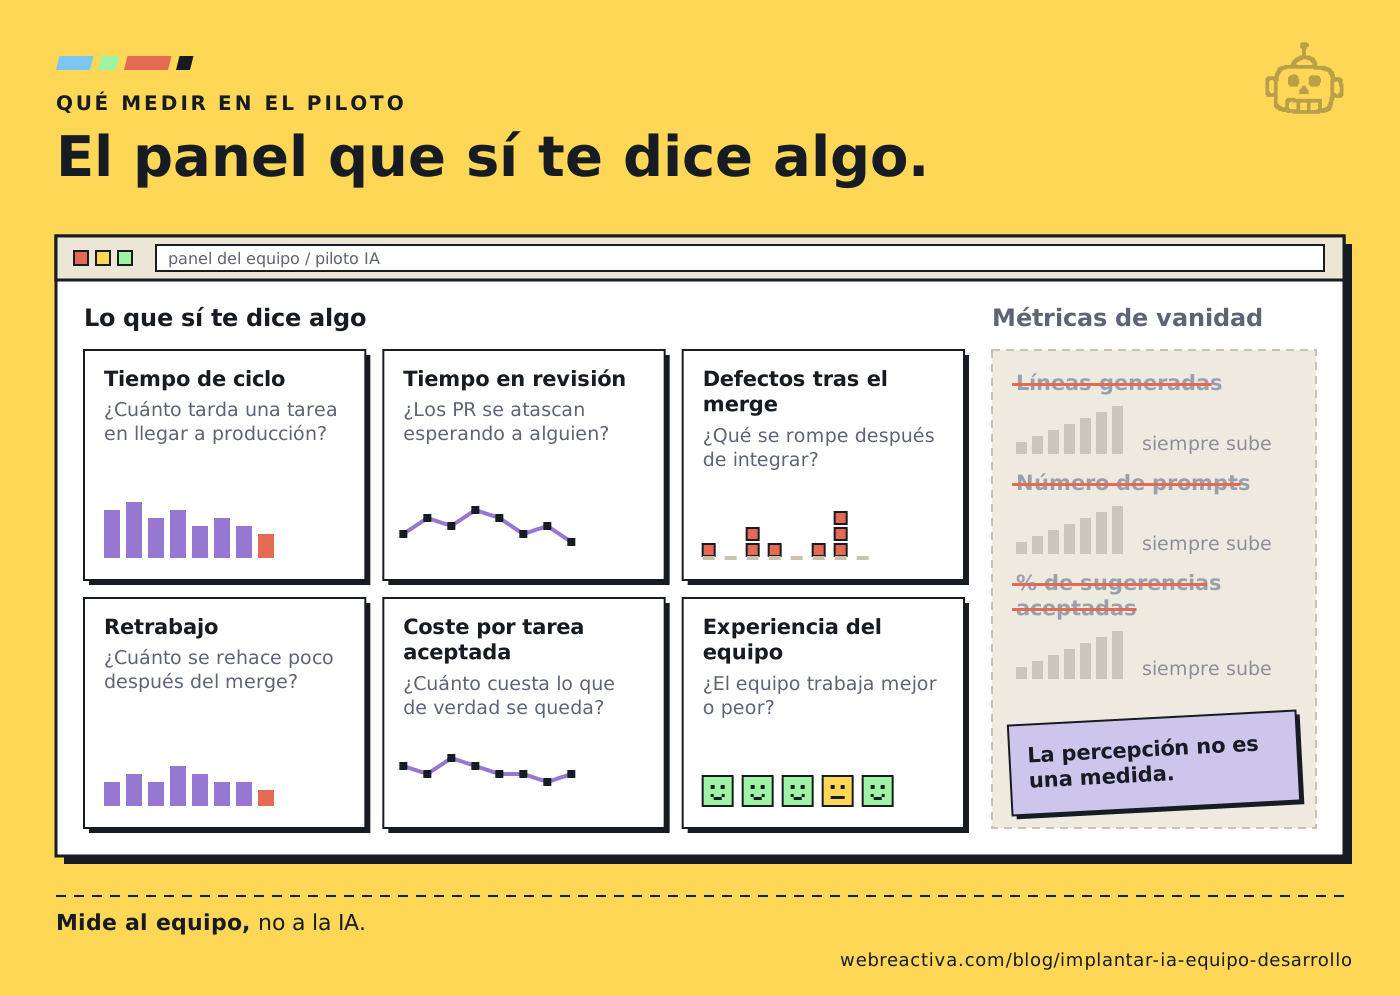
Hay un motivo más para no fiarse de las sensaciones. En el estudio de METR con developers experimentados en sus propios proyectos de código abierto, quienes usaban IA tardaron un 19 % más, y aun así creían haber ido un 20 % más rápido. El propio METR avisa de que es una foto de principios de 2025 y los modelos han cambiado mucho desde entonces. La lección sigue en pie: la percepción no es una medida.
¿Qué pasa con los juniors y con el conocimiento del equipo? 
Aquí hay dos riesgos que se tocan.
El primero es la dependencia de una persona. Si el método vive en la cabeza de «la que sabe», se va con ella. Por eso todo lo anterior insiste en dejarlo escrito en el repo: reglas, skills, specs, decisiones.
El segundo son los perfiles junior. Si el agente genera y nadie explica, el junior aprende a aceptar, no a juzgar. En el primer retiro de Thoughtworks, que contamos en el futuro de los programadores si la IA escribe todo el código, la conclusión fue que los juniors pueden ser más valiosos que nunca porque la IA les ayuda a ser productivos antes. En el segundo, que repasamos en verificar el código de la IA es el nuevo cuello de botella, apareció la otra cara: si los seniors solo emparejan con agentes, los juniors pierden el camino práctico hacia el criterio.
Las dos cosas son ciertas a la vez. Lo que marca la diferencia es el proceso: revisiones que explican, specs que se discuten en equipo y un glosario de dominio compartido. Tienes más ideas en la guía de IA para juniors.
Lo que están diciendo otros equipos 
Lo que te he contado sale de formaciones con equipos. Otros equipos están llegando a conclusiones parecidas por su cuenta, y lo cuentan en abierto.
Evgeni Rusev describe en The AI-First SDLC cómo lo implantaron en la mayoría de equipos de una consultora. Su frase resume el cambio de oficio: la ingeniería de software dejó de ir de escribir código y pasó a ir de gestionar contexto. Su preocupación es la misma que la nuestra: que cada sesión tenga que reconstruir lo que la organización ya sabe.
Birgitta Böckeler, de Thoughtworks, escribió en martinfowler.com dos ideas que encajan con el AGENTS.md de equipo. La primera: compartir reglas y contexto funciona mucho mejor dentro de un equipo que entre desconocidos de internet. La segunda: un agente rinde peor cuando recibe demasiado contexto, así que los ficheros de reglas se construyen poco a poco, no a lo bestia desde el primer día.
En GitLab contaron cómo forman equipos fluidos en IA. Ni centralizarlo todo ni dejar que cada equipo vaya por libre: acabaron en un modelo híbrido. Y su objetivo no era enseñar las herramientas de hoy, sino construir criterio y habilidades que duren cuando las herramientas cambien.
Stefan-Iulian Tesoi, en su plan para llevar agentes a un equipo, da un consejo concreto: arregla primero la capacidad de revisión, porque los agentes van a empeorarla antes de mejorarla. Su primera semana no tiene agentes: auditar tareas del backlog y especificar bien la mitad.
Leszek Wisniewski y Patrick Schaber cuentan en tres movimientos que funcionaron que la cultura no se impone por decreto: se cultiva persona a persona, hábito a hábito, con victorias pequeñas.
Sobre la revisión, un estudio de la Universidad Carnegie Mellon con más de 3.000 opiniones de developers concluye que la revisión es el punto de control donde se decide si un agente mejora o empeora el software. Y Alessandro Diaferia apunta en cómo está cambiando la revisión de PR un efecto secundario: si se revisa menos a fondo, quien revisa deja de crecer.
Y sobre aprender, el experimento de Anthropic con 52 ingenieros, la mayoría junior: quienes aprendieron una librería nueva con ayuda de IA sacaron un 50 % en el test de comprensión, frente al 67 % de quienes lo hicieron a mano. La mayor caída fue en depuración, justo la habilidad que hace falta para validar lo que escribe un agente. Quien usaba la IA para preguntar por qué aprendía; quien le delegaba todo, no.
¿En qué nivel está tu equipo? 
Una forma sencilla de situarte, sin pretensión de escala oficial:
- IA individual. Cada developer usa un asistente para sus tareas. La ganancia es local y depende de cada persona.
- IA de equipo. Reglas, skills, tests y criterios de revisión compartidos. Lo que aprende uno beneficia a todos.
- Desarrollo coordinado con agentes. Los agentes participan en planificar, implementar, probar y revisar. El equipo controla las decisiones, los riesgos y las aprobaciones.
Es habitual que un equipo esté en el 1 creyendo que está en el 2. El salto no lo da una herramienta nueva: lo da el contrato común y la costumbre de convertir cada error en una regla.
¿Esto lo decides para tu equipo? Este método es justo lo que hacemos en la formación en IA para equipos: en directo, con un requisito real de tu equipo, de la ronda de preguntas a la retro. Lo que aprendéis se queda en vuestro repo como reglas, specs y checks, y os sirve con el agente que elijáis.
TL;DR 
- 🧭 Implantar IA es un problema de coordinación, no de licencias. El atasco se muda de escribir código a revisarlo y confiar en él.
- 📁 Lo que solo queda en el chat se pierde; lo que queda en el repo, no. Cada fase del método deja un artefacto versionado.
- 🔁 Resuelve, rompe, repite. Entender, preguntar, especificar e implementar; romperlo con un red team; y una retro que convierte cada corrección en una regla.
- 🧀 Varias capas de control imperfectas (tipos, tests, hooks, red team, una persona) valen más que una perfecta.
- 📊 Mide tiempo de ciclo, revisión, defectos y coste por tarea aceptada. No líneas generadas.
Preguntas frecuentes 
¿Por dónde empiezo a implantar IA en un equipo de desarrollo?
Por un piloto de cuatro semanas con voluntarios, un solo repositorio y tareas representativas. Antes de usar agentes, documenta los comandos de test, las normas de seguridad y cómo se revisa, y mide el punto de partida para poder comparar.
¿Hay que obligar a todo el equipo a usar la misma herramienta?
No. Lo común son las reglas, los permisos, los comandos de validación y la revisión. El editor, el agente autorizado y el modelo los puede elegir cada developer, siempre que las reglas vivan en un fichero que lean todos los agentes.
¿Qué es un AGENTS.md de equipo?
Un fichero en el repo con las reglas que el agente necesita y no puede deducir del código: convenciones, comandos, permisos y qué se considera terminado. Es para agentes; el README sigue siendo para personas.
¿Cómo se evita que la revisión de código se convierta en un cuello de botella?
Con PR pequeñas, checks automáticos antes de la revisión humana y un semáforo de severidad para los hallazgos. La revisión humana se dedica a lo que la máquina no puede comprobar.
¿Hay que hacer spec-driven development en todas las tareas?
No. Encaja en funcionalidades claras y con valor. Para un bug rápido basta con un test de regresión, y si el camino no está claro es mejor un prototipo desechable que una spec equivocada.
¿Qué métricas sirven para saber si la IA ayuda al equipo?
Tiempo de ciclo, tiempo en revisión, defectos después del merge, retrabajo, coste por tarea aceptada y experiencia del equipo. Las líneas generadas o el porcentaje de sugerencias aceptadas no demuestran valor.
¿Qué es la deuda cognitiva?
La distancia entre el código que existe y el código que el equipo entiende. Crece cuando el agente escribe más rápido de lo que se revisa, y se reduce con registros de decisiones y resúmenes de qué se hizo y por qué.
¿Qué pasa con los perfiles junior en un equipo que usa agentes?
Pueden ser productivos antes, pero corren el riesgo de aprender a aceptar código en vez de a juzgarlo. Revisiones que explican, specs discutidas en equipo y mentoría compensan ese riesgo.
¿Es obligatorio formar al equipo en IA?
En la Unión Europea, el AI Act pide que quien usa sistemas de IA en la empresa tenga un nivel suficiente de alfabetización en IA. Lo contamos en formación en IA para empresas y el AI Act.
¿Cuánto tarda un equipo en notar resultados?
Un piloto de cuatro semanas basta para decidir si se amplía, se ajusta o se para. La mejora sostenida llega cuando el equipo convierte cada corrección al agente en una regla, un test o una skill compartida.
Fuentes 
- DORA — State of AI-assisted Software Development 2025: la IA como amplificador de la organización.
- Faros AI — The AI Productivity Paradox: telemetría de más de 10.000 developers sobre PR, revisión y bugs.
- Microsoft Inside Track — Engineering the Frontier Firm: de la productividad individual al proceso de equipo con specs.
- METR — Early-2025 AI and experienced open-source developers: percepción frente a medida.
- Anthropic — How AI assistance impacts the formation of coding skills: aprendizaje y comprensión con y sin IA.
- Agarwal, Miller, Kästner y Vasilescu — 3100 Opinions on Code Review in an AI World: la revisión como punto de control.
- Birgitta Böckeler — Context Engineering for Coding Agents: reglas compartidas y exceso de contexto.
- Michael Tweed en The Next Commit: adopción en Skyscanner, evidencias y autonomía según el riesgo.
- Evgeni Rusev — The AI-First SDLC: contexto antes que código.
- GitLab — How GitLab fosters AI-fluent teams: gobierno híbrido y formación en criterio.
- Stefan-Iulian Tesoi — Rolling out coding agents to a team: plan de cuatro semanas.
- Patrick Schaber y Leszek Wisniewski — Three AI rollout moves that worked: primeras victorias y cultura.
- Alessandro Diaferia — How AI code review is changing pull requests: efectos sobre las PR y quien revisa.
- Thoughtworks — The Future of Software Engineering, junio de 2026: conclusiones del retiro de Engelberg.
🧨 Última oportunidad para recibir la dinamita que mereces sobre programación con IA el próximo domingo: Suscríbete gratis a Web Reactiva en https://webreactiva.com/newsletter
Escrito con la ayuda de la IA generativa de Claude, fuentes fidedignas y con un human in the loop:
Dani Primo.
¿Tu equipo ya usa IA y le falta el método?
Hablemos 20 minutos: me cuentas cómo trabajáis y te digo con sinceridad si puedo ayudaros.
Reserva la charla