Tests E2E con IA: cómo usar e2e de TesterArmy
Tabla de contenidos
Los tests end-to-end tienen fama de ser los más caros de mantener. Cambias el texto de un botón, mueves un formulario a un modal o tu diseñadora decide que el checkout ahora va en dos pasos, y media suite se pone en rojo. El producto funciona. Lo que se ha roto es el guion de selectores que escribiste hace tres meses.
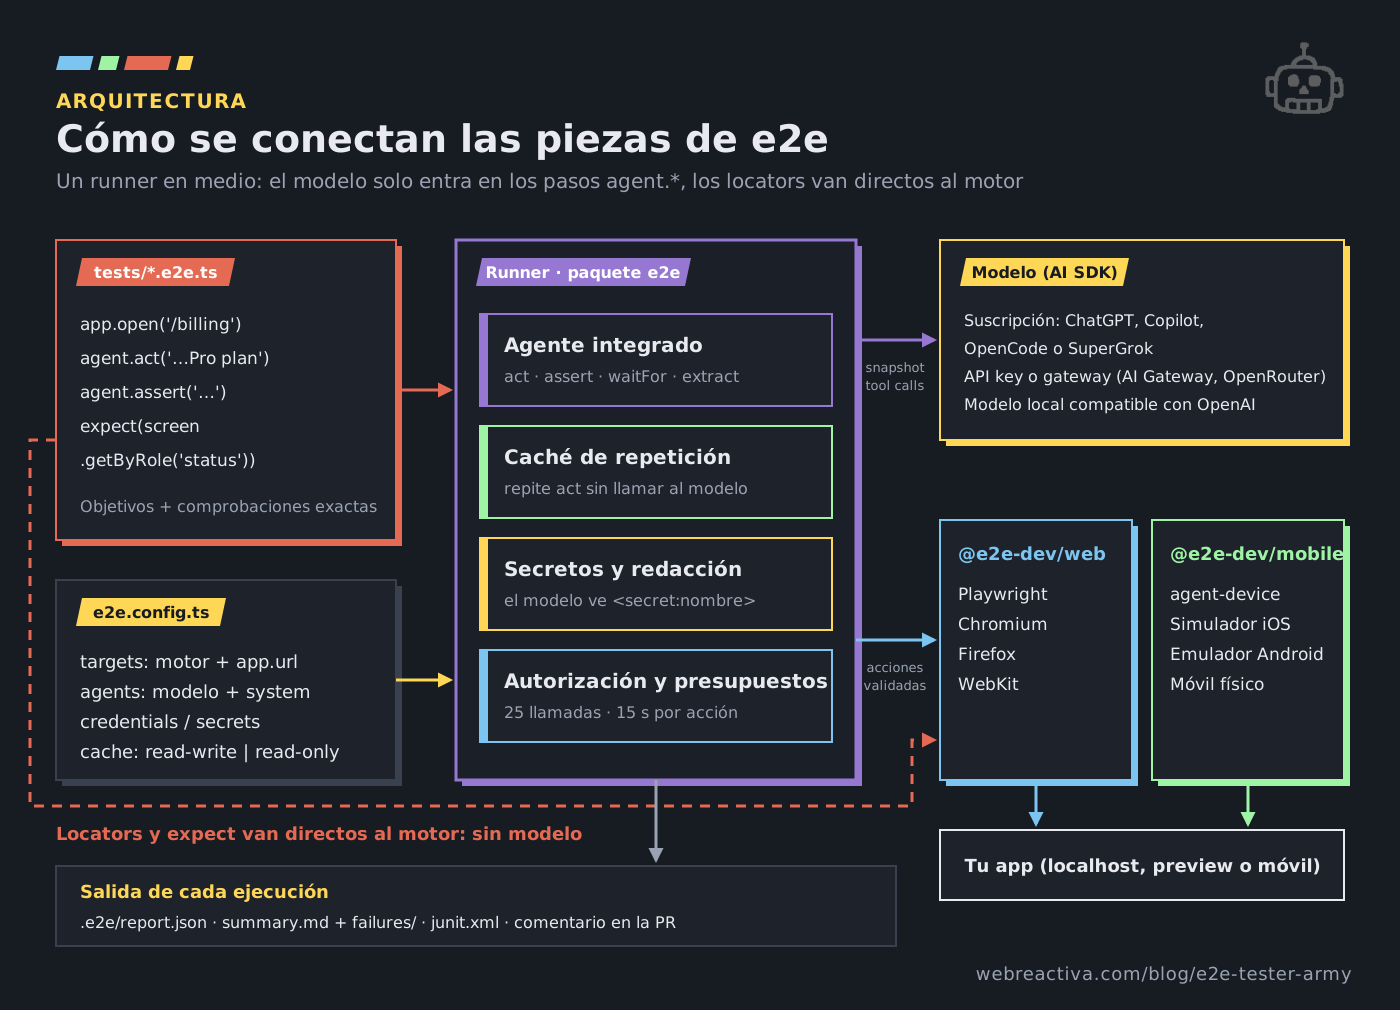
e2e es un framework de testing open source, creado por TesterArmy, que ataca justo ese dolor. En lugar de escribir cada clic, describes un objetivo en lenguaje natural y un agente de IA maneja la aplicación hasta conseguirlo. Y en el mismo test sigues teniendo locators y expect de los de toda la vida para comprobar valores exactos.
Tú eliges cuánta IA lleva cada test: puede ser 100% determinista, 100% agéntico o una mezcla.
En este tutorial vas a encontrar:
- Qué es e2e y en qué se diferencia de Playwright, Cypress y compañía
- Cómo instalarlo paso a paso, a mano o pidiéndoselo a tu agente de programación
- Cómo escribir tests con
agent.act,agent.assert, locators y sesiones de login - Cómo funciona la caché de repetición que evita pagar tokens en cada ejecución
- Cómo depurar fallos, llevarlo a CI y explorar tu app sin escribir tests
⚠️ e2e está en desarrollo activo camino de la 1.0. Este tutorial se basa en la versión 0.17.0 del paquete
e2ey en la documentación oficial del repositorio. Sus propios autores avisan de que la API y la configuración todavía pueden cambiar entre versiones menores.
Qué es e2e y qué problema resuelve 
e2e es un SDK, un runner y una CLI para escribir tests end-to-end en TypeScript sobre aplicaciones web y móviles. Su idea central cabe en una frase de su documentación: “escribe un objetivo en lugar de un guion de selectores y esperas”.
Este es el ejemplo que abre su README:
// tests/checkout.e2e.ts
import { test, expect } from 'e2e';

test('a member upgrades to Pro', async ({ app, agent, screen }) => {
  await app.open('/settings/billing');

  // El agente decide qué botones pulsar para conseguir el objetivo
  await agent.act('upgrade the workspace to the Pro plan');

  // Un modelo juzga la pantalla con una afirmación en lenguaje natural
  await agent.assert('the invoice preview shows a prorated amount');

  // Comprobación exacta, sin modelo de por medio
  await expect(screen.getByRole('status')).toContainText('Pro');
});
Fíjate en las tres capas. app.open navega de forma explícita. agent.act delega en el agente todo el baile de clics, campos y modales. Y el expect final es determinista: no hay IA que interprete nada, o el texto contiene “Pro” o el test falla.
Con esa mezcla usas el agente donde el flujo cambia a menudo y no te importa el cómo, y usas locators donde sabes con precisión qué quieres comprobar.
Los paquetes del ecosistema 
El proyecto es un monorepo con varios paquetes publicados en npm. Conviene tenerlos claros antes de instalar nada:
| Paquete | Para qué sirve |
|---|---|
e2e |
El SDK, el runner y la CLI. Es el núcleo |
@e2e-dev/web |
Motor de navegador: Chromium, Firefox y WebKit a través de Playwright |
@e2e-dev/mobile |
Motor para simuladores iOS y emuladores Android vía agent-device |
@e2e-dev/github |
Reporter que publica los resultados como comentario en la pull request |
@e2e-dev/kernel |
Navegadores alojados en Kernel para el motor web |
@e2e-dev/eas |
Simuladores y emuladores alojados en EAS para el motor móvil |
@e2e-dev/decision |
Ejecutores con modelos de decisión para acciones y aserciones acotadas |
Por debajo, el motor web usa Playwright con su propia versión fijada de playwright-core (la 1.63.0 en @e2e-dev/web 0.12.0). Eso significa que si ya tienes @playwright/test en tu proyecto, no hay conflicto: los dos runners conviven.
La licencia es Apache-2.0.
Requisitos antes de empezar 
e2e es exigente con la versión de Node.js. La CLI necesita Node.js 24.8 o superior, o 22.22.3 o superior si sigues en la rama 22. En Windows te piden ejecutarlo dentro de WSL.
⚠️ La landing de tester.army todavía menciona “Node.js 22.12 or newer”, pero la documentación del repositorio y la referencia de la CLI piden 24.8 (o 22.22.3). Hazle caso a la documentación: es la que se actualiza con cada versión.
Sobre gestores de paquetes no hay drama: funciona con npm, pnpm, Yarn (con o sin Plug’n’Play) y Bun. Eso sí, la CLI siempre se ejecuta sobre Node.js; bunx e2e instala con Bun pero lanza el proceso con Node.
Para tests móviles necesitas además Xcode con un runtime de simulador iOS, o el Android SDK con un emulador.
Y para los pasos con agente necesitas un modelo. Ahí tienes cuatro caminos:
- Una suscripción que ya pagas: ChatGPT Plus o Pro, GitHub Copilot, OpenCode Console o SuperGrok
- Una API key de cualquier proveedor compatible con el AI SDK de Vercel que soporte tool calls
- Un gateway como Vercel AI Gateway u OpenRouter
- Un modelo local servido con una API compatible con OpenAI (Ollama, por ejemplo)
Las suscripciones de Claude no están soportadas. Si quieres usar Claude, tiene que ser vía API o a través de un modelo disponible en tu plan de Copilot.
💡 Los tests sin pasos de agente no necesitan modelo. Puedes empezar con e2e como un runner determinista y añadir IA cuando te convenza.
Antes de delegar los tests, ten un flujo con tu agente que puedas repetir
e2e se instala con una skill y una petición a tu agente de programación. En este curso montas ese flujo solo con prompts sobre un proyecto real, y en la lección 3 escribes el AGENTS.md que le dice al agente cómo trabajar.
Entra en el curso →Instalación paso a paso 
Hay tres formas de ponerlo en marcha, y las dos primeras pasan por tu agente de programación. No es casualidad: e2e se distribuye también como una Agent Skill, un paquete de instrucciones que tu agente lee antes de escribir o ejecutar un test.
Opción 1: instala la skill y deja que tu agente haga el resto 
Es la vía más corta si ya trabajas con Claude Code, Codex, Cursor, OpenCode o cualquier agente que lea skills. Desde la raíz de tu proyecto:
npx skills add tester-army/e2e
Este comando usa la CLI de skills, la misma con la que se instalan las skills del ecosistema (si no la conoces, aquí tienes las skills más útiles para Claude Code y cómo instalarlas). Descarga la skill e2e desde el repositorio de GitHub y la deja en .agents/skills/e2e/, con un enlace simbólico en .claude/skills/e2e/ para Claude Code. Una sola copia sirve para todos los agentes.
Lo que se instala es una carpeta con un SKILL.md y ocho referencias temáticas. El agente carga primero el SKILL.md y solo abre la referencia que necesita para la tarea:
| Tema | El agente lo lee cuando… |
|---|---|
setup |
Añade e2e al proyecto, escribe e2e.config.ts o configura un target móvil |
writing-tests |
Escribe o arregla tests: fixtures, locators, matchers, sesiones de login |
agent |
Añade pasos agent.*, elige modelo o ajusta presupuestos y caché |
running |
Necesita flags de la CLI, reporters, el informe JSON o códigos de salida |
explore |
Explora la app hacia un objetivo sin fichero de test |
debugging |
Una ejecución ha fallado y toca leer el código de error |
mcp |
Maneja la app en vivo desde el servidor MCP para encontrar locators |
bug-bash |
Le pides que busque bugs en varias áreas a la vez |
Esto es divulgación progresiva: el agente no se traga toda la documentación de golpe, solo la parte que toca. Si quieres entender por qué funciona mejor que pegar un prompt gigante, en Web Reactiva tienes qué son las Agent Skills y en qué se diferencian de los prompts y de MCP.
El SKILL.md no es una lista de comandos: le impone al agente un flujo de trabajo en cinco pasos.
- Mirar lo que existe: el
e2e.config.ts, el patrón de tests y sie2eestá enpackage.json. Si no hay nada, sigue el temasetup - Conocer las pantallas antes de escribir: rutas, etiquetas, roles y textos de botones, leyendo los componentes o abriendo la app con el servidor MCP
- Escribir
tests/<feature>.e2e.tscon unagent.actpor objetivo y unexpectoagent.assertjusto detrás - Ejecutar un solo fichero con
npx e2e run tests/<feature>.e2e.ts - Leer el fallo en el reporter y en
.e2e/report.json, y arreglar el locator, la expectativa o la app. Nunca añadir un sleep
Además le marca reglas que le evitan los errores típicos: secretos solo a través de credentials y secrets, nunca en el código del test; juzgar el significado y no la frase exacta que produjo un modelo; tratar .e2e/ como salida que se lee y no se edita.
Con la skill instalada, ya puedes hablarle a tu agente en lenguaje natural:
Configura e2e en este proyecto para la app de Next.js que arranca con pnpm dev.
Añade un test para el flujo de checkout y ejecútalo hasta que pase.
¿Por qué ha fallado tests/billing.e2e.ts en la última ejecución?
💡 La skill también va dentro del paquete npm. Con e2e ya instalado,
npx e2e guideimprime elSKILL.mdynpx e2e guide <tema>imprime una referencia concreta. Y la documentación completa viaja ennode_modules/e2e/docs, así que el agente puede consultarla sin conexión.
Si tu agente no carga skills por su cuenta, la documentación sugiere añadir esta línea a tu AGENTS.md (más sobre ese fichero en cómo escribir reglas de contexto en AGENTS.md que funcionen):
End-to-end tests use e2e; read .agents/skills/e2e/SKILL.md before writing or running one.
Una última cosa: cuando actualices e2e, vuelve a ejecutar npx e2e init (o npx skills add) para refrescar la skill. Si no, tu agente seguirá trabajando con las instrucciones de la versión anterior.
Opción 2: el prompt de configuración de la documentación 
Si prefieres darle a tu agente un guion cerrado, la documentación oficial trae un prompt de arranque. Este es, traducido:
Configura tests end-to-end con e2e en este proyecto. Docs: https://e2e.tester.army/docs/quickstart.md

1. Ejecuta `npx e2e init --yes` (o el equivalente de pnpm o bun para este proyecto).
   Escribe una config web con Vercel AI Gateway, un test de ejemplo, la skill de e2e
   y la configuración MCP. Todavía no instala nada.
2. Lee la skill de e2e (`npx e2e guide` la imprime, `npx e2e guide <tema>` imprime
   un tema) y síguela en todos los pasos siguientes.
3. Apunta el target a esta app. Para una app web, pon su URL y el comando que
   arranca el servidor de desarrollo.
4. Pregúntame qué modelo usar para los pasos con agente: suscripción, API key
   o modelo local. Si requiere login, dame el comando `npx e2e login` y espera.
5. Instala dependencias, ejecuta el test de ejemplo y corrige errores hasta que pase.
6. Escribe un test para el flujo de usuario más importante, ejecútalo e itera
   hasta que pase.
Fíjate en el paso 2: el prompt también acaba en la skill. e2e init la instala junto con la config MCP, y a partir de ahí el agente sigue el mismo flujo de trabajo que en la opción 1.
Opción 3: instalación manual 
Desde el directorio de tu app:
# npm
npx e2e init

# pnpm
pnpm dlx e2e init

# bun
bunx e2e init
El asistente te pregunta tres cosas:
- Motor: Web (Playwright) o Mobile (iOS/Android)
- Proveedor de modelo: una suscripción, un proveedor con API key o None para tests sin IA
- Si quieres configurar tu agente de programación
Con eso escribe un e2e.config.ts, un test de ejemplo, añade las dependencias y deja intactos los ficheros que ya existieran. Si usas --yes, elige motor web y Vercel AI Gateway por defecto, instala la skill y la config MCP y se salta la instalación de dependencias.
La configuración generada para web tiene esta pinta:
// e2e.config.ts
import type { E2EConfig } from 'e2e';
import { web } from '@e2e-dev/web';
import { gateway } from 'ai';

export default {
  // El modelo que usará cada paso agent.*
  agents: { default: { model: gateway('openai/gpt-6-luna-fast') } },
  // Cada target es un motor + la app que va a probar
  targets: [{ engine: web(), app: { url: 'http://localhost:3000' } }],
} satisfies E2EConfig;
Y el test de ejemplo, que todavía no usa IA:
// tests/example.e2e.ts
import { test } from '@e2e-dev/web';
import { expect } from 'e2e';

test('app opens', async ({ app, browser }) => {
  await app.open('/');
  await expect(browser.locator('body')).toBeVisible();
});
Arranca tu servidor de desarrollo en http://localhost:3000 y lanza:
npx e2e run
e2e descarga un navegador, comprueba que la app abre y escribe un informe en .e2e/report.json. Sin llamadas al modelo, así que no necesitas login ni API key para este primer paso.
Por convención, el runner busca tests en tests/**/*.e2e.ts.
Conectar el modelo 
Si elegiste una suscripción, inicia sesión con el comando que toque:
| Suscripción | Comando |
|---|---|
| ChatGPT Plus o Pro | npx e2e login openai |
| GitHub Copilot | npx e2e login github-copilot |
| OpenCode Console (Zen y Go) | npx e2e login opencode-console |
| SuperGrok o X Premium+ | npx e2e login spacexai |
Copilot reutiliza tu login de la GitHub CLI si lo encuentra. Las llamadas del agente consumen los límites de uso de tu plan.
Si prefieres API key, exporta la variable de tu proveedor en la terminal donde ejecutes e2e:
# Vercel AI Gateway
export AI_GATEWAY_API_KEY="tu-api-key"

# OpenRouter usa su propia variable
export OPENROUTER_API_KEY="tu-api-key"
Un detalle que conviene saber: e2e no carga ficheros .env. No hay modelo por defecto ni una variable compartida; la config elige el modelo y cada proveedor lee su clave del entorno.
Los pasos con el agente integrado necesitan el paquete ai instalado, uses el proveedor que uses:
npm install -D ai
Para un modelo local, instala @ai-sdk/openai-compatible y apunta al endpoint:
import { createOpenAICompatible } from '@ai-sdk/openai-compatible';

const local = createOpenAICompatible({
  name: 'local',
  baseURL: 'http://127.0.0.1:11434/v1',
});

// Úsalo como agents.default en tu config
const agent = { model: local.chatModel('your-model-id') };
El modelo que elijas para el agente integrado tiene que soportar tool calls e imágenes.
Que e2e arranque tu app 
En el ejemplo anterior arrancabas tú el servidor a mano. En cuanto montas CI eso se vuelve un engorro, así que e2e puede encargarse: le das el comando y él lo lanza, espera a que la URL responda y lo para al terminar.
// e2e.config.ts
import type { E2EConfig } from 'e2e';
import { web } from '@e2e-dev/web';
import { gateway } from 'ai';

export default {
  agents: {
    default: {
      model: gateway('openai/gpt-6-luna-fast'),
      // Instrucciones de sistema para todos los pasos del agente
      system: 'You are a thorough QA agent. Verify every outcome.',
    },
  },
  targets: [{
    engine: web(),
    app: {
      url: process.env.APP_URL ?? 'http://localhost:3000',
      command: {
        executable: 'npm',
        args: ['run', 'dev'],
        reuseExisting: true,        // reutiliza un servidor ya levantado en local
        log: '.e2e/logs/app.log',   // guarda stdout y stderr de tu app
      },
    },
  }],
} satisfies E2EConfig;
Algunos detalles que te ahorran sustos:
- El comando se ejecuta sin shell.
executablese resuelve en elPATHyargsse pasan tal cual - El proceso hijo solo hereda
PATH,HOMEy las variables de directorio temporal. Lo demás se lo pasas conenv - El tiempo de espera por defecto (
startupTimeout) es de 60 segundos - En CI se ignora
reuseExistingy se informa conAPP_ALREADY_RUNNING
Si trabajas con varias ramas a la vez, puedes usar el puerto 0. El runner elige uno libre y lo sustituye en {port}:
app: {
  url: 'http://127.0.0.1:0',
  command: {
    executable: 'pnpm',
    args: ['dev', '--port', '{port}'],
    env: { PORT: '{port}' },
  },
},
⚠️ Si tu app es Next.js 16 y el target abre
127.0.0.1, añadeallowedDevOrigins: ['127.0.0.1']ennext.config.ts. Si no, la página se renderiza pero nunca hidrata: los clics llegan, pero ningún handler de React se ejecuta y el test falla en todos los reintentos.
Para probar en varios navegadores, declaras varios targets sobre la misma app. Cada test se ejecuta una vez por target:
const app = { url: 'http://localhost:3000' };

export default {
  targets: [
    { name: 'chromium', engine: web(), app },
    {
      name: 'webkit-mobile',
      engine: web({ browser: 'webkit', viewport: { width: 390, height: 844 } }),
      app,
    },
  ],
} satisfies E2EConfig;
Si estás probando cómo meter agentes en tu flujo de trabajo, testing incluido, cada domingo compartimos lo que vamos aprendiendo con +7.200 developers. Gratis, desde 2018.
Quiero esa dinamita 🧨Escribir tests con objetivos: agent.act 
agent.act recibe un objetivo. El agente elige y ejecuta las acciones, y devuelve el control cuando lo ha conseguido o lanza un error si no.
import { test } from '@e2e-dev/web';
import { expect } from 'e2e';

test('a visitor signs up for a trial', async ({ app, agent, screen }) => {
  await app.open('/');

  // Los params rellenan los huecos {name} y {email} del objetivo
  await agent.act('sign up for a free trial as {name} with email {email}', {
    params: { name: 'Ada Lovelace', email: 'ada@example.test' },
  });

  await agent.assert('the welcome screen greets Ada by name');
  await expect(screen.getByRole('status')).toContainText('trial');
});
La documentación da un consejo que te conviene aplicar desde el primer test: escribe las instrucciones como las dirías en voz alta. Nombra lo que se ve en pantalla, usa los textos exactos de la interfaz y pon un solo objetivo por llamada. El flujo dentro de un objetivo es cosa del modelo; el orden de los objetivos es cosa tuya.
Tres reglas más que conviene grabarse:
- Pasa los datos por
params, no los metas en la frase. Así el agente usa tus datos de prueba y la caché puede funcionar (ahora verás por qué) - Haz
awaitde cada llamada al agente y ascreen. Un test que termina con una llamada pendiente falla conSTEP_NOT_AWAITED - Si un objetivo falla, hazlo más específico. Mira el informe y usa las etiquetas que aparecen en pantalla
Para valores que cambian en cada ejecución, como un email con timestamp, envuélvelos en unique():
import { expect, unique } from 'e2e';

const email = `ada+${Date.now()}@example.test`;

// unique() permite que la caché repita el paso con el valor nuevo
await agent.act('sign up with email {email}', { params: { email: unique(email) } });
await expect(screen.getByText(email)).toBeVisible();
agent.act también puede pedir capturas de pantalla cuando el árbol de accesibilidad no le basta, e incluso tocar en coordenadas de la imagen. Útil para cosas como un teclado numérico dibujado en un canvas:
await agent.act('enter the code 3141 on the drawn keypad and press OK');
Lo que ve y lo que puede hacer el modelo 
Es normal desconfiar de soltar un modelo dentro de tu app, así que vale la pena saber qué recibe.
Para act, el modelo ve la instrucción, los params, los pasos ya completados y una instantánea de texto redactada de la pantalla: roles, nombres, textos y estados de los elementos. No ve HTML crudo, cookies, cabeceras ni variables de entorno. Los campos de contraseña van enmascarados y cualquier secreto configurado que aparezca en pantalla se sustituye por <secret:nombre>.
Las herramientas que recibe dependen del motor: tap, type, press, select, scroll, navigate… El runner autoriza cada acción, la cuenta contra un presupuesto y le pone un tope de 15 segundos por acción.
Y hay frenos de mano. Si detecta llamadas repetidas o ciclos, interviene. Tras tres acciones fallidas seguidas le pide al modelo que cambie de enfoque; tras cinco, le exige un veredicto.
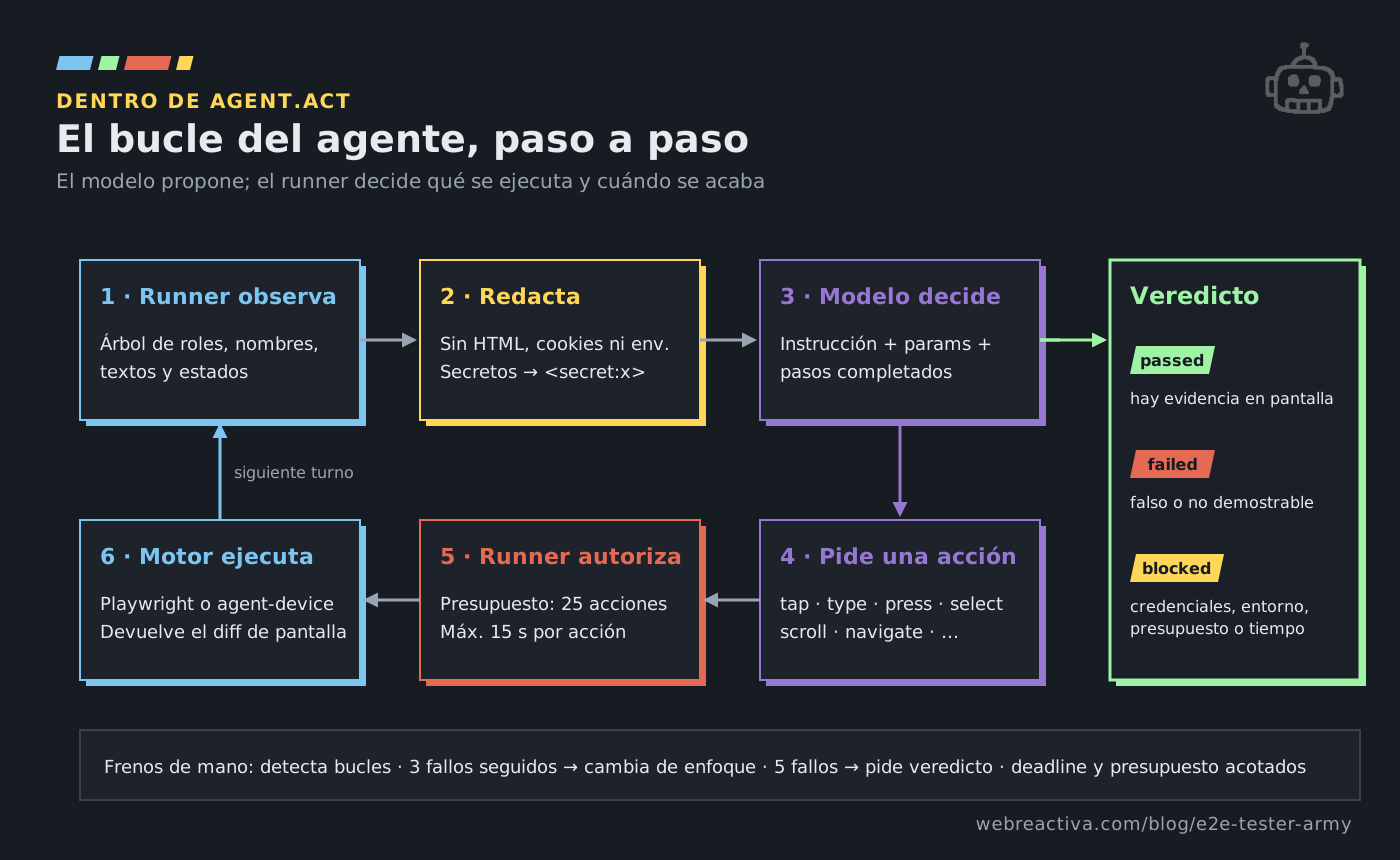
Ese veredicto puede ser de tres tipos:
| Veredicto | Significado |
|---|---|
passed |
La pantalla aporta evidencia de que el paso se cumplió |
failed |
La condición es falsa o no se puede establecer |
blocked |
Algo ajeno al producto impidió decidir: credenciales, entorno caído, datos de prueba ausentes, presupuesto agotado |
Separar failed de blocked te ahorra tiempo en CI. Un blocked por credenciales sale con código 2 y un entorno caído con código 3. Así sabes si tienes un bug o un problema de infraestructura sin abrir el log.
Presupuestos por defecto 
Cada llamada tiene un límite de llamadas al modelo y de tiempo:
| Método | Llamadas al modelo | Acciones | Timeout por defecto |
|---|---|---|---|
act |
25 | 25 | 120 s |
waitFor |
25 | 0 | 30 s |
extract |
2 | 0 | 30 s |
assert |
2 | 0 | 30 s |
Si se agota el presupuesto obtienes STEP_BUDGET_EXHAUSTED; si se acaba el tiempo, STEP_TIMEOUT. Todo se puede ajustar por agente en la config.
Comprobar la pantalla: assert, waitFor y extract 
El agente tiene tres llamadas para juzgar lo que hay en pantalla. Ninguna ejecuta acciones.
agent.assert comprueba una afirmación contra la pantalla actual. Si es falsa, falla con ASSERTION_FAILED. Si la pantalla no da evidencia suficiente, falla con ASSERTION_INCONCLUSIVE. Que distinga esos dos casos evita que un “no lo veo claro” acabe en un falso verde.
await agent.assert('the dashboard shows a trial badge');
agent.waitFor espera a que algo se cumpla. Hace polling de la pantalla y solo llama al modelo cuando la observación cambia, así que una espera larga con la pantalla quieta no te cuesta tokens:
await agent.waitFor('the export finishes and a download link appears', {
  interval: 500,
  timeout: 120_000,
});
agent.extract lee datos estructurados con un validador Standard Schema, como Zod:
import { expect } from 'e2e';
import { z } from 'zod';

const data = await agent.extract('every todo title and how many remain', {
  schema: z.object({
    titles: z.array(z.string()),
    remaining: z.number().int(),
  }),
});

// Y luego compruebas con expect normal
expect(data.titles).toContain('Buy milk');
Por defecto, estos juicios leen la instantánea de texto. Para comprobaciones visuales (una gráfica, un banner que tapa un formulario) añade vision:
await agent.assert('the chart trends upward', { vision: true });
await agent.assert('the search form is not covered by a banner', { vision: 'only' });
Un dato importante: el modelo que juzga no ve los pasos anteriores ni los resúmenes del agente que actuó. Solo la instrucción y la pantalla actual. Así evitas que el mismo modelo que hizo algo se autoconvenza de que lo hizo bien. Si quieres ir más allá, puedes configurar un modelo juez distinto al que actúa.
🔑 Usa
agent.assertpara comprobar significado (“el resumen menciona el descuento”) yexpectcuando el valor exacto importa (“el total es 42,00 €”). Lo segundo es más barato, más rápido y no tiene margen de interpretación.
Locators y expect: la parte determinista 
Todo lo que conoces de Playwright está aquí, sobre el fixture screen. Los pasos con locators no llaman a ningún modelo:
import { test, expect } from 'e2e';

test('adds a todo', async ({ app, screen }) => {
  await app.open('/todos');
  await screen.getByLabel('New todo').fill('Buy milk');
  await screen.getByRole('button', 'Add').tap();
  await expect(screen.getByTestId('todo')).toHaveCount(1);
});
Algunas diferencias con Playwright que te vas a encontrar:
getByRoleacepta el nombre como segundo argumento posicional:getByRole('button', 'Save')- Las coincidencias de texto son exactas y sensibles a mayúsculas por defecto. Para el comportamiento de subcadena de Playwright, pasa
{ exact: false } - Se usa
tap()además declick(), porque el mismo test puede ejecutarse en un móvil - Para cookies, rutas, diálogos, frames o descargas tienes el fixture
browser
Los locators sirven también para algo menos obvio: un expect después de un agent.act es lo que permite a la caché guardar ese paso. Lo vemos en la siguiente sección.
Si vienes de Playwright, la documentación incluye una guía de migración con una tabla que mapea cada opción (baseURL pasa a app.url, webServer a app.command, projects a targets…) y te dice qué falta todavía. Por ejemplo, no hay reporter HTML ni fullyParallel. Este sería el mismo test de checkout en ambos mundos:
// Playwright
test('checkout', async ({ page }) => {
  await page.goto('/cart');
  await page.getByRole('button', { name: 'Checkout' }).click();
  await page.getByLabel('Card number').fill('4242424242424242');
  await page.getByLabel('Expiry').fill('12/30');
  await page.getByLabel('CVC').fill('123');
  await page.getByRole('button', { name: 'Pay' }).click();
  await expect(page.getByRole('heading')).toHaveText('Order confirmed');
});

// e2e
test('checkout', async ({ app, agent, screen }) => {
  await app.open('/cart');
  await agent.act('pay with the test card 4242 4242 4242 4242, expiry 12/30, CVC 123');
  await expect(screen.getByRole('heading')).toHaveText('Order confirmed');
});
La navegación y la comprobación final siguen siendo explícitas. Lo de en medio, que es lo que se rompe cuando cambia el formulario, se lo queda el agente.
La caché de repetición: tests con IA sin pagar tokens en cada ejecución 
Sin esta caché, una suite con agente que se ejecuta decenas de veces al día pagaría el modelo en cada pasada.
Cuando un agent.act pasa y una comprobación posterior verifica el resultado, el runner graba las acciones que hizo el agente. En la siguiente ejecución las repite sin llamar al modelo. Si un control ya no aparece o el estado final no coincide, el agente toma el relevo desde la pantalla actual.
El resumen de cada ejecución te lo cuenta:
           AI  4.1k tokens · 2 model calls · anthropic/claude-sonnet-4.5
        Cache  4 replayed · 1 handed off · 1 missed
| Resultado | Qué pasó |
|---|---|
replayed |
La grabación se completó sin llamar al modelo |
handed off |
Empezó la repetición y luego el agente tomó el control |
missed |
El agente ejecutó el paso desde el principio |
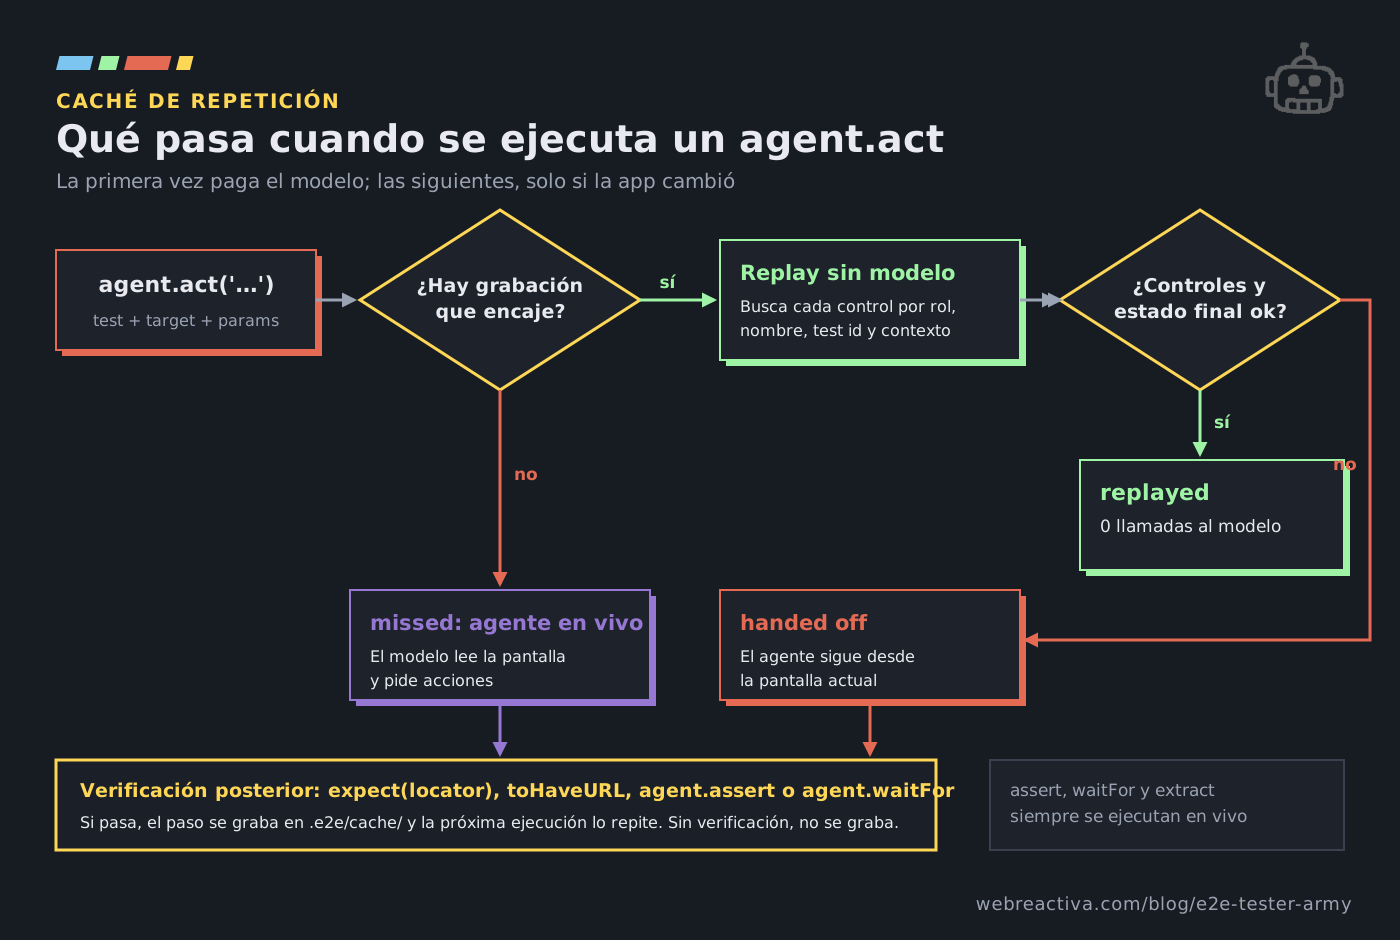
agent.assert, agent.waitFor y agent.extract siempre se ejecutan en vivo. Solo act se cachea.
Qué cuenta como verificación 
No vale cualquier cosa. Para que un paso se grabe, después tiene que haber una comprobación que mire la app:
| Cuenta como verificación | No cuenta |
|---|---|
expect(locator).toHaveText(...) y otros matchers de locator |
expect(value).toBe(...) sobre un valor plano |
expect(browser).toHaveURL(...) |
expect.poll(...) |
locator.waitFor(), browser.waitForURL() |
locator.textContent() y otras lecturas |
agent.assert(...), agent.waitFor(...) |
agent.extract(...), otro act |
De ahí sale el patrón que la documentación repite por todas partes: cada act seguido de un expect.
test('adds an item', async ({ app, agent, screen }) => {
  await app.open('/cart');
  await agent.act('add one item to the cart');
  // Este expect verifica el paso y lo hace cacheable
  await expect(screen.getByRole('status')).toHaveText('1 item');
});
Qué invalida una grabación 
Una entrada de caché pertenece a un test, un target, una instrucción, unos params y un agente concretos. Si cambias cualquiera de esas cosas, o el context del agente, o subes la versión menor del motor, hay un fallo de caché. Cambiar de modelo no la invalida.
El runner tampoco repite a ciegas. Antes de dar un paso por bueno comprueba la ruta, busca cada control por rol, nombre, test id y contexto, y verifica que aparecieron o desaparecieron los elementos que cambiaron en la grabación original. Si el resultado ya estaba en pantalla antes de repetir las acciones, no lo acepta como prueba.
Modos de caché 
| Modo | Repite | Graba | Por defecto |
|---|---|---|---|
read-write |
sí | sí | en local |
read-only |
sí | no | en CI si no configuras nada |
off |
no | no | con --no-cache |
e2e init añade .e2e/cache/ al .gitignore, así que cada máquina graba la suya. Si quieres que CI arranque con las grabaciones hechas, quita esa línea y versiona el directorio. Las entradas son JSON sin prompts, conversaciones ni capturas, aunque sí guardan los valores tecleados que no sean secretos, así que revísalas en la PR.
Para que una grabación caducada no pase desapercibida (el agente la arregla en silencio y pagas tokens en cada ejecución de CI), usa --strict-cache. El paso falla con REPLAY_STALE sin llamar al modelo y te obliga a regrabar:
CI=1 npx e2e run --strict-cache
Para inspeccionar la caché:
npx e2e cache ls      # una fila por entrada
npx e2e cache stats   # número de entradas y tamaño
npx e2e cache clear   # borra todo
Tu IA puede mentirte
Que el agente diga que ha terminado no significa que esté bien
La caché de e2e solo graba lo que una comprobación verifica. En esta masterclass verás cómo aplicar esa misma idea a todo lo que programa tu agente: pruebas en navegador con Playwright, casos Gherkin y revisión cruzada entre modelos.
Entrar a la masterclass →Métodos en directo + casos Gherkin
Login, sesiones y secretos 
Hacer login en cada test es lento y, si lo hace un agente, caro. e2e resuelve esto con tests de setup que guardan una sesión con nombre:
// tests/auth.setup.e2e.ts
import { test } from '@e2e-dev/web';
import { expect, credentials } from 'e2e';

test.setup('authenticate as admin', { sessions: ['admin'] }, async ({ app, screen, session, browser }) => {
  const admin = credentials.user('admin');

  await app.open('/login');
  await screen.getByLabel('Username').fill(admin.username);
  await screen.getByLabel('Password').fill(admin.password);
  await screen.getByRole('button', 'Sign in').tap();

  // Comprueba que el login funcionó ANTES de guardar
  await expect(browser).toHaveURL('/dashboard');

  await session.save('admin');
});
// tests/dashboard.e2e.ts
test('the dashboard opens directly', { session: 'admin' }, async ({ app, browser }) => {
  await app.open('/dashboard');
  await expect(browser).toHaveURL('/dashboard');
});
El runner ejecuta el setup aunque solo lances tests/dashboard.e2e.ts. La sesión guarda cookies, local storage e IndexedDB, se cifra en disco con una clave que solo vive en memoria y se borra al terminar la ejecución.
Las credenciales se declaran en la config y leen la contraseña del entorno:
export default {
  targets: [{ engine: web(), app: { url: 'http://127.0.0.1:3000' } }],
  credentials: {
    admin: {
      username: 'admin@example.test',
      password: process.env.ADMIN_PASSWORD ?? '',
    },
  },
} satisfies E2EConfig;
Lo interesante es cómo trata la contraseña. admin.password no es un string: es un Secret opaco sin forma de leer su valor desde el test. Solo lo aceptan fill(), los params de agent.act y algunas opciones del motor. Cuando se lo pasas al agente, el modelo solo ve el nombre y el propósito del secreto; el runner comprueba que el campo elegido es compatible y lo rellena él mismo.
await agent.act('Sign in', {
  params: { username: admin.username, password: admin.password },
});
Hay una consecuencia que conviene conocer: después de rellenar un secreto, se dejan de enviar capturas al modelo durante el resto del intento. Si tu test depende de vision, haz el login en un setup.
🛡️ Si te preocupa la seguridad de dar a un agente acceso a tu app, el diseño de e2e va en la buena dirección: redacción de secretos, acciones autorizadas por el runner y presupuestos. Para el contexto general, en Web Reactiva tienes una guía sobre seguridad con agentes de IA.
Ejecutar, filtrar y depurar 
Los comandos básicos de ejecución:
npx e2e run                           # toda la suite
npx e2e run tests/signup.e2e.ts:12    # el test declarado en la línea 12
npx e2e run --grep checkout           # tests cuyo título coincide
npx e2e run --target web              # un solo target
npx e2e run --headed                  # ver el navegador
npx e2e run --no-cache                # sin repetir acciones grabadas
Para organizar la suite tienes describe, beforeEach, test.skip, test.only (rechazado en CI) y opciones por test como retries, timeout y tags. Si un flujo tiene que abarcar varios tests, marcas el grupo con { serial: true } y se ejecutan en orden, en un solo worker, y se reintentan juntos.
Cuando algo falla, el código de salida ya te orienta:
| Código | Significado |
|---|---|
| 1 | Un test ha fallado |
| 2 | Configuración, recopilación de tests o política |
| 3 | Motor, proceso de la app, proveedor del modelo o artefactos |
| 4 | Error interno del runner |
| 130 | Ejecución interrumpida |
Con --reporter list,markdown obtienes .e2e/summary.md y una página por cada test fallido en .e2e/failures/. Cada página incluye la línea del código, los pasos, los últimos turnos del modelo y el texto de la pantalla en el momento del fallo. Es el formato que mejor lee tu agente de programación cuando le dices “arregla este test”.
Si prefieres scripts, .e2e/report.json tiene todo:
jq '.run.results[] | select(.status != "passed") | {titlePath, file, status}' .e2e/report.json
Integración con agentes de programación 
e2e está pensado para que tu agente escriba, ejecute y depure los tests contigo. init deja tres cosas preparadas:
- La skill en
.agents/skills/e2e/(y un enlace en.claude/skills/e2e/para Claude Code), la misma que instalanpx skills add tester-army/e2ey que viste en la instalación - Un servidor MCP registrado en
.mcp.json(Claude Code) y.cursor/mcp.json(Cursor) - La documentación completa dentro del paquete, en
node_modules/e2e/docs, para que el agente la lea sin conexión
El servidor MCP permite al agente abrir tu app e interactuar con ella. Su herramienta locate comprueba un locator contra la app en vivo y devuelve el código del test cuando coincide exactamente con un elemento. Cada agente, subagentes incluidos, abre su propia sesión.
Si quieres registrarlo a mano en Claude Code:
claude mcp add e2e -- npx e2e mcp
Skills, MCP, agentes que escriben y depuran tests: el sector está cambiando cada semana. Cada domingo, +7.200 developers comparten en la newsletter qué herramientas les funcionan y cuáles no.
Suscríbete gratis →Explorar tu app sin escribir tests 
e2e explore es el modo “QA curioso”. Le das un objetivo y el agente planifica sus propios pasos, maneja la app y anota lo que encuentra:
npx e2e explore 'Explore the checkout flow like a first-time buyer and report anything off'
La salida en terminal muestra los hallazgos según aparecen:
 ❯  web  Exploring  Explore this bookshop like a careful first-time buyer: browse the catalog, ...
   ⚑ medium issue  Home greeting exposes an unresolved userName template (/)
   ⚑ high issue  Neuromancer shows an impossible negative stock availability (/catalog)
   ✓ 1  Catalog browsing 31.46s · 7 actions · 4 findings
   ⚑ high issue  Cart total does not update when Hyperion quantity increases (/cart)
   ⚑ trivial warning  Checkout newsletter label misspells Receive (/checkout)
   ✓ 2  Cart quantities and removal 19.47s · 4 actions · 3 findings
   ended: the agent covered the goal
Cada hallazgo trae ubicación, comportamiento esperado y observado, pasos para reproducirlo y captura cuando es posible. Los issue son defectos funcionales y hacen fallar la ejecución; los warning son cosméticos.
Por defecto hace 8 pasos de exploración (de 1 a 12) con un límite de 10 minutos (de 3 a 15). Se ajusta con --max-steps y --timeout.
Un paso más allá está el bug bash: tu agente de programación lanza varias exploraciones en paralelo, cada una sobre un área y con una “personalidad” distinta (usuario novato, casos límite, rutas de error…), y luego escribe un test de reproducción para cada hallazgo. Solo cuenta como bug lo que hace fallar ese test con ASSERTION_FAILED. Se lo pides así:
Bug bash the checkout and account settings on this branch.
💡 Explore no sustituye a una suite de regresión. Úsalo para investigar una feature nueva o para decidir qué flujos merecen convertirse en tests permanentes.
e2e en integración continua 
Un workflow de GitHub Actions mínimo, basado en el de la documentación:
name: e2e

on:
  pull_request:
  push:
    branches: [main]

jobs:
  e2e:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - uses: pnpm/action-setup@v4
      - uses: actions/setup-node@v4
        with:
          node-version: 24
          cache: pnpm
      - run: pnpm install --frozen-lockfile

      # Descarga el navegador que fija el motor, con sus librerías de sistema
      - run: pnpm exec e2e-web install chromium --with-deps

      - run: npx e2e run --reporter list,junit
        env:
          APP_URL: http://127.0.0.1:3000
          AI_GATEWAY_API_KEY: ${{ secrets.AI_GATEWAY_API_KEY }}
          E2E_USER_ADMIN_PASSWORD: ${{ secrets.E2E_USER_ADMIN_PASSWORD }}

      - uses: actions/upload-artifact@v4
        if: ${{ !cancelled() }}
        with:
          name: e2e-report
          path: |
            .e2e/report.json
            .e2e/junit.xml
La documentación oficial fija las actions por SHA de commit, que es lo recomendable en producción. Aquí uso tags para que se lea mejor.
Cuando la variable CI está activa, cambian algunos valores por defecto:
| Ajuste | Local | CI |
|---|---|---|
retries |
0 | 1 |
workers |
la mitad de tus núcleos | 1 |
cache sin configurar |
read-write |
read-only |
.only |
permitido | rechazado con ONLY_IN_CI |
Puedes reproducir el comportamiento de CI en local con CI=1 npx e2e run.
Si añades @e2e-dev/github como reporter, los resultados aparecen como un comentario en la pull request que se actualiza en cada reintento, con enlaces al código y a los artefactos.
Para previews protegidas de Vercel, el motor web acepta cabeceras como x-vercel-protection-bypass, y app.identity mantiene la misma identidad de caché aunque la URL del preview cambie en cada deploy.
Beneficios de e2e frente a un framework clásico 
Con todo lo anterior delante, estos son los beneficios que veo:
Menos mantenimiento en flujos que cambian. Un objetivo como “upgrade the workspace to the Pro plan” sobrevive a un rediseño del formulario de pago. Un guion de diez selectores, no.
Coste controlado. La caché de repetición hace que un act verificado no vuelva a llamar al modelo hasta que la app cambia. waitFor no gasta tokens mientras la pantalla está quieta. Y los presupuestos por paso evitan que un agente perdido se coma tu factura.
Libertad de modelo. Suscripción que ya pagas, API key de cualquier proveedor del AI SDK o un modelo local. No te ata a un vendor.
Determinismo cuando lo necesitas. Los expect sobre locators no pasan por ningún modelo. El agente hace el trabajo pesado y la verificación final sigue siendo exacta.
Seguridad pensada desde el principio. Secretos opacos que el modelo nunca ve, redacción en informes, acciones autorizadas por el runner.
Web y móvil con la misma API. El mismo test, con screen, app, agent y expect, se ejecuta en Chromium, en un simulador iOS o en un emulador Android.
Pensado para tu agente de programación. Skill, servidor MCP, documentación offline e informes en markdown que tu agente puede leer para arreglar un test.
Así queda frente a las alternativas más habituales:
| Aspecto | e2e | Playwright Test | Playwright con agentes (MCP o CLI) |
|---|---|---|---|
| Tests en lenguaje natural | Sí, mezclados con locators | No | El agente genera código Playwright |
| Coste por ejecución | Bajo si la caché acierta | Ninguno | Tokens al generar, no al ejecutar |
| Adaptación a cambios de UI | El agente toma el relevo | Manual | Regenerar o reparar el test |
| Madurez | Pre-1.0, API cambiante | Muy madura | Depende de la herramienta |
| Móvil nativo | iOS y Android | No | No |
| Reporter HTML | No | Sí | Sí |
Si lo que buscas es que tu agente de programación maneje el navegador mientras desarrollas, la comparativa entre Playwright CLI y Playwright MCP te encaja mejor, y si quieres que el agente pruebe en el navegador lo que acabas de cambiar, mira Expect. e2e va de otra cosa: de que los propios tests tengan un agente dentro.
Limitaciones a tener en cuenta 
Antes de migrar una suite, conviene que conozcas estas limitaciones:
- Es pre-1.0. Los autores avisan de que la API y la config pueden cambiar entre versiones menores
- Faltan piezas de Playwright: no hay reporter HTML,
fullyParallel,globalSetup, emulación de dispositivos (devices['iPhone 15']),geolocationnilocator.or() - El runner solo arranca
app.command. Bases de datos, mocks y otros servicios los tienes que levantar tú antes - Los juicios del agente cuestan dinero en cada ejecución.
assert,waitForyextractnunca se cachean - Sin suscripción de Claude. Si es tu modelo de cabecera, toca usar la API
- Telemetría activada por defecto. Envía datos anónimos de uso (comandos, motores, dónde fallan las ejecuciones), sin contenido de tests ni credenciales. Se desactiva con
npx e2e telemetry disableoE2E_TELEMETRY_DISABLED=1
Y una reflexión que no es de e2e sino de cualquier test con IA: un agente que “consigue el objetivo” no garantiza que lo consiguiera por el camino que tu usuario tomaría. Por eso el patrón de act + expect no es opcional. Si quieres profundizar en cómo encaja todo esto en una estrategia de testing más amplia, tienes cómo hacen testing con IA los equipos que lo usan de verdad.
TL;DR 
- 🚀 e2e es un framework open source (Apache-2.0) de TesterArmy para tests end-to-end en TypeScript que mezcla objetivos en lenguaje natural (
agent.act) con locators yexpectdeterministas - 🔧 Se instala con
npx skills add tester-army/e2e(para que tu agente lo configure) o connpx e2e init, necesita Node.js 24.8+ (o 22.22.3+) y funciona con suscripciones (ChatGPT, Copilot, OpenCode, SuperGrok), API keys o modelos locales - ⚡ La caché de repetición graba los
actverificados y los repite sin llamar al modelo hasta que la app cambia - 🎯 La regla de oro: un objetivo por
act, seguido siempre de unexpectque lo verifique - 📚 Incluye skill y servidor MCP para tu agente de programación,
e2e explorepara buscar bugs sin escribir tests y soporte para iOS y Android
Preguntas frecuentes 
¿Qué es e2e de TesterArmy? 
Es un framework open source de testing end-to-end para apps web y móviles escrito en TypeScript. Permite describir pasos del test como objetivos en lenguaje natural que ejecuta un agente de IA, y combinarlos con locators y aserciones deterministas en el mismo test. Lo publica TesterArmy bajo licencia Apache-2.0.
¿Cómo se instala e2e? 
Necesitas Node.js 24.8 o superior (o 22.22.3 en la rama 22). La vía más rápida es npx skills add tester-army/e2e y pedirle a tu agente que lo configure. A mano, ejecuta npx e2e init en el directorio de tu app: el asistente te pide el motor y el proveedor del modelo, y genera e2e.config.ts y un test de ejemplo. Después lanzas npx e2e run.
¿Qué hace npx skills add tester-army/e2e? 
Instala la Agent Skill de e2e en .agents/skills/e2e/ (con un enlace en .claude/skills/e2e/ para Claude Code). Es un SKILL.md con el flujo de trabajo y las reglas para escribir tests, más ocho referencias temáticas que el agente abre según la tarea. Con ella, tu agente puede configurar e2e, escribir tests y depurar fallos a partir de una petición en lenguaje natural.
¿Necesito una API key para usar e2e? 
No para todo. Los tests sin pasos de agente no necesitan modelo. Para los pasos con agente puedes usar una suscripción de ChatGPT, GitHub Copilot, OpenCode Console o SuperGrok con npx e2e login, una API key de cualquier proveedor del AI SDK o un modelo local compatible con la API de OpenAI.
¿Puedo usar Claude con e2e? 
Sí, pero no con una suscripción de Claude, que no está soportada. Tienes que configurarlo como proveedor por API (directo, Vercel AI Gateway u OpenRouter) o usar un modelo de Claude disponible en tu plan de GitHub Copilot.
¿Cuánto cuesta ejecutar tests con e2e? 
El framework es gratuito. El coste viene del modelo que uses en los pasos con agente. La caché de repetición evita llamadas al modelo en los agent.act ya verificados, y cada paso tiene un presupuesto máximo de llamadas (25 para act, 2 para assert y extract por defecto).
¿En qué se diferencia e2e de Playwright? 
e2e usa Playwright por debajo para el motor web, pero añade pasos con agente (act, assert, waitFor, extract), caché de repetición, gestión de secretos opacos y soporte para iOS y Android. A cambio, todavía le faltan funciones de Playwright como el reporter HTML o la emulación de dispositivos.
¿Puedo usar e2e y Playwright en el mismo proyecto? 
Sí. @e2e-dev/web trae su propia versión fijada de playwright-core, así que no interfiere con tu @playwright/test. e2e busca tests en tests/**/*.e2e.ts por defecto, así que basta con mantener separados los patrones de ficheros y migrar un archivo cada vez.
¿Cómo evita e2e que el modelo vea mis contraseñas? 
Las credenciales se declaran en la config y la contraseña se expone como un Secret opaco sin acceso a su valor. El modelo solo ve el nombre y propósito del secreto, y el runner rellena el campo él mismo tras autorizarlo. Los valores se redactan de prompts, informes y trazas.
¿Funciona e2e en CI? 
Sí. En CI usa 1 worker, 1 reintento y la caché en modo solo lectura por defecto. Genera informes JSON, JUnit y markdown, y el paquete @e2e-dev/github publica los resultados como comentario en la pull request.
Fuentes 
- e2e en tester.army: página oficial del proyecto
- Repositorio tester-army/e2e en GitHub: código, README y documentación en
docs/ - Documentación oficial de e2e: quickstart, goals, caché, autenticación, CI y referencia de la CLI
- Paquete e2e en npm
🧨 Última oprtunidad para recibir la dinamita que mereces sobre programación con IA el próximo domingo: Suscríbete gratis a Web Reactiva en https://webreactiva.com/newsletter

Escrito con la ayuda de la IA generativa de Claude, fuentes fidedignas y con un human in the loop:
Dani Primo.
12 recursos para developers cada domingo en tu bandeja de entrada
Además de una skill práctica bien explicada, trucos para mejorar tu futuro profesional y una pizquita de humor útil para el resto de la semana. Gratis.