All Code Is Slop: la pirámide de poteto para fiarte de tu IA
Tabla de contenidos
📺 Este artículo resume la charla «All Code Is Slop (Except Mine)» que Lauren Tan (poteto) dio en el AI Engineer Code Summit. Las capturas son diapositivas de esa charla.
Levanta la mano si alguna vez has abierto código que escribió otra persona y has pensado: «esto es slop».
Yo también.
Así arrancó poteto su charla, con el público riéndose porque todos se veían en la foto. El título lleva la trampa incorporada: todo el código es slop, menos el mío. Lo gracioso es que ella, que el mes anterior envió 3.000 pull requests a producción, no defiende que su código sea mejor. Defiende que su entorno es mejor. Y que con ese entorno el slop se convierte en oro.
Hace unas semanas ya repasamos su charla de los 2.500 PRs, con la curva de confianza, las skills de verificación y el jardinero. Esta es otra charla, más corta (17 minutos) y con números nuevos del equipo de Grok Bot en SpaceX. Aquí me quedo con lo que no estaba en aquella:
- La pirámide de poteto: en qué orden invertir para confiar en tus agentes.
- Por qué cada vez que corriges al agente debería nacer una regla de lint, no una línea más en tu
AGENTS.md. - Los 183 timers que se colaron en Cursor y los 65.824 comentarios que borraron en Grok Bot.
- La verificación formal (TLA+, Lean) y el testing basado en propiedades aplicados a una app de escritorio.
- Los números del equipo: 11.000 PRs en un mes, medio por ciento de reverts y una app que va más rápida que en su lanzamiento.
¿Quién es poteto y qué defendió en «All Code Is Slop»? 
Lauren Tan, poteto en redes, es Principal Engineer en SpaceX y trabaja en Grok Bot, la app de escritorio de agentes de xAI. Antes pasó por el core team de React y por Cursor, y es la autora de pstack, el plugin de skills que ya desmontamos en el repaso a pstack para Cursor.
Su tesis cabe en una frase: el oficio del developer ahora es mantener o mejorar la calidad del código mientras multiplicas tu productividad.
Antes de los agentes nadie se preocupaba por el volumen, salvo por los casos raros. En su anterior empresa a esas personas las llamaban coding machines. El ejemplo que pone es Bret Taylor, que según la leyenda reescribió Google Maps en un fin de semana. Con agentes, dice poteto, cualquiera puede ser una coding machine. La pregunta es si lo que sale de esa máquina se puede mantener.
Hay quien llama a esto software factory. A ella le gusta más una palabra más sencilla: confianza. No confianza ciega, sino invertir en el entorno del agente hasta poder fiarte de que hará lo correcto cuando no estás mirando.
Le costó seis meses llegar al punto de enviar miles de PRs, muchas mientras dormía. Su promesa al público es que a ti te costará bastante menos.
🔑 Lo que defiende poteto no es un modelo mejor ni más agentes en paralelo. Es un repositorio que obliga al agente a hacer lo correcto por defecto.
¿Qué es la pirámide de poteto? 
Es su forma de decidir dónde gastar tiempo en el entorno del agente. Una pirámide invertida de cinco capas, ordenadas de más barata a más cara. Arriba, lo que más volumen de problemas resuelve con menos esfuerzo. Abajo del todo, lo más caro: tú revisando a mano.
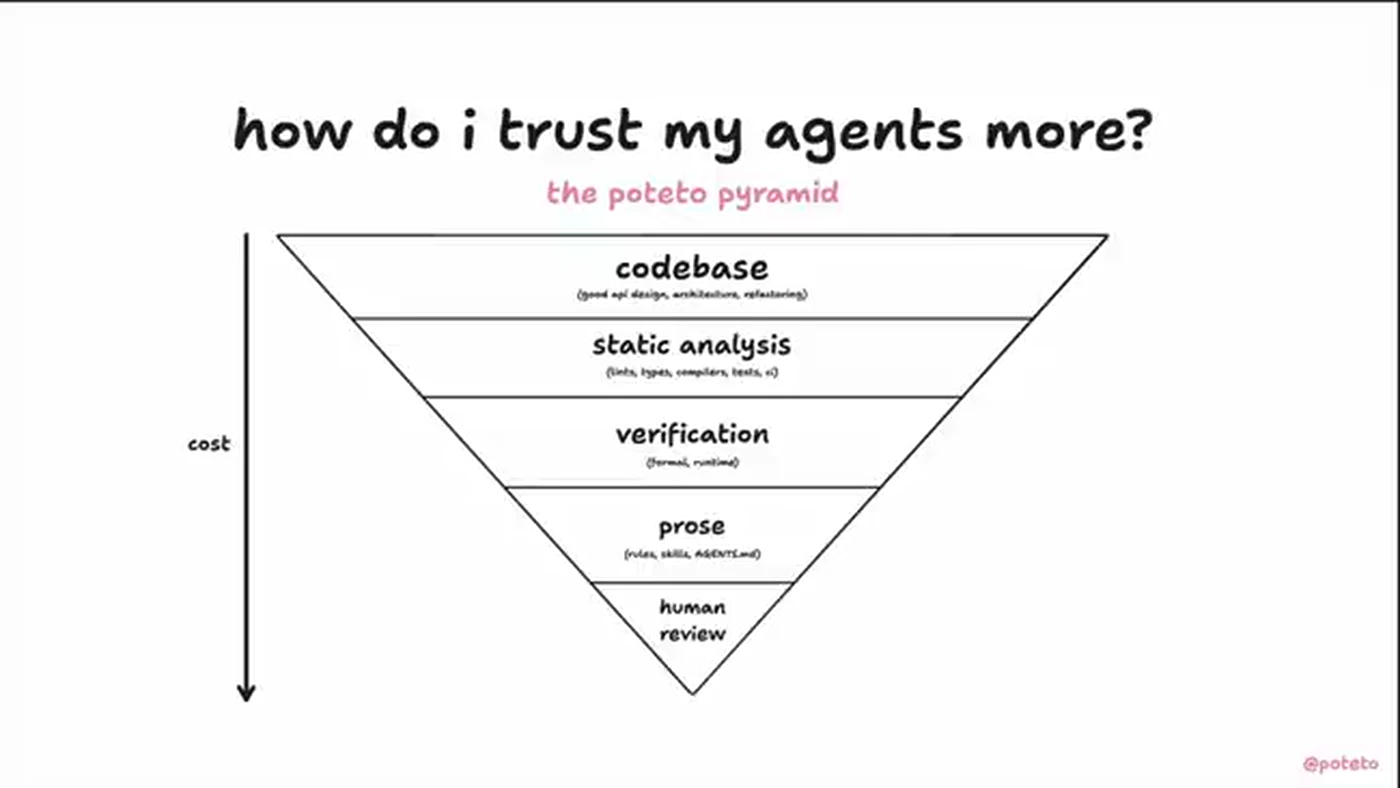
Las capas, de arriba abajo:
- Código base: buen diseño de APIs, arquitectura, refactorización.
- Análisis estático: lint, tipos, compiladores, tests, CI.
- Verificación: en tiempo de ejecución y formal.
- Prosa: rules, skills,
AGENTS.md. Todo lo que requiere criterio para aplicarse. - Revisión humana: la punta, y la más cara.
Las dos primeras capas son deterministas. Usan el propio código para restringir lo que puede hacer el agente y empujarlo a hacer lo correcto sin que se lo pidas. La verificación sirve para encontrar bugs, comprobar invariantes y, esto es lo interesante, comprobar si el agente entendió tu intención. La prosa va casi al final, como un retoque.
Es justo el orden contrario al que sigue casi todo el mundo. ¿Qué haces cuando el agente se equivoca? Abres el AGENTS.md y añades una línea en mayúsculas. Poteto te pide lo contrario: que pienses cómo convertir esa corrección en algo que se compruebe solo.
⚠️ Una regla escrita en prosa depende de que el agente la lea, la entienda y decida cumplirla. Una regla de lint que falla en CI no depende de nada de eso.
Si llevas tiempo afinando reglas, nuestra guía de AGENTS.md y reglas de contexto sigue siendo útil. Lo que cambia con la pirámide es el orden: la prosa entra cuando las capas de arriba ya no dan más de sí.
Antes de automatizar el bucle, ten un bucle que funcione a mano
En el curso montas, paso a paso y sobre un proyecto real, el flujo de trabajo con un agente que luego repites en cualquier repositorio: reglas de sesión, preguntas antes de programar y petición a petición.
Entra en el curso →¿Por qué tu código base es el input más importante del agente? 
Porque el agente genera su salida a partir de lo que lee, y lo que más lee es tu código. Un prompt son unas líneas. Tu repositorio son miles de ficheros que el agente toma como ejemplo de «así se hacen las cosas aquí».
Poteto lo explica con una imagen que me encanta: tu código base es un jardín.
En 2024 llegaba al trabajo y revisaba las tres pull requests que habían escrito sus compañeros. Hoy ese número ronda las 300. Cada developer es ahora un equipo de cientos o miles de agentes, y el código llega tan rápido que parece un flujo continuo, casi orgánico, como algo vivo.
En esa analogía, las restricciones y barreras que pones son los cimientos de hormigón sobre los que crece el código nuevo. La diapositiva que usa es un edificio cubierto de vegetación: las plantas crecen donde la estructura les deja.
¿Y las malas hierbas? Son los apaños, los antipatrones, el código deprecado y la deuda técnica. El agente que llega después los ve, piensa que son el patrón establecido de tu repositorio y los copia. Antes de que te des cuenta se han extendido por todo el jardín.
De ahí sale la conclusión: tu código base tiene que estar lo más limpio posible para que el agente copie siempre lo bueno.
💡 Cada apaño que dejas en el repositorio es una instrucción implícita para el próximo agente. Más fuerte que cualquier línea de tu
AGENTS.md.
¿Qué es Dune y por qué prohibieron useEffect? 
Dune es el framework de cliente que crearon para Grok Bot. Poteto admite que, como tecnología, no tiene mucho misterio: piensa en él como un Next.js para apps de Electron. Lo interesante son las restricciones y reglas de lint que lleva dentro, donde han codificado lo aprendido construyendo apps de escritorio.
La primera lección: lo que requiere matices para usarse bien acaba en slop.
El ejemplo clásico es useEffect en React. Tiene sus casos de uso, pero se usa mal tan a menudo que hay quien bromea con que hace falta un doctorado para usarlo. Los agentes, dice poteto, no son buenos usándolo. Su solución fue radical: prohibirlo en el código de producto. Solo se permite en algunos sitios concretos dentro de las APIs de Dune.
¿El resultado? El problema desaparece por categoría. Nunca más hay que cazarlo en una revisión de código.
La segunda lección es que la estructura de directorios también es contexto. En Cursor, que también es una app de Electron, los agentes importaban a menudo código del proceso principal dentro del proceso de render, y eso provocaba tareas largas y tirones en la interfaz. En Grok Bot y en las apps de Dune lo resolvieron así:
- Dos directorios de primer nivel con nombres que no dejan dudas:
electron-rendereryelectron-main. - Los imports entre ellos están prohibidos por su analizador del grafo de dependencias y por reglas de lint.
Son reglas sencillas de montar. Pero cada una es una cosa menos que revisar a mano.
Si trabajas con React y te reconoces en lo de useEffect, te dejo una forma de hacer lo mismo en tu proyecto con ESLint. No es la regla de Dune (no es pública), es la idea aplicada con lo que trae ESLint de serie:
export default [ { files: ["src/features/**/*.{ts,tsx}"], rules: { // Prohibido en código de producto: usa los hooks del framework "no-restricted-imports": ["error", { paths: [{ name: "react", importNames: ["useEffect"], message: "useEffect está prohibido en features/. Usa los hooks del framework. Si crees que lo necesitas, el problema está en la API, no en la regla." }] }], }, },];Fíjate en el message. Ahí está la segunda mitad del truco, la que veremos en un momento: el error le dice al agente qué hacer en su lugar.
¿Por qué los agentes escriben markdown para justificarse? 
Poteto ha visto a los agentes usar markdown (documentación, comentarios en el código, rules, skills) como un sitio donde dejar por escrito sus excusas para no hacer lo correcto.
Y también lo contrario: sobrerreaccionan a una corrección pequeña que les hiciste y la convierten en una ley que no se puede romper jamás.
El ejemplo viene otra vez de Cursor. A los agentes les encantaban los timers imperativos: setTimeout, requestAnimationFrame, requestIdleCallback. Los usaban como arreglo rápido para tapar un choque de arquitectura entre el estilo imperativo de VS Code y el estilo declarativo de React.
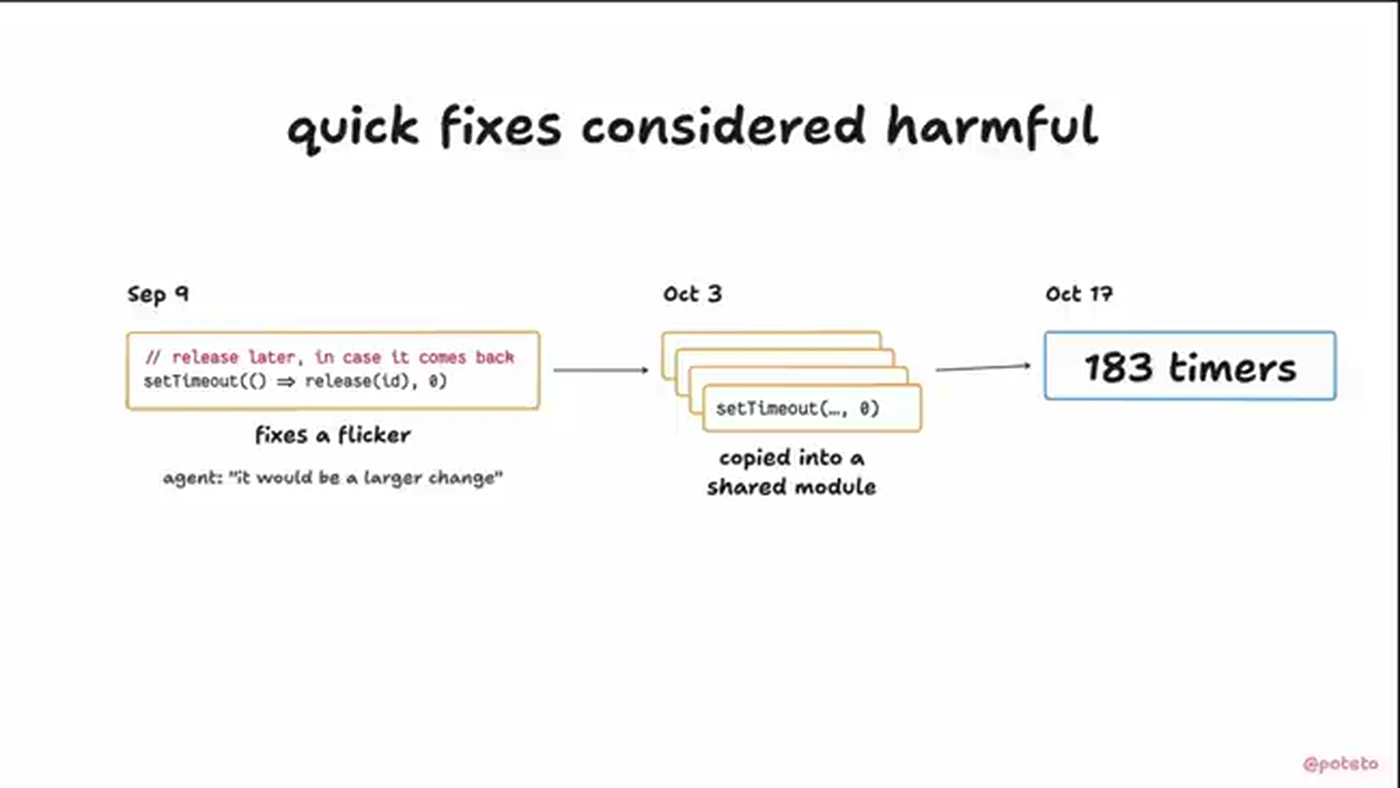
La secuencia de la diapositiva es de película de terror:
- 9 de septiembre: un agente arregla un parpadeo con
setTimeout(() => release(id), 0)y un comentario que lo justifica. Cuando le preguntan, contesta que hacerlo bien «sería un cambio más grande». - 3 de octubre: el apaño ya está copiado en un módulo compartido.
- 17 de octubre: hay 183 timers en el código.
Si has hecho trabajo de rendimiento en JavaScript ya sabes cómo acaba esto. Muchos timers creados y destruidos a toda velocidad disparan recolecciones de basura grandes, y eso se traduce en lag y tirones. La elección de arquitectura empeoró el rendimiento del cliente y también el del agente.
Lo peor, según poteto, no fue el apaño. Fueron los comentarios que lo explicaban y lo hacían parecer legítimo. Cada comentario era una invitación a copiarlo.
¿Por qué Grok Bot prohíbe el 99 % de los comentarios? 
Porque en Grok Bot aprendieron la lección y decidieron prohibir casi todos los comentarios. Los motivos que da poteto:
- Se quedan obsoletos con facilidad.
- Los humanos, en la práctica, no se molestan en leer el slop de los comentarios.
- Le dan al agente una vía de escape para justificar no hacer lo correcto porque es difícil.
- Y el peor de todos: no se pueden hacer cumplir.
Un comentario del tipo «agente del futuro: no hagas esto» parece bienintencionado. Pero nunca se convierte en algo en lo que puedas confiar, porque nada obliga a nadie a respetarlo.
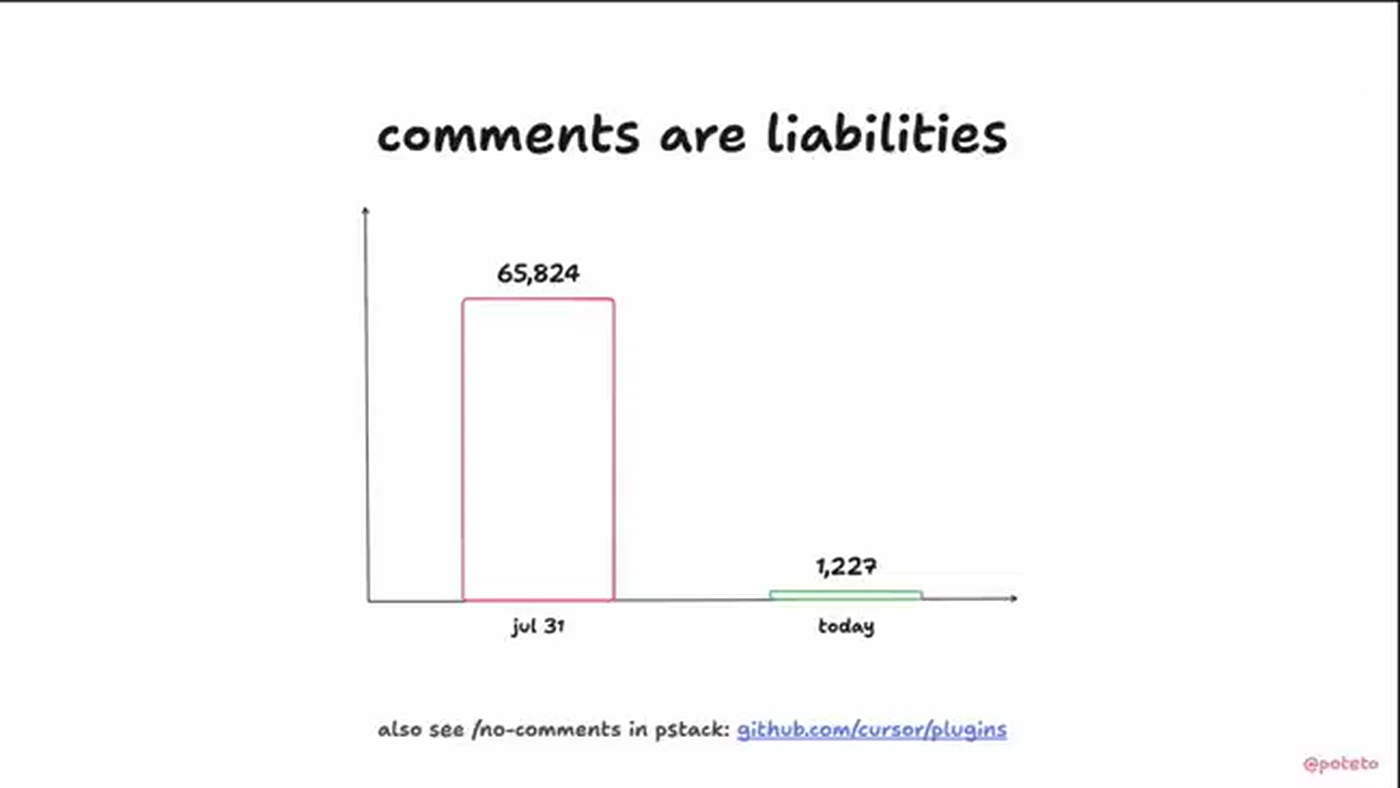
La diapositiva lo resume en dos barras: 65.824 comentarios el 31 de julio, 1.227 el día de la charla. Una reducción de más del 98 %. Para limpiarlos usaron la skill /no-comments de pstack, que también repasamos en la comparativa de skills anti-slop.
¿Qué pusieron en su lugar? Reglas de lint con mensajes de error muy útiles, que le dicen al agente que arregle la causa raíz del problema en vez de parchearlo.
🛡️ Un buen mensaje de error en una regla de lint es la mejor documentación que puedes darle a un agente: aparece justo cuando la necesita y no se puede ignorar.
Si te ha tocado limpiar un apaño que un agente copió por medio proyecto, no eres el único. Cada domingo compartimos en la newsletter lo que vamos aprendiendo al trabajar con agentes, con más de 7.500 developers al otro lado.
Apúntate gratis →¿Qué haces cada vez que corriges a tu agente? 
Conviertes la corrección en una comprobación determinista. O piensas cómo eliminar el problema por categoría con un mejor diseño de API o una mejor arquitectura.
Ese es el principio general del equipo. Y la diapositiva que lo acompaña es una escalera que solo sube.
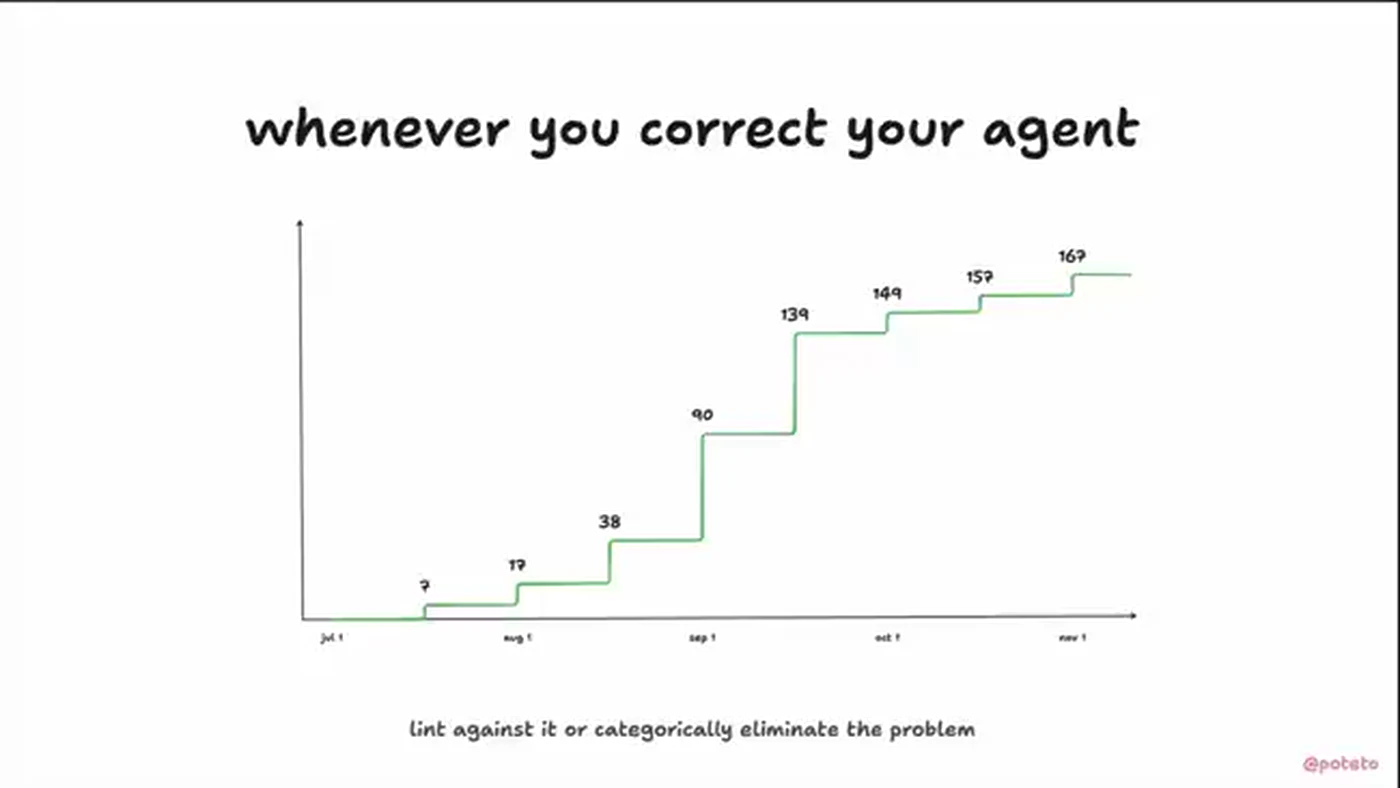
La gráfica no lleva unidad en el eje, pero por el contexto se lee como el número acumulado de comprobaciones que han ido añadiendo: 7 en julio, 38 en agosto, 90 a primeros de septiembre y 167 en noviembre. Cada escalón es una corrección que dejó de depender de que alguien se acordara de ella.
Y luego añade:
Si haces esto suficientes veces, tendrás menos cosas que vigilar en la revisión de código. Y en algún momento te darás cuenta de que no queda nada que revisar.
Ese es el punto en el que poteto deja que los agentes fusionen la mayoría de sus propias PRs.
¿Cómo lo aplicas tú? Una práctica que puedes empezar mañana:
- Cada vez que corrijas al agente en una conversación, apúntalo en una lista (un fichero, un issue, lo que uses).
- Al final de la semana, repasa la lista y pregunta de cada punto: ¿puede ser una regla de lint, un tipo, un test o un cambio de API?
- Si puede, escríbela. Con un mensaje de error que diga qué hacer, no solo qué está mal.
- Si no puede, entonces sí, va a la prosa: una skill o tu
AGENTS.md. - Limpia las apariciones antiguas del antipatrón. Si no, el agente seguirá copiándolas.
El quinto paso es el que más cuesta y el que más se olvida. Una regla nueva evita que aparezcan casos nuevos, pero las malas hierbas que ya estaban siguen en el jardín y siguen dando ejemplo.
¿Qué verificación usa el equipo de Grok Bot? 
Tres capas que van de lo práctico a lo experimental: verificación en tiempo de ejecución, verificación formal y testing basado en propiedades para interfaces.
Y con ellas ha cambiado la revisión de código. Ya no consiste en leer diffs. Consiste en mirar artefactos de verificación: vídeos, capturas, diagramas, pruebas formales.
Verificación en tiempo de ejecución 
Es la forma elegante de decir que el agente ejecuta el código él mismo y usa las herramientas de depuración que usa cualquier developer, como el Chrome DevTools Protocol. En la charla anterior poteto ya contó cómo son sus skills de verificación, así que voy rápido:
- Un feature map: algo así como un mapa del sitio con todas las funcionalidades desde el punto de vista del usuario. Le da al agente y a ti un vocabulario compartido, así que «la cosita de la barra lateral izquierda» deja de ser una adivinanza.
- CLIs propios dentro de las skills, para que el agente reutilice siempre el mismo driver. Eso ahorra tokens y además se puede testear.
En pstack tienes /create-verification-skill para montar la tuya.
Verificación formal: TLA+ y Lean 
Esto sí es nuevo. El equipo ha empezado a usar TLA+ para hacer model checking de los flujos de usuario importantes, como las notificaciones entre varios dispositivos y plataformas. Y Lean para demostrar que ciertos algoritmos son correctos.
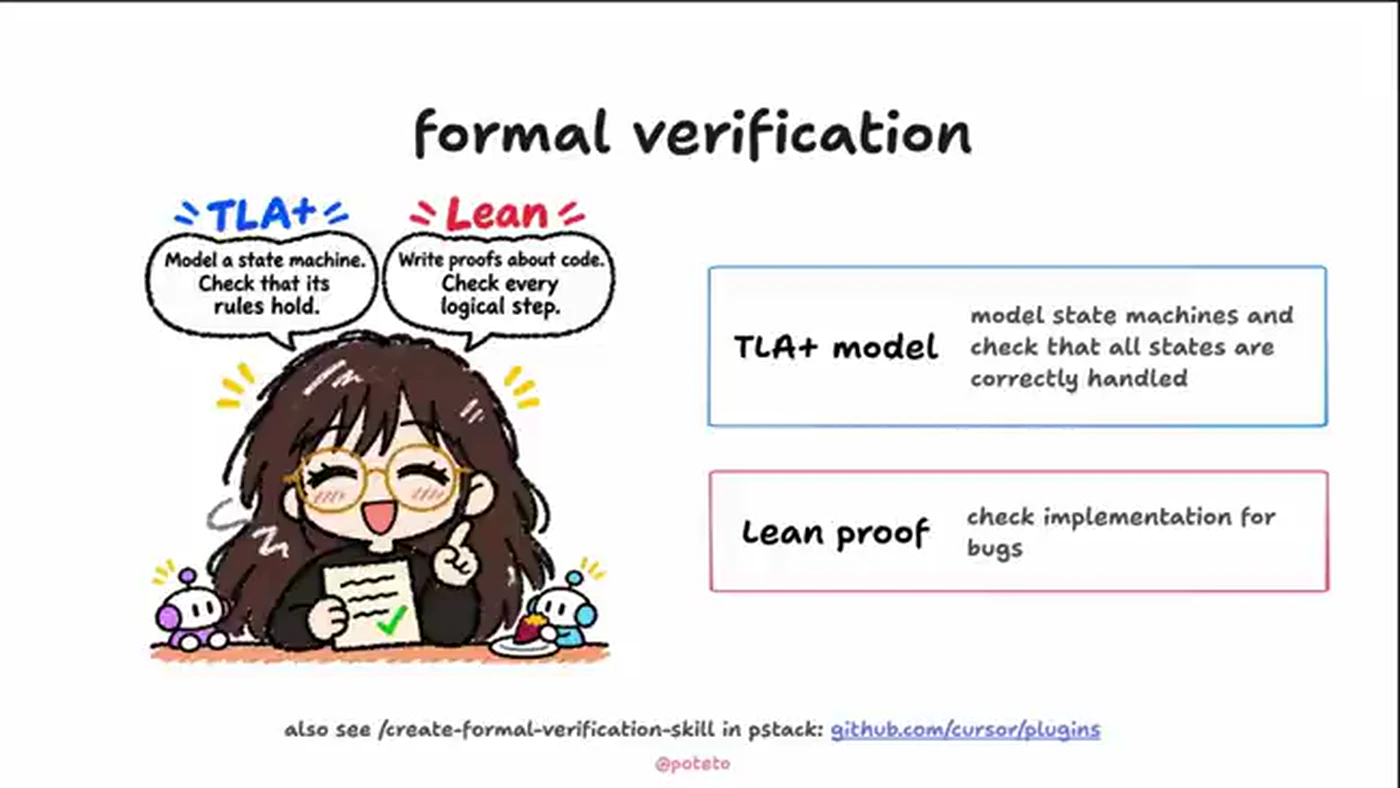
El ejemplo de Lean es muy concreto: escribieron su propia librería de virtualización (la que pinta solo los elementos visibles de una lista larga) y usan Lean para comprobar que no aparecen parpadeos ni saltos. Poteto dice que ya han encontrado unos cuantos bugs con verificación formal. También dice, con buen criterio, que no es una bala de plata: es otra herramienta, otra capa del entorno del agente.
La skill de pstack para esto es /create-formal-verification-skill.
Testing basado en propiedades para interfaces 
Lo último que están probando es el property-based testing aplicado a la UI, con una librería llamada Bombadil, de Antithesis. En lugar de escribir casos concretos, defines propiedades que tienen que cumplirse siempre y la herramienta explora la interfaz buscando una secuencia que las rompa. Según poteto, ya les ha cazado algún bug de interfaz.
Si te suena lejano, no te preocupes: es la capa más experimental de la charla, y el equipo la usa como complemento de las otras dos.
¿Por qué el 70 % de los tokens se va en verificar? 
Porque verificar es lo que permite confiar, y confiar es lo que permite escalar. Poteto lo cuenta con dos tuits de Cindy Sridharan, ingeniera muy conocida por su trabajo en sistemas distribuidos y observabilidad.
En mayo, Cindy se quejaba de que esa misma semana se habían fusionado varias PRs generadas por IA con bugs sutiles, que luego costaron días de verificación manual. «La velocidad no sube si cuentas el esfuerzo de arreglarlo todo», escribía.
Seis meses después, el 5 de noviembre, publicó esto:
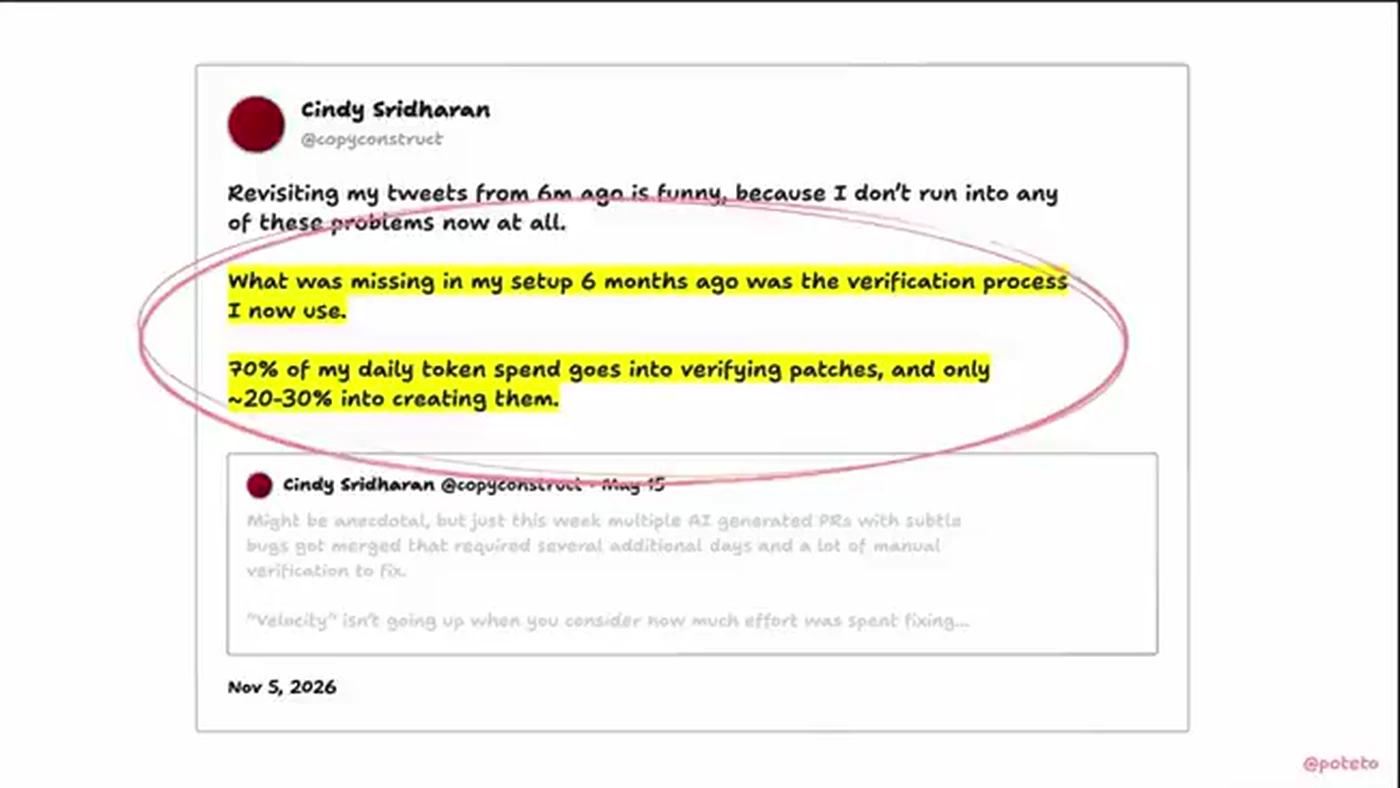
Dos frases resaltadas en amarillo:
- Lo que le faltaba hace seis meses era el proceso de verificación que usa ahora.
- El 70 % de su gasto diario de tokens va a verificar parches. Solo entre el 20 y el 30 % se va en crearlos.
Poteto dice que esa proporción cuadra con lo que ve en su propio trabajo: la mayor parte de sus tokens va a verificación.
Si miras la lista de técnicas de Cindy (tests unitarios, funcionales, de componentes, fuzzing, property-based, verificación formal, mutation testing, contratos, canarying, chaos testing…) no hay nada nuevo. Es buena ingeniería de software de toda la vida. La diferencia es que muchas de esas técnicas eran demasiado caras de entender, escribir o mantener. Los agentes han desplomado ese coste.
🔑 Para poteto estamos entrando en una edad de oro del testing y la verificación: los agentes permiten probarlo todo con una profundidad que antes no salía a cuenta.
Hay un dato que encaja con esto. En la encuesta de Stack Overflow de 2025, más developers desconfían de la precisión de las herramientas de IA (46 %) que los que confían en ella (33 %). Si te ves en ese 46 %, la charla de poteto propone una salida concreta: gastar más tokens en verificar y menos en generar.
Poteto añade un detalle más. La verificación formal no solo encuentra bugs: también te ayuda a razonar sobre cómo debería funcionar tu producto y si el agente entendió tu intención. Para eso creó la skill /statechart en pstack, que dibuja las máquinas de estado desde el punto de vista del usuario. Le resulta mucho más fácil de revisar junto a los vídeos y las capturas que aportan los agentes.
Tu IA puede mentirte
Monta tu capa de verificación sin esperar a tener un equipo como el de Grok Bot
Vas a ver cómo pasar del «creo que funciona» a las pruebas: skills de verificación, tests en navegador con Playwright, casos Gherkin y adversarial review entre modelos.
Entrar a la masterclass →Métodos en directo + casos Gherkin
¿Qué consigue un equipo que invierte en todo esto? 
Poteto enseñó los números del equipo de Grok Bot, y son de los que hacen que te frotes los ojos:
| Métrica | Dato que dio poteto |
|---|---|
| PRs a producción del equipo en un mes | 11.000 |
| PRs de poteto en un mes | 3.000 |
| Versiones estables de la app | Alrededor de una al día |
| Personas con al menos una PR en octubre | 227 |
| PRs revertidas | Estable en torno al 0,5 %, y más baja que antes en términos relativos |
Las versiones de la app de escritorio pasaron de 7 en agosto (desde el lanzamiento) a 19 en septiembre y 15 en octubre, con una mediana entre versiones de 44, 25 y 28 horas.
Lo de las 227 personas tiene más miga de lo que parece. No son todas del equipo. Muchas son contribuciones de paso, gente que no tiene mucho contexto del proyecto. Y aun así contribuyen sin romperlo, porque el repositorio no les deja hacer otra cosa.
¿No debería ser esto un caos? Es lo que cualquiera pensaría. Pero la tasa de reverts no ha subido.
¿Y el rendimiento de la app? 
Con ese ritmo y tanta gente tocando el código, el rendimiento de Grok Bot no solo se ha mantenido: ha mejorado en varias dimensiones desde el lanzamiento. Y sigue siendo una app de Electron («por ahora», añadió poteto).
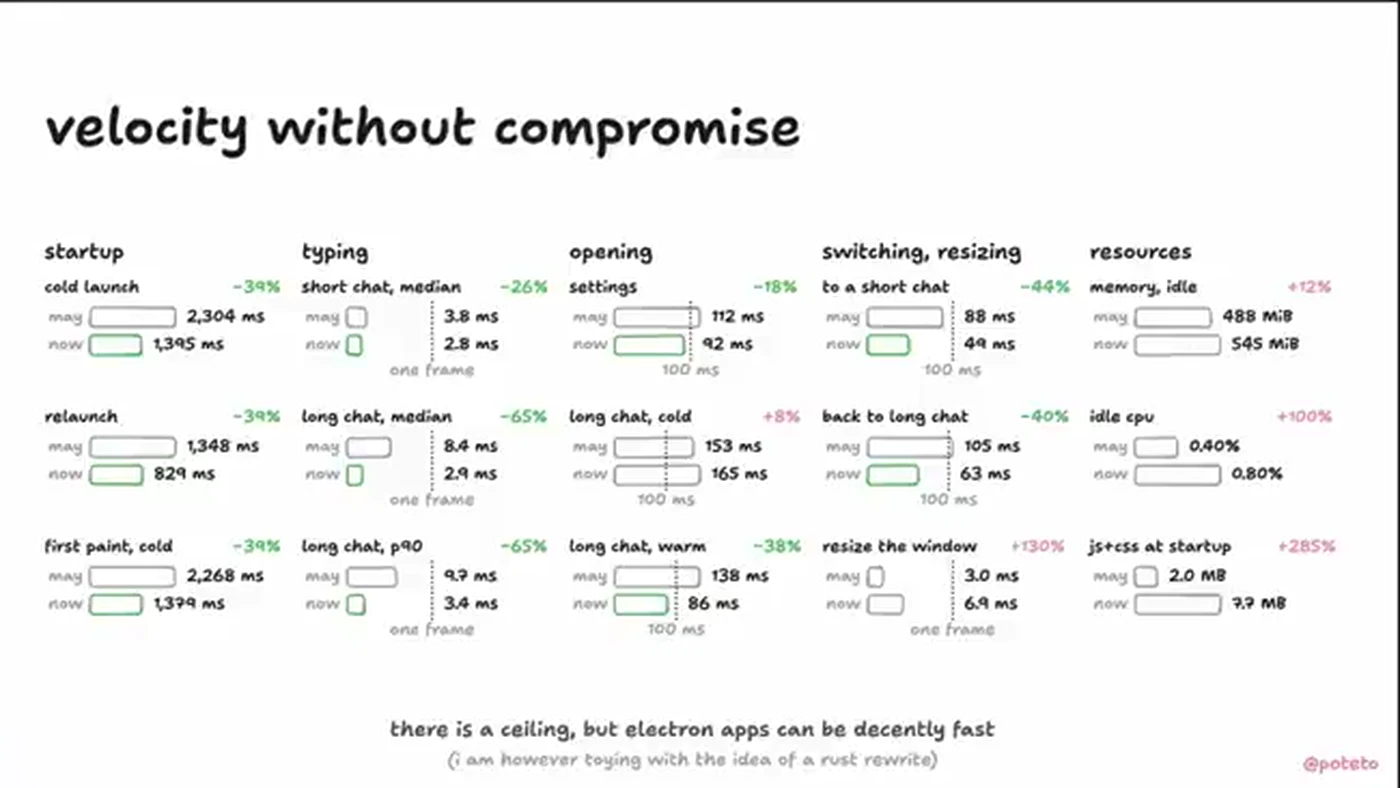
Algunos números de la diapositiva, de mayo a la fecha de la charla:
- Arranque en frío: de 2.304 ms a 1.395 ms (−39 %).
- Escribir en un chat largo (mediana): de 8,4 ms a 2,9 ms (−65 %).
- Volver a un chat largo: de 105 ms a 63 ms (−40 %).
Lo bueno de la diapositiva es que no esconde lo que ha empeorado. La memoria en reposo sube un 12 %, la CPU en reposo pasa del 0,40 % al 0,80 %, redimensionar la ventana tarda más (de 3 ms a 6,9 ms) y el JS y CSS que se carga al arrancar se ha multiplicado casi por cuatro, de 2 MB a 7,7 MB. Abrir un chat largo en frío también es algo más lento (+8 %).
Me parece más creíble así. Una diapositiva con todo en verde me haría sospechar. Esta dice: hemos ganado mucho donde el usuario lo nota, hemos perdido en algunos recursos y lo enseñamos. Al pie, una línea honesta: «hay un techo, pero las apps de Electron pueden ser decentemente rápidas». Y entre paréntesis, que está jugando con la idea de reescribirla en Rust.
Equipos que pasan de revisar diffs a revisar pruebas: es el cambio que estamos viviendo en directo. Cada domingo, gratis desde 2018, seleccionamos 12 recursos sobre cómo se está haciendo en la práctica.
Suscríbete gratis →¿Deberías montar ya tu software factory? 
La respuesta de poteto es: todavía no. Antes de automatizarlo todo, mejora tu bucle.
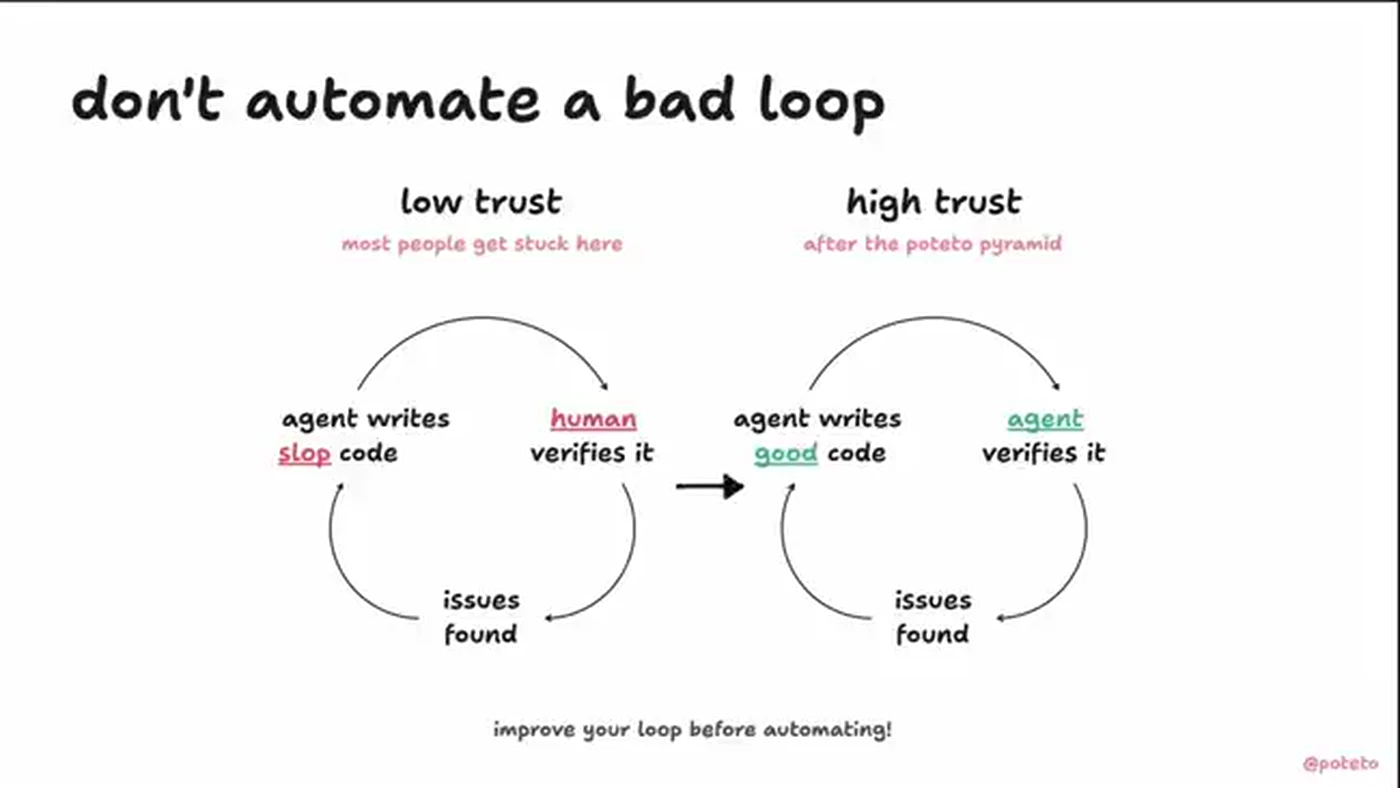
La diapositiva enfrenta dos bucles:
- Baja confianza (donde se queda atascada la mayoría): el agente escribe código slop, un humano lo verifica, se encuentran problemas, vuelta a empezar.
- Alta confianza (después de la pirámide): el agente escribe buen código, otro agente lo verifica, se encuentran problemas, vuelta a empezar.
La forma es la misma. Lo que cambia es quién verifica y qué calidad tiene lo que entra.
Si tu bucle interno produce slop, automatizarlo solo produce más slop. Y entonces necesitas echarle más y más tokens al problema, que como todos sabemos sale caro.
Su consejo, en orden:
- Cada vez que corrijas al agente, hazlo mejorando el código base primero.
- Empieza con una regla de lint que impida apariciones nuevas del antipatrón.
- Limpia las apariciones antiguas.
- Asegúrate de que tu historia de verificación es sólida.
Ese trabajo es un requisito previo para automatizar. Y cuando lo tienes hecho, descubres que montar tu fábrica encima es fácil.
¿Cómo es el bucle externo de Grok Bot? 
El ejemplo con el que cerró la charla es el que mejor resume todo lo anterior. Cada vez que el equipo saca una versión nueva:
- Grok Bot arranca solo un proyecto nuevo de agentes.
- Ese proyecto hace fuzzing de toda la aplicación, de la build entera, usándola como un usuario real para encontrar bugs.
- Por cada bug que encuentra, abre una PR con el arreglo.
- Y la fusiona sola.
Poteto lo dice con la boca pequeña («por loco que suene»), y la explicación es la tesis de toda la charla: el código base es lo bastante bueno como para que las PRs tiendan a ser buenas por defecto. La mayor parte del código de producto que entra ya no necesita una revisión humana profunda.
En la diapositiva se ve un hilo del bot con el resultado de un fuzzing en Linux: 56 bugs distintos tras quitar duplicados, cada uno con su respuesta en el hilo, ordenados por severidad.
Esto es lo que poteto llama el bucle externo, y lo ofrece como argumento comercial (Grok Bot tiene conectores, rutinas y proyectos para orquestar cientos o miles de agentes). Lo que me interesa no es el producto, sino el orden: el bucle externo llega al final, cuando el interno ya es de fiar.
¿Qué te llevas si no trabajas en SpaceX? 
Es fácil leer «11.000 PRs al mes» y pensar que esto no va contigo. Pero casi nada de lo que cuenta poteto requiere el presupuesto de SpaceX. Requiere disciplina.
Lo que puedes hacer esta semana, en un proyecto normal:
| Capa de la pirámide | Qué puedes hacer ya |
|---|---|
| Código base | Elige un antipatrón que el agente repita y elimínalo por diseño: una API que no deje hacerlo mal |
| Análisis estático | Una regla de lint por cada corrección que repitas, con un mensaje que diga qué hacer en su lugar |
| Verificación | Que el agente ejecute la app y te traiga una captura o un vídeo, no un «debería funcionar» |
| Prosa | Revisa tu AGENTS.md: ¿qué líneas podrían ser una regla de lint? Muévelas |
| Revisión humana | Mide qué revisas a mano cada semana. Lo que se repite es candidato a subir de capa |
Y una advertencia honesta. Poteto habla desde un proyecto joven, con un framework propio y un equipo que puede prohibir useEffect de un día para otro. En un monolito con diez años de historia, limpiar el jardín cuesta mucho más. La idea vale igual, pero el ritmo será otro. Si quieres ver cómo encaja con el trabajo del día a día, el post sobre cómo ser harness engineer recorre ese camino pregunta a pregunta.
Tampoco esperes que la charla te dé todos los detalles. No enseña las reglas de Dune, ni los modelos de TLA+, ni cuánto cuesta en tokens mantener todo esto. Es una charla de 17 minutos y va a la idea, no al cómo.
La idea, eso sí, es potente.
Si todo el código es slop, la diferencia no está en quién lo escribe. Está en lo que le dejas copiar.
¿Qué corrección le has hecho hoy a tu agente que mañana podría ser una regla?
TL;DR 
- 🔺 La pirámide de poteto ordena dónde invertir: código base, análisis estático, verificación, prosa y, al final, revisión humana.
- 🧹 Cada corrección al agente debe acabar en una regla de lint o en un cambio de diseño que elimine el problema. En Grok Bot pasaron de 7 a 167 comprobaciones en cuatro meses.
- 🚫 Prohibieron
useEffecten código de producto y el 99 % de los comentarios: de 65.824 a 1.227. - 🔬 Verificación en ejecución, formal (TLA+ y Lean) y basada en propiedades. Cindy Sridharan dedica el 70 % de sus tokens a verificar.
- 🚀 Resultado: 11.000 PRs al mes en el equipo, un 0,5 % de reverts y una app más rápida que en su lanzamiento. No automatices un bucle malo.
Preguntas frecuentes 
¿Quién es poteto? 
Es Lauren Tan, Principal Engineer en SpaceX, donde trabaja en Grok Bot, la app de escritorio de agentes de xAI. Antes formó parte del core team de React y trabajó en Cursor. Es la autora de pstack, un plugin de skills para Cursor.
¿De qué va la charla «All Code Is Slop (Except Mine)»? 
De cómo mantener o mejorar la calidad del código mientras multiplicas tu productividad con agentes. La tesis es que el slop no depende de quién escribe el código, sino del entorno: si inviertes en código base, análisis estático y verificación, puedes confiar en lo que hacen tus agentes.
¿Qué es la pirámide de poteto? 
Es una pirámide invertida de cinco capas que ordena dónde invertir para confiar en tus agentes: código base, análisis estático, verificación, prosa (rules, skills, AGENTS.md) y revisión humana. Las capas de arriba son más baratas y deterministas. La revisión humana es la más cara.
¿Por qué convertir correcciones en reglas de lint en vez de escribirlas en AGENTS.md? 
Porque una regla en código es reproducible y no depende de que el agente la lea o decida cumplirla. Una línea en AGENTS.md es prosa que requiere criterio. Una regla de lint que falla en CI se cumple siempre, y con un buen mensaje de error le dice al agente qué hacer.
¿Por qué prohibieron los comentarios en el código de Grok Bot? 
Porque se quedan obsoletos, casi nadie los lee, no se pueden hacer cumplir y dan al agente una excusa escrita para justificar apaños. En Cursor vieron cómo un setTimeout justificado con un comentario se copió hasta sumar 183 timers. En Grok Bot bajaron de 65.824 comentarios a 1.227.
¿Por qué prohibir useEffect en código generado por agentes? 
Porque es una API que requiere muchos matices para usarse bien, y poteto observó que los agentes la usan mal. Su principio es que lo que necesita matices acaba en slop. En Dune solo se permite dentro de algunas APIs del framework, así que el problema desaparece de la revisión de código.
¿Qué es la verificación formal y cómo la usan con agentes? 
Es demostrar matemáticamente que un sistema cumple ciertas propiedades. El equipo de Grok Bot usa TLA+ para comprobar máquinas de estado de flujos como las notificaciones entre dispositivos, y Lean para probar algoritmos como su librería de virtualización. Ya han encontrado bugs con ella, aunque poteto no la considera una bala de plata.
¿Cuántos tokens se dedican a verificar el código generado por IA? 
Cindy Sridharan contó que el 70 % de su gasto diario en tokens va a verificar parches y solo un 20-30 % a crearlos. Poteto dijo en la charla que su proporción es parecida: la mayor parte de sus tokens se va en verificación.
¿Se puede fusionar código de agentes sin revisión humana? 
Poteto lo hace con la mayoría de las PRs de producto, pero solo después de meses invirtiendo en el código base, el análisis estático y la verificación. Su equipo fusiona unas 11.000 PRs al mes con un 0,5 % de reverts. Sin esa base, automatizar la fusión solo multiplica el slop.
¿Qué es el bucle externo en el desarrollo con agentes? 
Es la automatización que se pone encima del trabajo diario: procesos que lanzan agentes sin que nadie los pida. En Grok Bot, cada versión nueva dispara un fuzzing de toda la app que encuentra bugs, abre una PR con el arreglo y la fusiona. Poteto insiste en construirlo solo cuando el bucle interno ya es de fiar.
Fuentes 
- All Code Is Slop (Except Mine), charla de Lauren Tan en el AI Engineer Code Summit
- pstack en el repositorio de plugins de Cursor
- Bombadil, testing basado en propiedades para interfaces, de Antithesis
- TLA+, de Leslie Lamport
- Lean, lenguaje y asistente de demostraciones
- Stack Overflow Developer Survey 2025: AI
🧨 Última oportunidad para recibir la dinamita que mereces sobre programación con IA el próximo domingo: Suscríbete gratis a Web Reactiva en https://webreactiva.com/newsletter

Escrito con la ayuda de la IA generativa de Claude, fuentes fidedignas y con un human in the loop:
Dani Primo.
12 recursos para developers cada domingo en tu bandeja de entrada
Además de una skill práctica bien explicada, trucos para mejorar tu futuro profesional y una pizquita de humor útil para el resto de la semana. Gratis.