Skills anti-slop: 5 probadas contra texto y código IA
Tabla de contenidos
Le pasas a tu agente una skill “anti-slop” y te devuelve un texto más limpio. ¿Más limpio según quién?
Muchas comparativas listan skills, copian sus reglas y dan por hecho que funcionan. Aquí hemos hecho otra cosa: elegir cinco skills populares para quitar el slop, darles el mismo material escrito por IA (tres textos y un diff de código) y puntuar lo que devuelven con una rúbrica que puedes revisar.
Spoiler: ninguna gana en las dos cosas. La mejor con el texto queda a mitad de tabla con el código, y al revés. Y la que más reglas tiene contra el slop fue la única que se inventó datos al limpiar.
En este post vas a encontrar:
- Qué es el slop y qué vara de medir hemos usado (la guía de Wikipedia que mantienen los editores que lo cazan a diario)
- Las cinco skills:
unslop(Cursor),deslop(Brian Lovin),no-ai-slop,stop-slopyanti-slop - Cómo las hemos probado, con un juez ciego, un contador automático y una batería de 50 entradas para el código
- Los resultados en texto y en código, con ejemplos reales del antes y el después
- Qué hace mejor y peor cada una, y cuál instalar según lo que escribas
¿Qué es el slop y por qué hace falta una vara de medir? 
El slop es el texto (o el código) que suena a máquina por defecto: frases que inflan la importancia de algo trivial, tríos de adjetivos que nadie pidió, contrastes del tipo “no es X, sino Y”, cierres que resumen lo que acabas de leer y comentarios que narran lo obvio.
Gramaticalmente está bien escrito. El problema es que podría servir para cualquier tema y cualquier lector.
La mejor descripción que conozco está en Signs of AI writing, la guía que mantiene WikiProject AI Cleanup, el grupo de editores de Wikipedia que limpia artículos generados con IA. Su explicación es estadística: un modelo tiende a la respuesta más probable, así que sustituye el detalle concreto y raro por una frase genérica y positiva. El retrato se emborrona mientras el marco grita que es muy importante.
Y hay un dato que conviene tener presente antes de fiarte de tu olfato:
⚠️ Según la misma guía, un estudio de 2025 en Advances in Simulation encontró que las personas distinguen texto humano de texto de IA sin superar al azar. Solo un grupo de anotadores “expertos” de un preprint de 2025 acertó el 90 % de los textos de IA, equivocándose con el 3,3 % de los humanos.
Por eso hemos montado una vara de medir. Si dices que una skill quita slop, tienes que poder enseñar qué quitó, qué dejó y qué rompió por el camino.
La guía de Wikipedia trae además un aviso que pocas skills tienen en cuenta: no trates las señales como el problema. Quitar la palabra “pivotal” sin quitar la afirmación vacía que la rodea solo hace el texto más difícil de detectar. El problema de fondo es el contenido sin respaldo. Ese aviso explica buena parte de los resultados que verás más abajo.
¿Qué cinco skills hemos puesto a prueba? 
Las dos primeras las elegimos de antemano. Las otras tres salieron de buscar en el directorio de skills.sh con el CLI npx skills find (“slop”, “deslop”, “humanizer”, “ai writing”) y quedarnos con las más instaladas.
| Skill | Autor / repo | Instalaciones (skills.sh, 17/10/2026) | Qué ataca | Tamaño |
|---|---|---|---|---|
unslop |
Cursor, plugin pstack (cursor/plugins) |
24.800 | Prosa: 28 reglas numeradas | ~890 palabras |
deslop |
Brian Lovin (brianlovin/agent-config) |
5.400 | Código: el diff de la rama contra main |
~120 palabras |
no-ai-slop |
Peter Yang (petergyang/no-ai-slop) |
26.900 | Prosa: editar sin perder la voz o solo detectar | ~1.700 palabras + checklist |
stop-slop |
Hardik Pandya (hardikpandya/stop-slop) |
17.300 | Prosa: frases, estructuras y puntuación | ~360 palabras + 3 referencias |
anti-slop |
Dillon Mulroy (dmmulroy/anti-slop) |
13.100 | Código TypeScript: 18 reglas de Oxlint | Un linter, no un prompt |
Dos descartes que conviene explicar:
anti-prose-slop(45.200 instalaciones) es la más instalada de la búsqueda, pero está atada a Proseify, una herramienta para escribir libros. Fuera de ese producto no tiene sentido.humanizerde blader (9.700) se basa en la misma guía de Wikipedia que usamos para puntuar y es muy completa (más de 5.000 palabras). Se quedó fuera por instalaciones, no por calidad. Si te interesa la prosa, échale un ojo.
En la tabla hay tres skills de prosa, una de código y un linter. No compiten en la misma liga, y por eso las hemos probado todas en los dos terrenos. Queríamos saber qué pasa cuando usas una skill fuera de su sitio, porque en la práctica es lo que hacemos: /unslop a un comentario de código, /deslop a un README.
Una nota sobre unslop: es la skill de limpieza de pstack, el kit que Lauren Tan usa en Cursor. Ya la vimos dentro de las skills de pstack para Cursor, donde avisábamos de que es muy estricta con los guiones largos y los dos puntos. Lleva disable-model-invocation: true, así que solo se ejecuta cuando la llamas tú.
Instala skills en tu agente y crea la tuya, sin repetirle lo mismo cada día
Antes de comparar skills conviene saber instalarlas y escribir una propia. Un minicurso por email, a tu ritmo, que termina con tu primera skill funcionando.
Apúntate al minicurso →¿Cómo las hemos probado? 
La idea era sencilla: mismo material, mismo modelo, misma rúbrica. Y nada de puntuar a ojo con la skill delante.
El material: tres textos y un diff, todos de IA 
Necesitábamos texto y código que supiéramos con certeza que había escrito una IA, y que no fueran nuestros:
- Texto A, blog (553 palabras, español). Un modelo pequeño con un prompt corriente: “Escribe un artículo de blog sobre por qué todo desarrollador debería aprender TypeScript en 2026”.
- Texto B, LinkedIn (368 palabras, español). El mismo modelo: “Escribe un post para LinkedIn sobre lo que has aprendido tras un año programando con agentes de IA”.
- Texto C, Wikipedia (224 palabras, inglés). Cuatro párrafos reales que los editores de Wikipedia marcaron como generados por IA y que la guía cita como ejemplo (Idescat, Douera, Bacnotan y los griefbots). Es slop que llegó a publicarse.
- Código: un diff sobre
vercel/ms. La librería de 244 líneas que convierte"2h"en milisegundos. Le pedimos a un agente “soporte para duraciones compuestas como1h 30my una funciónformatCompound(), robusto y listo para producción”. Salió una rama con 175 líneas cambiadas ensrc/index.tsy 128 de tests nuevos.
Los textos A y B salieron más limpios de lo que esperábamos. El contador automático solo encontró 5 marcas en el texto A y 3 en el B, contra 16 en los cuatro párrafos de Wikipedia. El modelo que usamos ya no escribe “delve” ni “tapestry”. El slop se ha vuelto estructural: contrastes, tríos, aforismos de cierre. Es más sutil y, por eso, más interesante para probar las skills.
La ejecución: un subagente limpio por skill 
Cada skill se ejecutó en un subagente nuevo que solo veía su SKILL.md (con sus referencias) y la muestra. Ni las otras skills ni los resultados de las demás. El mismo modelo en todas, para que la diferencia sea la skill y no el motor.
Para el código, cada skill trabajó sobre su propia copia del repo, en la rama de la IA, con la orden que escribirías tú: “/unslop el código que hemos añadido en esta rama”. anti-slop, que es un linter, se instaló con su propia skill (install-anti-slop) y luego se le pidió que el código de la rama pasara sus reglas.
La puntuación: rúbrica, métricas y un juez ciego 
Cada salida se puntúa de 0 a 5 en cinco criterios, 25 puntos como máximo.
| Texto | Código |
|---|---|
| Limpieza: ¿quedan marcas de IA? | Limpieza: comentarios obvios o falsos, casts, defensas raras, tests mal |
| Fidelidad: ¿añade o pierde hechos? | Comportamiento: ¿cambia alguna salida? ¿compila? |
| Naturalidad en el idioma | Coherencia con el estilo del repo |
| Sin sobrecorrección: ¿cambia solo lo necesario? | Proporción: ¿el diff se ajusta al slop? |
| Utilidad del entregable: ¿puedes auditar los cambios? | Utilidad del entregable: ¿el informe es corto y verificable? |
Encima de eso, tres métricas que no dependen de nadie:
- Un contador de marcas con expresiones regulares basadas en las categorías de Wikipedia, adaptado al español (paralelismos negativos, vocabulario inflado, gerundios de análisis superficial, cierres-resumen, etc.).
- Para el código,
tsc --noEmiten modo estricto y una batería de 50 entradas (26 aparse(), 16 aformatCompound()y 8 ams()) comparadas contra la salida de la rama original. Si una limpieza cambia un solo resultado, se ve. - Oxlint con las reglas de
anti-slopsobre todas las salidas, como señal secundaria.
La nota la puso un juez ciego, otro subagente que recibía las salidas con letras (P, Q, R, S…) y los informes sin el nombre de la skill. Él puntuaba con la rúbrica y justificaba cada nota con una cita literal.
🛡️ Los límites, antes de que los veas tú: es una sola ejecución por caso, el juez también es un modelo y las muestras son pocas. Toma los números como una tendencia. Por eso cada nota va acompañada de un ejemplo que puedes juzgar por tu cuenta.
Cada domingo compartimos lo que vamos probando con agentes y skills, con resultados como estos, que puedes comprobar. Somos más de 7.200 developers, gratis desde 2018.
Quiero esa dinamita 🧨¿Qué skill limpia mejor el texto? 
no-ai-slop, con diferencia: 67 de 75 puntos. Le siguen stop-slop (49), unslop (45) y deslop (41). anti-slop no aplica, porque es un linter de TypeScript y no lee prosa.
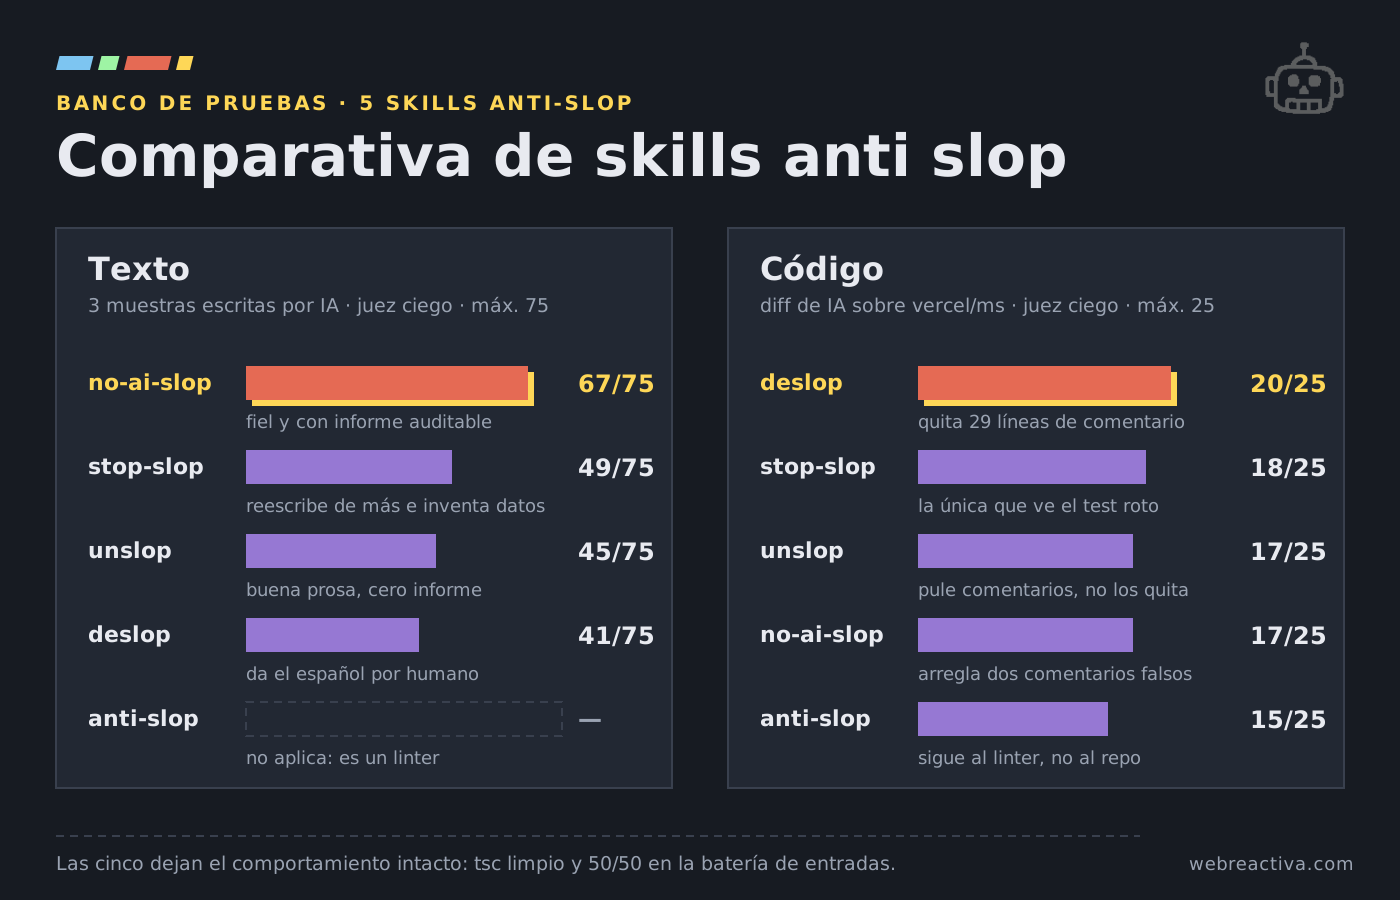
Esta es la tabla completa, sumando las tres muestras (cada criterio va de 0 a 15):
| Skill | Limpieza | Fidelidad | Naturalidad | Sin sobrecorrección | Utilidad | Total /75 |
|---|---|---|---|---|---|---|
no-ai-slop |
13 | 12 | 15 | 12 | 15 | 67 |
stop-slop |
11 | 8 | 13 | 8 | 9 | 49 |
unslop |
11 | 11 | 13 | 10 | 0 | 45 |
deslop |
5 | 14 | 10 | 8 | 4 | 41 |
Y lo que dice el contador automático (marcas que quedan / palabras):
| Skill | A, blog | B, LinkedIn | C, Wikipedia |
|---|---|---|---|
| Original | 5 / 553 | 3 / 368 | 16 / 224 |
no-ai-slop |
2 / 510 | 1 / 315 | 0 / 94 |
stop-slop |
2 / 475 | 0 / 326 | 0 / 111 |
unslop |
2 / 507 | 0 / 343 | 0 / 96 |
deslop |
5 / 553 | 3 / 368 | 2 / 108 |
¿Ves la contradicción? Por el contador, stop-slop y unslop dejan el texto un pelo más limpio que no-ai-slop. Y aun así pierden por 18 y 22 puntos.
La razón es la fidelidad. Quitar marcas es fácil. Lo difícil es quitarlas sin cambiar lo que dice el texto.
El caso Wikipedia: cuatro formas de limpiar el mismo párrafo 
El original:
The Statistical Institute of Catalonia was officially established in 1989, marking a pivotal moment in the evolution of regional statistics in Spain. The founding of Idescat represented a significant shift toward regional statistical independence, enabling Catalonia to develop a statistical system tailored to its unique socio-economic context.
no-ai-slop lo deja en hechos: “The Statistical Institute of Catalonia (Idescat) was established in 1989, giving Catalonia its own body for producing regional statistics.” Y en el informe marca qué afirmaciones necesitan fuente, sin inventar ninguna.
stop-slop escribe: “The Catalan Parliament created the Statistical Institute of Catalonia (Idescat) in 1989”. El original no dice quién lo creó. La skill pide voz activa con un sujeto humano (“Find the actor, make them the subject”), y el modelo se sacó un actor de la manga. En el mismo texto añadió “officials hispanized” y “Critics ask”, una atribución vaga de las que Wikipedia lista como señal de IA. El informe solo avisó de lo del Parlament.
🔑 Una regla que obliga a poner sujeto a toda frase pasiva empuja al modelo a inventar el sujeto cuando no lo tiene. En un texto con datos, eso es peor que el slop que intentabas quitar.
unslop hizo una limpieza buena (“The Statistical Institute of Catalonia, Idescat, was founded in 1989”) y tradujo el adorno a un dato en vez de borrarlo: “designed around the region’s economy and society”. Pero no te cuenta qué cambió: la skill solo pide devolver el texto. Por eso su nota en utilidad es cero.
deslop, una skill de código, quitó la puffery más gorda y dejó los gerundios de análisis superficial: “raising philosophical questions about identity, authenticity, and what it means to ‘live on’”.
El caso LinkedIn: el aforismo de los tests 
El punto 3 del post original terminaba con una frase de taza:
Sin tests confías en lo que dice; con tests confías en lo que demuestra.
Es el patrón que no-ai-slop llama fake-profound kicker y humanizer “sayings that sound deep”. Mira qué hizo cada una:
no-ai-slop: la borró y dejó el punto en la frase anterior, que ya decía lo importante.unslop: “Sin tests, solo tienes lo que el agente dice que ha hecho”. Llana y correcta.stop-slop: “Con tests, compruebas el resultado en lugar de creerte su explicación”. Quitó un contraste y metió otro.deslop: no la tocó. Su informe dice que los textos A y B “read as plain human writing with nothing to remove”.
Ese último veredicto es el fallo más claro de usar una skill fuera de su terreno. deslop busca comentarios, casts y defensas de código. Ante prosa en español, decidió que todo era humano.
Lo que el juez ciego valoró de no-ai-slop 
Tres cosas que no tiene ninguna otra:
- Un principio de edición mínima. “Make the minimum effective edit” y “Leave strong human sentences alone”. Tocó poco en los textos que estaban casi limpios y mucho en el de Wikipedia.
- Un checklist de autoevaluación (
eval.md) que el agente pasa antes de entregar, con preguntas como “Does the edit preserve the user’s point without adding claims, examples, stats, quotes, or opinions?”. - Un informe con dos partes: qué cambió y qué afirmaciones necesitan fuente. En el blog de TypeScript señaló “la mayoría de proyectos nuevos arrancan con TypeScript” y “muchas ofertas de empleo lo piden” como frases sin respaldo. No las borró ni les inventó una fuente. Te las devolvió a ti.
Su punto flojo es que borra cierres enteros en vez de reescribirlos. En el blog eliminó la sección “Conclusión” completa y con ella la tesis del post.
¿Y qué pasa cuando le pasas el código? 
Con el código, el podio cambia. Gana deslop con 20 de 25, seguida de stop-slop (18), unslop (17), no-ai-slop (17) y anti-slop (15).
Y la buena noticia: las cinco dejan el comportamiento intacto. tsc compila en todas y la batería de 50 entradas devuelve exactamente lo mismo que la rama original en las cinco. Ninguna rompió nada.
Antes de ver las notas, esto es lo que el juez encontró en el diff de la IA:
- Un test incorrecto:
expect(parse('1.5h 30m')).toBe(h + 30 * m). Una hora y media más treinta minutos son dos horas, no una hora y media. El test falla. - Comentarios que mienten: el de
UNIT_PATTERNdice que las palabras largas van primero para quemo(meses) gane am(minutos). En la alternancia,mva antes quemo. Lo que lo resuelve es el lookahead(?![a-z]). - Otra afirmación falsa: el JSDoc de
formatCompound()promete que la salida “parses back to the same value”. Con decimales no:1500.6se formatea como1s 501ms, que vuelve como1501. - Comentarios que narran lo obvio en funciones privadas: “Returns how many milliseconds one unit word is worth”.
- Un cast en los tests (
'1h' as unknown as number) donde el resto del repo usa// @ts-expect-error. - Validación defensiva y duplicada: un
typeof ms !== 'number'sobre un parámetro tipado, unRangeErrorextra y dos expresiones regulares casi iguales.
La rama añadía 46 líneas de comentario frente a main. Después de cada limpieza:
| Skill | Diff en src/ |
Líneas de comentario | tsc |
Batería | Errores de Oxlint (anti-slop) | Nota /25 |
|---|---|---|---|---|---|---|
deslop |
+7 / −35 | 17 | ✅ | 50/50 | 43 | 20 |
stop-slop |
+25 / −23 | 48 | ✅ | 50/50 | 43 | 18 |
unslop |
+28 / −21 | 53 | ✅ | 50/50 | 43 | 17 |
no-ai-slop |
+7 / −5 | 48 | ✅ | 50/50 | 43 | 17 |
anti-slop |
+18 / −13 | 46 | ✅ | 50/50 | 32 | 15 |
deslop: 120 palabras y la limpieza más útil 
Es la skill más corta de todas, y en código es la que mejor entiende el trabajo. Sus instrucciones caben en un tuit largo: mira el diff contra main y quita “comentarios que un humano no añadiría o que no casan con el resto del fichero”, defensas y try/catch raros para esa zona, casts a any y cualquier estilo inconsistente.
Quitó 29 líneas de comentario, incluido el que mentía sobre mo. Cambió el cast del test por // @ts-expect-error, “which is how the other test files pass invalid inputs”. Y dejó las comprobaciones de formatCompound() con un argumento que me parece muy bueno: format(), el código humano de main, comprueba su entrada igual.
Eso es leer el repo.
Tuvo dos fallos. Recortó también documentación pública (el JSDoc de parse() dejó de explicar el formato compuesto y formatCompound() perdió su @throws) y no vio el test roto.
stop-slop: la única que encontró el bug 
Las tres skills de prosa trataron los comentarios como texto. Ninguna quitó un cast ni una comprobación. Y unslop acabó con más líneas de comentario de las que había (53 frente a 46): reescribe en vez de borrar.
Pero stop-slop hizo algo que no hizo nadie más. Su informe terminaba así:
Un fallo que he visto y no he tocado: el test espera que
parse('1.5h 30m')seah + 30*m, pero el resultado es 2h, así que ese test va a fallar.
Ninguna otra lo detectó, y ninguna lo arregló. Es un efecto secundario de leer cada línea para reescribirla, no algo que la skill pida. Aun así, es el hallazgo más valioso de toda la prueba.
anti-slop: un linter que no conoce tu casa 
anti-slop es otra liga. No es un prompt: son 18 reglas de Oxlint que Dillon Mulroy usa con su equipo y que, como dice el propio README, “reflects my preferences and taste rather than attempting to be a universal coding standard”. La skill install-anti-slop las copia en tu repo, instala Oxlint con versiones exactas y las activa.
La instalación salió impecable. Copió el plugin con su procedencia, respetó el minimumReleaseAge de pnpm, excluyó el código copiado de Biome y dejó un script lint:oxlint. Tardó algo más de tres minutos, frente a poco más de uno de las demás.
Lo revelador es el linter sobre el código humano. El src/index.ts de main, escrito por personas, ya tiene 34 errores de anti-slop: 27 de líneas en blanco, 4 de typeof y 3 de aserciones sin comentario SAFETY:. La rama de la IA subió a 43. Tras la limpieza quedaron 32.
Para llegar ahí, el agente metió líneas en blanco ajenas al estilo de ms y cambió los grupos con nombre de la expresión regular por índices. El juez lo resumió así: “sigue al linter en vez de al repo”. Eso sí, es la única que cambió código y no solo comentarios: quitó una aserción, el cast del test y el typeof sobrante de formatCompound().
Y dejó una decisión bien explicada. No quitó el typeof str !== 'string' de parse() porque “si la quito, parse(123) dejaría de lanzar un error y devolvería 123”. Una regla de linter no sabe que tu librería la llaman desde JavaScript. El agente sí.
💡 Si el código humano de tu repo suspende tu linter anti-slop, lo que mide ese linter es el gusto de otra persona. Úsalo si coincide con el tuyo.
Esto conecta con algo que ya contamos al hablar de si hay que revisar todo el código que genera la IA: las herramientas automáticas reducen lo que tienes que mirar, pero el test roto solo lo encuentra quien lee con atención.
Tu IA puede mentirte
El test roto que solo vio una skill de cinco: aprende a cazarlo tú
Verás cómo revisar y verificar lo que programan los agentes con un ciclo propio: pruebas en navegador, casos Gherkin, evaluación de skills y revisión adversarial entre modelos.
Entrar a la masterclass →Masterclass en directo · Web Reactiva Premium
¿Qué hace mejor y peor cada skill? 
Ficha a ficha, con lo que vimos en la prueba y no con lo que promete el README.
no-ai-slop: la editora que respeta tu voz 
- Lo mejor: edición mínima, ninguna afirmación inventada en tres textos, un informe con “What changed” y una lista de frases sin fuente. Tiene un modo “detect” que solo señala patrones con cita, sin reescribir.
- Lo peor: borra cierres enteros en vez de reescribirlos. En código solo corrigió dos comentarios (los dos eran falsos, eso sí) y no vio el cast ni el test.
- Úsala para: posts, newsletters, documentación y cualquier texto con tu firma.
npx skills add petergyang/no-ai-slop@no-ai-slop
stop-slop: muchas reglas y mano dura 
- Lo mejor: deja el texto con menos marcas que nadie y su autopuntuación de cinco dimensiones (35/50 para aprobar) obliga a repasar. En código fue la única que encontró el bug.
- Lo peor: reescribe casi todo, cambia títulos (“Aprende TypeScript en 2026”) y se inventa datos para cumplir su regla de voz activa: un Parlamento, unos officials, unos critics y un plazo (“En pocos días verás”).
- Úsala para: borradores tuyos donde no haya datos que proteger, y siempre con una regla extra: “no añadas hechos que no estén en el original”.
npx skills add hardikpandya/stop-slop@stop-slop
unslop: prosa limpia, sin explicaciones 
- Lo mejor: buena mano con el inglés técnico, convierte adornos en datos cuando puede y su regla 27 (“di lo que hace, no cómo se siente”) es de las mejores que hay. Fue la que mejor dejó el texto de Wikipedia (18/25) después de
no-ai-slop. - Lo peor: no entrega informe, así que no sabes qué cambió sin hacer un diff. En código reescribe comentarios en vez de quitarlos y acabó con siete líneas más. Prohíbe los guiones largos y los dos puntos como conector, algo que choca con muchos estilos en español.
- Úsala para: textos técnicos en inglés y como pase final dentro de pstack, que es donde está pensada.
npx skills add cursor/plugins@unslop
deslop: la más corta y la más afinada en código 
- Lo mejor: 120 palabras que van al grano. Compara con el resto del fichero en vez de aplicar una lista, borra comentarios en vez de reescribirlos y deja lo que el repo ya hace igual.
- Lo peor: con prosa no sirve (dio por humanos dos textos de IA) y en código recorta también documentación pública que valía.
- Úsala para: el último paso antes de abrir una PR, sobre el diff de tu rama.
npx skills add brianlovin/agent-config@deslop
anti-slop: reglas deterministas con gusto ajeno 
- Lo mejor: es un linter. Se ejecuta en CI, no depende del humor del modelo y sus reglas están bien documentadas, con ejemplos y límites. La instalación es de manual.
- Lo peor: penaliza código humano perfectamente válido y, si le pides que el código pase, el agente adapta tu estilo al del autor del linter.
- Úsala para: proyectos TypeScript nuevos o equipos que compartan esas preferencias. En un repo con estilo propio, vendoriza las reglas y quita las que no sean tuyas, que es justo lo que recomienda su README.
npx skills add dmmulroy/anti-slop --skill install-anti-slop
Si estás armando tu caja de herramientas de skills, cada domingo te contamos cuáles sobreviven al uso real y cuáles se quedan en el README. Gratis, con más de 7.200 developers dentro.
Apúntate gratis →¿Funcionan las skills anti-slop en español? 
Funcionan, pero con matices. Las cinco están escritas en inglés y sus listas de palabras prohibidas son inglesas (“delve”, “pivotal”, “tapestry”). En español no pescan nada por palabra: el modelo tiene que traducir el patrón, no la palabra.
Lo que sí viaja bien entre idiomas son los patrones de estructura: el “no es X, sino Y”, los tríos, los cierres-resumen, el aforismo final. Los dos textos en español se limpiaron sobre todo por ahí.
Tres cosas a vigilar:
- La puntuación.
unslopystop-slopprohíben el guion largo, yunsloptambién los dos puntos a mitad de frase. Son reglas de estilo, no de slop. Si tu estilo los usa, quítalas de la skill. - El falso negativo. Una skill que no entiende bien el idioma puede declarar humano un texto de IA, como pasó con
deslop. - Tu propia lista. Los tics del español son otros: “en definitiva”, “cabe destacar”, “sin duda”, “un antes y un después”, “en la era de”. Si escribes en español, añade esa lista a la skill que elijas.
🔑 Una skill anti-slop en inglés aplicada a español es como un corrector ortográfico de otro idioma: atrapa la estructura y se le escapa el vocabulario.
¿Cuál instalo yo? 
Depende de qué escribas, pero la prueba deja una combinación bastante clara:
- Para prosa con tu nombre,
no-ai-slop. Es la única que trata la fidelidad como algo sagrado y te devuelve un informe que puedes revisar en un minuto. - Para el código de tu rama,
deslop. Ejecútala sobre el diff antes de la PR. Es corta, barata y lee tu repo. - Para cazar bugs, una revisión aparte. Ninguna skill anti-slop arregló el test roto. El slop y los bugs son problemas distintos, y una skill de estilo no sustituye a una de revisión de código y seguridad.
¿Y si ya usas stop-slop o unslop en un flujo automático? No hace falta tirarlas. Añádeles la regla que les falta, la del checklist de no-ai-slop: no añadir afirmaciones, ejemplos, cifras, citas ni opiniones que no estén en el original. Y pídeles que digan qué cambiaron.
La lección de fondo coincide con el aviso de Wikipedia. Las marcas de IA son síntomas, y la skill que mejor salió en texto no fue la que más palabras cambió: fue la que borró afirmaciones sin respaldo y te avisó de las que no podía comprobar.
TL;DR 
- 🏆 En texto gana
no-ai-slop(67/75): edita lo mínimo, no inventa nada y te dice qué frases necesitan fuente. - 🧹 En código gana
deslop(20/25): 120 palabras que comparan con tu repo y quitan 29 líneas de comentario sin cambiar una sola salida. - 🐛
stop-slopfue la única que vio el test roto de la IA, pero en texto se inventó un Parlamento para cumplir su regla de voz activa. - 📏
anti-slopes un linter: el código humano devercel/msya suspendía 34 de sus reglas antes de que la IA tocara nada. - 🇪🇸 Todas están en inglés: en español atrapan la estructura (contrastes, tríos, cierres) y se les escapa el vocabulario.
Preguntas frecuentes 
¿Qué es una skill anti-slop? 
Es una skill para agentes de IA (un SKILL.md que cargan Claude Code, Codex, Cursor y otros) con instrucciones para detectar y quitar los patrones típicos del texto o el código generado por IA. Algunas trabajan sobre prosa, otras sobre el diff de una rama y otras, como anti-slop, instalan un linter.
¿Cuál es la mejor skill para quitar el slop de un texto? 
En nuestra prueba, no-ai-slop de Peter Yang, con 67 de 75 puntos frente a 49 de la segunda. Su ventaja está en que no inventa datos y entrega un informe con lo que cambió y lo que necesita fuente.
¿Cuál es la mejor skill para limpiar código generado por IA? 
deslop de Brian Lovin, con 20 de 25. Compara el diff de tu rama con el estilo del resto del fichero, quita comentarios innecesarios y casts, y deja lo que el repo ya hace igual.
¿Las skills anti-slop pueden romper el código? 
En nuestra prueba, ninguna lo hizo: las cinco compilaron con tsc y devolvieron lo mismo en una batería de 50 entradas. El riesgo real está en la documentación, porque alguna recortó JSDoc público que valía.
¿Una skill anti-slop encuentra bugs? 
No es su trabajo. De cinco, solo stop-slop detectó un test incorrecto, como efecto secundario de leer cada línea, y ninguna lo arregló. Para bugs necesitas tests, revisión o una skill de code review.
¿Por qué stop-slop se inventa datos? 
Por su regla de voz activa: “Every sentence needs a human subject doing something”. Cuando una frase pasiva no dice quién hizo algo, el modelo rellena el hueco. Se arregla añadiendo a la skill una regla explícita contra añadir hechos.
¿Funcionan estas skills con textos en español? 
Sí, con matices. Detectan bien los patrones de estructura (contrastes, tríos, cierres), pero sus listas de palabras son inglesas. Conviene añadir los tics del español y quitar las reglas de puntuación que no encajen con tu estilo.
¿Qué diferencia hay entre unslop y deslop? 
unslop (del plugin pstack de Cursor) edita prosa con 28 reglas numeradas. deslop limpia el código que tu rama añade frente a main. Son complementarias: una para el texto, otra para el código.
¿anti-slop es una skill o un linter? 
Las dos cosas. anti-slop es un conjunto de reglas de Oxlint para TypeScript, y su skill install-anti-slop las instala y configura en tu repo. Las reglas reflejan el gusto de su autor, así que revísalas antes de activarlas todas.
¿Cómo instalo estas skills? 
Con el CLI de skills.sh: npx skills add <repo>@<skill>. Por ejemplo, npx skills add petergyang/no-ai-slop@no-ai-slop o npx skills add brianlovin/agent-config@deslop. El CLI detecta tu agente y copia la skill en su carpeta.
Fuentes 
- unslop, SKILL.md en cursor/plugins (pstack)
- deslop, SKILL.md en brianlovin/agent-config
- no-ai-slop de Peter Yang en skills.sh
- stop-slop de Hardik Pandya
- anti-slop de Dillon Mulroy
- humanizer de blader
- Wikipedia: Signs of AI writing (WikiProject AI Cleanup)
- Reinhart et al., “Do LLMs write like humans?”, PNAS, 2025
- vercel/ms en GitHub
- skills.sh, directorio de Agent Skills
🧨 Última oprtunidad para recibir la dinamita que mereces sobre programación con IA el próximo domingo: Suscríbete gratis a Web Reactiva en https://webreactiva.com/newsletter

Escrito con la ayuda de la IA generativa de Claude, fuentes fidedignas y con un human in the loop:
Dani Primo.
12 recursos para developers cada domingo en tu bandeja de entrada
Además de una skill práctica bien explicada, trucos para mejorar tu futuro profesional y una pizquita de humor útil para el resto de la semana. Gratis.