Cómo enviar 2.500 PRs en un mes gracias a la IA
Tabla de contenidos
📺 Este artículo es un resumen de la charla en vídeo que Lauren Tan (poteto) publicó en X.
Más de 2.000 pull requests a producción en un mes. Una sola persona.
Lo cuenta Lauren Tan (poteto en X), que forma parte del core team del compilador de React, pasó por Netflix, Meta y Cursor y hoy construye Grokbot en SpaceX AI. La charla iba a ser para Cursor Compile en Londres, no pudo ir y la colgó entera en X. En el tuit habla de 2.500 PRs. En el vídeo dice 2.000. En una de sus diapositivas pone “más de 5.000 PRs en 6 meses”.
La cifra exacta da igual. Lo que importa es que no la persiguió. “Nunca me propuse enviar 2.000 PRs al mes”, dice. Fue la consecuencia de otra cosa, y esa otra cosa tiene nombre: confianza.
En 38 minutos, poteto explica cómo prepara su entorno para fiarse de lo que hace un agente cuando ella no está mirando. Es la parte aburrida del trabajo con agentes, y la que te deja dormir tranquilo.
Esto es lo que vas a sacar de aquí:
- La curva de confianza que explica por qué te atascas con 1 a 5 agentes.
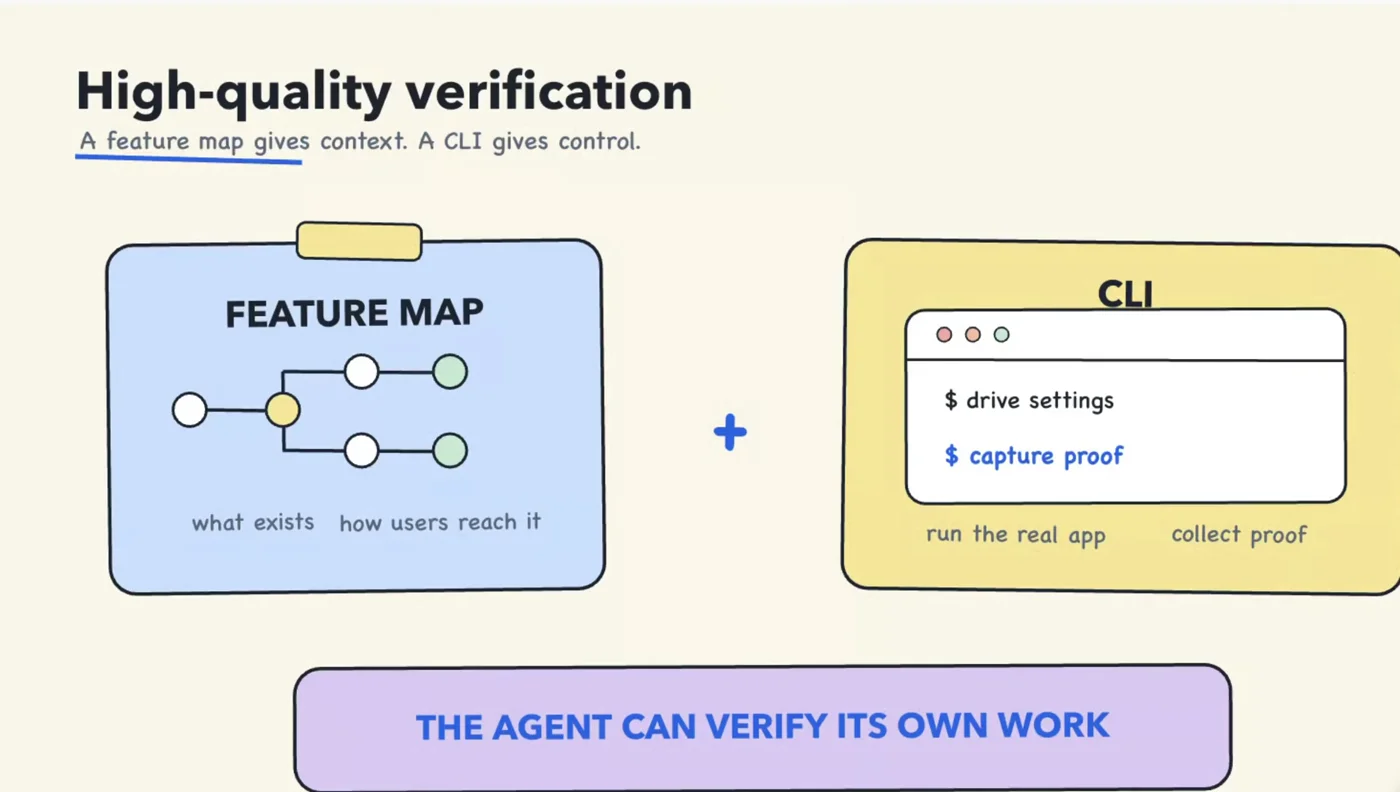
- Cómo son las skills de verificación que usaba su equipo: un CLI y un feature map.
- La jerarquía de cinco niveles para decidir dónde arreglar un error del agente.
- Por qué en su framework prohibieron los comentarios en el código.
- El papel del jardinero en un equipo que programa con agentes.
¿Qué contó poteto en su charla de los 2.500 PRs? 
La tesis cabe en una frase: si preparas muy bien el entorno de tus agentes, acabas con algo parecido a una fábrica de software personal o de equipo, que produce código de calidad a un ritmo que antes no era posible.
A ella no le gusta el término “fábrica de software”. Prefiere otra imagen: una cocina con estrella Michelin.
En una fábrica produces en serie, en una cadena de montaje. En una cocina de alta gama el trabajo es creativo, hay oficio, hay algo de arte. Con agentes ya no cocinas cada ingrediente tú, pero sigues siendo responsable del plato que sale por la puerta. Y lo que decide si ese plato sale bien es cómo montas la cocina: qué formación tienen los cocineros de línea, qué equipo tienen a mano, cuántos friegaplatos hay por cocinero.
Me gusta la analogía porque pone el foco donde toca. No en el cocinero estrella que lo hace todo, sino en el sistema que permite que cualquiera que entre en la cocina haga un buen trabajo.
🔑 La productividad de poteto no viene de lanzar más agentes. Viene de haber construido un entorno en el que puede confiar en ellos.
Si ya has leído nuestro repaso a las skills de pstack para Cursor, conoces su método de trabajo con agentes skill por skill. Esta charla es la otra mitad: el porqué de todo eso y cómo encaja con la arquitectura del código.
¿Por qué se atasca casi todo el mundo entre 1 y 5 agentes? 
Porque no se fía de lo que hacen. Esa es la respuesta directa de poteto, y la explica con un gráfico muy sencillo: en el eje vertical, la confianza; en el horizontal, el número de agentes que trabajan a la vez.
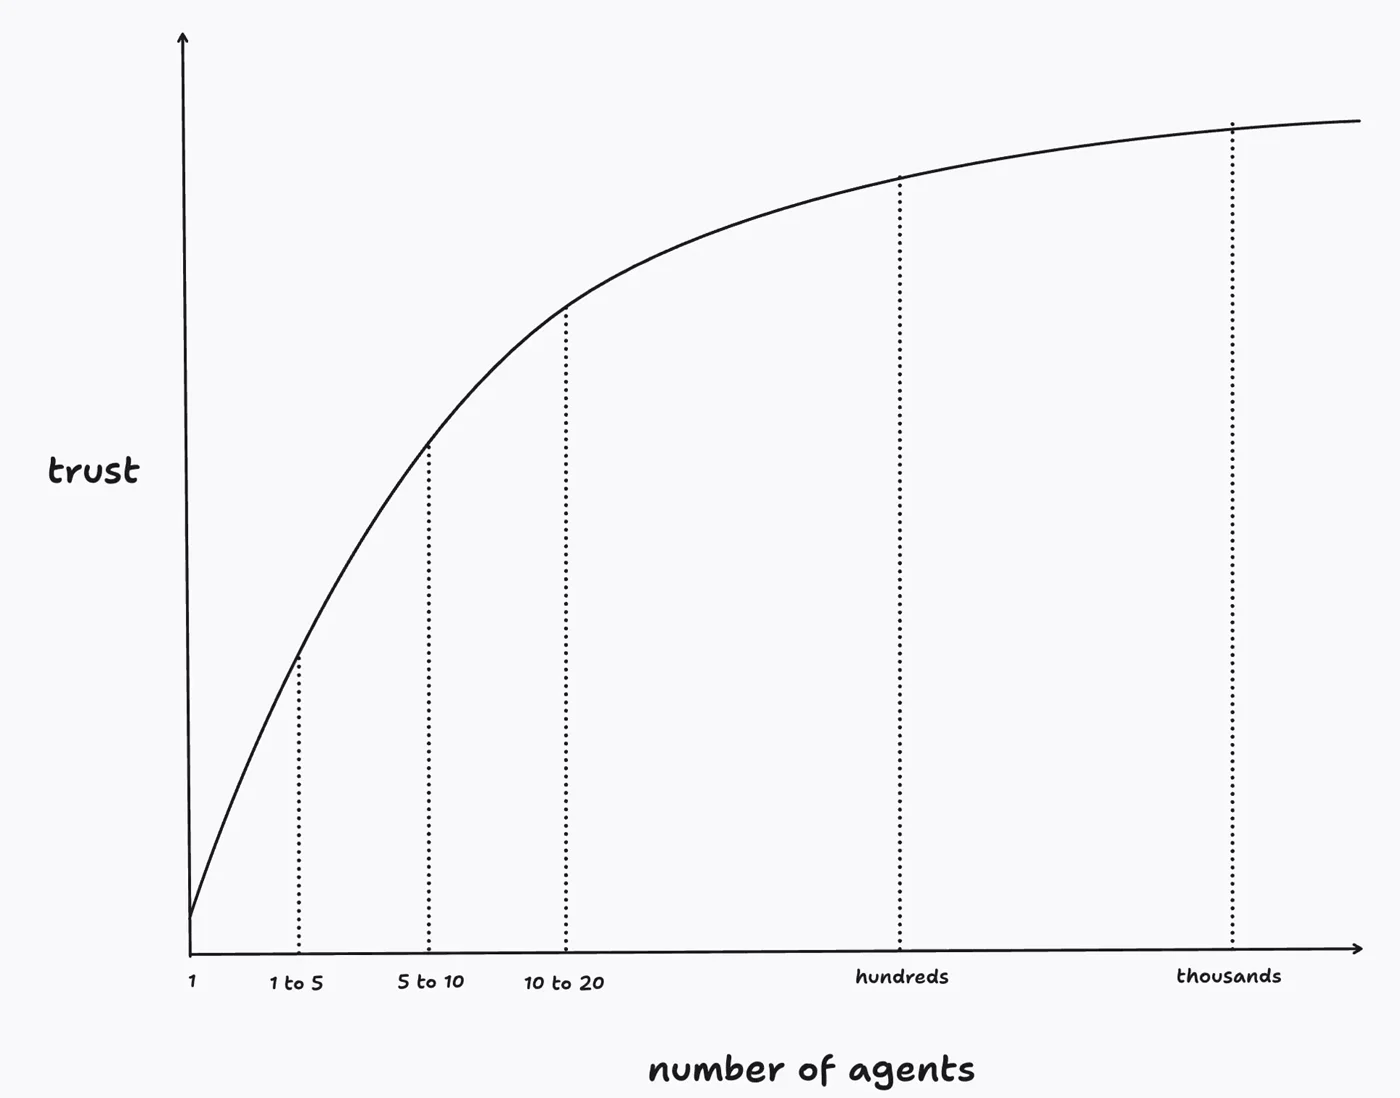
En el tramo de 1 a 5 agentes estás de niñera. Tienes que vigilar cada conversación, corregir el rumbo cada dos por tres, intervenir. Si te levantas de la silla, no pasa nada útil, o peor, el agente hace lo que no debía.
Ella misma empezó ahí. Y defiende algo que a mí me parece muy honesto: esa fase es la más difícil de abandonar, porque nadie te dice cómo salir de ella.
¿Qué pasa si te saltas el paso y lanzas cien subagentes o agentes en la nube sin haber construido esa confianza?
Pues que te llueven PRs de slop, regresiones y bugs en producción. Y nadie en tu equipo va a estar contento.
No es un problema solo de poteto. En la encuesta de Stack Overflow de 2025, más desarrolladores desconfían de la precisión de las herramientas de IA (46 %) que los que confían en ella (33 %). La desconfianza existe. La pregunta es qué haces con ella: ¿te quedas vigilando o construyes algo que te permita dejar de vigilar?
¿Cómo empezó todo? Una historia de rendimiento y trazas a mano 
La historia arranca seis meses antes de la charla, cuando poteto entra en Cursor. Base de código nueva, producto nuevo, ninguna skill propia. El equipo estaba construyendo la ventana de agentes que sustituiría al IDE clásico, y esa ventana tenía problemas de rendimiento.
Como venía del equipo de React, le pidieron ayuda. Y se encontró con un muro: un flujo de PRs que no paraba de crecer y ninguna forma de saber si el rendimiento empeoraba con cada uno.
Así que se pasaba el día en Chrome DevTools. Trazas de rendimiento, heap snapshots, análisis a mano. Tanto trabajo manual que llegó a frustrarse y a pensar lo obvio: “Espera, si tenemos agentes, ¿qué estoy haciendo?”.
De ahí salió la idea que lo cambió todo. ¿Y si el agente pudiera arrancar la aplicación, tomar las trazas, entenderlas, encontrar los puntos calientes e ir mejorando el rendimiento por su cuenta?
Lo que ella describe como hill climbing: el agente propone un cambio, mide, se queda con lo que mejora y vuelve a probar. Es la misma lógica que contamos en cómo hacer hillclimb de una skill con evaluaciones, pero aplicada a métricas de rendimiento de una aplicación real.
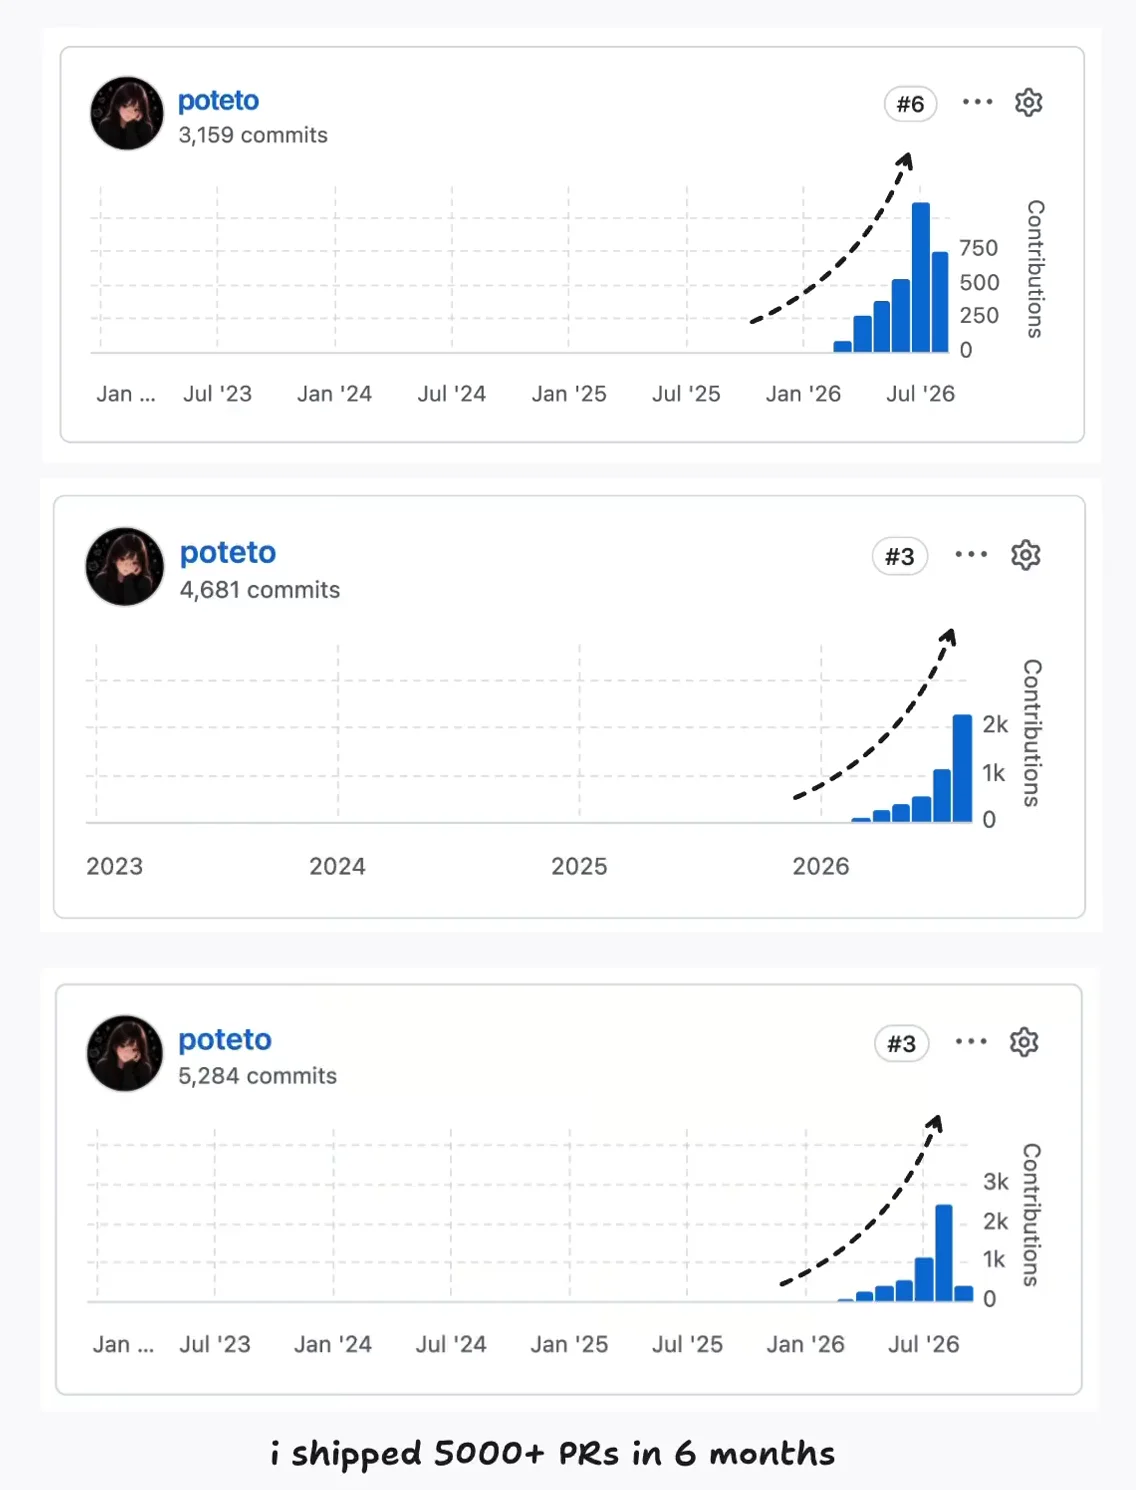
Las gráficas de contribuciones que enseña son bastante elocuentes: tres repositorios, miles de commits en cada uno, y todo concentrado en 2026. Ella misma reconoce que entonces no sabía que todo lo que estaba haciendo apuntaba a lo mismo. Pero tenía una idea rondando: yo soy el cuello de botella. Necesitaba volcar lo que sabía como ingeniera en su equipo de agentes para dejar de ser quien lo bloqueaba todo.
Pasar de vigilar agentes a fiarte de ellos es justo el cambio que estamos viviendo. Cada domingo, +7.200 developers comparten en la newsletter cómo lo están haciendo en su día a día.
Quiero esa dinamita 🧨¿Cómo confías más en tus agentes? 
Con tres palancas, según la diapositiva central de la charla:
- Verificación para asegurar que el código es correcto.
- Skills de calidad que enseñen a los agentes a trabajar como ingenieros de software de verdad (y aquí cita su plugin, pstack).
- Refactorizar o reescribir la arquitectura para que sea amigable con los agentes.
Al lado de la tercera apunta una nota pequeña: greenfield vs brownfield. No es lo mismo diseñar un proyecto nuevo pensando en agentes que reconvertir uno con años de historia. Lo segundo es más duro, pero también es donde más se nota.
Vamos una por una.
Para fiarte del agente, primero dile qué tiene que construir
Antes de verificar el resultado necesitas una intención escrita. En el curso recorres el ciclo completo de SDD con OpenSpec sobre un proyecto real: proposal, spec, diseño y tareas antes de que el agente toque el código.
Entra en el curso gratis →¿Qué es una skill de verificación y qué tiene dentro? 
Una skill de verificación es una skill que enseña al agente a ejecutar tu aplicación y a recoger pruebas empíricas de que el código funciona. No “creo que funciona porque compila”, sino “lo he ejecutado y aquí tienes la traza, la captura o el número”.
poteto habla de niveles de verificación. En el extremo más accesible están estas skills. En el otro, la verificación formal: lenguajes como Lean o TLA+ para demostrar que las invariantes de tu lógica de negocio siempre se cumplen. Ella misma lo deja claro: eso sigue siendo una pregunta abierta y muy poca gente lo hace. Con skills de verificación se llega muy lejos.
La primera skill que montó en Cursor se llamaba algo como Control Glass (así suena en la charla). Usaba el Chrome DevTools Protocol para arrancar la aplicación y capturar trazas. Y tras varias iteraciones acabó con dos piezas.
Pieza 1: un CLI dentro de la skill 
Si cada agente se inventa su propio script para arrancar la app y medir, cada sesión hace una cosa distinta. Los resultados no son comparables y los fallos no son reproducibles.
La solución es meter un CLI en el propio directorio de la skill. El agente lo usa siempre, y el equipo invierte en que sea bueno: que cubra muchos casos, que arranque bien la aplicación, que recoja las pruebas que importan.
Pieza 2: un feature map 
Esta es la idea que más me ha gustado de toda la charla.
El problema apareció cuando empezaron a usar estas skills de verdad. Llegaba un aviso por Slack con una captura diminuta de la interfaz y tres signos de interrogación. El agente podía arrancar la aplicación, sí, pero no tenía ni idea de qué estaba mirando el usuario. Iba a ciegas.
El feature map es algo parecido a un sitemap, pero de funcionalidades. Una forma de memoria materializada: qué funcionalidades tiene la aplicación, cómo llega el usuario a cada una (atajos de teclado, qué elementos del DOM pulsar) y qué hace cada una. Vive dentro de la carpeta de la skill, en el repositorio, y una automatización lo mantiene al día.
Con el CLI, el agente puede manejar la aplicación. Con el feature map, puede entender lo que le piden. Juntos, el agente es capaz de reproducir un aviso vago de un usuario interno o externo sin que nadie le explique nada.
💡 Según poteto, estas skills de verificación se volvieron tan útiles que pasaron a ser infraestructura crítica del equipo, con mantenimiento continuo.
Si quieres montar algo parecido, en pstack existe /create-verification-skill, que genera justo esta estructura para tu proyecto. Y aunque no uses Cursor, la idea se traslada a cualquier agente con acceso a un navegador o a la terminal.
¿Verificar que funciona es suficiente? 
No. La verificación te dice si el código es correcto, no si es bueno.
poteto separa las dos cosas con un ejemplo de andar por casa: la verificación responde a “¿el botón de pagar paga de verdad?”. Pero no te dice nada de cómo de rápido es, de cómo está escrito o de si mañana alguien va a poder mantenerlo.
Para eso están las skills que enseñan al agente a trabajar como un ingeniero con oficio. En su caso, pstack: una colección de skills y playbooks para depurar, desarrollar funcionalidades o prototipar, sacados de cómo trabaja ella. No entra en detalle durante la charla (para eso tienes nuestro recorrido por pstack), pero sí deja una idea para equipos:
Los ingenieros con más experiencia son los que más pueden aportar a un repositorio de skills compartido. Su criterio, escrito en una skill, hace más listos a todos los agentes del equipo.
Y cuando combinas esas skills de calidad con las de verificación, el agente puede demostrar que el trabajo funciona y además medirlo. Métricas de rendimiento reales, telemetría, números. Nada de “debería ir rápido”.
¿Dónde corriges un error de tu agente? 
Esta es, según la propia poteto, la diapositiva con la que te tienes que quedar si solo recuerdas una. Cada vez que corriges a tu agente, tienes cinco sitios donde puedes arreglar el problema, y el orden importa:
- El código base (codebase)
- Análisis estático: linters, diagnósticos del compilador, CI
- Rules y Bugbot
- Skills
- La guía de estilo
Cuanto más arriba, más difícil que el error se repita. Cuanto más abajo, más depende de que alguien (persona o agente) se acuerde.
| Nivel | Tipo de control | Qué pasa si el agente lo ignora | Coste de mantenerlo |
|---|---|---|---|
| Código base | El error es imposible de escribir | No puede ignorarlo | Alto al principio, bajo después |
| Análisis estático | Restricción que bloquea | El CI falla | Medio |
| Rules / Bugbot | Guía con revisión automática | A veces se escapa | Bajo |
| Skills | Guía que se carga cuando toca | A veces no la lee | Bajo |
| Guía de estilo | Solo lo hace cumplir una persona | Se cuela casi siempre | Muy alto con muchos PRs |
El código base es la mejor memoria 
Los agentes extienden los patrones que ven. Es la naturaleza de un LLM: usa lo que tiene en su ventana de contexto, y los ficheros que lee forman parte de ese contexto. Un agente no va a refactorizar tu código en cada PR. Va a mirar lo que hay y a copiarlo.
Por eso el primer sitio donde arreglar un error es el propio código. Y el ideal no es documentar el error, es hacerlo categóricamente imposible: mejores estructuras de datos, mejores tipos, mejores algoritmos.
Análisis estático: si se repite, regla de lint 
Si corriges al agente y vuelve a cometer el mismo fallo, conviértelo en una regla de lint o en un chequeo de CI. Eso ya no es una sugerencia, es una barrera.
Rules, Bugbot y skills: guía, no obligación 
Aquí entramos en el terreno de la orientación. Son útiles y los agentes los usan casi siempre, pero no siempre. A veces el agente no lee la regla. A veces la persona que lo pilota la ignora. Por eso van después de lo que se puede imponer.
La guía de estilo: el agujero 
Si una convención solo vive en la cabeza de quien revisa, tienes un problema serio. Alguien tiene que leer cada línea y acordarse de comentar. Con el ritmo de PRs que generan los agentes, eso es imposible.
poteto no dice que tires la revisión humana. Dice que la uses para descubrir qué te falta en los otros cuatro niveles. Cada comentario repetido en una revisión es una regla de lint o una skill que aún no has escrito.
🛡️ Antes de añadir otra línea a tu
AGENTS.md, pregúntate si ese error se podría hacer imposible en el código o detectar con un linter. Una regla escrita se puede ignorar. Un tipo que no compila, no.
Esta idea conecta con lo que llevamos tiempo contando sobre harness engineering: el arnés del agente no es solo el prompt y las herramientas, también es el propio repositorio.
Tu IA puede mentirte
Monta tu propia capa de verificación sin esperar a tener un Dune
Vas a ver cómo pasar del 'creo que funciona' a las pruebas: skills de verificación, tests en navegador con Playwright, casos Gherkin y adversarial review entre modelos.
Entrar a la masterclass →Métodos en directo + casos Gherkin
¿Qué es Dune, el framework diseñado para agentes? 
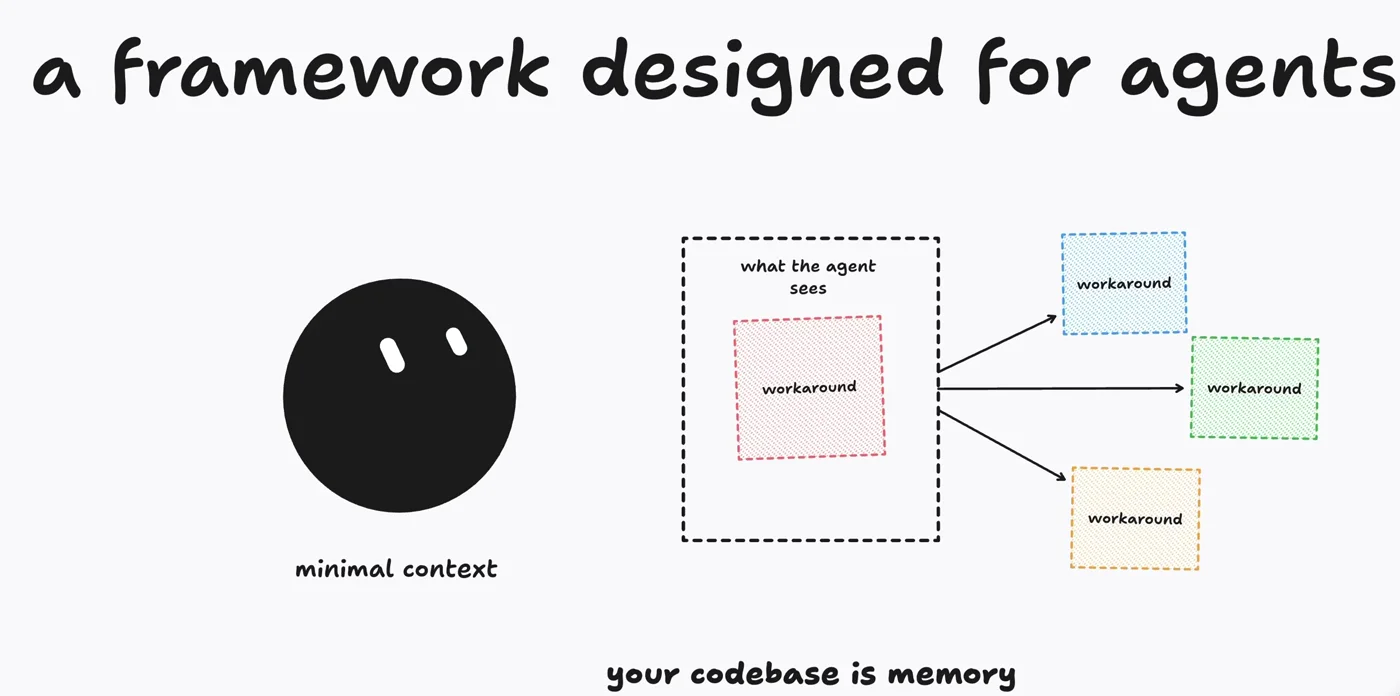
Dune es el framework de cliente que su equipo construyó para Grokbot, pensado para que el camino fácil sea el camino correcto. Nació de los problemas de rendimiento que vieron en la ventana de agentes de Cursor, y parte de un principio que cualquiera que haya trabajado con agentes reconocerá:
A los agentes les encantan los atajos.
Entonces, ¿por qué no diseñar el framework para que el atajo sea lo correcto?
El resultado, en palabras de poteto, es un código base “bastante molesto para los humanos”, porque está muy cerrado: hay muy pocas formas de hacer cada cosa. Pero es el entorno perfecto para agentes, sobre todo para los que trabajan con poco contexto.
Piensa en quién abre PRs hoy en tu empresa. Ya no todo el que contribuye a un código base es ingeniero. Diseñadores, product managers, incluso el CEO, entran a enviar funcionalidades a través de un agente. La pregunta es cómo montar el código para que un agente pilotado por alguien con prisa y poco contexto haga un buen trabajo por defecto.
Un ejemplo concreto: fronteras entre procesos 
En Dune hay convenciones estrictas sobre dónde vive cada cosa y qué se puede importar desde dónde. Las funcionalidades van en una sola carpeta. Hay un punto de entrada parecido a una ruta, componentes para la interfaz, un host que se ejecuta en la máquina virtual de Grokbot y un cliente que lo une todo.
El ejemplo que pone es el de Electron. El código del proceso principal no puede acabar en el hilo de renderizado. En Cursor vieron cómo se colaba código lento en el renderer por un import descuidado, y eso se nota: para ir a 60 fotogramas por segundo cada tarea tiene que durar menos de 16 milisegundos, y a 120 fps, menos de 8.
En Dune esa frontera se hace cumplir a través del grafo de dependencias de imports. Si un import cruza la frontera, el build falla.
🔑 Dune en sí no es lo importante (ella misma lo dice). Lo importante es que un framework propio pensado para agentes puede codificar el conocimiento tribal de tus mejores ingenieros, ese que antes solo vivía en los comentarios de las revisiones de código.
Si te interesa cómo afecta esto a decisiones concretas de stack, lo vimos con un caso real en StyleX vs Tailwind cuando programa la IA.
¿Por qué prohibieron los comentarios en el código? 
Porque los agentes usaban los comentarios como excusa para no arreglar el problema de verdad.
Es el ejemplo más llamativo de la charla, y el que más me ha hecho pensar.
Al principio, a poteto no le parecía mal que los agentes dejaran comentarios. Muchos eran slop, sí, pero los humanos también comentamos: casos límite, apaños, notas para un compañero en una parte delicada del código. ¿Qué hay de malo?
Lo que vieron en el código de Cursor fue esto: un agente encontraba un comentario explicando un apaño y lo tomaba como justificación para no resolver el problema real. En su lugar, ponía otra tirita.
Y aquí entra el efecto virus.
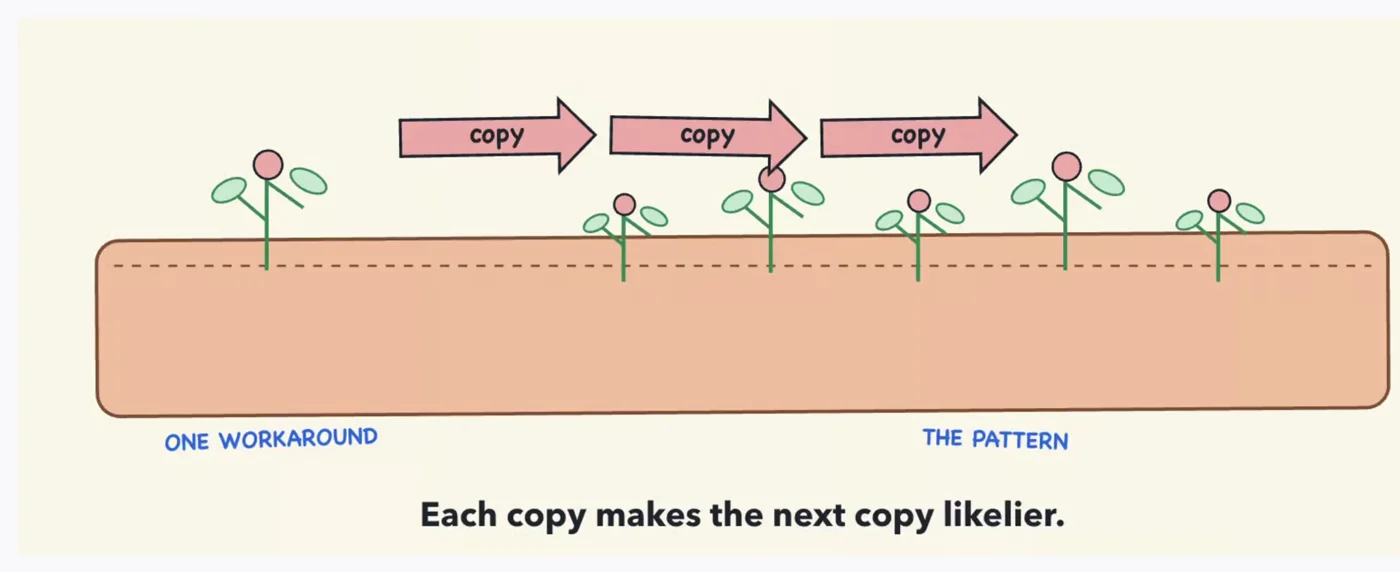
Un pequeño apaño, o un comentario que lo explica, se copia. En unos días o semanas, ese apaño está por todas partes y se ha convertido en el patrón de facto para todos los agentes. Cada copia hace más probable la siguiente.
Al revés también funciona, y esa es la buena noticia: si el código está limpio y los malos patrones son imposibles, los agentes copian lo bueno.
En Dune decidieron prohibir los comentarios para cortar ese contagio de raíz. Es una medida radical, y no digo que la copies tal cual en tu proyecto. Pero la pregunta de fondo sí merece que te la hagas: ¿qué patrón de tu código no te gustaría ver multiplicado por cien?
Porque eso es justo lo que va a pasar.
Si te ha tocado limpiar un apaño que un agente copió por medio proyecto, no eres el único. Cada domingo seleccionamos 12 recursos sobre programar con IA, gratis desde 2018.
Apúntate gratis →¿Necesita tu equipo un jardinero? 
Según poteto, sí. Propone un rol nuevo: el jardinero, alguien que vigila lo que crece donde no debe y lo corta antes de que se extienda.
Ella misma admite que de jardinería sabe poco (lo cual le da bastante gracia a la metáfora), pero la idea se entiende. Malas hierbas, plagas, crecimientos que no quieres. Un código base trabajado por agentes es un huerto que crece muy deprisa, en la dirección buena y en la mala.
El trabajo del jardinero sigue tres pasos:
- Eliminar la deuda técnica que ya existe, porque los agentes la van a copiar.
- Mantener un único camino pavimentado para cada cosa. Una forma convencional de hacerlo, con suficiente guía en el código, en el CI y en las reglas de lint para que el agente no tenga que adivinar.
- Escribir una regla de lint contra cada antipatrón que veas. No hace falta limpiarlo todo en el momento. La regla al menos detiene la hemorragia y evita que crezca mientras planificas la limpieza.
La mentalidad que recomienda es mantener el código siempre en un estado en el que te alegraría que un agente lo copiara.
Si alguna vez has visto cómo un // TODO: hack temporal sobrevive cinco años y se reproduce por todo el proyecto, ya sabes de qué va esto. Con agentes, esos cinco años se convierten en dos semanas.
¿Qué es el bucle externo y por qué no necesitas un “cerebro de empresa”? 
El bucle externo es todo lo que pasa fuera del editor y que puede disparar trabajo de agentes: avisos de Slack, alertas de Sentry, métricas de Datadog, eventos de la base de datos. poteto lo cuenta desde Grokbot, que se conecta a esos servicios, agrega la información y decide qué hacer.
Hay quien habla de montar un “cerebro de empresa” para esto. Ella no lo ve necesario. Los agentes son muy buenos usando herramientas, así que basta con conectarlos a las que ya usas y dejar que disparen agentes en la nube cuando toque.
Las piezas que menciona:
- Rutinas de Grokbot, que se suscriben a hilos de Slack o alertas de Sentry y arrancan trabajo de forma automática.
- Agentes en la nube que reciben esas tareas.
- Automatizaciones de Cursor y su SDK para montar bots adicionales que reutilizan las skills, reglas y código base que ya has preparado.
Todas estas piezas se acumulan. El código base limpio, las reglas, las skills de verificación, el feature map. Cada pieza hace más fiables a las demás. En su equipo, las automatizaciones reproducen bugs reportados y abren PRs solas.
Esto no es exclusivo de Grokbot ni de Cursor. Si trabajas con Claude Code, la idea equivalente son las rutinas de Claude Code, y la arquitectura de fondo la tienes en nuestro post sobre agent loops.
¿Qué puedes aplicar mañana si no trabajas en SpaceX AI? 
Bastante más de lo que parece. No necesitas un framework propio ni miles de agentes. Necesitas cambiar un hábito: cada corrección a tu agente es una oportunidad de que no vuelva a pasar.
Un plan de mínimos para esta semana:
- Apunta cada vez que corrijas a tu agente. Solo eso, durante tres o cuatro días.
- Clasifica cada corrección según los cinco niveles. ¿Se podría hacer imposible en el código? ¿Detectar con un linter? ¿Necesita una regla o una skill?
- Empieza por arriba. Si algo se puede resolver con un tipo o con una regla de ESLint, hazlo antes de escribirlo en el
AGENTS.md. - Monta una skill de verificación mínima: un script que arranque tu app y capture una prueba (una captura, un log, un número). Que el agente use siempre el mismo.
- Busca tu primer “virus”: un apaño que se haya copiado varias veces. Escribe una regla de lint contra él.
| Situación | Dónde actuar primero | Ejemplo |
|---|---|---|
| El agente importa algo prohibido | Análisis estático | Regla de lint de imports restringidos |
| El agente usa un tipo mal | Código base | Tipos más estrictos que no compilan |
| El agente no sigue un flujo de trabajo | Skills | Skill de depuración o de PR |
| El agente dice que funciona y no funciona | Verificación | CLI que arranca la app y captura pruebas |
| El agente repite un apaño | Jardinería | Borrar el apaño + regla contra él |
⚠️ Cuidado con el efecto contrario: un código base tan cerrado que tu equipo humano no quiere tocarlo. poteto lo asume como coste en Grokbot porque allí casi todo el código lo escriben agentes. En tu proyecto, el equilibrio puede ser otro.
¿Qué le falta a la charla? 
La charla es de una persona que trabaja con muchos recursos, en una empresa donde los agentes son el producto. Hay cosas que no cuenta.
No habla de costes. Miles de PRs con agentes en la nube no salen gratis, y no da cifras.
Tampoco entra en cuánto tiempo llevó montar todo esto. Dice al final que no hay secreto, que es “mucho trabajo duro”. Te lo crees, pero no sabes si son semanas o meses de equipo.
Y la cifra de PRs es difícil de interpretar sin saber su tamaño. 2.000 PRs pequeños y bien acotados son una señal de buena ingeniería (PRs que se revisan y se revierten fácil). No es lo mismo que 2.000 PRs gigantes.
Nada de eso quita valor a las ideas. La jerarquía de cinco niveles, el feature map y la regla de “lint contra cada antipatrón” sirven igual en un equipo de tres personas que en uno de trescientas.
TL;DR 
- 🚀 poteto envió más de 2.000 PRs en un mes, y lo atribuye a la confianza en sus agentes, no a usar más agentes.
- 🔧 Sus skills de verificación tienen dos piezas: un CLI para manejar la app real y un feature map que explica qué hay y cómo llegar.
- 🎯 Cuando corriges a un agente, arregla en este orden: código base, análisis estático, rules/Bugbot, skills y guía de estilo.
- 🦠 Los agentes copian lo que ven: un apaño se convierte en patrón. Por eso en Dune prohibieron los comentarios.
- 🌱 Tu equipo necesita un jardinero: borra deuda, mantén un único camino y escribe una regla de lint contra cada antipatrón.
Preguntas frecuentes 
¿Quién es poteto? 
Es Lauren Tan, conocida como poteto en X y GitHub. Es parte del core team del compilador de React, trabajó en Netflix y Meta, después en Cursor en la ventana de agentes, y ahora trabaja en Grokbot en SpaceX AI. Es la autora de pstack, un plugin de skills para Cursor.
¿Cuántos PRs envió poteto con agentes? 
En el tuit habla de 2.500 PRs en un mes y en la charla de 2.000. Una de sus diapositivas muestra más de 5.000 PRs en seis meses, repartidos en varios repositorios. Ella insiste en que el número no era un objetivo, sino una consecuencia.
¿Qué es la curva de confianza en agentes de IA? 
Es un gráfico que relaciona la confianza que tienes en tus agentes con cuántos puedes tener trabajando a la vez. Con poca confianza te quedas en 1 a 5 agentes y los vigilas de cerca. Para pasar a decenas o cientos necesitas verificación, buenas skills y un código base preparado.
¿Qué es una skill de verificación? 
Es una skill que enseña al agente a ejecutar tu aplicación y recoger pruebas de que el código funciona: trazas, capturas, métricas. En el caso de poteto incluye un CLI propio dentro de la skill y un feature map, y usa Chrome DevTools Protocol para controlar la aplicación.
¿Qué es un feature map para agentes? 
Es un documento dentro de la skill de verificación que describe qué funcionalidades tiene la aplicación, cómo llega el usuario a cada una (atajos, elementos del DOM) y qué hacen. Funciona como memoria materializada para que el agente entienda avisos vagos de usuarios. En el equipo de poteto lo mantiene al día una automatización.
¿Dónde debo corregir los errores de mi agente de código? 
poteto propone cinco niveles en orden: el código base (hacer el error imposible), el análisis estático (linters, compilador, CI), rules y Bugbot, skills y, por último, la guía de estilo. Cuanto más arriba lo resuelves, menos probable es que se repita.
¿Por qué el código base es la mejor memoria para un agente? 
Porque los agentes extienden los patrones que ven en los ficheros que leen, que forman parte de su contexto. Un agente no refactoriza en cada PR: copia lo que hay. Si el código es bueno, copia lo bueno, y si tiene apaños, los multiplica.
¿Qué es Dune, el framework de Grokbot? 
Es el framework de cliente que el equipo de poteto creó para Grokbot. Está diseñado para que el camino fácil sea el correcto: convenciones estrictas, fronteras entre procesos impuestas por el grafo de imports y comentarios prohibidos. Es incómodo para humanos, pero ideal para agentes con poco contexto.
¿Por qué prohibir los comentarios en el código con agentes? 
Porque los agentes usaban los comentarios que explicaban un apaño como justificación para no resolver el problema real y añadir otro apaño. Ese patrón se copiaba y se extendía por el código. Prohibirlos en Dune corta ese contagio de raíz.
¿Qué hace un jardinero en un equipo que programa con agentes? 
Vigila los patrones que se extienden sin control. Elimina la deuda técnica existente, mantiene un único camino para cada cosa y escribe reglas de lint contra cada antipatrón para detener su crecimiento. El objetivo es que el código esté siempre en un estado que te gustaría ver copiado.
Fuentes 
- Charla de poteto en X: “here’s how i shipped 2,500 PRs last month to production”
- pstack en el repositorio de plugins de Cursor
- Stack Overflow Developer Survey 2025: AI
🧨 Última oprtunidad para recibir la dinamita que mereces sobre programación con IA el próximo domingo: Suscríbete gratis a Web Reactiva en https://webreactiva.com/newsletter

Escrito con la ayuda de la IA generativa de Claude, fuentes fidedignas y con un human in the loop:
Dani Primo.
12 recursos para developers cada domingo en tu bandeja de entrada
Además de una skill práctica bien explicada, trucos para mejorar tu futuro profesional y una pizquita de humor útil para el resto de la semana. Gratis.