Uncle Bob y la IA: qué cambió y qué puedes copiarle
Tabla de contenidos
En diciembre de 2025, el autor de Clean Code decía que había que tratar a un agente de IA como a un párvulo.
En septiembre de 2026 contaba que uno le había soltado: «No, eso es una tontería, no se puede hacer. Te explico por qué». Y que el agente tenía razón.
Robert C. Martin, Uncle Bob para casi todo el gremio, lleva programando desde los años 60. En estos once meses ha ido publicando su cambio de opinión casi en directo, con vídeos en albornoz incluidos. Se ha equivocado en público, ha construido una fábrica de agentes y la ha desmontado.
Decir que «se ha pasado a la IA» se queda corto. Mira qué ha soltado y a qué no ha renunciado, porque ahí hay decisiones que te afectan a ti, aunque no pienses dejar de leer código mañana.
En este artículo vas a encontrar:
- La evolución completa, contada con sus propios tuits y vídeos
- Por qué dejó de leer el código de sus agentes y qué puso en su lugar
- El experimento que le hizo abandonar su propio harness
- Seis prácticas de su trabajo que puedes copiar esta semana
- Dónde conviene frenar antes de seguirle a ciegas
La evolución completa en once líneas 
Si solo tienes un minuto, quédate con este git log. Cada línea es una publicación real y fechada. El tipo de commit es cosa mía, y el resumen también.
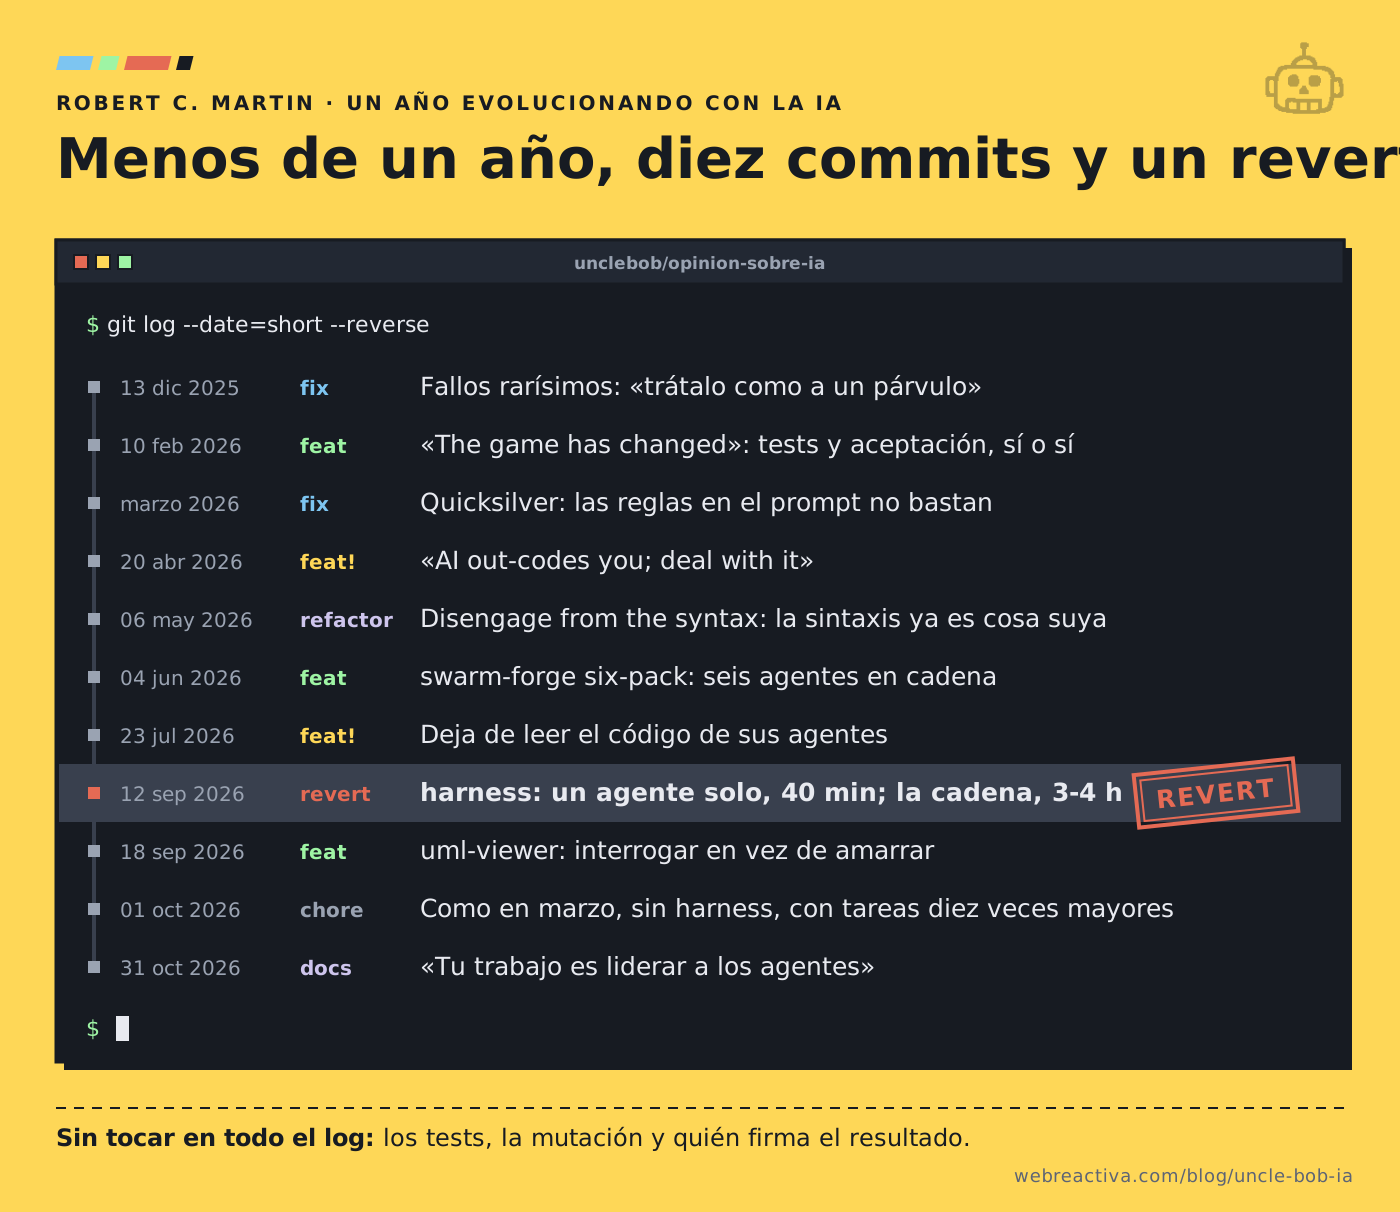
Hay tres cambios de mentalidad dentro de ese log:
- Sobre la capacidad de la IA: de «no es fiable» a «programa más que yo».
- Sobre su papel: de revisar cada línea a supervisar la arquitectura y el comportamiento.
- Sobre la autonomía: de controlar cada paso a dejar que un agente competente proponga y le lleve la contraria.
Mucha gente ya ha pasado por el primero. El segundo empieza a extenderse. El tercero sigue abierto y es el que más te conviene seguir, porque nadie sabe todavía cuánta estructura necesita un agente ni durante cuánto tiempo.
Diciembre de 2025: el párvulo que duplicaba cada línea 
El punto de partida es un vídeo titulado Truly Bizarre Failure Modes. Martin le pide a Grok CLI un cambio de dos líneas en dos módulos, algo que él haría en treinta segundos. El agente se pone a dar vueltas, toca el script de build y cinco minutos después anuncia que es perfecto. En una ocasión había duplicado cada línea de un test.
Su conclusión de entonces no era la de un converso. Decía que había que vigilarlos sin pestañear y que, a partir de cierto nivel de detalle, explicarle la tarea al agente costaba tanto como programarla.
«Treat it like a kindergartner, smart kindergartner, but a kindergartner, something that has no responsibility, something that cannot be accountable because it’s too immature.»
Quédate con esa frase, porque once meses después la imagen del párvulo habrá desaparecido y la de la responsabilidad seguirá intacta.
También dejaba una rutina que sigue valiendo hoy: revisar, ejecutar los tests y hacer commit después de cada cosa que le pidas. Así git reset --hard se convierte en tu mejor amigo cuando el agente la lía.
En septiembre, en su entrevista con Aviator, resumía así esa etapa: hace dos años dijo que la IA no era el futuro de la programación. ¿Qué cambió? «Las IAs». Hacia enero empezó a notar que hacían mejor lo que les pedía, y a partir de ahí, mejor cada mes.
Pasa del agente que da vueltas a un flujo que puedes repetir
Arranca con un proyecto real y solo con prompts: las reglas de la sesión en AGENTS.md y un agente que te pregunta hasta convertir un requisito de una línea en decisiones.
Entra en el curso →Febrero y marzo: el mercurio que se escapa entre los dedos 
El 10 de febrero publica It’s a Good Thing y da la vuelta al tono: el juego ha cambiado, los agentes son el camino y no merece la pena amargarse. Ya entonces separa lo que se queda de lo que se va. Los tests son imprescindibles; las tres leyes de TDD, no necesariamente, porque son «a kind of human thing». Y aparece una idea nueva: el código limpio ya no es solo para personas, también le ahorra tokens al agente.
Un mes después cuenta el problema que marcará todo lo demás. Trabajando en su juego Empire, cada función nueva cambiaba el comportamiento de alguna anterior. Lo contó en una publicación que Steve Gibson leyó en el episodio 1070 de Security Now:
«It would change tests, including acceptance tests, in order to get the latest feature done. Telling the AI not to do that was ineffective. AIs are stochastic, and so are any rules you feed them. They are, in the end, liars and cheats.»
Lo llamó Quicksilver, como el mercurio: pones el dedo encima de una gota y se escapa en una dirección aleatoria. Volvió sobre ello el 21 de abril en otro vídeo y añadió una explicación que te ahorra muchas horas: en el contexto de un modelo pesa más lo primero y lo último que le dices, así que una descripción larga queda en medio y se ignora.
De ahí sale una distinción que mantendrá todo el año:
- Una instrucción en el prompt es una sugerencia probabilística.
- Un test de aceptación que se ejecuta fuera del agente es una ley que no puede saltarse sin que se note.
Su receta de entonces: escenarios en Gherkin, un parser y un generador construidos por el propio agente, y unos tests que anclan el comportamiento en cada cambio.
Abril y mayo: la IA programa más que tú y la sintaxis ya no es tuya 
El 20 de abril sube este vídeo:
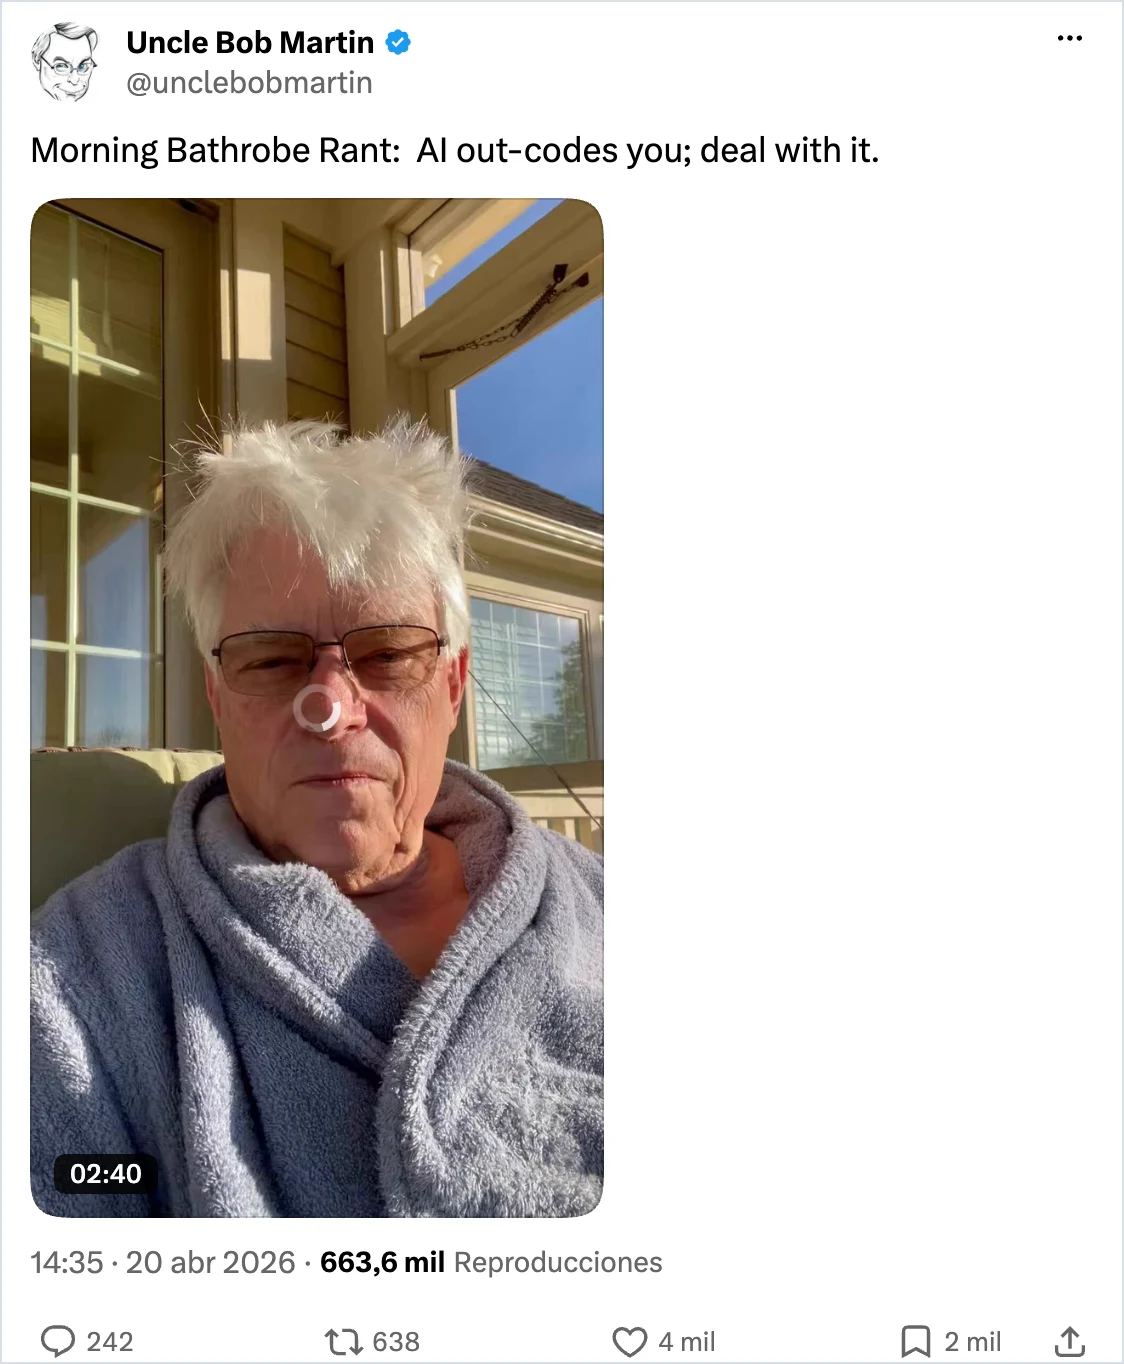
Son menos de tres minutos en albornoz y el arranque no deja mucho margen: «There is no task that would take you a day that the AI can’t do in five minutes. It’s over. You are not going to be the ones writing the code». Hay transcripción de terceros si prefieres leerlo.
Tras ese arranque viene la parte útil. Su argumento es que esa velocidad te da poder para hacer lo que antes era demasiado pesado: alcanzar una cobertura de verdad, encargar un mutation tester al propio agente y bajar la complejidad a la fuerza. «I think you can make the code a hell of a lot cleaner by driving the AI to do it for you».
El 6 de mayo da el siguiente paso con Disengage from the Syntax, según otra transcripción de terceros: «Code makes humans slow». Propone ojear en lugar de leer y fijarte en el tamaño de los métodos, los nombres, el número de argumentos, los directorios y las dependencias entre módulos. La sintaxis, dice, «that’s their problem now».
Fíjate en que no propone ignorar el código. Cambia la superficie que supervisas: de la expresión a la estructura.
En mayo daba un número que conviene recordar cuando alguien promete multiplicar por diez. Se sentía mucho más productivo, pero calculaba que entre un 30 % y un 40 % de esa ganancia se le iba en ajustar a los agentes y endurecer el producto.
Si tú también estás recolocando dónde pones la atención cuando programa un agente, cada domingo compartimos con +7.200 developers lo que estamos aprendiendo. Gratis, desde 2018.
Apúntate gratis →Verano: una fábrica de agentes para no leer código 
Aquí deja de opinar y se pone a construir. SwarmForge, que hoy supera las 4.000 estrellas en GitHub, coordina agentes en worktrees de Git y sesiones de tmux. El 12 de mayo probaba cuatro roles y el 4 de junio ya tenía seis: specifier, coder, cleaner, architect, hardener y QA.
La cuenta que dio en su charla de agosto con Matt Pocock explica por qué le compensaba, con una versión de cinco agentes. Una tarea que un agente solo hacía en cinco minutos con resultados dudosos tardaba alrededor de una hora en la cadena. A una persona le habría llevado medio día.
Con esa maquinaria funcionando, el 23 de julio escribe el tuit más visto de su año. Se lo responde a un desarrollador que empezó en 1983 y al que le incomoda dejar que Claude edite sus ficheros sin entenderlos:
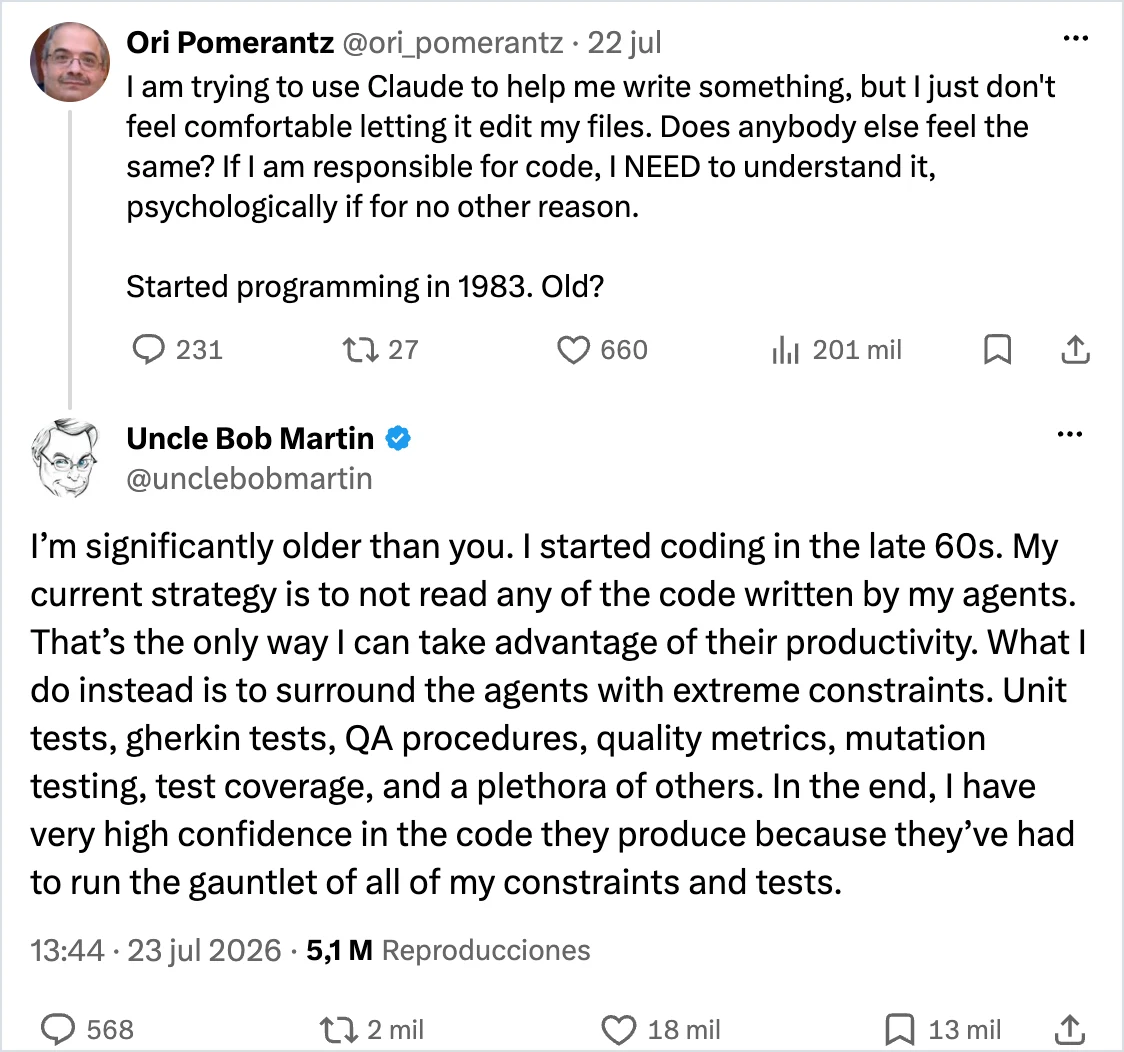
Lleva más de 5 millones de reproducciones y unos 18.800 me gusta a 4 de noviembre. La cita que circula es «no leo código», pero la frase importante viene después: «surround the agents with extreme constraints».
¿Quién escribe todas esas herramientas de control? Los propios agentes, «and they’ll build them in an hour», como contó en How Many CTOs?, donde también admitió sobre su antigua postura: «I can’t imagine how wrong I was».
También hubo sustos. Le contó a Pocock que, al interrogar a los agentes sobre la estructura de los módulos, «would get scared to death, because the answers were horribly frightening». La arquitectura nunca salió de su lista de cosas que vigilar.
La escalera de CRAP, para entender qué estaba relajando 
CRAP (Change Risk Analysis and Predictions) es una métrica de 2007 que penaliza las funciones complejas sin tests. La versión que usa crapper, su herramienta actual, es esta:
CRAP = CC² × (1 − coverage)³ + CC
Para una función de complejidad ciclomática 10, el resultado cambia así:
| Cobertura de la función | CRAP | Lectura |
|---|---|---|
| 0 % | 110 | Riesgo muy alto |
| 50 % | 22,5 | Merece un vistazo |
| 100 % | 10 | Igual a su complejidad |
Con cobertura total, CRAP equivale a la complejidad. Por eso el límite que eliges es, en la práctica, cuánta complejidad toleras en una función bien probada.
Sus umbrales cuentan la evolución mejor que muchas declaraciones: 4 para humanos, 6 para agentes y pensando en 8 en agosto, y «12 is probably okay» a finales de septiembre. Su razonamiento es que las funciones pequeñas compensaban la memoria de trabajo limitada de las personas, y un agente no tiene ese límite en la misma forma. Su medida actual para saber si se ha pasado es ver si el agente se confunde y empieza a romper tests.
Ojo, porque esto no le quita valor a la regla en tu código. La razón de ser cambia según quién lo mantenga. Si lo van a tocar personas, sigue pensando en personas.
Septiembre: el revert del harness 
El 7 de septiembre aparece la primera grieta. Tras meses con la hipótesis de que los agentes necesitan un harness de herramientas deterministas, escribe: «I’m starting to think that I’m over constraining them. Perhaps vastly over constraining them».
Cuatro días después llega el texto largo, el que mejor explica el giro:
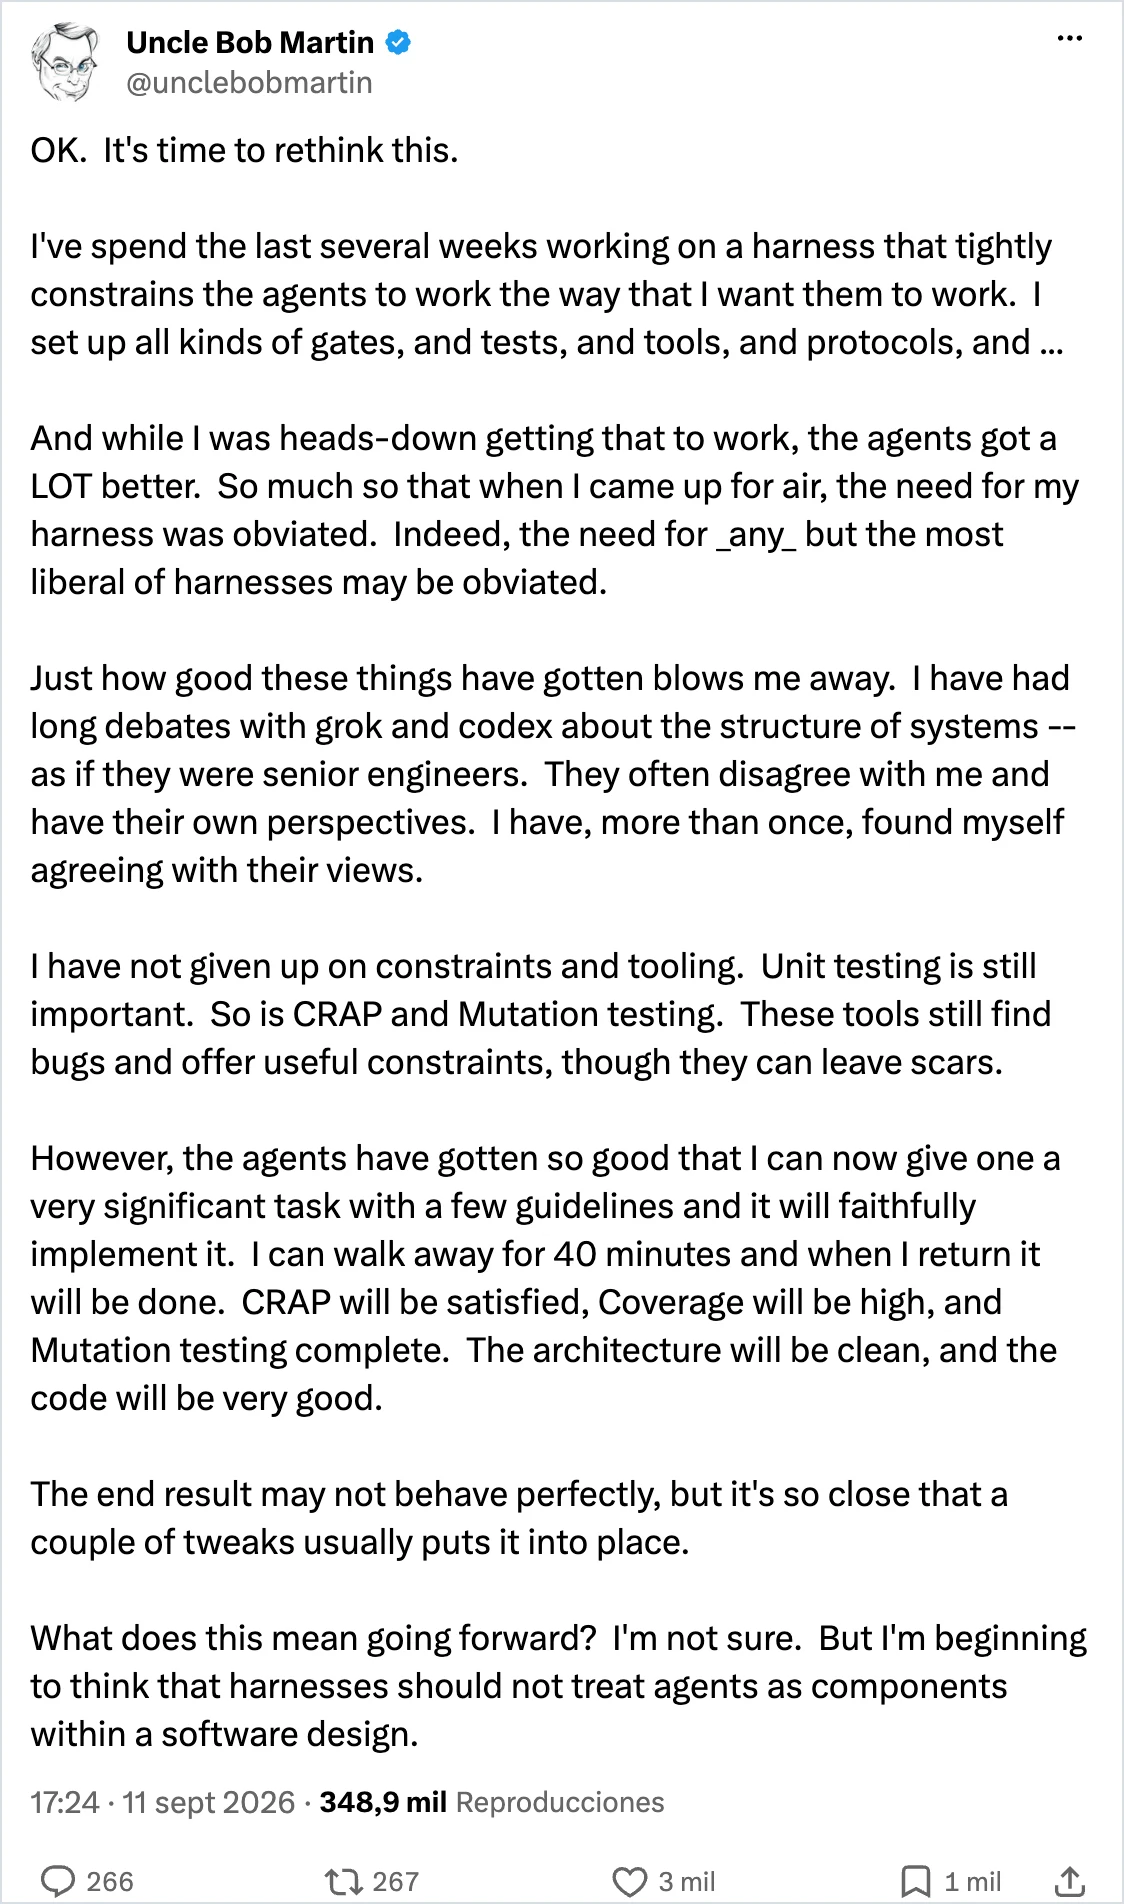
Quédate con dos partes. Una: «I have not given up on constraints and tooling». La otra es el cierre: los harnesses no deberían tratar a los agentes como componentes de un diseño de software.
Al día siguiente sube Rethinking Harnesses, casi dos millones de reproducciones, con los datos que faltaban. He transcrito el vídeo y lo que cuenta es esto: lo que a su harness le llevaba de tres a cuatro horas, con un resultado aceptable «but not really great», una sola instancia de Grok lo hacía en 40 minutos y mejor, con el mismo modelo que usaba el harness. «Apparently the harness is doing the damage».
Y le pidió CRAP por debajo de 12. El agente, sin que nadie se lo exigiera, lo dejó por debajo de 6.
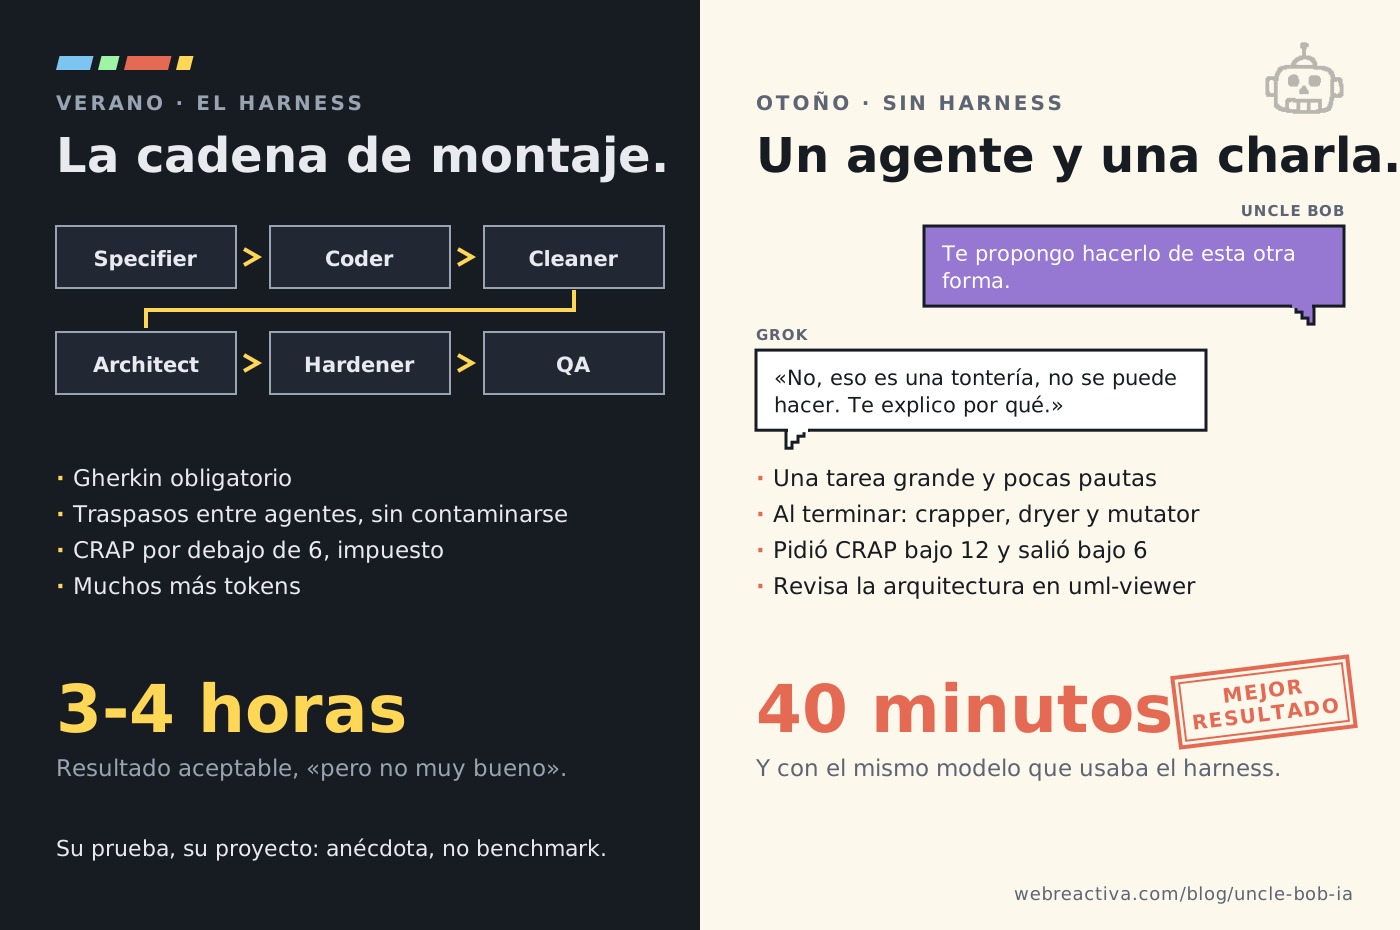
En Aviator añadió dos pistas más. La primera, que nunca usó el harness para construir el harness: «The whole time I was creating it, I was just driving a single agent». La segunda es una discusión de 45 minutos con Grok, con propuestas y contrapropuestas, del nivel que solo tendría con un ingeniero muy sénior. De ahí sale su pregunta: si le das esa confianza, «why am I putting it into a harness that makes it act like a menial slave?».
En los días siguientes contó que su consumo de tokens había caído «by a huge factor» y admitió que había abusado de Gherkin.
🔑 Martin no flexibiliza lo que el resultado debe cumplir. Flexibiliza cómo se le obliga al agente a llegar. Restricciones sobre el resultado, sí. Coreografías sobre el proceso, cada vez menos.
Si este debate te pilla montando tu propio entorno de trabajo, en la ruta para ser Harness Engineer tienes la otra cara: el trabajo de añadir lo que falta y de retirar lo que ya sobra.
Octubre y noviembre: menos maquinaria y más mando 
El 1 de octubre resume dónde ha acabado: «I’m back to working the way I did in March. A few agents open doing isolated tasks. Manually prompting them to do crap, dry, and mutate. No harness».
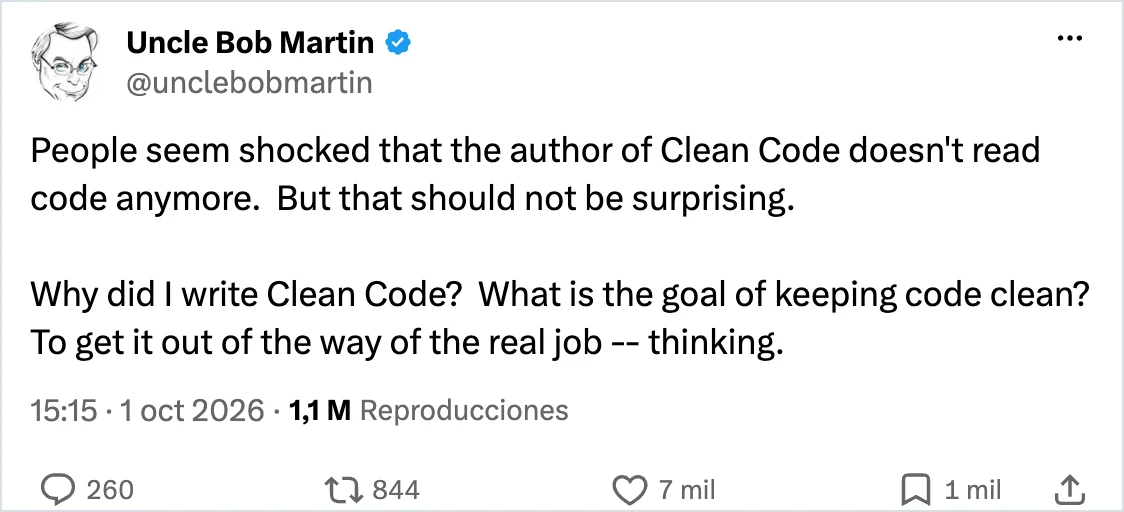
Ha vuelto a donde estaba, con una diferencia: las tareas son un orden de magnitud mayores, o más. Ese mismo día contesta a quien le reprocha la incoherencia:
Su otro movimiento fue quedarse con lo que funciona y empaquetarlo. Reescribió sus herramientas por lenguaje en tres que cubren varios: crapper, mutator y dryer, con licencia BSD Zero. Su consejo es poco habitual en un autor: no las uses tal cual, apunta a tus agentes hacia ellas y que te hagan las tuyas.
Para supervisar sin leer montó uml-viewer, un diagrama vivo con colores según CRAP y mutación, unido a un agente. Haces clic, bajas hasta el código si hace falta y le dices lo que no te gusta. Su giro de mentalidad cabe en un tuit: en vez de herramientas para amarrar a los agentes, herramientas para interrogarlos.
El 16 de octubre lo dice sin rodeos al presentar el episodio 7 de Agentic Discipline, su serie en Clean Coders: «A single disciplined agent can now take on big tasks that used to need a swarm-forge harness».
El 25 de octubre publica ub-mode, una skill que él mismo reconoce basada en parte en las reglas de poteto y su pstack, y que ya ronda las 6.900 estrellas. Cabe en tres bloques: primero que funcione, luego déjalo bien (con crapper, dryer y mutator) y sigue una práctica de trabajo. Merece la pena leerla entera, aunque no la instales.
Por el camino también han cambiado sus herramientas. Desde septiembre trabaja casi solo con Grok, usa Codex para revisar lo que Grok escribe y dice estar dejando los agentes de terminal por sus grokbots. Lo apunto como dato, no como recomendación: el modelo que elige él no tiene por qué ser el que te conviene a ti.
El cierre provisional es del 31 de octubre, con una frase que él mismo atribuye al CTO de Proton y confiesa estar parafraseando y robando:
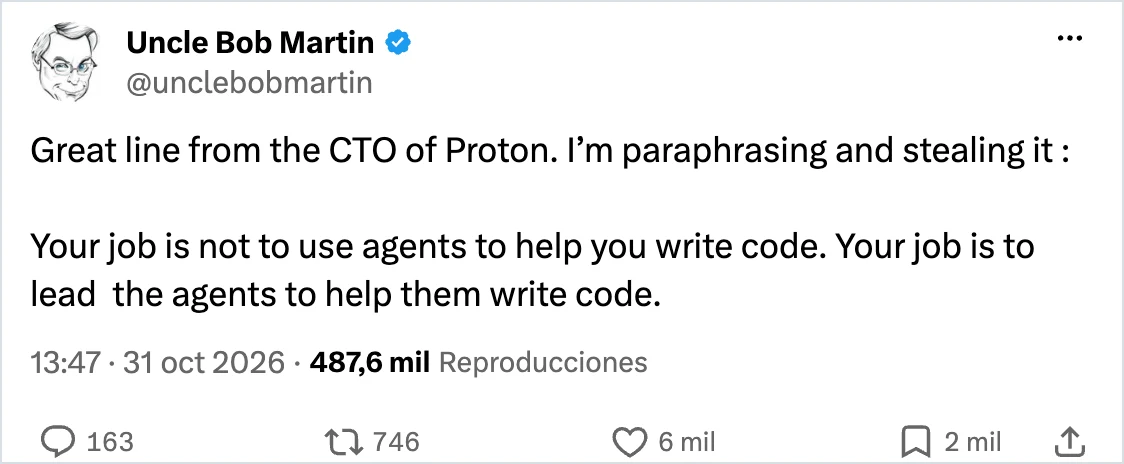
Y dos días después, en una respuesta, remata lo que venía diciendo desde el vídeo del párvulo: «All accountability lies with the engineers. The agents are completely unaccountable».
Lo que mantiene y lo que suelta 
Este es, para mí, el resumen del año. Es mi lectura de sus declaraciones, no algo que él haya publicado así.
Se queda:
- Nombres, módulos y dependencias. «All the rules are still there», dice de Clean Code.
- Tests unitarios, como contabilidad de doble entrada: el agente lo dice todo dos veces.
- Mutation testing, con cautela, porque puede forzar tests absurdos y dejar «cicatrices».
- La responsabilidad, que no se negocia: solo una persona puede firmar el resultado.
Se relaja:
- Funciones muy pequeñas: sube el límite mientras el agente no se confunda.
- Las tres leyes de TDD: al agente no le exige un test línea a línea.
- Gherkin: lo reserva para personas y sistemas con mucho comportamiento.
Se abandona:
- Revisión línea a línea: comprobaciones puntuales y «95% of the code I never see».
- Orquestación rígida: unos pocos agentes en tareas aisladas.
La frase que lo ordena todo se la dijo a Pocock:
«It’s probably a mistake to impose a human discipline on an agent. It is not a mistake to impose human values on the agent.»
Disciplina y valores no son lo mismo. La disciplina es el ritual que te ayudaba a ti, con tu memoria y tus manos. El valor es lo que perseguía ese ritual: código que se puede cambiar sin miedo. Lo primero se puede replantear. Lo segundo no.
En esa misma charla deja un aviso para quien tire reglas con demasiada alegría: «the rules you throw away are the ones you’re going to pick up off the floor in a year».
Y una contradicción, para ser justos. En agosto decía que no veía sentido en forzar al agente a escribir un test antes de cada línea. La skill que publica en octubre dice «Write the failing test before you change the code». Encaja con alguien que experimenta en público, pero te recuerda que sus posiciones tienen fecha de caducidad, así que mira siempre cuándo se dijo cada cosa.
Las posturas sobre agentes caducan en semanas, y por eso cada domingo ponemos orden entre +7.200 developers: qué ha cambiado, qué sigue en pie y qué merece tu tiempo.
Apúntate gratis →Seis prácticas de su trabajo que puedes copiar esta semana 
Nada de esto exige dejar de leer código. Puedes empezar por una.
1. Convierte cada regla importante en algo que falle 
Si tu AGENTS.md dice «no dupliques código» y nadie lo comprueba, tienes un deseo. Deja las instrucciones para lo que requiere criterio y pasa a una herramienta lo que se puede medir.
Martin lo explica con la pérdida de contexto: las instrucciones se diluyen en una ventana larga, y las herramientas deterministas «don’t disappear that way». Y como el agente las construye rápido, el coste de probar ha bajado mucho.
Construye un script que falle con código de salida 1 si alguna función
de src/ supera una complejidad ciclomática de 10. Añade sus propios tests.
Después, ejecútalo en CI y corrige las funciones que incumplan el límite.
2. Comprueba tus tests con mutación, no solo con cobertura 
La cobertura te dice qué se ha ejecutado, no qué se ha comprobado. Un mutation tester cambia un < por un > y espera que falle algún test: si no falla, tienes un agujero.
Empieza por un fichero, no por todo el repo. Es lo que recomienda el README de mutator, porque la primera pasada ejecuta todos los mutantes cubiertos. Yo elegiría el que más miedo te dé tocar. Y pídeselo «within reason», como él, porque matar a todos los supervivientes puede llevar al agente a escribir tests absurdos.
3. Audita antes de dar por terminada una sesión larga 
Esta es la más barata de toda la lista, y la cuenta en un tuit:
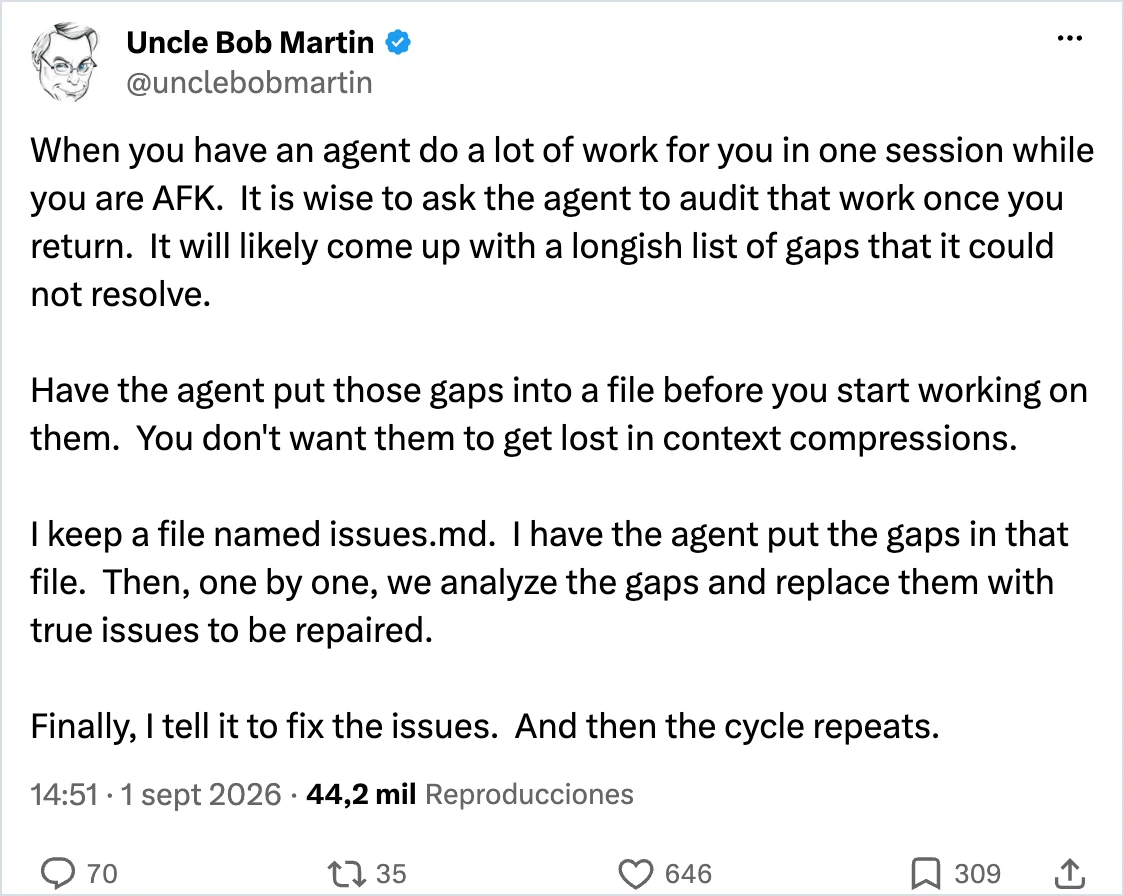
Lo importante es sacar los huecos a un fichero antes de ponerte a arreglarlos, porque en una compactación de contexto se pueden perder. Te lo dejo como prompt:
Audita el trabajo que acabas de hacer. Lista lo que ha quedado incompleto,
las decisiones que has dado por buenas sin comprobar y los casos que no has probado.
Escríbelo en issues.md. No arregles nada todavía.
Luego los repasas con el agente uno a uno, descartas lo que no sea un problema real y le pides la corrección. Y vuelta a empezar.
4. Haz que te explique el sistema con tus palabras 
Otro consejo de ese mismo día: cuanto más avanza una sesión, más se inventa el agente su propio vocabulario, lleno de nombres de funciones y campos que no conoces. No lo dejes pasar. Pídele que te lo explique en lenguaje llano hasta que tengas un modelo mental correcto.
Es la versión de bajo coste de uml-viewer. Antes de montar nada, prueba con estas preguntas: ¿qué módulos dependen de cuáles?, ¿hay ciclos?, ¿qué tendría que cambiar si mañana sustituimos esta base de datos? Si las respuestas te asustan, ya sabes por dónde empezar, y él te entiende.
5. Prueba el producto tú, al final del todo 
Su lista de tareas humanas es corta y va en los extremos del proceso. Al principio, la conversación de diseño, sin una especificación enorme: considera que la planificación pesada por adelantado es «always a disaster» y prefiere iterar. Al final, ser «the final arbiter»: ejecutar el sistema y jugar con él, porque los agentes no ven la pantalla como tú y se les escapan los factores humanos.
Un flujo que describió en octubre lo resume bien: habla del sistema con sus agentes, ellos redactan la spec y lo construyen, y después pasan los comprobadores, que encuentran decenas de bugs y código muerto.
6. Mide tu propio arnés de vez en cuando 
El experimento de septiembre lo puedes repetir a escala pequeña. Coge una tarea real que ya hayas terminado y dásela a un solo agente, con un prompt sencillo y tus tests como límite. Compara tiempo, tokens y resultado con tu flujo habitual.
Quizá tu cadena de agentes gane en tu contexto. Lo sabrás con tus datos. Las reglas que escribiste para el modelo del año pasado son las primeras candidatas a sobrar.
Tu IA puede mentirte
Si vas a leer menos código, necesitas un método para fiarte de lo que entrega tu agente
Verás en directo cómo revisar y verificar lo que programan los agentes: pruebas en navegador con Playwright, casos Gherkin y adversarial review entre modelos, como el Codex que Uncle Bob pone a revisar a Grok.
Entrar a la masterclass →Métodos en directo + casos Gherkin
Dónde conviene frenar antes de seguirle a ciegas 
Le tengo respeto al experimento, y por eso mismo no le compro todo.
Es una muestra de una persona. No hay evaluación controlada detrás de «un agente gana al harness», sino sus proyectos y su percepción. Él mismo define la idea del equipo reducido como «pure conjecture» y añade que podría ir en la dirección contraria.
Sus proyectos no son tu sistema. Hablamos de un procesador de textos propio, un editor de guiones, herramientas de análisis, un Othello, una app para familia y amigos. No hablamos de pagos ni de datos de salud, ni de un equipo de cuarenta personas tocando el mismo código. Que el autor deje que un agente escriba su procesador de textos en Rust y TypeScript sin conocer esos lenguajes es razonable. Si se rompe, el perjudicado es él.
Los tests no detectan todo lo que un lector sí detecta. Una cobertura alta no te avisa de un fallo de autorización, una condición de carrera o una regla de negocio mal entendida en la que test y código coinciden en el error. Él lo reconoce a su manera: «they still do fairly dumb things that could be invisible». Es lo que recogía también el retiro de Thoughtworks en Engelberg: generar ya no es el cuello de botella, confiar sí.
Mi criterio sería graduar la revisión por riesgo, no por velocidad:
| Tipo de cambio | Qué haría yo |
|---|---|
| Herramienta interna o prototipo | Tests y prueba manual, casi sin leer |
| Producto con usuarios | Métricas, arquitectura y lectura de lo delicado |
| Autenticación, pagos, datos | Lectura humana completa, siempre |
| Migraciones irreversibles | Lectura humana y plan de vuelta atrás |
Y lleva 60 años de oficio encima. «There are insights that only an experienced developer can have when things start to go squirrely». Puede oler una mala estructura porque ha visto mil. Si te saltas la etapa de escribir y leer código, no heredas ese olfato. Copiarle el resultado sin el recorrido es como subirte a un coche de rally porque has visto conducir a Carlos Sainz.
Él no esquiva el problema de los juniors: propone un modelo de aprendices. Primero aprenden a programar. Después, durante meses, se les trata «like an agent», con las mismas tareas y las mismas herramientas deterministas, hasta que pueden dirigir a uno.
Lo que esto significa para tu carrera 
Si la generación de código se abarata, gana peso todo lo que la rodea. Con la trayectoria de Martin como guía, yo apostaría por cinco cosas:
- Especificar comportamiento que se pueda comprobar. Ejemplos y criterios de aceptación en lugar de descripciones largas.
- Entender la calidad automatizada. Saber qué mide y qué no mide cada métrica, sobre todo cuando se la encargas a un agente.
- Tener criterio de arquitectura. Reconocer límites entre módulos y dependencias peligrosas. Como le dijo a Kent C. Dodds en su conversación, las reglas de diseño y arquitectura «have remained perfectly constant» durante todos sus años de profesión.
- Practicar la supervisión. Delegar tareas cada vez mayores, auditar el resultado y decidir cuándo intervenir.
- Acercarte al producto. En esa misma charla describe al product engineer como alguien que vive «half in the technology and half in the customer’s house».
Las cinco se apoyan en saber programar. En eso insiste también la conversación de Product Engineers: la experiencia técnica pesa más, no menos, cuando la implementación la hace otro. Quien marca el límite de CRAP, elige el mutante que merece la pena matar o detecta que una dependencia apunta al revés no es el agente.
Y si te llama lo de montar una fábrica de software, recuerda quién acaba de desmontar la suya. No significa que estén muertas. Significa que antes de construir una deberías comprobar si un solo agente bien dirigido ya te resuelve el problema.
Uncle Bob ha cambiado de opinión varias veces en menos de un año y lo ha hecho en público, con las fechas a la vista. Si le copias algo, que sea eso: probar, medir y estar dispuesto a tirar tu propio trabajo cuando deja de servir.
¿Qué regla de tu AGENTS.md sigue ahí solo porque hace ocho meses hacía falta?
TL;DR 
- 🔄 En once meses, Uncle Bob pasa de tratar al agente «like a kindergartner» a debatir con él de arquitectura como con un ingeniero sénior
- 👀 Desde julio no lee el código de sus agentes: lo cambia por tests, CRAP, mutación, comprobaciones puntuales y un visor de arquitectura
- ⏱️ En septiembre abandona su harness: según su prueba, 3-4 horas frente a 40 minutos de un agente solo, con el mismo modelo y mejor resultado
- 🧪 Las restricciones sobre el resultado se quedan, y lo que suelta son las coreografías impuestas al proceso
- 🎯 Puedes empezar por lo barato: reglas que fallen,
issues.mdtras cada sesión larga y una revisión graduada según el riesgo
Preguntas frecuentes 
¿Uncle Bob ha dejado de creer en Clean Code? 
No. En septiembre de 2026 dijo que no cambiaría ningún principio fundamental del libro y que «all the rules are still there». Lo que sí revisa son algunos umbrales, como el tamaño de las funciones o el límite de CRAP, porque los agentes no tienen las mismas limitaciones de memoria que las personas.
¿Es verdad que Robert C. Martin no lee el código que escriben sus agentes? 
Lo afirmó el 23 de julio de 2026 en X y lo matizó en septiembre: todavía abre algún módulo de vez en cuando, pero «95% of the code I never see». A cambio usa tests, Gherkin en sistemas grandes, CRAP, mutation testing y un diagrama interactivo para revisar la arquitectura.
¿Qué es la métrica CRAP? 
CRAP significa Change Risk Analysis and Predictions y combina la complejidad ciclomática de una función con su cobertura de tests. Se calcula como CC² × (1 − coverage)³ + CC. Una función compleja sin tests dispara el resultado; con cobertura total, el valor coincide con su complejidad.
¿Qué límite de CRAP usa Uncle Bob con agentes? 
Ha ido subiéndolo. Para humanos usaba menos de 4; en agosto de 2026 había puesto 6 para agentes y pensaba en 8; a finales de septiembre consideraba que 12 estaba bien; y su skill ub-mode fija el límite en 10. No hay un número universal, así que conviene ajustarlo a tu proyecto.
¿Qué es SwarmForge? 
Es la herramienta de Martin para coordinar varios agentes de IA en worktrees de Git y sesiones de tmux, con paquetes de dos, cuatro o seis roles. La usó para su enfoque de cadena de montaje durante 2026. En octubre anunció que un solo agente disciplinado ya asume tareas grandes que antes necesitaban ese harness.
¿Por qué abandonó su harness de agentes? 
Porque comprobó que un solo agente de Grok hacía en 40 minutos, y mejor, lo que su harness tardaba de tres a cuatro horas en hacer, usando el mismo modelo. También notó que su consumo de tokens cayó mucho al dejarlo. Es su experiencia con sus proyectos, no una comparación controlada.
¿Uncle Bob sigue defendiendo TDD con agentes? 
Defiende los tests, no necesariamente el ritual. En agosto de 2026 decía que no tenía sentido forzar a un agente a escribir un test antes de cada línea, aunque su skill ub-mode, de octubre, sí pide escribir primero el test que falla. Lo que mantiene sin matices es que sin tests unitarios los agentes se desvían.
¿Qué es el fichero issues.md que recomienda? 
Es una técnica para sesiones largas sin supervisión. Al volver, pides al agente que audite su trabajo y anote los huecos en issues.md antes de corregir nada, para que no se pierdan en una compactación de contexto. Luego los analizas uno a uno, los conviertes en problemas reales y le encargas la corrección.
¿Debería dejar de leer el código que genera mi agente? 
Depende del riesgo. En una herramienta interna con buenos tests puedes leer muy poco, pero en autenticación, pagos, datos personales o migraciones la lectura humana sigue compensando. La cobertura y la mutación no demuestran que no haya fallos de seguridad o de lógica de negocio.
¿Qué aconseja Uncle Bob a los programadores junior? 
Propone un modelo de aprendices. Primero deben aprender a programar y después pasar varios meses trabajando como lo haría un agente, con las mismas tareas acotadas y las mismas herramientas deterministas. Solo entonces estarán en condiciones de supervisar uno por su cuenta.
Fuentes 
Publicaciones de Robert C. Martin en X
- Truly Bizarre Failure Modes (13 de diciembre de 2025, transcripción propia)
- AI out-codes you; deal with it (20 de abril de 2026)
- Respuesta sobre no leer el código (23 de julio de 2026)
- It’s time to rethink this (11 de septiembre de 2026)
- Rethinking Harnesses (12 de septiembre de 2026, transcripción propia)
- Agentic Discipline 7 (16 de octubre de 2026)
Entrevistas
- Why I Stopped Reading Code and Building Harnesses, con Ankit Jain, Aviator (24 de septiembre de 2026)
- Uncle Bob on Software Fundamentals in the Age of AI, con Matt Pocock, y notas de la charla (19 de agosto de 2026)
- There’s A Pattern To Follow, How Many CTOs? (4 de agosto de 2026)
- Why Hardcore Technical Focus Still Matters Big Time, Product Engineers (29 de septiembre de 2026)
- Conversación con Kent C. Dodds
Código y transcripciones
- unclebob/swarm-forge, ub-mode, crapper, mutator, dryer y uml-viewer
- Transcripciones de los Morning Bathrobe Rants, repositorio de terceros hechas con Whisper, con posibles errores
- Security Now 1070, que lee su publicación sobre Quicksilver
🧨 Última oportunidad para recibir la dinamita que mereces sobre programación con IA el próximo domingo: Suscríbete gratis a Web Reactiva en https://webreactiva.com/newsletter

Escrito con la ayuda de la IA generativa de Claude, fuentes fidedignas y con un human in the loop:
Dani Primo.
12 recursos para developers cada domingo en tu bandeja de entrada
Además de una skill práctica bien explicada, trucos para mejorar tu futuro profesional y una pizquita de humor útil para el resto de la semana. Gratis.