REA: el MCP de ingeniería inversa para tu agente de IA
Tabla de contenidos
Ves una función en una app y piensas: “esto lo quiero en mi producto”.
El portapapeles de Notion que pega bloques con formato. La búsqueda de una app de notas que encuentra lo que buscas antes de que acabes de escribir. El sonido de un juego viejo que suena a la izquierda o a la derecha según dónde rompes el ladrillo.
No tienes el código fuente. Tienes el ejecutable, un .asar o una web minificada. Y hasta ahora, la distancia entre “me gusta cómo funciona” y “sé cómo funciona” eran tardes enteras con Ghidra, una libreta y mucha paciencia.
REA (Reverse Engineer Anything) es un servidor MCP y una CLI que le da a tu agente de IA las herramientas de ingeniería inversa para recorrer esa distancia. Tu agente pregunta, REA inspecciona el binario en tu máquina y devuelve evidencia: el código, las referencias y lo que todavía no sabe.
Esto es lo que vas a encontrar:
- Qué es REA y qué problema resuelve frente a abrir Ghidra a mano.
- Cómo funciona por dentro: el bucle pregunta → inspección → evidencia → implementación.
- Cómo instalarlo en Claude Code, Codex, Cursor y otros 16 clientes con un solo comando.
- Tres casos reales (DX-Ball, Notion y un juego de PC-98) y qué enseñan.
- Límites, requisitos y la parte legal, que aquí importa más que en otros posts.
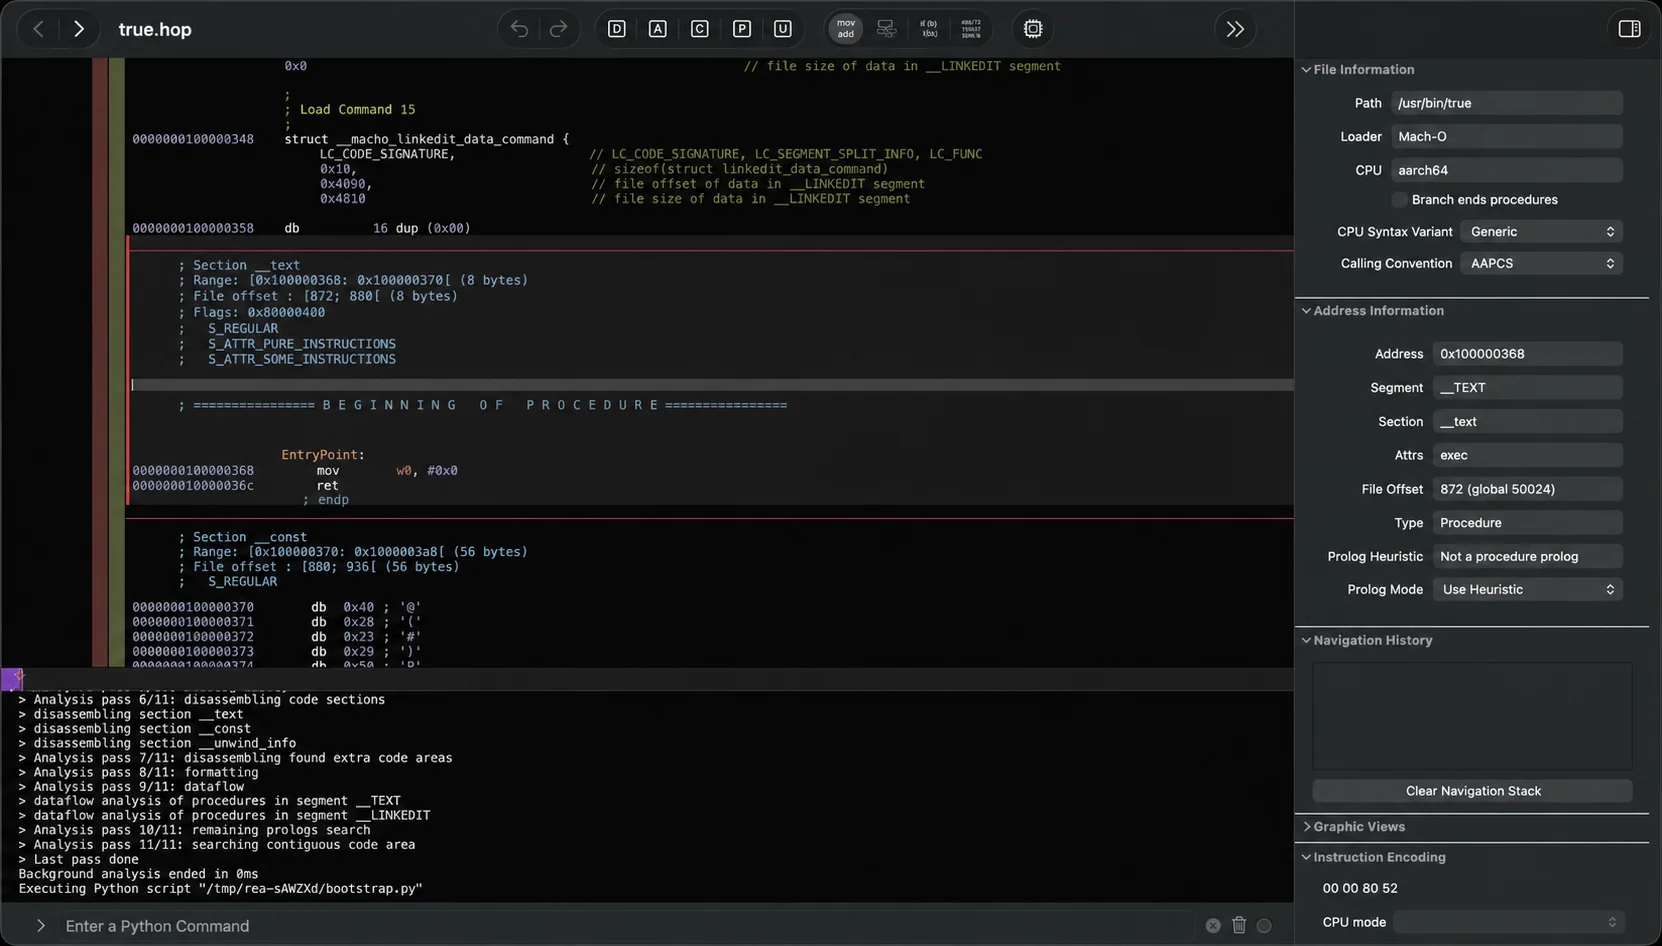
¿Qué es REA y para qué sirve? 
REA es un proyecto open source con licencia MIT, publicado en npm como rea-agents, que conecta tu agente de código con herramientas de análisis de binarios, aplicaciones JavaScript y Electron, ensamblados .NET, APKs de Android y sitios web. Lo puedes usar de dos maneras: como servidor MCP que tu agente llama por su cuenta o como CLI desde la terminal. Las dos comparten los mismos flujos de trabajo y el mismo formato de resultado.
La frase con la que se presenta en su README lo resume bien: “See a feature you like. Understand how it works, down to the binary level.”
El matiz importante está en lo que devuelve. REA no te suelta un volcado de pseudocódigo y se lava las manos. Cada conclusión viene con la evidencia que la sostiene y con las limitaciones de esa evidencia. Es la diferencia entre un compañero que te dice “creo que es esto” y uno que te dice “es esto, aquí está la instrucción, y esto otro no lo he podido comprobar”.
En el momento de escribir este post, la última versión es la 6.5.0, publicada el 13 de octubre de 2026 según el CHANGELOG.md del repositorio. Ese changelog ocupa más de 360 KB, lo que da una idea del ritmo: el propio README avisa de que “REA changes quickly” y pide mantenerlo actualizado.
🔑 REA no sustituye a Ghidra, Hopper o IDA. Los orquesta. Tu agente habla con REA, REA habla con el motor de análisis y traduce lo que encuentra a un formato que el modelo puede razonar.
Si ya leíste nuestro análisis de reverse-skill, el router de ciberseguridad para tu agente, la diferencia es clara. reverse-skill le dice al agente por dónde empezar con instrucciones y reglas. REA le da las manos: herramientas MCP que abren el binario, leen bytes, siguen llamadas y guardan el resultado.
¿Cómo funciona REA por dentro? 
El funcionamiento es un bucle de cuatro pasos. Tu agente pregunta por un objetivo local, REA lo inspecciona y rastrea con motores de análisis, devuelve código, referencias y huecos de conocimiento, y el agente usa eso para explicar, implementar o probar. Si algo no cuadra, vuelve a preguntar.
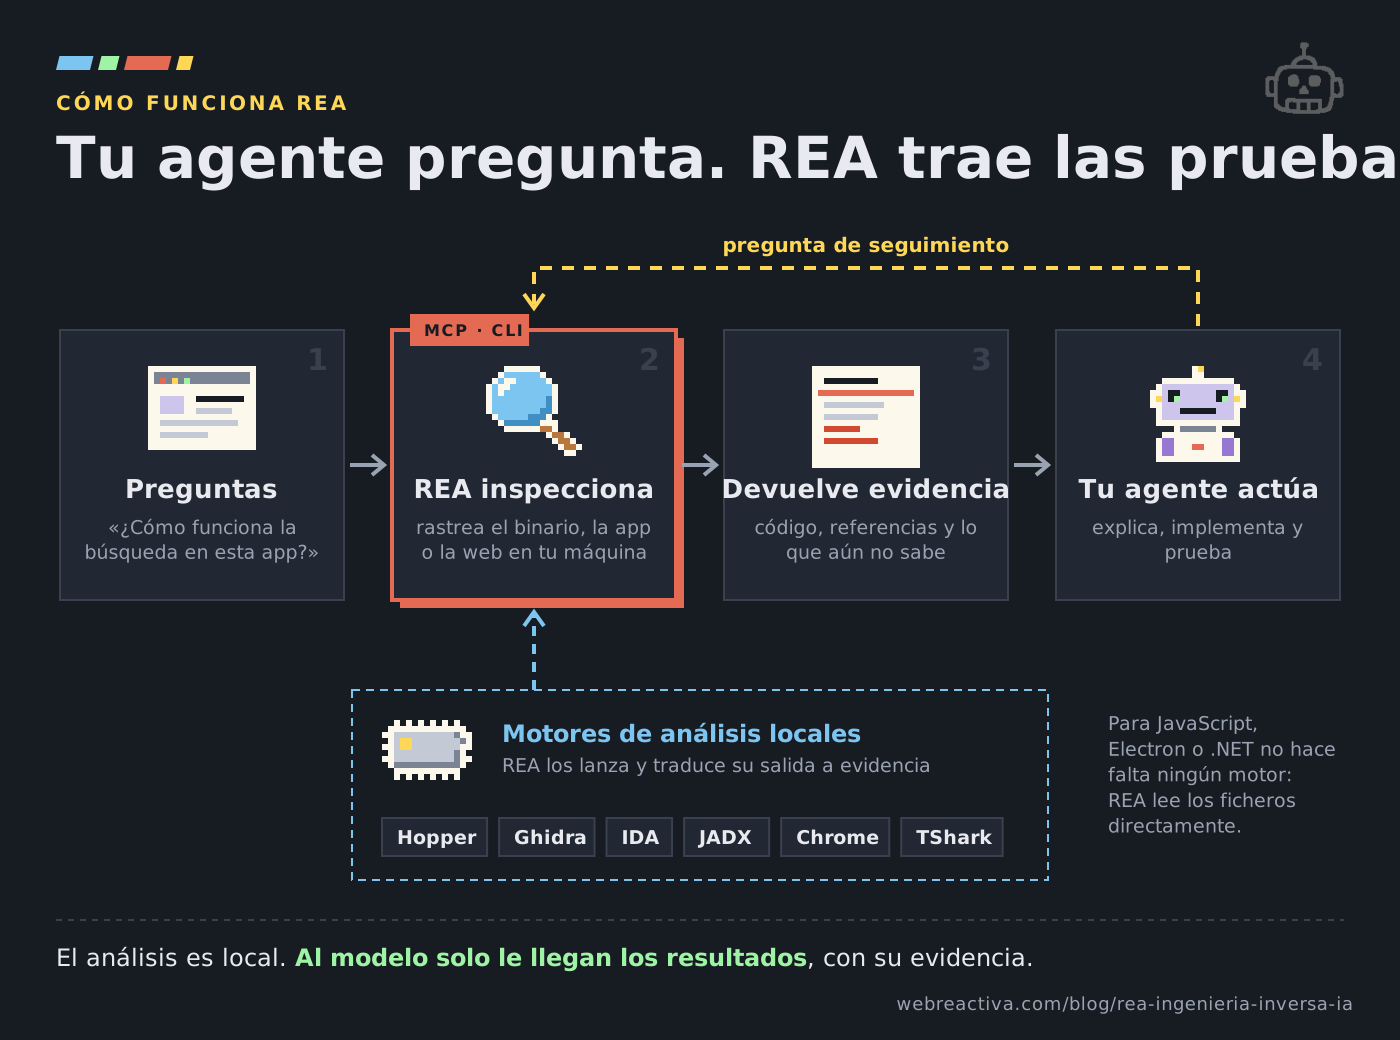
Vamos paso a paso.
1. Preguntas. En lenguaje natural, a tu agente de siempre. El ejemplo del README es literal: “Understand how search works in the Notes app, show me the evidence, and build a similar feature for my project.” Cambias “Notes” por la app que te interesa y “search” por la función.
2. REA inspecciona. Según el tipo de objetivo, REA elige el camino. Para un binario nativo arranca Hopper, Ghidra o IDA (el que tengas). Para una app Electron lee los módulos JavaScript del .asar sin ejecutar nada. Para un APK tira de JADX. Para una web abre un navegador de la familia Chrome.
3. Devuelve evidencia. Cada resultado separa tres cosas: observaciones (lo que se ha visto en el binario), inferencias (lo que se deduce) y desconocidos (lo que no se ha podido comprobar). Las guías de prompts del proyecto piden de forma explícita a los agentes que no mezclen esas tres capas.
4. Tu agente actúa. Con la evidencia en la mano, el agente te explica el mecanismo, escribe una implementación para tu proyecto y la prueba. Si le falta una pieza, vuelve al paso 2 con una pregunta más concreta.
¿Por qué importa tanto separar observación de inferencia? Porque los modelos tienen una tendencia muy humana a rellenar huecos con lo que suena plausible. En ingeniería inversa eso es veneno: una constante mal leída y tu “reimplementación” se parece al original lo mismo que un huevo a una castaña.
💡 Si trabajas con agentes, esta idea de “evidencia con huecos explícitos” te sirve aunque nunca toques un binario. Es la misma disciplina que pedimos cuando hablamos de cómo verificar el código que genera la IA.
¿Qué hace REA con resultados enormes? 
Una app real produce evidencia gigante. La documentación de la CLI pone un ejemplo concreto: analizar la aplicación de Obsidian genera un fichero de evidencia de 334 MB. Nadie, ni humano ni modelo, se lee eso.
La solución es guardar la evidencia completa en disco y pedir vistas: un resumen, una página de módulos o un módulo concreto. Ese mismo resumen de Obsidian se queda en unos 10 KB. El agente lee la vista, y si necesita más, pide la siguiente página sin repetir el análisis.
# Guarda la evidencia completa de la app
rea analyze-javascript-application /ruta/absoluta/a/la/app --json > app-evidence.json

# Pide solo un resumen de esa evidencia
jq -c '{source: {kind: "inline", evidence: .}, view: {kind: "summary"}}' app-evidence.json > app-view.json
rea inspect-analysis-view app-view.json
Es la misma idea que aplicamos al gestionar el contexto de un agente: no metas todo en la ventana, mete un índice y deja que pida lo que necesite.
REA le instala una skill a tu agente. Aprende a crear la tuya
Un minicurso por email, a tu ritmo, para instalar skills en tu agente y escribir la tuya, para que deje de improvisar en las tareas que repites.
Apúntate al minicurso →¿Qué puedes analizar con REA? 
Mucho más de lo que sugiere el nombre. La tabla del README tiene más de 20 tipos de objetivo. Estos son los que más te pueden interesar si vienes del desarrollo web y de producto:
| Objetivo | Qué te devuelve | Qué necesitas |
|---|---|---|
| Binarios nativos | Pseudocódigo, ensamblador, strings, símbolos, llamadas y referencias | Hopper, Ghidra o IDA |
| JavaScript / Electron | Módulos, imports, source maps, rutas, IPC y add-ons nativos | Node.js y npm |
| Sitios web | Estructura, scripts, tráfico de red y capturas | Un navegador de la familia Chrome |
| Capturas de red guardadas | Peticiones, respuestas y dónde se originan en el código | Ficheros HAR o SAZ de Fiddler |
| Ensamblados .NET | Metadatos, instrucciones CIL y dependencias nativas | Nada extra (solo estático) |
| APKs de Android | Manifest, clases, métodos descompilados y referencias | JADX y un JDK completo |
| Apps Flutter | Hash del snapshot de Dart y procedencia del motor | Nada extra |
| Binarios Go y Rust | Versión del compilador, módulos y dependencias embebidas | Nada extra |
| Bases de datos SQLite | Tablas, columnas, índices y filas seleccionadas | Node 24.15+ o 26+ |
La lista sigue con WebAssembly, bytecode de la EVM, firmware, capturas de paquetes con TShark, señales lógicas con sigrok, volcados de procesos que fallaron en Linux y dispositivos Android por adb. Cada uno con su guía en la carpeta docs/ del repositorio.
El análisis estático de JavaScript y .NET lee los ficheros sin ejecutar la aplicación. Los flujos de captura en tiempo de ejecución, en cambio, sí arrancan o interactúan con el objetivo usando tus permisos de usuario. No es lo mismo leer un .asar que lanzar un ejecutable que no conoces.
⚠️ Si vas a inspeccionar algo que no es de fiar, usa un entorno aislado. La propia documentación avisa de que trabajar en local no garantiza que el objetivo o las herramientas de terceros no tengan efectos externos.
¿Cómo se instala REA en Claude Code, Codex o Cursor? 
Con Node.js y npm instalados, un solo comando:
npx rea-agents setup
El asistente te enseña una lista de agentes, eliges los que quieres configurar, revisas los cambios propuestos y los apruebas. Después reinicias el agente. Eso es todo.
Requisitos de Node: 22.x (22.19 o superior), 24.x (24.11 o superior) o 26+. Si estás en Linux y vas a usar Ghidra, JADX o el análisis estático de JavaScript, necesitas además un ps compatible con procps en el PATH.
La parte que más me gusta del instalador es lo poco que se fía de sí mismo:
- Antes de escribir nada, comprueba tu configuración actual y te muestra las rutas exactas que va a tocar.
- Si encuentra una configuración rota o insegura, bloquea toda la operación antes de escribir un solo byte.
- Crea copias de seguridad (
.rea.backup) y reemplaza los ficheros de forma atómica. - Si pulsas Ctrl-C o dices que no, no cambia nada.
- Respeta las entradas y comentarios que no son suyos en tus ficheros de configuración.
Además del servidor MCP, el setup instala una skill con las instrucciones de investigación para tu agente. Si no la quieres, --skill=false.
¿Qué agentes son compatibles con REA? 
Según la guía de instalación, el setup configura 19 clientes: Claude Code, Claude Desktop, Codex, Cursor, Gemini CLI, Windsurf, Devin, OpenCode, Antigravity, GitHub Copilot CLI, Command Code, Qwen Code, Kimi Code, VS Code, Grok Build, OMP, Pi, Hermes y Qoder. Cualquier otro cliente que soporte servidores MCP locales puede usarlo con registro manual.
Si quieres configurar uno en concreto sin pasar por el menú:
# Configura solo Claude Code
npx rea-agents setup --client claude_code
Si usas OpenCode, encaja bien con lo que contamos en cómo usar OpenCode: un servidor MCP más en la lista y listo.
¿Necesito Hopper, Ghidra o IDA? 
Depende de lo que quieras mirar. Para análisis nativo profundo, sí, uno de los tres. Para JavaScript, Electron y .NET estático, no.
El setup puede instalar Hopper si se lo apruebas de forma explícita (es una aprobación aparte). Ghidra e IDA tienen que estar ya instalados en tu máquina; REA solo verifica y guarda sus rutas. Para análisis offline más ligero también acepta GNU objdump y Rizin, aunque no los instala ni los actualiza.
🛡️ Hopper, IDA Pro y JEB son herramientas comerciales. El README es tajante: REA no te da licencias, y copias crackeadas o claves robadas no están autorizadas. Si usas la demo de Hopper, sus términos siguen aplicando.
¿Cómo se actualiza? 
Si lo instalaste de forma global:
npm install --global rea-agents
rea update
Si tiras de npx, vuelve a lanzar el setup con la última versión: npx rea-agents@latest setup. Con Bun necesitas la 1.2.17 o posterior para que rea update funcione.
Cada semana aparecen herramientas como REA que cambian lo que un agente puede hacer. Cada domingo, +7.200 developers compartimos en la newsletter lo que vamos probando para adoptar IA en el desarrollo.
Apúntate gratis →¿Cómo se usa REA desde la terminal? 
No necesitas un agente para probarlo. La CLI ejecuta los mismos flujos que el servidor MCP, con una diferencia: cada comando es un proceso independiente, así que si quieres encadenar análisis tienes que guardar los resultados.
El ejemplo más rápido, sin instalar nada de forma global, es analizar una app Electron extraída:
npx -y rea-agents@latest analyze-javascript-application /ruta/absoluta/a/la/app --json
El resultado incluye los módulos, los imports, las fronteras de Electron (preload, proceso principal, renderer) y la evidencia de cada cosa.
Para un ensamblado .NET, sin ejecutarlo y sin motor nativo:
# Identidad y forma de despliegue del ensamblado
rea inspect-managed-artifact /ruta/absoluta/Assembly.dll --json

# Miembros de un tipo concreto
rea inspect-managed-members /ruta/absoluta/Assembly.dll --type Example.Parser --json
Y para una base de datos SQLite local, con una muestra acotada de filas:
rea inspect-sqlite-database /ruta/a/datos.db --table users --row-limit 20 --json
La CLI es muy útil para scripts y para entender qué hace cada herramienta antes de dejarla en manos del agente. Primero ves con tus ojos qué devuelve; luego delegas.
¿Qué son los prompts guiados de REA? 
Además de las herramientas, REA expone seis flujos de investigación a través de la capacidad prompts de MCP. No añaden herramientas: son puntos de partida para que el agente sepa cómo encadenar las que ya tiene.
| Prompt | Para qué sirve |
|---|---|
investigate_feature |
Rastrear una función desde su descubrimiento hasta la evidencia del código |
compare_application_versions |
Comparar dos versiones publicadas de una app |
verify_reconstruction |
Comprobar una reconstrucción contra la evidencia guardada |
trace_crash |
Relacionar un fallo con rutas de código y capturas del proceso |
audit_residual_unknowns |
Revisar lo que sigue sin resolver |
prepare_bounded_process_capture |
Diseñar un experimento controlado antes de ejecutar nada |
compare_application_versions me parece el más interesante para quien hace producto. ¿Qué cambió entre la versión 3.1 y la 3.2 de esa app que de repente va más rápida? Es una pregunta que antes requería un especialista y una semana.
Y prepare_bounded_process_capture es un buen ejemplo de la filosofía del proyecto: antes de ejecutar algo, diseña el experimento y acota qué vas a observar. Lo contrario de “lánzalo y a ver qué pasa”.
¿Qué se puede conseguir con REA? Tres casos reales 
El proyecto documenta tres casos completos en su web, cada uno con la evidencia publicada en el repositorio. Los tres tienen en común algo que me gusta: no se quedan en “mira qué bonito”, llegan hasta una comprobación.
DX-Ball: de 63 bytes a una función en C 
DX-Ball es un clon de Arkanoid para Windows de los noventa. Cuando la bola rompe un ladrillo, el sonido se escucha más a la izquierda o más a la derecha según dónde está el ladrillo. La pregunta era: ¿cómo calcula ese panorama?
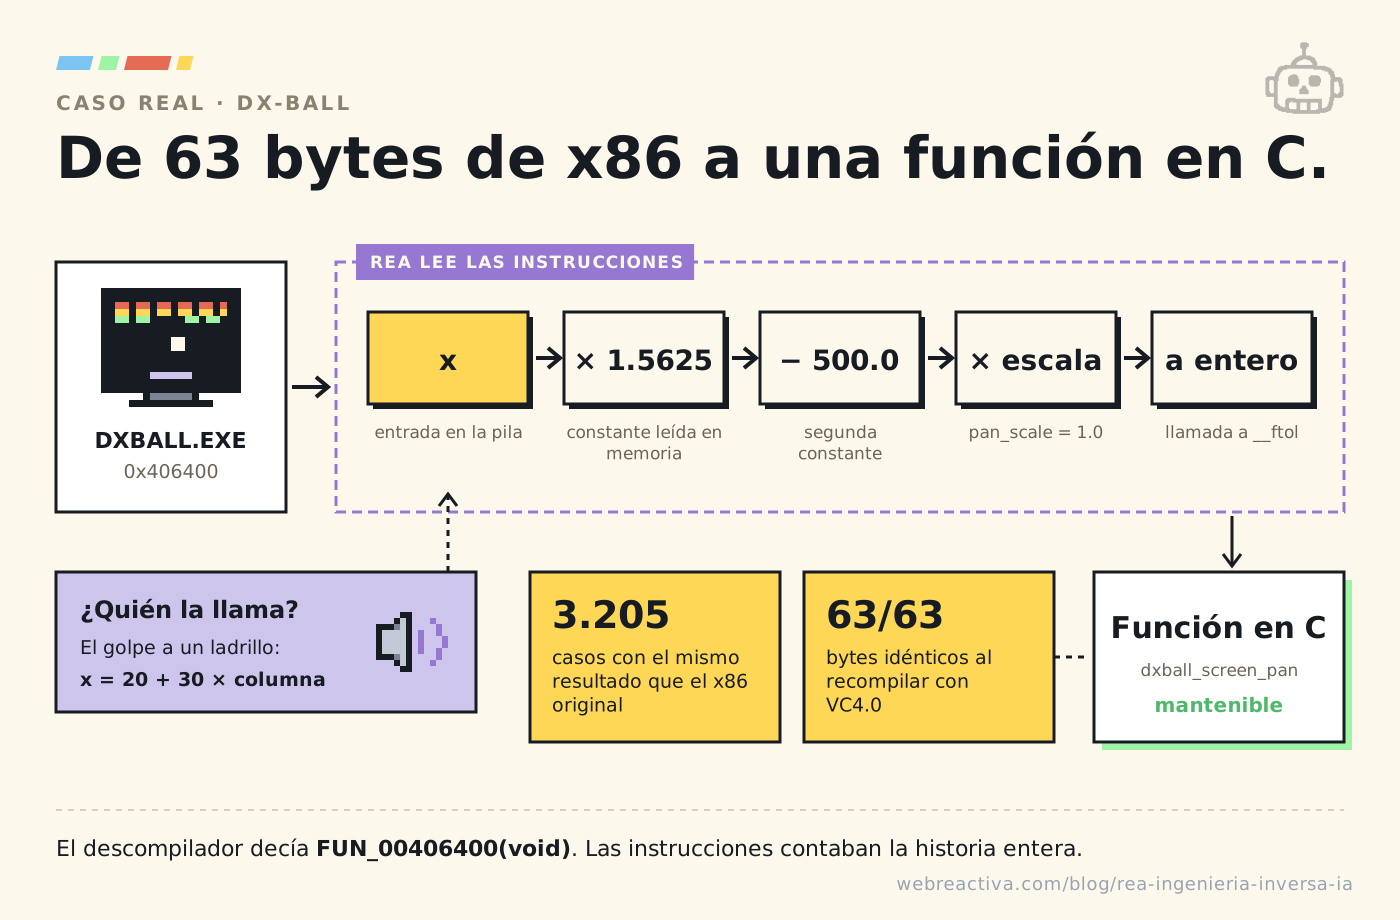
Según el dosier de evidencia del caso, el análisis se hizo con REA 4.1.0 y Ghidra 12.1.4 sobre el DXBALL.EXE de 158.208 bytes. La función vive entre 0x406400 y 0x40643e: 63 bytes.
El descompilador de Ghidra la presentaba como FUN_00406400(void), sin parámetros y sin la expresión de punto flotante. El pseudocódigo se había comido la mitad de la historia. Las instrucciones, en cambio, la contaban entera:
- Carga un entero de la pila: la posición
x. - La multiplica por una constante en memoria que, leída byte a byte, vale 1.5625.
- Le resta 500.0.
- La multiplica por una escala guardada que empieza en 1.0.
- La convierte a entero con una llamada a
__ftol.
Siguiendo al llamador, REA encontró de dónde sale x: el código del golpe al ladrillo calcula 20 + 30 × columna. Es la posición horizontal del ladrillo en pantalla.
Con eso, la reconstrucción en C pasa 3.205 casos comparados con el x86 original y, al compilarla con Visual C++ 4.0, reproduce los 63 bytes de la función compilada. No “se parece”. Es la misma.
🔑 Esta es la lección del caso: el pseudocódigo es una interpretación, las instrucciones son el hecho. Un agente que solo lee pseudocódigo hereda los errores del descompilador.
Notion: el puente del portapapeles en Electron 
El segundo caso es más cercano al día a día de un desarrollador web. Notion Desktop es una app Electron, y su portapapeles enriquecido pasa por varias capas: el renderer, el script de preload, el canal IPC y el proceso principal.
REA analizó el preload.js de la pestaña (24.579 bytes) de Notion Desktop 7.6.1 y localizó dos cosas con su posición exacta en el código: el puente expuesto al renderer como __electronApi y el envoltorio que hace invoke por IPC. Leyendo el resto del paquete, el canal resultó ser notion:clipboard:write, que en el proceso principal comprueba quién envía el mensaje y acaba llamando a clipboard.write de Electron.
El dosier del caso es honesto con sus límites: dice claro que el grafo automático no encontró la ruta completa del portapapeles: la traza por el nombre del canal no dio resultados. La página explica qué se observó con REA y qué se completó leyendo el código a mano.
Si alguna vez has montado un preload con contextBridge, este caso es una clase práctica de cómo lo resuelve una app de escritorio muy usada.
TH04: un juego de PC-98 en 16 bits 
El tercer caso es para nostálgicos: Touhou 4: Lotus Land Story, un juego de disparos japonés para el PC-98 que se ejecuta en DOS. La pregunta era cómo calcula los anillos de balas, tanto el fijo como el que apunta al jugador.
REA abrió el MAIN.EXE original (156.258 bytes, modo real x86) con Ghidra 12.1.4, recuperó los cálculos de ángulo a partir de las instrucciones de 16 bits y el C++ reconstruido se comparó después con la salida del compilador de la época. El resultado: 16 balas repartidas en 256 unidades de ángulo, es decir, 16 unidades (22,5°) entre bala y bala, con la primera en el ángulo 0 o en la dirección del jugador.
Tanto DX-Ball como TH04 tienen repositorio público con la reconstrucción completa, enlazado desde el README de REA.
Tu IA puede mentirte
El pseudocódigo puede mentir. Tu agente, también
Verás cómo revisar y verificar lo que programa tu agente con skills, pruebas en navegador y adversarial review entre modelos, igual que DX-Ball se comprobó contra el original.
Entrar a la masterclass →Métodos en directo + casos Gherkin · Acceso con Web Reactiva Premium
¿Dónde se ejecuta el análisis y qué datos salen de tu máquina? 
El análisis es local. REA no sube tu app a ningún sitio. Lo que sí sale es lo que tu agente recibe como resultado de las herramientas, y eso llega al proveedor del modelo con su propia política de datos.
Dicho de otra forma: el binario se queda en tu disco, pero el pseudocódigo, los strings y las referencias que el agente lee viajan al modelo como cualquier otra respuesta de una herramienta. Si analizas algo con información sensible, tenlo en cuenta igual que lo tendrías con cualquier otro servidor MCP.
⚠️ Con capturas de red, volcados de procesos o bases de datos es fácil que aparezcan credenciales o datos personales. La documentación te hace responsable de protegerlos. Revisa qué le pides al agente antes de dárselo.
Y luego está la parte legal, que en ingeniería inversa no es un trámite.
¿Es legal usar REA? 
REA está pensado para usos legítimos: investigación de seguridad, análisis de malware, CTFs, educación, interoperabilidad, preservación de software y depuración o auditoría de software que es tuyo o que tienes permiso para examinar.
El DISCLAIMER.md del proyecto también deja claro lo que no apoya:
- Saltarse DRM, comprobaciones de licencia o sistemas anti-trampas.
- Desarrollar trampas para juegos o manipular servicios online.
- Saltarse autenticación o controles de acceso de sistemas que no estás autorizado a probar.
- Copiar software propietario o reproducir su código y recursos protegidos.
Fíjate en ese último punto, porque choca con la promesa del README de “construir una versión para tu proyecto”. La línea que yo trazaría es esta: entender el mecanismo y escribir tu propia implementación es una cosa. Copiar el código descompilado y pegarlo en tu producto es otra muy distinta. El caso de Notion es un buen ejemplo de lo primero: aprendes cómo se monta un puente de portapapeles seguro en Electron y lo construyes a tu manera.
La ingeniería inversa además puede estar restringida por la ley de tu país o por la licencia del software que analizas. Que un ejecutable sea público no te da permiso para cualquier operación sobre él.
🛡️ Si dudas, pregúntate: ¿podría explicarle esto en voz alta al autor de la app sin ponerme rojo? Si la respuesta es no, para.
La ingeniería inversa con agentes está pasando ahora mismo, y lo vivimos en directo. Cada domingo, gratis desde 2018, 12 recursos para entender el cambio y poner orden en tu forma de trabajar con IA.
Suscríbete gratis →¿Qué limitaciones tiene REA? 
Ninguna herramienta lo hace todo, y REA es bastante transparente con lo que no cubre. Estas son las que he encontrado leyendo su documentación:
El soporte varía mucho según plataforma. Muchas funciones están verificadas solo en Linux x64 o solo en macOS arm64. El changelog de la 6.5.0 está lleno de frases como “other hosts remain unverified”. Si estás en Windows, el soporte de Ghidra todavía está marcado como experimental.
Depende de herramientas externas. TShark, sigrok, WABT, JADX, Apktool o pwntools tienen que estar instalados por ti, a veces en una versión concreta (WABT 1.0.42, sigrok-cli 0.7.2). REA no los instala.
Los motores nativos buenos son de pago. Ghidra es gratuito, pero Hopper e IDA Pro no. Y cada uno soporta formatos distintos.
Hopper en macOS pide intervención la primera vez. Al arrancarlo puede salir un diálogo para elegir modo demo o activar la licencia. Hay que completarlo a mano antes del primer uso desatendido.
Evoluciona muy rápido. Lo cual es bueno y malo. El README pide actualizar antes de reportar un bug porque es probable que ya esté arreglado.
La IA sigue siendo la IA. REA te da evidencia de calidad, pero quien la interpreta es tu modelo. Separar observación de inferencia ayuda mucho, aunque no hace milagros si el modelo decide ignorar los desconocidos.
| Aspecto | Valoración |
|---|---|
| Instalación en agentes | Excelente: un comando, con copias de seguridad y vista previa |
| JavaScript y Electron | Muy bueno: sin motor nativo y sin ejecutar nada |
| Binarios nativos | Bueno, si tienes Ghidra, Hopper o IDA a mano |
| Soporte en Windows | Limitado: varias piezas experimentales o sin verificar |
| Transparencia del resultado | Excelente: observaciones, inferencias y desconocidos separados |
| Curva de entrada | Media: la herramienta es fácil, la ingeniería inversa no |
Mi veredicto sobre REA 
Lo que más pesa de REA es que trata la evidencia como un ciudadano de primera. Cada resultado dice qué se vio, qué se dedujo y qué falta. Con agentes que rellenan huecos con una seguridad pasmosa, eso te evita reimplementar una constante que el modelo se inventó.
¿Para quién es? Para quien hace seguridad, CTFs o preservación de software, claro. Pero también para quien desarrolla apps Electron y quiere entender cómo resuelven otros los problemas que tiene delante. O para quien tiene que integrarse con un sistema cerrado y no tiene más documentación que el propio binario.
Mi recomendación: empieza por el análisis estático de una app Electron que tengas instalada. No necesitas Ghidra, no ejecutas nada y en diez minutos ves si el enfoque te encaja. Después, si te pica, pasa a los binarios nativos.
Eso sí, recuerda la línea: aprender cómo funciona algo y construir tu versión, sí. Copiar lo que no es tuyo, no.
TL;DR 
- 🔍 REA es un servidor MCP y una CLI open source (MIT) que le da a tu agente herramientas de ingeniería inversa para binarios, Electron, .NET, Android y webs.
- 🧾 Su seña de identidad es la evidencia: cada resultado separa observaciones, inferencias y desconocidos.
- ⚡ Se instala con
npx rea-agents setupen 19 clientes, entre ellos Claude Code, Codex, Cursor, OpenCode y Gemini CLI. - 🎯 Casos reales: una función de DX-Ball reconstruida en C que reproduce sus 63 bytes compilados y el puente de portapapeles de Notion en Electron.
- 🛡️ El análisis es local, pero los resultados llegan a tu modelo; y el uso tiene que ser legítimo y autorizado.
Preguntas frecuentes sobre REA 
¿Qué significa REA?
REA significa Reverse Engineer Anything. Es un servidor MCP y una CLI que conectan tu agente de IA con herramientas de ingeniería inversa para analizar binarios, aplicaciones y comportamiento en tiempo de ejecución sin tener el código fuente.
¿REA es gratis?
Sí. El código de REA tiene licencia MIT y se distribuye en npm como rea-agents. Algunas herramientas que puede usar por debajo, como Hopper o IDA Pro, son comerciales y necesitan su propia licencia.
¿Cómo instalo REA en Claude Code?
Ejecuta npx rea-agents setup, selecciona Claude Code, revisa los cambios propuestos y apruébalos. Después reinicia Claude Code. También puedes usar npx rea-agents setup --client claude_code para saltarte el menú.
¿Qué agentes de IA son compatibles con REA?
El instalador configura 19 clientes, entre ellos Claude Code, Claude Desktop, Codex, Cursor, Gemini CLI, Windsurf, OpenCode, VS Code y GitHub Copilot CLI. Cualquier cliente con soporte para servidores MCP locales puede usarlo con registro manual.
¿Necesito Ghidra para usar REA?
Solo para análisis nativo profundo, y puede ser Ghidra, Hopper o IDA. El análisis estático de JavaScript, Electron y .NET funciona sin ningún motor nativo.
¿REA sube mis aplicaciones a la nube?
No. El análisis se hace en tu máquina. Lo que sí llega al proveedor del modelo son los resultados que tu agente recibe de las herramientas, con la política de datos de ese proveedor.
¿Qué versión de Node.js necesita REA?
Node.js 22.x a partir de 22.19, 24.x a partir de 24.11 o la 26 en adelante, más npm. Para inspeccionar bases de datos SQLite hace falta Node 24.15 o superior, o la 26.
¿Puedo usar REA sin un agente de IA?
Sí. Todas las funciones están disponibles como comandos de la CLI rea, que usa los mismos flujos y el mismo formato de evidencia que el servidor MCP. Es útil para scripts y para entender qué devuelve cada herramienta.
¿Es legal hacer ingeniería inversa con REA?
Depende de tu jurisdicción, de la licencia del software y de tu autorización. REA está pensado para investigación de seguridad, educación, interoperabilidad, preservación y análisis de software propio o autorizado, y su disclaimer excluye saltarse DRM, licencias o anti-trampas.
¿En qué se diferencia REA de reverse-skill?
reverse-skill es un conjunto de instrucciones que le dice al agente qué metodología seguir en tareas de seguridad. REA es un servidor MCP con herramientas que abren y analizan los objetivos y devuelven evidencia estructurada. Pueden complementarse.
Fuentes 
- Repositorio de REA en GitHub: README,
CHANGELOG.md,DISCLAIMER.mdy la carpetadocs/. - Web oficial de REA, con guías y casos ilustrados.
- Paquete rea-agents en npm.
- Caso DX-Ball y su repositorio de reconstrucción.
- Caso Notion.
- Caso TH04 y su repositorio de reconstrucción.
🧨 Última oprtunidad para recibir la dinamita que mereces sobre programación con IA el próximo domingo: Suscríbete gratis a Web Reactiva en https://webreactiva.com/newsletter

Escrito con la ayuda de la IA generativa de Claude, fuentes fidedignas y con un human in the loop:
Dani Primo.
12 recursos para developers cada domingo en tu bandeja de entrada
Además de una skill práctica bien explicada, trucos para mejorar tu futuro profesional y una pizquita de humor útil para el resto de la semana. Gratis.