ODD vs SDD: Organic vs Spec Driven Development con IA
Tabla de contenidos
Le pides a tu agente que cambie el texto de un botón. Te devuelve una propuesta, una spec con tres escenarios, un documento de diseño y una lista de cuatro tareas. Para un botón.
Eso es lo que pasa cuando aplicas Spec Driven Development (SDD) a todo sin mirar el tamaño de lo que pides. Y es justo la queja de la que nace Organic Driven Development (ODD): una forma de trabajar con agentes en la que la ceremonia crece con el riesgo del cambio, no con la costumbre.
Los dos quieren lo mismo: que la IA no improvise y que tú no pierdas el hilo. Los dos usan una especificación escrita. La diferencia está en cuándo la escriben, cuánta escriben y quién decide que hace falta.
En este post vas a encontrar:
- Qué es ODD, de dónde sale y qué tiene de nuevo (y qué no)
- Cómo funciona el SDD y por qué se ganó su sitio
- La misma petición recorrida con los dos enfoques, paso a paso
- Una tabla frente a frente y una matriz para decidir cuál usar
- Cómo copiar las ideas de ODD aunque no instales ninguna herramienta
¿Qué es el Organic Driven Development (ODD)? 
ODD es un protocolo para agentes de código que adapta el proceso al tamaño real del cambio: los cambios pequeños y entendidos se hacen en línea, sin documentos, y solo el trabajo grande genera un único documento de feature que se puede retomar entre sesiones.
El término no viene de un libro ni de una conferencia. Viene de Gentle-AI, el proyecto open source de Gentleman Programming que configura los agentes que ya usas (Claude Code, OpenCode, Codex, Cursor, Pi) con memoria persistente, skills, personas y revisión. En su README lo resumen con una frase que es casi un manifiesto:
«Small changes should not need a planning pipeline, and larger work should not lose its context between sessions.»
Traducido a lenguaje de pasillo: un arreglo de tres líneas no necesita una reunión, y una feature de tres días no puede depender de que te acuerdes de todo el lunes.
Conviene ser honesto con una cosa desde el principio.
ODD no es una metodología con décadas detrás como TDD. Es el nombre que un proyecto concreto le ha dado a su forma de orquestar agentes. No hay papers ni un comité. Lo que sí hay es un protocolo escrito con mucho detalle, decisiones tomadas a partir de benchmarks propios y una historia interesante: el mismo proyecto empezó apostando por SDD.
¿De dónde sale ODD y por qué Gentle-AI dejó atrás el SDD? 
Gentle-AI tenía un flujo SDD completo, con comandos /sdd-* e integración con OpenSpec. En la v3.0.0 convirtieron ODD en el protocolo obligatorio por defecto del orquestador y dejaron SDD como una rama opcional «entrada solo por petición explícita». En las notas de esa versión explican que quitaron ceremonia que se había convertido en «gatekeeping rather than value»: un peaje, no un valor.
En la v4.0.0 fueron más lejos: «SDD and OpenSpec are removed». Los comandos /sdd-*, los perfiles y las fases de SDD desaparecen y ODD queda como única ruta de desarrollo.
Eso no demuestra que el SDD esté muerto. Demuestra que un equipo que lo usaba a diario decidió que, como modo por defecto, le salía caro. Que es una conclusión muy distinta y bastante más útil.
🔑 ODD no elimina la especificación. La mueve: deja de ser un paso obligatorio de entrada y pasa a ser algo que aparece cuando el trabajo lo pide.
¿Cómo funciona el ODD paso a paso? 
El protocolo tiene siete pasos y se aplica a cada petición, sin que tengas que pedir un plan ni elegir un flujo. Esto es lo que hace el agente, según la documentación de uso de Gentle-AI:
- Autorizar. Decide si tu petición autoriza un cambio. Una pregunta, una revisión o una propuesta se quedan en solo lectura. Si dices «¿por qué falla este test?», el agente investiga y te lo cuenta, pero no toca nada.
- Explorar. Lee el código existente y los requisitos, en proporción a lo que pides. No se lee medio repositorio para cambiar un literal.
- Resolver la incertidumbre. Investigación opcional si hay una duda concreta, como mucho una pregunta enfocada si hay una decisión de producto real y, si la premisa es arriesgada y no está probada, un único desafío a esa suposición.
- Clasificar. Es el paso que más pesa y tiene su propia sección justo debajo.
- Registrar antes de escribir. Si el trabajo es grande, crea un documento de feature antes de la primera línea de código y te avisa en una línea de cuántas tareas tiene.
- Implementar tarea a tarea. Con test primero cuando existe un test ejecutable y un resultado esperado claro (RED → GREEN → REFACTOR) y commits en trozos revisables de unas 400 líneas cambiadas.
- Cerrar. Informa del resultado verificado, de cada check que falló o quedó pendiente y del siguiente paso.
Fíjate en el paso 1. Parece una tontería y es de lo más útil del protocolo.
¿Cuántas veces has preguntado algo a un agente y te ha contestado editando cuatro ficheros? Separar «pregúntame» de «cámbialo» evita una cantidad absurda de diffs que no pediste.
¿Cómo decide ODD si una tarea es pequeña o grande? 
Por entendimiento, riesgo y capacidad de retomarla. Nunca por número de ficheros.
Una tarea es pequeña cuando se cumplen tres condiciones: se entiende, el riesgo está contenido y se podría retomar solo con la petición original más el git diff. Si mañana alguien abre el diff y la petición, y con eso sabe por dónde iba, la tarea es pequeña aunque toque doce ficheros.
Pasa a ser grande solo cuando falla esa prueba del diff: varias sesiones, esperas externas (una respuesta de otro equipo, un deploy) o requisitos tan largos que no sobrevivirían a una compactación del contexto.
Es un criterio más fino de lo que parece. Un renombrado masivo con el IDE toca 80 ficheros y es pequeño. Cambiar la lógica de redondeo de una factura toca un fichero y quizá no lo sea, porque nadie lo retoma sin saber qué decidiste y por qué.
💡 La prueba del diff te sirve aunque no uses ningún agente: si mañana no podrías continuar esto solo con la petición y el diff, apúntalo en algún sitio hoy.
¿Qué es el documento de feature de ODD? 
Cuando la tarea es grande, ODD crea un único fichero: odd/tasks/<nombre-feature>.md. No una carpeta con propuesta, diseño, specs y tareas. Uno. Con un orden fijo:
# Exportar tareas a CSV## Specs- S1: «El botón dice "Exportar CSV" y descarga tareas.csv» <!-- tus palabras, literales -->- S2: «Si no hay tareas, el botón aparece deshabilitado»- S3: Las fechas van en ISO 8601 (criterio de aceptación)## Tasks- T1 (S1, S3): endpoint GET /tasks/export — commit a1b2c3d- T2 (S1, S2): botón en la vista de lista — pendiente## Log- L1: «Añade exportar a CSV en la lista de tareas. Que el botón diga "Exportar CSV" y si no hay tareas, deshabilitado.»- L2: Cambio pedido: separador ; en vez de , para Excel en españolTres detalles marcan la diferencia con muchos flujos SDD:
- Las specs citan tus palabras literales. Los textos, mensajes de error y ejemplos que diste van entre comillas, tal cual.
L1es tu petición original, sin tocar. Lo que viene después se añade al log, no reescribe la historia.- A los subagentes se les pasa una referencia al documento, nunca un resumen. Cada trabajador recibe la ruta, su tarea y sus
S#.
Ese último punto no es una manía de estilo. En los benchmarks que publica el propio README, una spec de 73 líneas con 26 checks ocultos se pasaba parafraseada entre agentes y acababa con 13 fallos; tras dos rondas de correcciones seguía en 23 de 26. Pasándola por referencia, pasó. Cada paráfrasis es un teléfono escacharrado.
Si además tienes Engram (la memoria persistente del mismo ecosistema), el documento se replica en memoria para retomar la feature en otra sesión. Si no está disponible, el agente debe decirlo en vez de dar el progreso por guardado.
Antes de decidir si te sobra el SDD, recorre un ciclo entero
En seis vídeos instalas OpenSpec en un proyecto que ya existe y pasas por proposal, spec, tareas, apply y archivo. Así comparas con criterio y no de oídas.
Entra en el curso gratis →¿Qué es el Spec Driven Development y por qué se ganó su sitio? 
El SDD es una forma de programar con IA en la que escribes primero una especificación de qué debe hacer el software y solo después dejas que el agente genere el código. La spec es la fuente de verdad; el código es una consecuencia.
Ya tenemos una guía completa sobre qué es el Spec Driven Development y cómo escribir specs útiles, así que aquí vamos a lo que importa para la comparación: el flujo.
Con OpenSpec, uno de los frameworks más usados, el ciclo típico es:
/opsx:propose— describes el cambio y se genera una carpeta enopenspec/changes/<cambio>/con la propuesta, los deltas de spec (requisitos y escenarios), el diseño y la lista de tareas.- Revisas y ajustas esos documentos hasta que dicen lo que quieres.
/opsx:apply— el agente implementa siguiendo las tareas.- Verificas contra los escenarios de la spec.
/opsx:archive— los deltas se fusionan en las specs vivas del proyecto.
Spec Kit, de GitHub, y Kiro, de AWS, siguen variantes de la misma idea: especificar, planificar, dividir en tareas, implementar. Si quieres ver cómo se diferencian, en la comparativa de frameworks SDD están frente a frente.
¿Por qué funcionó tan bien? Porque atacaba un problema muy real.
La encuesta de Stack Overflow de 2025 recoge que el 84 % de los desarrolladores usa o piensa usar herramientas de IA, pero el 46 % desconfía de la precisión de lo que generan, y la mayor frustración, citada por el 66 %, son las soluciones que están «casi bien». El SDD es una respuesta directa a ese «casi»: si dejas escrito qué es «bien» antes de empezar, el agente tiene menos espacio para el casi.
Y hay otro dato que conviene tener presente. En el estudio de METR de 2025 con desarrolladores experimentados de proyectos open source, usar IA los hizo un 19 % más lentos, aunque ellos creían haber ido un 20 % más rápido. La sensación de velocidad no es velocidad. Parte del atractivo del SDD es que te obliga a pensar antes de que esa sensación te engañe.
¿Dónde se atasca el SDD? 
El SDD se atasca cuando el coste de la ceremonia supera el valor del cambio. Y eso pasa más de lo que admiten sus defensores.
Los problemas que más se repiten, y que ya tratamos en los errores comunes al hacer Spec-Driven Development, son:
- Ceremonia fija. El flujo es el mismo para un typo que para un sistema de pagos.
- Dos fuentes de verdad. Si alguien arregla algo a mano y no actualiza la spec, ya tienes dos versiones de la realidad.
- Specs que nadie lee. Cuatro documentos generados por la IA, revisados en diagonal, son una spec en teoría y un trámite en la práctica.
- Requisitos que no sabes escribir. Si todavía no entiendes el problema, la spec te pide una claridad que no tienes. Es la crítica de fondo del famoso «spec driven development doesn’t work if you’re too confused to write the spec».
Birgitta Böckeler, en su análisis de Kiro, Spec Kit y Tessl en martinfowler.com, ya señalaba que estas herramientas generan mucho texto para cambios pequeños y que revisar markdown no siempre es más cómodo que revisar código. Marmelab lo tituló sin anestesia: «Spec-Driven Development: The Waterfall Strikes Back».
⚠️ El SDD no fracasa por escribir specs. Fracasa cuando la spec se escribe por obligación y no porque el cambio la necesite.
Cada semana aparece un flujo nuevo para trabajar con agentes y cuesta separar lo que dura de lo que no. Cada domingo, +7.500 developers compartimos lo que estamos probando con IA en el día a día.
Quiero esa dinamita 🧨¿Cómo se ve la misma tarea con ODD y con SDD? 
Vamos a lo práctico. Tienes una app de tareas y pides:
«Añade un botón de exportar a CSV en la lista de tareas. Que diga “Exportar CSV” y que esté deshabilitado si no hay tareas.»
Antes de los detalles, la foto completa de los dos recorridos:
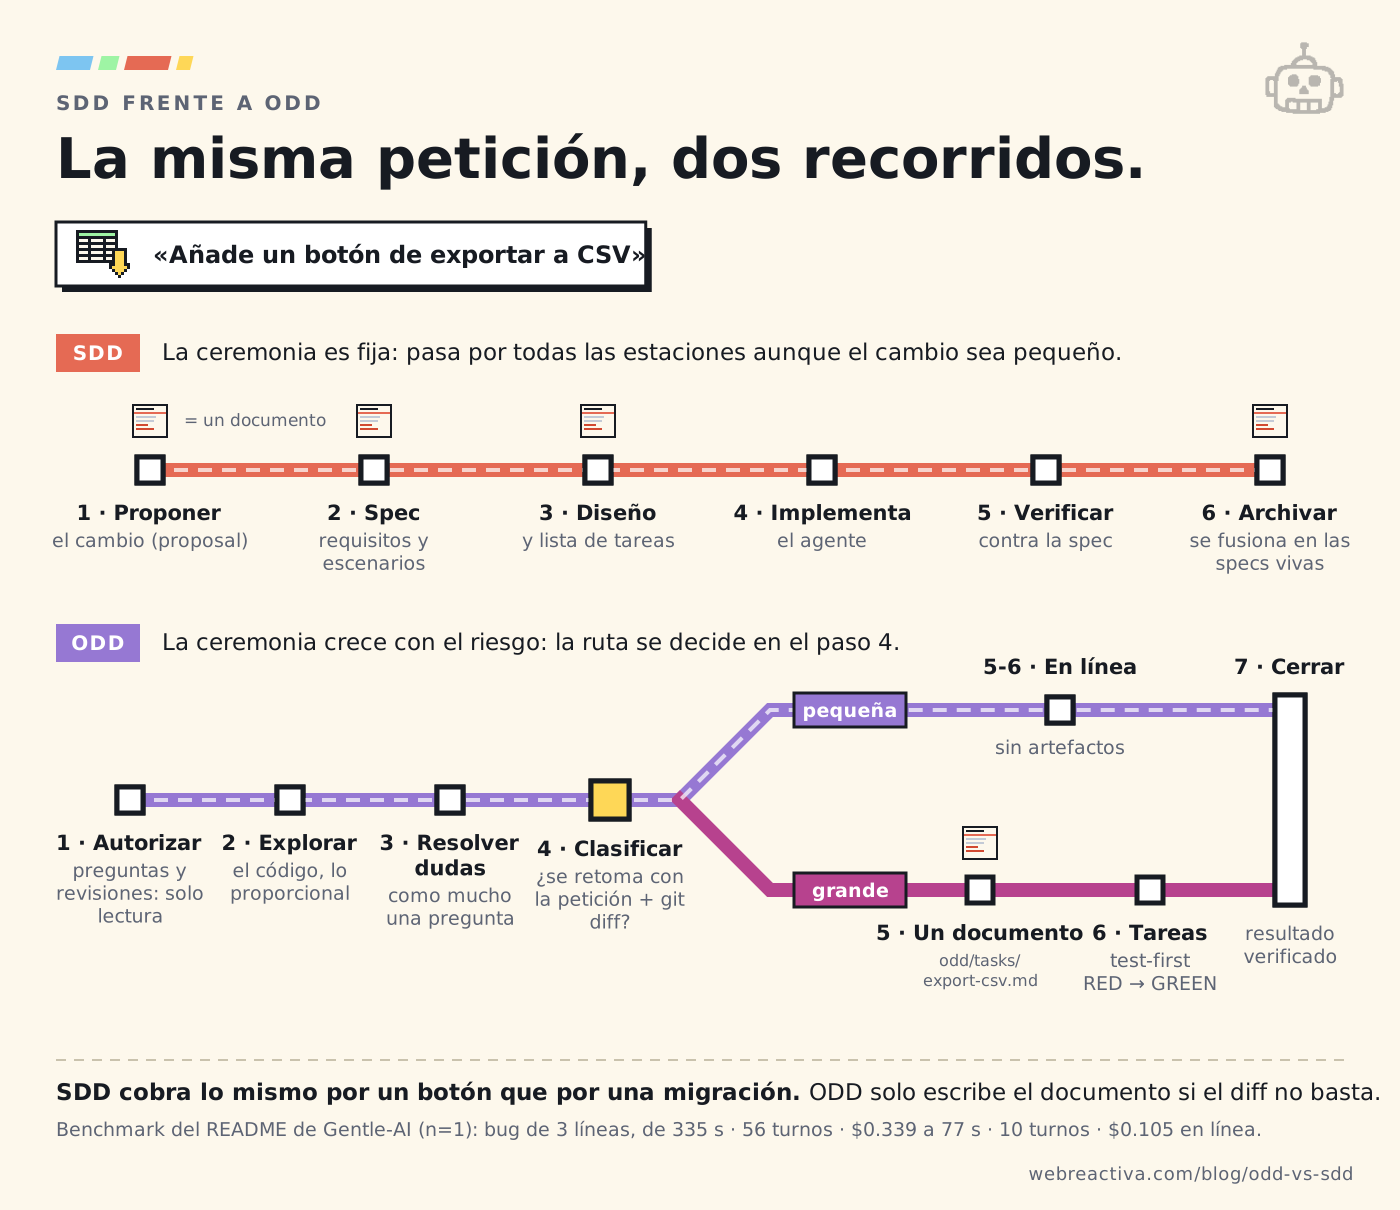
El recorrido con SDD (OpenSpec) 
- Lanzas
/opsx:propose exportar-csv. - Se crea
openspec/changes/exportar-csv/conproposal.md, un delta de spec con el requisito y sus escenarios,design.mdytasks.md. - Lees los cuatro documentos. Corriges que el separador sea
;porque tu equipo abre los CSV con Excel en español. /opsx:apply. El agente implementa las tareas.- Compruebas los escenarios: botón visible, fichero descargado, botón deshabilitado sin tareas.
/opsx:archive. La spec de «lista de tareas» de tu proyecto ahora incluye la exportación.
Resultado: buena trazabilidad, una spec viva actualizada y unos cuantos minutos de lectura para un cambio que cabía en una tarde.
El recorrido con ODD 
- Autorizar: «añade» es una orden de cambio. Hay permiso para escribir.
- Explorar: el agente busca dónde se pinta la lista y si ya existe algún endpoint de exportación.
- Resolver: hay una decisión de producto que no puede tomar solo. Pregunta una vez: «¿separador
,o;?». Respondes;. - Clasificar: es un endpoint y un botón, se entiende, el riesgo es bajo y mañana se retoma con la petición y el diff. Pequeña.
- Registrar: no se crea ningún documento.
- Implementar: primero un test que falla («sin tareas, el botón está deshabilitado» y «la respuesta tiene cabecera
text/csv»), luego el código, luego refactor con los tests en verde. - Cerrar: te dice qué hizo, qué tests pasan y si quedó algo pendiente.
Ahora cambia la petición: «Exportar a CSV, a Excel y a PDF, con filtros por proyecto, y que los ficheros grandes se generen en segundo plano y lleguen por email». Eso no se retoma con un diff: hay colas, plantillas, varias sesiones y probablemente esperas. ODD lo clasifica como grande y crea odd/tasks/exportar-informes.md antes de tocar código.
Es decir: con SDD los dos casos pasan por las mismas estaciones; con ODD solo el segundo.
ODD vs SDD: ¿en qué se diferencian de verdad? 
Se diferencian en tres cosas: cuándo aparece la especificación, cuántos artefactos genera y quién decide que hace falta. En el SDD la spec es la entrada obligatoria y la decides tú lanzando el flujo; en ODD es una consecuencia del tamaño del trabajo y la decide el protocolo con la prueba del diff.
| Qué comparamos | SDD (OpenSpec, Spec Kit, Kiro) | ODD (Gentle-AI) |
|---|---|---|
| Punto de partida | Escribir la spec | Entender la petición y si autoriza cambios |
| Cambios pequeños | Mismo flujo completo | En línea, sin documentos |
| Cambios grandes | Carpeta con propuesta, specs, diseño y tareas | Un único documento de feature |
| Quién activa el proceso | Tú, con un comando | El protocolo, en cada petición |
| Tus palabras | Reformuladas en requisitos y escenarios | Citadas literales en S# y L1 |
| Specs del proyecto a largo plazo | Sí, se archivan y forman una spec viva | No es su objetivo: el documento es de la feature |
| Tests | Según el framework y tu disciplina | Test primero por defecto si hay test ejecutable |
| Coste en cambios pequeños | Alto | Bajo |
| Trazabilidad para equipos y auditoría | Excelente | Buena en lo grande, mínima en lo pequeño |
| Riesgo principal | Burocracia y specs que nadie lee | Clasificar como pequeño algo que no lo era |
La fila de las specs a largo plazo es la que más se olvida en los debates.
El SDD no solo sirve para guiar al agente en un cambio. Con el tiempo te deja un catálogo de comportamiento del sistema: qué hace cada parte y por qué. ODD no aspira a eso. Su documento vive para una feature y su propósito es que se pueda retomar y verificar, no documentar el producto entero.
Si en tu empresa alguien te pide «¿dónde está escrito cómo se calcula el IVA en devoluciones?», el SDD tiene una respuesta mejor.
¿Qué dicen los números del propio Gentle-AI? 
El README de Gentle-AI publica una tabla de antes y después de introducir el enrutado proporcional, con Gentle Shell sobre un benchmark local con suites de aceptación ocultas. Avisan de que cada celda es una única ejecución (n=1) y de que el coste es equivalente a precio de API. Tómalo como una pista, no como una ley.
| Escenario | Antes | Después |
|---|---|---|
| Bug de 3 líneas en una función | 335 s · 56 turnos · 0,339 $ | 77 s · 10 turnos · 0,105 $, en línea y sin subagentes |
| Bug en lógica compartida | 479 s · 0,361 $ | 276 s · 0,207 $, con un explorador |
| Migración de datos (alto riesgo) | 559 s · 0,403 $ · necesitó una ronda de feedback | 539 s · 0,555 $ · aceptada a la primera, con un verificador independiente |
El bug pequeño se resuelve unas cuatro veces más rápido, vale. Pero mira la migración de alto riesgo: el proceso se vuelve más caro a propósito, porque añade un verificador independiente, y a cambio sale bien a la primera.
Ahí tienes ODD resumido en una tabla: gastar poco donde el riesgo es bajo y gastar más donde duele equivocarse.
También publican sus límites, cosa que se agradece. Frente al mismo modelo en Codex CLI, la tarea grande tardó unas tres veces más (17,5–17,9 minutos frente a 6,1), y lo marcan como trabajo pendiente.
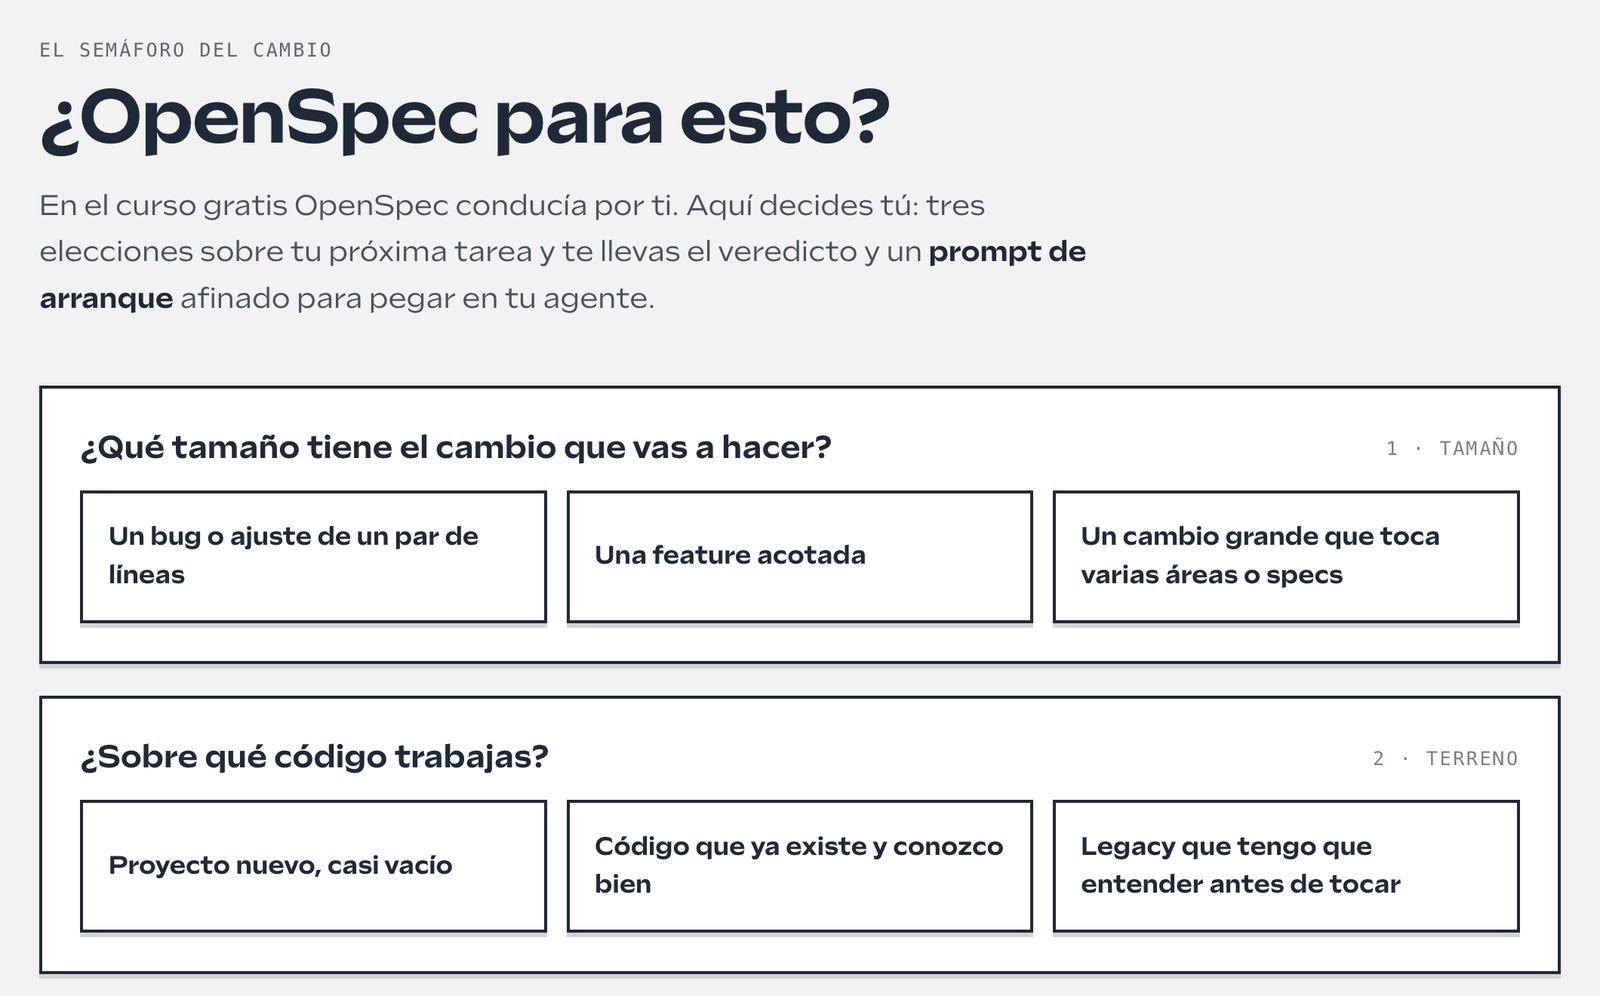
¿Cuándo usar ODD y cuándo SDD? 
Usa ODD como modo por defecto para el día a día y reserva el SDD para el trabajo donde la spec tiene valor más allá del propio cambio. La pregunta que decide no es «¿cuánto código es?», sino «¿cuánto me cuesta equivocarme y cuánto me cuesta retomarlo?».
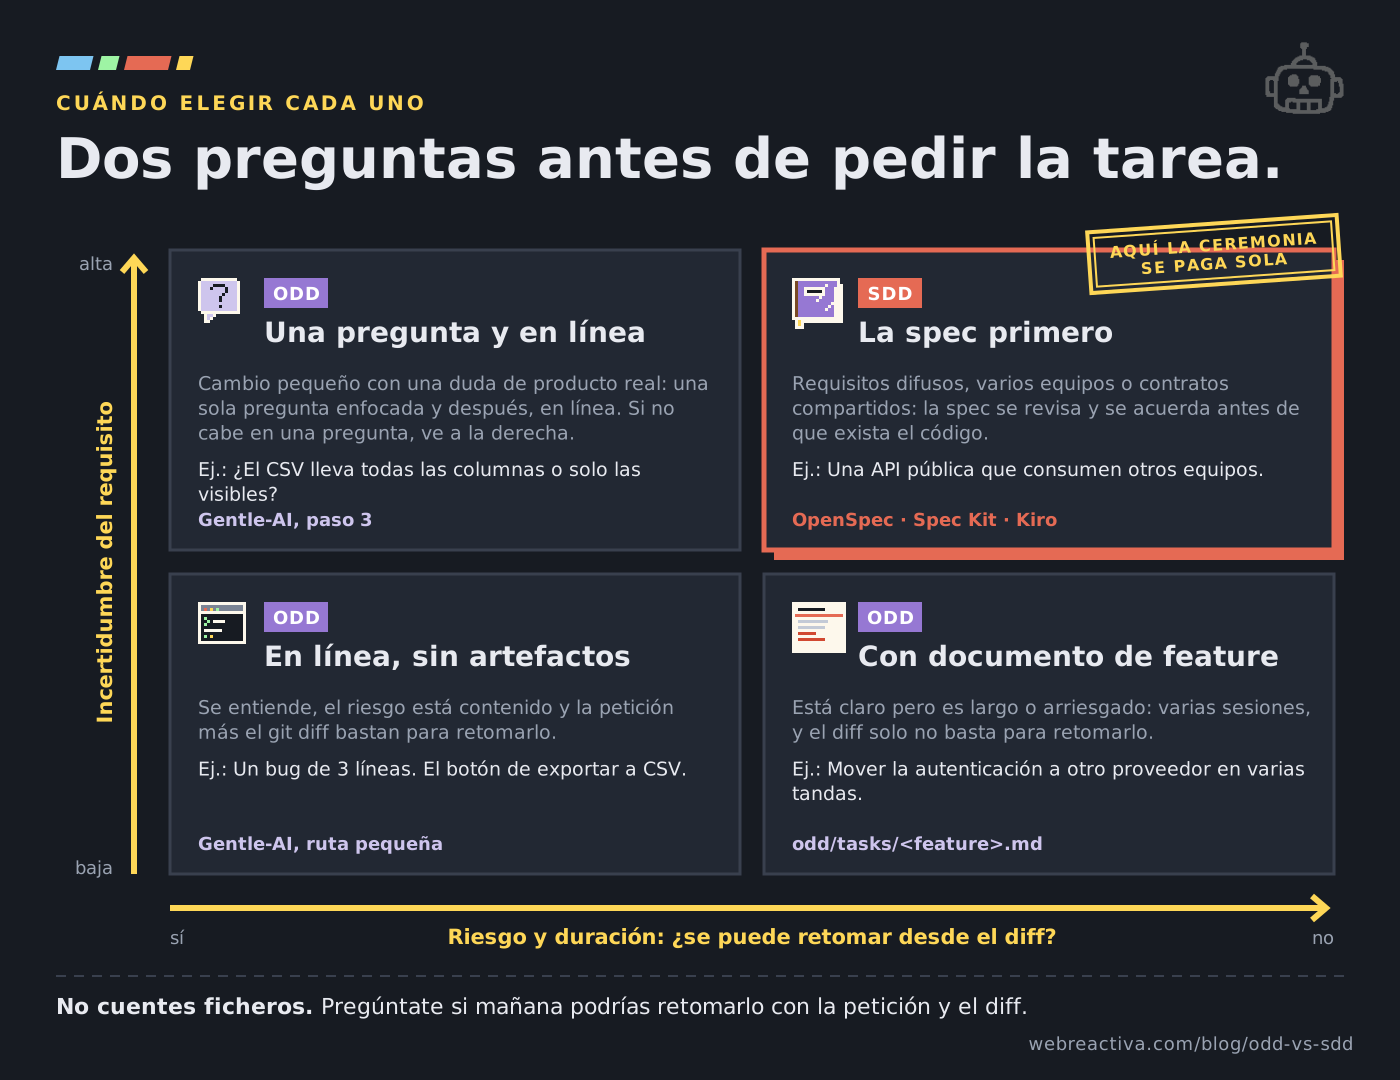
Elige ODD en línea cuando:
- El cambio se entiende a la primera y lo retomarías con el diff.
- Es un bug acotado, un ajuste de UI, un refactor mecánico o una dependencia que actualizar.
- Vas solo o en un equipo pequeño que revisa por PR.
Elige ODD con documento de feature cuando la tarea es clara pero larga: varias sesiones, esperas externas o requisitos que no quieres que se pierdan en una compactación.
Y elige SDD cuando:
- Varios equipos o servicios dependen del mismo contrato (una API pública, un esquema de eventos).
- Necesitas trazabilidad formal: auditorías, sectores regulados, clientes que firman requisitos.
- Quieres construir una documentación viva del comportamiento del sistema.
- El requisito todavía es difuso y necesitas pensar por escrito antes de que nadie programe. Aquí el SDD no es burocracia: es la herramienta para aclararte.
El último punto contradice un poco la crítica de «too confused to write the spec». Si estás confuso, escribir la spec no funciona como entrada para el agente, pero sí como ejercicio para ti. La diferencia es no lanzar /opsx:apply hasta que la spec diga algo.
🛡️ Hay un caso donde ODD te puede morder: cuando el agente clasifica como pequeño algo que tenía trampa. Si tocas dinero, permisos, datos de usuarios o migraciones, sube el nivel tú, aunque el diff parezca corto.
¿Se pueden combinar ODD y SDD? 
Sí, y es probable que sea lo más sensato en un equipo mediano. La propia v3.0.0 de Gentle-AI lo planteaba así antes de retirar el SDD en la v4: SDD como una rama dentro de ODD, a la que solo se entra por petición explícita o por una propuesta aceptada.
Un reparto que funciona:
- ODD para todo por defecto. Arreglos, ajustes, features normales.
- SDD para los contratos. Cuando el cambio toca una API pública, un esquema compartido o una regla de negocio que otros van a consultar, escribe la spec en OpenSpec y archívala.
- El documento de feature de ODD enlaza a la spec. No dupliques: el
S#puede decir «cumple el requisito R3 deopenspec/specs/facturacion».
Así no pagas ceremonia en el 80 % del trabajo y no pierdes la memoria del sistema en el 20 % que la necesita.
Si estás buscando cuánto proceso necesita tu equipo con agentes, en la newsletter de los domingos contamos lo que funciona y lo que no en proyectos reales. Gratis, desde 2018.
Suscríbete gratis →¿Cómo aplicar ODD sin instalar Gentle-AI? 
No necesitas instalar nada para robar las mejores ideas de ODD. Son reglas, y las reglas caben en tu CLAUDE.md o AGENTS.md. Si no tienes claro cómo se organizan, aquí explicamos cómo escribir reglas y contexto en AGENTS.md.
Un bloque mínimo, inspirado en el protocolo:
## Cómo trabajamos- Si te pregunto o te pido revisar algo, NO edites ficheros. Responde y espera.- Antes de cambiar código, lee el código relacionado. Proporcional a la tarea.- Si hay una decisión de producto que no puedes tomar, hazme UNA pregunta.- Tarea pequeña = la entiendes, el riesgo es bajo y se retoma con mi petición + git diff. Hazla sin planes ni documentos.- Tarea grande = no se retoma con el diff (varias sesiones, esperas, requisitos largos). Antes de escribir código crea docs/tasks/<feature>.md con: ## Specs (mis frases literales entre comillas, numeradas S1, S2…) ## Tasks (una línea por tarea con sus S#) ## Log (L1 = mi petición original, literal)- Si existe un test ejecutable: primero un test que falle, luego el código.- Al terminar: qué verificaste, qué falló o quedó pendiente y el siguiente paso.- Si delegas en un subagente, pásale la ruta del documento, nunca un resumen.Es una versión de bolsillo. No tiene la memoria, ni la revisión con recibos (RDD), ni el enrutado medido de Gentle-AI. Pero te da el 80 % del cambio de mentalidad en diez líneas.
Si quieres probar el protocolo completo, el README de Gentle-AI explica la instalación y su documentación de uso recoge el detalle de cada paso.
¿Qué aprendemos de este cara a cara? 
Que el debate no es «specs sí» contra «specs no». Los dos enfoques escriben especificaciones. Uno las pone siempre en la puerta; el otro las saca cuando el trabajo lo pide.
El SDD te protege de la improvisación. ODD te protege de la burocracia. Y las dos cosas matan proyectos, solo que a velocidades distintas.
Si te quedas con una sola idea, que sea la prueba del diff: antes de decidir cuánto proceso necesitas, pregúntate si podrías retomar esto mañana solo con la petición y el git diff. Si la respuesta es sí, hazlo y ya. Si es no, escríbelo antes de empezar.
TL;DR 
- 🌱 ODD (Organic Driven Development) es el protocolo por defecto de Gentle-AI: cambios pequeños en línea, sin documentos; trabajo grande con un único documento de feature.
- 📜 SDD (Spec Driven Development) pone la especificación como entrada obligatoria y fuente de verdad, con herramientas como OpenSpec, Spec Kit o Kiro.
- 🧪 La prueba del diff decide en ODD: si se retoma con la petición y el
git diff, es pequeña, toque los ficheros que toque. - ⚡ En el benchmark de Gentle-AI (n=1), un bug de 3 líneas bajó de 335 s y 56 turnos a 77 s y 10 turnos al dejar de usar subagentes.
- 🎯 Usa ODD como modo diario y reserva el SDD para contratos compartidos, trazabilidad formal y specs vivas del sistema.
Preguntas frecuentes 
¿Qué significa ODD en programación con IA? 
ODD significa Organic Driven Development. Es el protocolo por defecto de Gentle-AI para agentes de código: decide si la petición autoriza cambios, explora el código, clasifica la tarea por entendimiento, riesgo y capacidad de retomarla, y solo crea documentación persistente cuando el trabajo es grande.
¿ODD es una metodología estándar como TDD? 
No. ODD es el nombre que el proyecto open source Gentle-AI, de Gentleman Programming, da a su protocolo de trabajo con agentes. No tiene literatura académica detrás, aunque sus ideas (proceso proporcional al riesgo, test primero, specs literales) se pueden aplicar en cualquier flujo.
¿Qué diferencia hay entre ODD y SDD? 
El SDD escribe siempre la especificación antes del código y usa el mismo flujo para cualquier cambio. ODD solo genera un documento de feature cuando la tarea no se puede retomar con la petición y el git diff; los cambios pequeños se hacen en línea. Además, ODD cita tus palabras literales en vez de reformularlas.
¿ODD sustituye al Spec Driven Development? 
En Gentle-AI sí: la v4.0.0 retiró SDD y OpenSpec y dejó ODD como única ruta. Fuera de ese proyecto, no tiene por qué. El SDD sigue siendo mejor cuando necesitas trazabilidad formal, contratos compartidos entre equipos o una documentación viva del comportamiento del sistema.
¿Cómo decide ODD si una tarea es pequeña o grande? 
Con la prueba del diff. Una tarea es pequeña si se entiende, el riesgo está contenido y se podría retomar con la petición original más el git diff. Pasa a ser grande solo cuando eso falla: varias sesiones, esperas externas o requisitos demasiado largos. El número de ficheros nunca decide.
¿Qué contiene el documento de feature de ODD? 
Es un único fichero odd/tasks/<feature>.md con tres secciones: ## Specs, con requisitos numerados que citan tus frases literales y criterios de aceptación; ## Tasks, una línea por tarea con sus specs y su commit; y ## Log, donde L1 es tu petición original y después se añaden cambios y evidencias.
¿ODD obliga a usar TDD? 
Aplica test primero por defecto cuando existe un test ejecutable y determinista y un resultado esperado claro: test en rojo, código, test en verde y refactor. Si no hay un test que tenga sentido, el agente debe explicar la excepción y ejecutar igualmente comprobaciones funcionales.
¿Puedo usar ODD con Claude Code? 
Sí. Gentle-AI configura Claude Code, OpenCode, Codex, Cursor y Pi, entre otros. Si no quieres instalarlo, puedes copiar las reglas básicas de ODD en tu CLAUDE.md o AGENTS.md: separar preguntas de cambios, la prueba del diff y el documento de feature solo para trabajo grande.
¿Cuándo es mejor seguir usando SDD? 
Cuando el cambio toca un contrato del que dependen otros equipos, cuando trabajas en un sector con auditorías o requisitos firmados, cuando quieres mantener specs vivas del sistema o cuando el requisito es tan difuso que necesitas pensarlo por escrito antes de programar.
¿Cuál es el mayor riesgo de ODD? 
Que el agente clasifique como pequeña una tarea que escondía riesgo, como un cálculo de dinero, un cambio de permisos o una migración de datos. El protocolo prevé verificadores independientes para cambios de alto riesgo, pero conviene que subas tú el nivel cuando sepas que el terreno es delicado.
Fuentes 
- Gentle-AI — repositorio oficial (Gentleman-Programming/gentle-ai)
- Gentle-AI — documentación de uso: Organic Driven Development
- Gentle-AI — Intended usage
- Gentle-AI v3.0.0 — Organic Driven Development as the Default Workflow
- Gentle-AI v4.0.0 — SDD Retires, ODD Leads
- OpenSpec — repositorio oficial (Fission-AI/OpenSpec)
- Spec Kit — repositorio oficial (github/spec-kit)
- Understanding Spec-Driven Development: Kiro, spec-kit y Tessl (Birgitta Böckeler, martinfowler.com)
- Spec-Driven Development: The Waterfall Strikes Back (Marmelab)
- Stack Overflow Developer Survey 2025 — sección de IA
- Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity (METR)
🧨 Última oportunidad para recibir la dinamita que mereces sobre programación con IA el próximo domingo: Suscríbete gratis a Web Reactiva en https://webreactiva.com/newsletter

Escrito con la ayuda de la IA generativa de Claude, fuentes fidedignas y con un human in the loop:
Dani Primo.
12 recursos para developers cada domingo en tu bandeja de entrada
Además de una skill práctica bien explicada, trucos para mejorar tu futuro profesional y una pizquita de humor útil para el resto de la semana. Gratis.