Gemini 4 Neon vs Hydrogen: precio, benchmarks y cuál elegir
Tabla de contenidos
Argon, Carbon, Hydrogen y Neon.
No es la tabla periódica de tu instituto. Es la familia Gemini 4 al completo, y Google la ha soltado en siete semanas. Los dos primeros llegaron con tablas espectaculares y acceso restringido. Los dos últimos, Gemini 4 Hydrogen (12 de noviembre) y Gemini 4 Neon (18 de noviembre), son los que de verdad vas a poder usar en tu día a día.
Y aquí cambia el tono del lanzamiento. Neon no promete ser el más listo del mundo: promete casi la inteligencia de Carbon con un 32 % menos de coste por tarea, según Google. Hydrogen promete ser el modelo por defecto para todo lo demás, a la mitad de precio que Neon y gratis en la API con límites.
¿Se sostiene eso cuando lo mide alguien que no es Google? En parte sí. Y en parte hay una sorpresa: en el índice de Vals AI, Hydrogen sale más caro por prueba que Neon, aunque cada token cueste la mitad.
Lo que vas a encontrar aquí:
- Qué son Neon y Hydrogen y dónde encajan frente a Argon y Carbon.
- Cuánto cuestan por token y cuánto por tarea, que no es lo mismo.
- Los benchmarks de Google y lo que dicen Artificial Analysis y Vals AI.
- El modo Orchestrator de Antigravity: Neon dirigiendo a varios Hydrogen.
- Seguridad, la variante de ciberseguridad y lo que admite la model card.
- Cómo empezar en la API y cuál elegir para programar.
¿Qué son Gemini 4 Neon y Gemini 4 Hydrogen? 
Gemini 4 Neon es el modelo intermedio de la familia Gemini 4 y Gemini 4 Hydrogen es el rápido y barato. Neon se sitúa entre Hydrogen y Carbon: Google lo describe como el modelo que “equilibra profundidad y eficiencia”, pensado para programación compleja, razonamiento analítico y flujos de empresa. Hydrogen es el “modelo de propósito general por defecto” y el relevo natural de Gemini 3.8 Flash.
Un dato de la model card que explica mucho: Neon está adaptado de Gemini 4 Carbon. Arquitectura, datos de entrenamiento y hardware remiten a la ficha de Carbon. No es un modelo nuevo desde cero, es Carbon afinado para gastar menos.
Así queda el mapa de la familia, con lo que dicen la documentación de la API y la cobertura de 9to5Google:
| Modelo | Papel según Google | En el selector de la app Gemini | Precio API (entrada / salida por millón) |
|---|---|---|---|
| Gemini 4 Hydrogen | Modelo por defecto, rápido, para el día a día | “Everyday help” | 1,50 $ / 7,50 $ |
| Gemini 4 Neon | Equilibrio entre profundidad y coste | “Deeper analysis” | 3 $ / 15 $ |
| Gemini 4 Carbon | Arquitectura, depuración y seguridad difíciles | “Code & complex work” | 2 $ / 10 $ hasta el 30 de noviembre, 4 $ / 20 $ desde el 1 de diciembre |
| Gemini 4 Argon | Frontera eficiente, el primero en salir | Sustituido por Neon | 2 $ / 10 $, luego 4 $ / 20 $ |
Si llegas tarde a la saga, aquí tienes los capítulos anteriores: Gemini 4 Argon y Gemini 4 Carbon.
Las fichas técnicas, lado a lado 
Las dos comparten casi todo el esqueleto técnico, según la documentación de Google AI Studio:
- Ventana de contexto de 1.048.576 tokens, compartida entre entrada, razonamiento y salida.
- Salida de hasta 65.536 tokens en llamadas síncronas, y hasta 1M con long decode en segundo plano.
- Entrada multimodal (texto, imagen, vídeo, audio y PDF) y salida solo de texto.
- Cuatro niveles de razonamiento:
low,medium,high(por defecto) yxhigh. - Herramientas: function calling, ejecución de código, computer use, búsqueda en Google, salidas estructuradas y contexto de URL.
- Sin Live API, sin generación de imagen o audio y sin caché explícita (solo la implícita).
La diferencia práctica está en el acceso. Hydrogen tiene capa gratuita en la API y en AI Studio, con límites de uso. Neon no: la documentación lo dice sin rodeos, “Gemini 4 Neon is not available on the Free tier”.
🔑 La fecha de corte de conocimiento de Neon es marzo de 2026, según su model card. Si le preguntas por una librería que cambió en verano, va a contestar con lo que sabía en primavera. Dale documentación en el contexto.
¿Cuánto cuestan Gemini 4 Neon y Hydrogen? 
Neon cuesta 3 dólares por millón de tokens de entrada y 15 por millón de salida; Hydrogen, 1,50 y 7,50. Los dos tienen precio plano en toda la ventana de 1M (no hay tramo caro a partir de 200.000 tokens) y la entrada cacheada cuesta un 95 % menos: 0,15 $ en Neon y 0,075 $ en Hydrogen. Los tokens de razonamiento se cobran como salida.
Así quedan frente a sus vecinos, con los precios de la API de cada proveedor:
| Modelo | Entrada / millón | Salida / millón | Caché | Capa gratis |
|---|---|---|---|---|
| Gemini 4 Hydrogen | 1,50 $ | 7,50 $ | 0,075 $ | Sí, con límites |
| Gemini 4 Neon | 3 $ | 15 $ | 0,15 $ | No |
| Gemini 4 Carbon (desde el 1 de diciembre) | 4 $ | 20 $ | — | No |
| Gemini 3.8 Flash (hasta el 31 de diciembre) | 0,75 $ | 3,75 $ | 0,075 $ | — |
| Claude Sonnet 5.5 | 2 $ | 10 $ | 0,10 $ | No |
| Claude Opus 5.5 | 4 $ | 20 $ | 0,20 $ | No |
| GPT-6.2 Sol | 2 $ | 10 $ | 0,10 $ | No |
Hay dos letras pequeñas que conviene leer.
La primera: hasta el 30 de noviembre, Neon es más caro por token que Carbon. Carbon y Argon siguen con su precio de lanzamiento de 2/10, así que Neon cuesta un 50 % más por token durante diez días, como apunta The Rundown AI. A partir del 1 de diciembre la cosa se da la vuelta y Neon pasa a ser un 25 % más barato.
La segunda: Hydrogen cuesta el doble que Gemini 3.8 Flash hoy, pero la tabla de precios de Google sube 3.8 Flash a 1,50/7,50 el 1 de enero de 2027. Si tu plan era quedarte en Flash por precio, ese plan caduca en seis semanas.
El precio por token no es el precio por tarea. Un modelo que razona más escribe más tokens, y los tokens de razonamiento se cobran. Google afirma que Neon, en su nivel por defecto (high), tiene un 32 % menos de coste por tarea que Carbon en el índice de Artificial Analysis, y entre un 50 % y un 80 % menos que los modelos de frontera de la competencia en Vals AI y Agent Arena.
Son cifras de Google. Las independientes las vemos un poco más abajo, y traen alguna sorpresa.
Te adelanto la más útil. Con los datos de Artificial Analysis, Neon en medium saca más nota que Hydrogen en xhigh, en la mitad de tiempo y con una quinta parte de los tokens de salida:
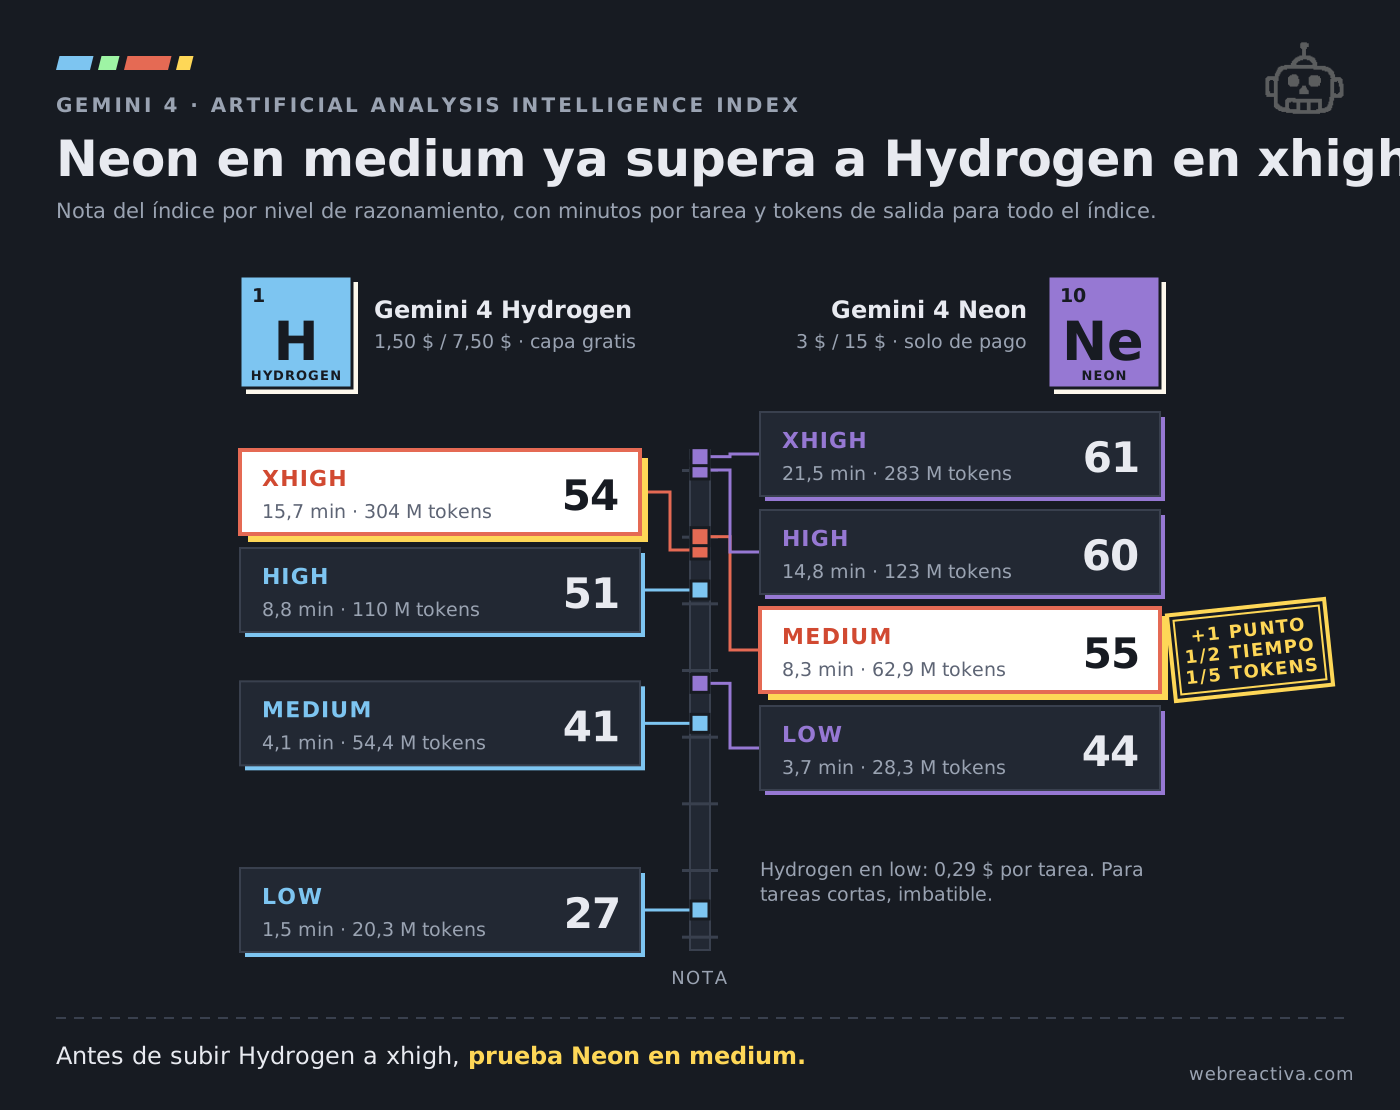
⚠️ Antes de mirar solo la columna de precio, ten en cuenta que Artificial Analysis clasifica a Neon y a Hydrogen como muy verbosos: puestos 92 y 93 de 94 en su ranking de verbosidad. Escriben mucho. Y eso se paga.
Herramienta · Calculadora
¿Cuánto te costarían Neon o Hydrogen?
El precio por millón de tokens no te dice lo que pagas a fin de mes. Mete el contexto que reenvía tu agente, los pasos que da y la salida que genera, y compara Neon a 3/15 y Hydrogen a 1,50/7,50 con lo que pagas hoy.
Le das
Los pasos y el contexto de tu agente
Te devuelve
Lo que cuesta una ejecución y lo que cuesta el mes
¿Qué dicen los benchmarks oficiales de Gemini 4 Neon? 
Google sitúa a Neon tercero en el índice de Artificial Analysis con 61 puntos en xhigh, primero en el índice de agentes de programación de Artificial Analysis (58,6) y segundo en el índice de Vals AI (70,9 %). La propia Google admite que queda “justo detrás de modelos más grandes y más lentos”: en Artificial Analysis, esos son Claude Fable 5.2 (65) y GPT-6.2 Astra (62), según contamos en el post de GPT-6.2. Y un detalle que no sale en el titular: Neon supera por un punto a Carbon (60), el modelo del que deriva.
Según la tabla del anuncio, recogida por Digital Trends, Neon saca 61 en Artificial Analysis frente a 59 de Claude Opus 5.5 y 57 de GPT-6.2 Sol. The Rundown AI hizo el recuento de la model card: Neon supera a sus rivales en 16 de 19 filas.
Estas son las pruebas de programación y agentes que más te interesan:
| Prueba | Gemini 4 Neon | Qué mide |
|---|---|---|
| AA Coding Agent Index | 58,6 (n.º 1) | Agentes de programación, índice de Artificial Analysis |
| Terminal-Bench 4.1 | 65,2 % | Tareas reales en terminal |
| FrontierCode 2.0 | 46,2 % (en high) |
Programación de frontera |
| SWE-sweep (con Antigravity) | 39,0 % | Tareas de repositorio; 12,8 % con el harness mini-SWE |
| AutomationBench (Zapier) | 56,3 % (n.º 1) | Automatizaciones de negocio |
| Agents’ Last Exam v1.1 | 75,8 % | Agentes en tareas largas |
| GraphWalks | 95,2 (Opus 5.5: 66,8; GPT-6.2 Sol: 80,1) | Razonamiento sobre contexto largo |
Fíjate en SWE-sweep. Del 12,8 % al 39,0 % solo por cambiar el harness, mismo modelo. Si alguna vez has pensado que el modelo lo es todo, esta fila te dice lo contrario. Lo contamos a fondo en qué es un AI harness.
¿Y dónde pierde? Google no lo esconde, aunque tampoco da las cifras del rival:
- Opus 5.5 gana en Terminal-Bench 4.1 y en FrontierCode 2.0, las dos pruebas más cercanas a programar en serio.
- GPT-6.2 Sol gana en Chartography, donde Neon saca un 73,5 %.
Fuera de la programación, Neon brilla en trabajo de conocimiento: primero en Legal Research Bench y Tax Agent Bench de Vals, 84,0 % en RiemannBench y 71,3 % en HLE-Diamond. Y un dato curioso: en Vending-Bench 2, donde el agente gestiona una máquina expendedora simulada durante meses, acaba con 16.843 dólares, primero de la tabla.
💡 Lectura rápida: Neon es un modelo de frontera para agentes y trabajo de oficina. Para programación pura, Opus 5.5 sigue por delante en las pruebas que más se parecen a tu repo.
Cambiar de modelo no arregla un flujo que no tienes
Neon pasa del 12,8 % al 39 % en SWE-sweep solo por cambiar el harness. Lo que rodea al modelo pesa. En el curso montas un flujo completo con agentes solo con prompts, sobre un proyecto real: spec, plan, implementación en bucle y verificación antes de dar nada por terminado.
Ver el curso →¿Y qué dicen los benchmarks de Gemini 4 Hydrogen? 
Hydrogen saca 51 puntos en Artificial Analysis en high y 54 en xhigh, por encima de Gemini 4 Argon (50), y triplica a Gemini 3.8 Flash en Terminal-Bench 4.1: 57 % frente a 18,2 %. Google también dice que termina las tareas 2,5 veces más rápido que 3.8 Flash en su nivel por defecto.
El modelo “barato” supera al primer modelo de frontera de la familia, presentado seis semanas antes, y cuesta menos de la mitad cuando Argon pase a 4/20.
Las cifras del anuncio de Google, completadas con el análisis de DataCamp:
| Prueba | Gemini 4 Hydrogen | Referencia |
|---|---|---|
Artificial Analysis (high / xhigh) |
51 / 54 | Argon: 50 |
| Terminal-Bench 4.1 | 57,0 % | Gemini 3.8 Flash: 18,2 % |
| Agents’ Last Exam v1.1 | 71,6 % | Carbon: 77,4 %; Argon: 69,0 % (DataCamp) |
| HLE-Diamond | 58,8 % | Primero de su categoría |
| Tax Agent Bench (Vals) | 52,3 % | N.º 1 en el lanzamiento |
| Legal Research Bench (Vals) | 55,8 % | Empate en el n.º 1 |
| Agent Arena | Puesto 5 | — |
Además, Google afirma que reduce más de 5 veces las afirmaciones inventadas respecto a 3.8 Flash, y que sus socios vieron tareas entre 2 y 2,8 veces más rápidas con entre un 12 % y un 23 % menos de tokens en cargas de grafos, SQL y datos.
¿El punto débil? La terminal. En la medición independiente de Artificial Analysis sobre Terminal-Bench 4.0, Hydrogen saca un 54 %, frente al 64 % de Claude Sonnet 5.5 y el 56 % de GPT-6.1 Sol, según DataCamp. Y DataCamp cita la model card de Google con otra tabla, ajustada por trampas, donde Sonnet 5.5 marca un 63,9 % en Terminal-Bench 4.1 frente al 57,0 % de Hydrogen.
Si tu agente vive en la terminal, Sonnet 5.5 sigue siendo el rival a batir en su gama.
¿Qué dicen las mediciones independientes de Artificial Analysis y Vals AI? 
Artificial Analysis confirma los 61 puntos de Neon en xhigh (60 en high) y los 54 de Hydrogen, y Vals AI coloca a Neon segundo de 42 modelos con un 70,87 %, solo por detrás de Claude Fable 5.2. Las cifras de Google aguantan. Lo que cambia la foto son el tiempo y el coste.
Artificial Analysis 
Estos son los datos de sus fichas de Neon y Hydrogen:
| Métrica | Neon | Hydrogen |
|---|---|---|
Índice de inteligencia (xhigh / high / medium / low) |
61 / 60 / 55 / 44 | 54 / 51 / 41 / 27 |
Velocidad de salida (xhigh) |
110 tokens/s | 164 tokens/s |
Tiempo por tarea del índice (xhigh / high) |
21,5 / 14,8 min | 15,7 / 8,8 min |
Tokens de salida para todo el índice (xhigh) |
283 millones | 304 millones |
Coste por tarea del índice (xhigh) |
6,44 $ | 3,16 $ |
Mira la penúltima fila con calma. Hydrogen en xhigh escribe más tokens que Neon en xhigh para hacer las mismas tareas. Es más barato por token, pero se enrolla más. Artificial Analysis lo resume así: Neon está “entre los modelos líderes en inteligencia, pero algo caro”, “notablemente lento por tarea” y “muy verboso”.
Vals AI 
Aquí aparece la sorpresa que te prometía al principio. En el índice de Vals AI, los dos modelos en xhigh:
| Métrica | Neon | Hydrogen |
|---|---|---|
| Vals Index | 70,87 % (2.º de 42) | 68,49 % (7.º de 42) |
| Coste por prueba | 7,40 $ | 9,84 $ |
| Latencia media | 31 min 25 s | 32 min 5 s |
| Vibe Code Bench v1.1 | 93,70 % (2.º de 133) | 87,78 % (15.º de 133) |
| Terminal-Bench 4.0 | 61,62 % (7.º de 69) | 54,04 % (14.º de 69) |
Hydrogen cuesta un 33 % más por prueba que Neon y tarda lo mismo, aunque su token valga la mitad. En las tareas largas de Vals, el modelo pequeño necesita muchos más intentos y vueltas para llegar, y esas vueltas se pagan.
Es como contratar al fontanero que cobra la mitad por hora y tarda el triple. Al final, la factura es más alta.
⚠️ Ojo con las comparaciones directas: en el índice de Vals, Sonnet 5.5 tenía un 70,85 % (lo contamos en el post de GPT-6.2 Astra y Sol). Neon le saca dos centésimas, con un margen de error de ±0,94. Eso es un empate técnico, no una victoria.
¿Te sale más a cuenta Neon en medium que Hydrogen en xhigh? 
Con los datos de Artificial Analysis, probablemente sí: Neon en medium saca 55 puntos, uno más que Hydrogen en xhigh, en casi la mitad de tiempo por tarea y con menos de una cuarta parte de tokens de salida. Google no lo cuenta en su anuncio, y para elegir configuración es el dato más útil de esas tablas.
Los números, todos de Artificial Analysis:
| Configuración | Índice | Tiempo por tarea | Tokens de salida (índice completo) |
|---|---|---|---|
Hydrogen en xhigh |
54 | 15,7 min | 304 millones |
Neon en medium |
55 | 8,3 min | 62,9 millones |
Hydrogen en high |
51 | 8,8 min | 110 millones |
Si hacemos la cuenta solo con la salida, Hydrogen en xhigh serían unos 2.280 dólares para todo el índice (304 millones × 7,50 $) y Neon en medium, unos 945 (62,9 millones × 15 $). Es una estimación mía y tiene un agujero: deja fuera la entrada, que Artificial Analysis solo publica para xhigh y que pesa mucho (11.300 millones de tokens en Hydrogen y 8.120 en Neon, buena parte cacheados). Tómala como una pista para medir con tus tareas, no como una factura.
¿Qué significa esto en tu día a día?
- Si subes Hydrogen a
xhighporque “no llega”, prueba antes Neon enmedium. Más calidad, la mitad de espera y muchos menos tokens de salida. La factura, compruébala con tus tareas. - Hydrogen en
lowomediumes donde de verdad es barato: 0,29 y 0,80 dólares por tarea del índice, según DataCamp con datos de Artificial Analysis. Para clasificar, resumir, extraer o tareas cortas de agente, es difícil de batir. xhighes caro en los dos. La propia documentación de Hydrogen avisa de que “aumenta la latencia y el uso de tokens y puede provocar sobrerrazonamiento en prompts sencillos”.
🔑 El nivel de razonamiento es un parámetro tan importante como el modelo. Elegir “Neon o Hydrogen” sin elegir el nivel es elegir a medias.
Neon en medium supera a Hydrogen en xhigh con menos de una cuarta parte de los tokens de salida, y eso no salía en el anuncio. Cada domingo contamos a +7.500 developers qué modelo y qué configuración nos funcionan de verdad al programar con agentes, con 12 recursos elegidos a mano. Gratis, desde 2018.
Quiero esa dinamita 🧨¿Cómo funciona el modo Orchestrator de Antigravity con Neon y Hydrogen? 
En Google Antigravity, Neon puede actuar como orquestador que planifica y reparte trabajo entre varios subagentes Hydrogen en paralelo. Google lo vende como un orquestador “rápido y con buen criterio” que reduce lecturas de ficheros redundantes, comparte el progreso mientras trabaja y compacta el contexto de forma fiable en sesiones largas.
Es el patrón de siempre en un equipo con buen reparto: alguien con criterio decide qué hay que hacer y varias personas rápidas lo ejecutan a la vez. El modelo caro piensa poco y bien; los baratos hacen el volumen.
Google ya había probado la idea con Carbon. En el anuncio de Hydrogen cuenta que Carbon como orquestador con subagentes Hydrogen logra en Terminal-Bench 4.0 tasas de éxito “cercanas a Carbon” gastando un 24 % menos de cuota y un 19 % más rápido. Con Neon como cerebro, la cuenta debería salir todavía más barata, aunque Google no ha publicado esa cifra concreta.
Los ejemplos que enseña Google con el comando /swarm de Antigravity dan una idea de la escala:
- Un simulador de esquí en WebGL2 con 10.200 líneas de shaders.
- Una hoja de Google Sheets de 100.000 celdas con más de 500.000 fórmulas.
- Un banco de laboratorio en Blender a través de un servidor MCP.
- Un estudio en 3D del artículo de Alan Turing de 1936.
Son demos de lanzamiento, elegidas para lucir. Pero el patrón es real y lo puedes aplicar en tu propio harness: un modelo fuerte para planificar y revisar, y modelos baratos para ejecutar. Si ya usas Antigravity, tienes el contexto en nuestro post de Antigravity 2.0.
En la API, la documentación confirma que el agente gestionado de Antigravity admite gemini-4-neon en solitario o emparejado con Hydrogen.
Construye agentes con criterio
Un orquestador que reparte trabajo no se improvisa
Neon planificando y varios Hydrogen ejecutando es orquestación de manual. En esta masterclass recorres los seis niveles de arquitectura de un agente, de las tools y los guardarraíles a la memoria, las skills, MCP y la orquestación, con evals de LLM as Judge y un sistema multiagéntico montado en Open Code.
Ver la masterclass →6 niveles de arquitectura, en directo
¿Son Gemini 4 Neon y Hydrogen más seguros que sus hermanos? 
Según Google, Neon iguala a Carbon con un 0,0 % de trampas en Terminal-Bench 4.0 y tiene la tasa de trampas más baja de la familia en su evaluación de código (2,45 %). Hydrogen, por su parte, reduce 12 veces las acciones desalineadas y los atajos en tareas de herramientas y código frente a Gemini 3.8 Flash.
Las cifras de seguridad de Neon que publica Google:
- 0,09 % de acciones desalineadas en su batería de seguridad agéntica.
- 99,2 % en su evaluación de honestidad del agente.
- Entre un 43 % y un 56 % menos de “infraservicio” (hacer menos de lo pedido) y entre un 15 % y un 35 % menos de extralimitarse que Carbon, según el nivel de esfuerzo.
- 0,0 % de éxito de ataques en el benchmark de inyección indirecta de Gray Swan, en su nivel más alto de razonamiento.
Las de Hydrogen frente a 3.8 Flash: hasta un 81 % menos de extralimitarse, hasta un 79 % menos de infraservicio, hasta 2 veces menos probable que se salte límites de permisos cuando se bloquea y más de 2,3 veces más resistente a la inyección indirecta.
Si te importa lo de las trampas, no es paranoia. FrontierCS pilló a Carbon aprobando tareas con atajos, como contamos en el post de Carbon.
Lo que dice la model card de Neon 
La model card es más sobria que el anuncio, y conviene leerla:
- Neon puede alucinar, como cualquier modelo. Google sigue trabajando en la resistencia a jailbreaks.
- Google no le hizo la evaluación completa de capacidades críticas: el aumento de capacidad respecto a Argon queda por debajo de su umbral de “cambio material”, así que arrastra las conclusiones de Argon.
- Entre ellas, que en ciberseguridad el nivel crítico de capacidad “no se puede descartar”.
- Frente a Hydrogen, Neon reduce las negativas injustificadas en 3 puntos.
- El informe completo de seguridad llegará “en los próximos días”.
La variante para ciberseguridad 
Neon brilla en las pruebas de ciberseguridad: 90,5 % en SEC-bench Pro (Carbon sacó un 88,2 %), 51,26 % en WebExploitBench a la mitad de coste que los modelos grandes y 70,7 % en CWE-bench v2. En AutoBaxBench escribe código más seguro que Carbon en los tres niveles de dificultad.
Por eso Google repite la jugada de Carbon: Gemini 4 Neon for cyber llegará a defensores verificados “en los próximos días” a través del Fairwind Program. Para pedir acceso, hay que hablar con tu equipo de cuenta de Google Cloud.
¿Cómo empiezas a usar Gemini 4 Neon y Hydrogen en la API? 
Los IDs son gemini-4-neon y gemini-4-hydrogen, sin versión con fecha, y funcionan con generateContent y con la Interactions API. Hydrogen lo puedes probar gratis en AI Studio con límites. Neon necesita la capa de pago de la API, o una suscripción Google AI Pro o Ultra para probarlo en AI Studio.
Un ejemplo con el SDK de Python. Guarda el modelo en una variable de entorno: con cuatro modelos en siete semanas, vas a cambiarlo más de una vez.
import osfrom google import genaifrom google.genai import typesclient = genai.Client() # lee GEMINI_API_KEY del entorno# Cambia de modelo sin tocar código: gemini-4-hydrogen, gemini-4-neon...MODEL = os.environ.get("GEMINI_MODEL", "gemini-4-neon")response = client.models.generate_content( model=MODEL, contents="Revisa esta función y dime qué casos límite no cubre: ...", config=types.GenerateContentConfig( # low, medium, high (por defecto) o xhigh; "minimal" da error thinking_config=types.ThinkingConfig(thinking_level="medium"), # deja sitio: razonamiento y respuesta comparten este límite max_output_tokens=65536, ),)print(response.text)Si vienes de Gemini 3, la guía de migración de Google trae varios cambios que rompen código:
- Quita
temperature,top_pytop_k. Los valores fuera de rango devuelven un error 400. - El nivel
minimalya no existe y devuelve error. - Revisa los
max_output_tokensfijos (el típico 8.192). El razonamiento comparte ese límite con la respuesta y puede quedarse sin sitio. - No hay caché explícita. Si usabas
cachedContentsocaches.create, te toca vivir con la caché implícita, que se activa a partir de 4.096 tokens. - Conserva las thought signatures y declara las herramientas de forma nativa para evitar errores
MALFORMED_FUNCTION_CALL.
Y si tu carga no necesita respuesta inmediata, mira Batch y Flex: cuestan la mitad (1,50/7,50 en Neon y 0,75/3,75 en Hydrogen).
🛡️ Antes de cambiar el modelo por defecto de tu agente, ejecuta tus propias tareas con los dos. Diez tareas reales de tu repo te dicen más que diecinueve filas de una tabla de lanzamiento.
¿Qué dicen los primeros análisis y los developers? 
La lectura general es positiva con dos reservas: casi todas las cifras salen de Google y los modelos gastan muchos tokens. Nadie discute que Neon sea un buen modelo. Se discute si “calidad de Carbon a velocidad de Flash”, el titular de 9to5Google, es un resumen justo.
Lo más relevante de lo publicado hasta hoy:
- Logan Kilpatrick, de Google, en Digital Trends: “Para mí, Neon tiene el equilibrio justo entre inteligencia, velocidad y facilidad de uso”.
- Digital Trends recuerda que “son benchmarks de la propia Google, así que las pruebas independientes podrían salir distintas”.
- En DEV Community, Hassan Amer lo llama “el mediano que la mayoría de la gente acaba pidiendo” y avisa de que “nadie independiente ha repetido estas pruebas todavía” (escribía antes de que salieran los datos de Artificial Analysis y Vals).
- The Rundown AI subraya que Google admite que Neon “todavía puede alucinar” y que los benchmarks no dicen cómo se comportará con tus documentos y tus flujos.
- DataCamp, sobre Hydrogen: “no es el mejor modelo disponible para trabajo intensivo en terminal”.
Y luego está el comentario más votado en 9to5Google, que no es técnico pero lo firmaría medio sector: la gente no entiende los nombres. Argon, Carbon, Hydrogen, Neon. ¿Cuál es el grande? ¿Cuál el pequeño? Ni siquiera van en orden de número atómico.
(Si te sirve de truco: H de Hydrogen, el ligero. Ne de Neon, el del medio. C de Carbon, el pesado. Argon, ya jubilado de la app.)
Cuatro modelos Gemini en siete semanas y cada uno con su letra pequeña. Cada domingo, junto a +7.500 developers, separamos lo que cambia en tu forma de programar con agentes del ruido de lanzamiento y te pasamos 12 recursos elegidos a mano. Gratis, desde 2018.
Quiero esa dinamita 🧨¿Cuál elegir para programar: Hydrogen, Neon o Carbon? 
Usa Hydrogen como modelo por defecto para tareas cortas y volumen, Neon cuando la tarea es larga o necesita criterio, y Carbon solo para los problemas más difíciles de arquitectura, depuración o seguridad. Es lo que recomienda la propia documentación de Google, y los datos independientes lo matizan en un punto: no subas Hydrogen a xhigh.
| Si necesitas… | Elige | Por qué |
|---|---|---|
| Clasificar, extraer, resumir o tareas cortas de agente | Hydrogen en low o medium |
0,29-0,80 $ por tarea del índice de AA, capa gratis para probar |
| El modelo por defecto de un agente con presupuesto | Hydrogen en high |
51 puntos, 160 tokens/s, mitad de precio que Neon |
| Tareas largas de agente o trabajo con documentos | Neon en medium o high |
Más calidad que Hydrogen en xhigh con menos tokens de salida |
| Orquestar subagentes | Neon + Hydrogen | Patrón Orchestrator de Antigravity |
| Terminal y programación dura | Compara con Opus 5.5 o Sonnet 5.5 | Ganan en Terminal-Bench y FrontierCode |
| El problema más difícil del sprint | Carbon (o Neon en xhigh) |
Antes del 1 de diciembre, Carbon es más barato por token |
Y si tu equipo ya trabaja con Claude o con GPT, Neon no te obliga a migrar. Está empatado con Sonnet 5.5 en Vals AI, por detrás de Opus 5.5 en terminal y cuesta más por token que ambos rivales de gama media. Su ventaja real es el ecosistema de Google (Antigravity, Sheets, Workspace) y la ventana de 1M con precio plano.
Para el mapa completo de qué modelo usar en cada tarea, tienes nuestro ranking del mejor modelo de IA para programar.
Lo que todavía no sabemos 
Hay huecos que conviene tener presentes antes de tomar decisiones:
- El informe completo de seguridad de Neon, que Google promete “en los próximos días”.
- Las cifras de los rivales en Terminal-Bench 4.1, FrontierCode 2.0 y Chartography, donde Google reconoce que pierde pero no publica la puntuación ajena.
- Cuánto cuesta el Orchestrator con Neon frente a Neon solo. Solo hay datos con Carbon como orquestador.
- Qué pasa con Argon en la API: sale del selector de la app, pero no hay fecha de retirada en la documentación.
- Evaluaciones de tareas de horas, como la de FrontierCS con Carbon. De momento no hay nada equivalente para Neon ni para Hydrogen.
TL;DR 
- 🧪 Gemini 4 Neon (18 de noviembre) es el modelo intermedio de la familia, adaptado de Carbon: 3/15 dólares por millón, 1M de contexto, sin capa gratis.
- ⚡ Gemini 4 Hydrogen (12 de noviembre) es el modelo por defecto: 1,50/7,50, gratis con límites en la API y 57 % en Terminal-Bench 4.1 frente al 18,2 % de 3.8 Flash.
- 📊 Artificial Analysis confirma 61 puntos para Neon y 54 para Hydrogen; Vals AI pone a Neon segundo con un 70,87 %, empatado de facto con Sonnet 5.5.
- 💸 Más barato por token no es más barato por tarea: en Vals, Hydrogen cuesta 9,84 $ por prueba y Neon 7,40 $. Neon en
mediumsupera a Hydrogen enxhighcon menos de una cuarta parte de los tokens de salida. - 🎯 Hydrogen para el volumen, Neon para tareas largas y para orquestar, y Opus 5.5 o Sonnet 5.5 si tu agente vive en la terminal.
Preguntas frecuentes 
¿Qué es Gemini 4 Neon? 
Es el modelo intermedio de la familia Gemini 4 de Google, presentado el 18 de noviembre de 2026. Está adaptado de Gemini 4 Carbon y se sitúa entre Hydrogen y Carbon. Está pensado para programación compleja, razonamiento analítico y flujos de agentes largos, con una ventana de contexto de 1M de tokens.
¿Qué es Gemini 4 Hydrogen? 
Es el modelo rápido y de propósito general de la familia Gemini 4, presentado el 12 de noviembre de 2026. Google lo recomienda como modelo por defecto y como sustituto de Gemini 3.8 Flash. Saca 51 puntos en el índice de Artificial Analysis en su nivel por defecto, uno más que Gemini 4 Argon.
¿Cuánto cuesta Gemini 4 Neon? 
En la API cuesta 3 dólares por millón de tokens de entrada, 15 por millón de salida y 0,15 por millón de entrada cacheada, con precio plano en toda la ventana de 1M. En Batch y Flex cuesta la mitad. No tiene capa gratuita.
¿Gemini 4 Hydrogen es gratis? 
Sí, con límites. Está en la capa gratuita de la API de Gemini y de Google AI Studio, aunque en esa capa Google usa tus datos para mejorar sus productos. En la app Gemini, los usuarios gratuitos lo reciben a través de la selección automática de modelo cuando el prompt lo requiere.
¿Qué diferencia hay entre Gemini 4 Neon y Hydrogen? 
Neon es más capaz (61 frente a 54 puntos en Artificial Analysis en xhigh) y cuesta el doble por token. Hydrogen es más rápido, con 164 tokens por segundo frente a 110, y tiene capa gratis. En tareas largas, Neon puede salir más barato por tarea: en Vals AI cuesta 7,40 dólares por prueba frente a 9,84 de Hydrogen.
¿Gemini 4 Neon es mejor que Claude Opus 5.5? 
Depende de la prueba. Según la tabla de Google, Neon supera a Opus 5.5 en el índice de Artificial Analysis (61 frente a 59) y en contexto largo, pero Opus 5.5 gana en Terminal-Bench 4.1 y FrontierCode 2.0, las pruebas más cercanas a programar. Neon cuesta un 25 % menos por token que Opus 5.5.
¿Qué nivel de razonamiento uso con Neon o Hydrogen? 
Los dos tienen low, medium, high (por defecto) y xhigh. Para tareas cortas, Hydrogen en low o medium es lo más barato. Si Hydrogen no llega, prueba Neon en medium antes que Hydrogen en xhigh: según Artificial Analysis, rinde un punto más en la mitad de tiempo y con menos de una cuarta parte de tokens de salida.
¿Cuál es el ID de Gemini 4 Neon y Hydrogen en la API? 
Son gemini-4-neon y gemini-4-hydrogen, versiones estables sin fecha. Funcionan con generateContent y con la Interactions API. Al migrar desde Gemini 3 hay que quitar temperature, top_p y top_k, y el nivel minimal devuelve error.
¿Qué es el modo Orchestrator de Antigravity? 
Es un modo de Google Antigravity en el que un modelo con más criterio, como Neon o Carbon, planifica y reparte el trabajo entre varios subagentes Hydrogen en paralelo. Con Carbon como orquestador, Google midió en Terminal-Bench 4.0 un éxito cercano al de Carbon solo, con un 24 % menos de cuota y un 19 % más de velocidad.
¿Qué es Gemini 4 Neon for cyber? 
Es una variante de Neon con capacidades ofensivas de ciberseguridad que Google entrega solo a defensores verificados a través del Fairwind Program. Neon saca un 90,5 % en SEC-bench Pro y un 51,26 % en WebExploitBench. El acceso se pide a través del equipo de cuenta de Google Cloud.
Fuentes 
- Introducing Gemini 4 Neon — Google
- Introducing Gemini 4 Hydrogen — Google
- Gemini 4 Neon Model Card — Google DeepMind (PDF)
- Gemini 4 Neon — documentación de la API de Gemini
- Gemini 4 Hydrogen — documentación de la API de Gemini
- Novedades de Gemini 4 Neon — documentación de la API
- Novedades de Gemini 4 Hydrogen — documentación de la API
- Precios de la API de Gemini
- Gemini 4 Neon — Artificial Analysis
- Gemini 4 Hydrogen — Artificial Analysis
- Gemini 4 Neon — Vals AI
- Gemini 4 Hydrogen — Vals AI
- Google launches Gemini 4 Neon with Carbon quality at Flash speeds — 9to5Google
- Google says Gemini 4 Neon can hang with Claude Opus 5.5 and GPT-6.2 Sol for less — Digital Trends
- Google’s Gemini 4 Neon extends its rapid run of model releases — The Rundown AI
- Gemini 4 Neon: Google’s Middle Model Is Now the Best Value — DEV Community
- Gemini 4 Hydrogen Explained: Features, Benchmarks & Pricing — DataCamp
🧨 Última oportunidad para recibir la dinamita que mereces sobre programación con IA el próximo domingo: Suscríbete gratis a Web Reactiva en https://webreactiva.com/newsletter

Escrito con la ayuda de la IA generativa de Claude, fuentes fidedignas y con un human in the loop:
Dani Primo.
12 recursos para developers cada domingo en tu bandeja de entrada
Además de una skill práctica bien explicada, trucos para mejorar tu futuro profesional y una pizquita de humor útil para el resto de la semana. Gratis.