GBrain es el Gstack para OpenClaw, Hermes y Claude Code
Tabla de contenidos
Garry Tan dirige Y Combinator. Y en su tiempo libre, que no debe de ser mucho, ha escrito la memoria que usan sus agentes de IA.
Se llama GBrain, es open source con licencia MIT y en el momento de escribir esto pasa de las 31.900 estrellas en GitHub. La descripción del repositorio no se anda con rodeos: “Garry’s Opinionated OpenClaw/Hermes Agent Brain”. Un cerebro con opiniones para los agentes que él ya usa a diario.
La idea de fondo cabe en una línea del README: darle al agente que ya usas una memoria que controlas tú. No es otro agente. No compite con OpenClaw ni con Hermes. Se enchufa a ellos (y a Claude Code, Codex, Cursor y unos cuantos más) y les quita el trabajo de recordar.
En este artículo vas a encontrar:
- Qué es GBrain y cómo está montado por dentro
- La instalación paso a paso, con los comandos exactos y las trampas que avisa su autor
- Cómo conectarlo con Claude Code, Codex, OpenClaw y Hermes Agent
- Qué mejora frente a la memoria que ya traen OpenClaw y Hermes
- Cómo queda al lado de Claude-Mem, MemPalace y otros sistemas de memoria
- Sus limitaciones, que también las tiene
GBrain, el cerebro que Garry Tan escribió para sus agentes 
GBrain es una capa de memoria externa para agentes de IA: guarda hechos, personas, empresas, reuniones y notas en un repositorio de Markdown, los indexa en Postgres y se los sirve a cualquier agente por MCP o por línea de comandos.
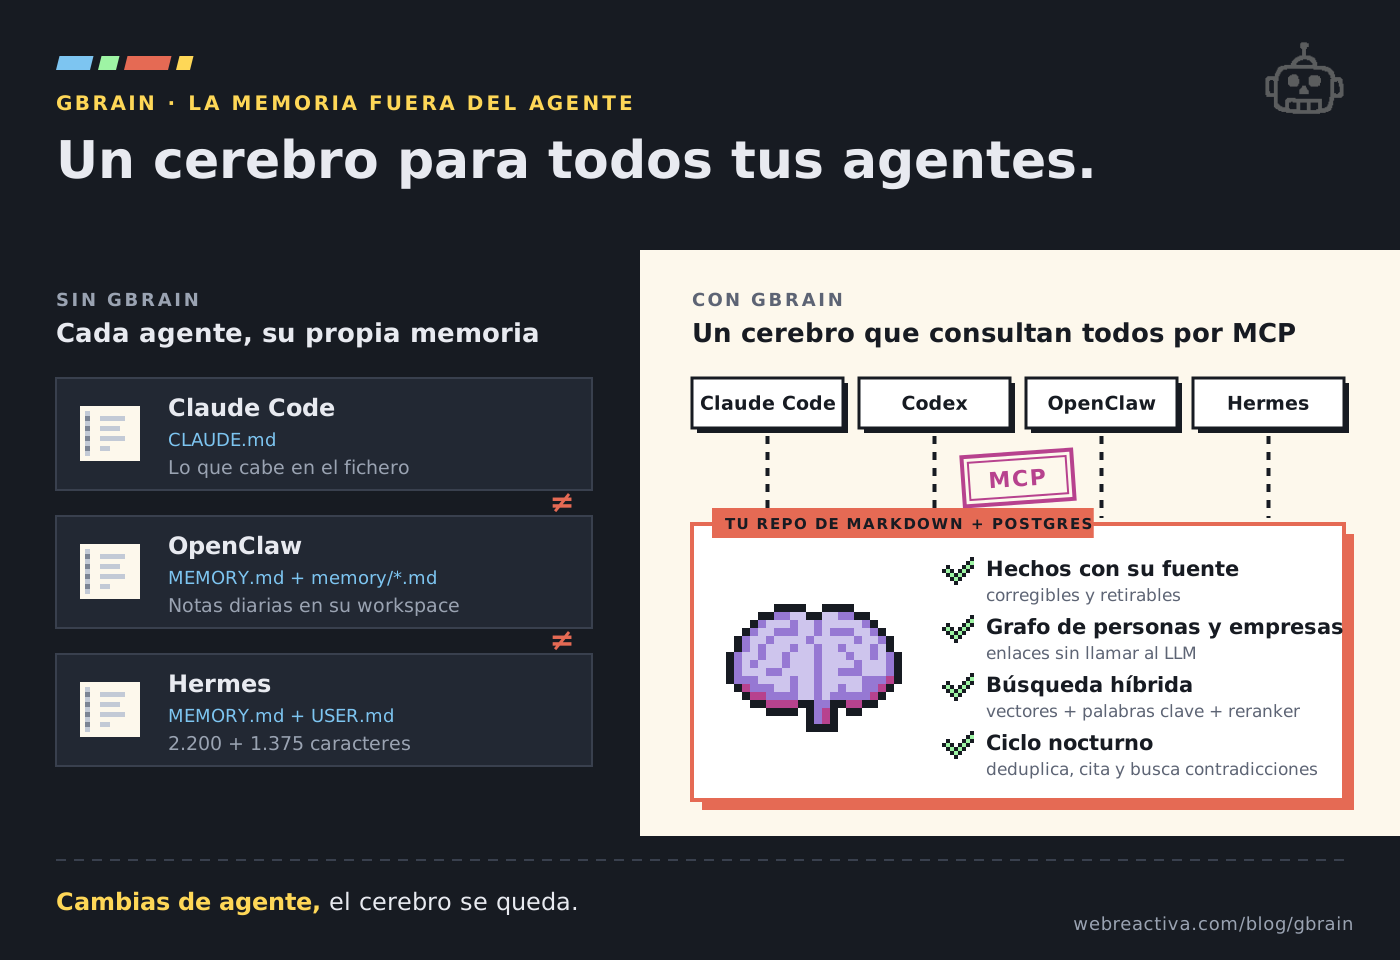
Garry Tan lo construyó para sus propios agentes de OpenClaw y Hermes, y lo usa en producción. Las cifras que publica en el README sobre su propio cerebro son de las que hacen levantar la ceja: 155.795 páginas, 24.589 personas, 5.340 empresas y 66 tareas programadas. Son datos de su instalación, no un benchmark independiente, pero sirven para entender la escala para la que está pensado.
Los ficheros de memoria de un agente funcionan bien mientras lo que recuerdas cabe en una hoja. Cuando tu agente lleva meses contigo, ha leído tus correos, tus reuniones y tus notas, la hoja se queda corta. GBrain parte de ahí: tu memoria es una base de conocimiento, no un fichero de preferencias.
El proyecto está escrito en TypeScript sobre Bun y se mueve a una velocidad considerable. La entrada más reciente del changelog, del 9 de noviembre de 2026, es la versión 0.60.621.0. Sí, la numeración también tiene opiniones.
🔑 GBrain no sustituye a tu agente ni a su configuración. Su propia guía de límites de memoria lo dice claro: lleva hechos y preferencias duraderas entre agentes, pero “no reemplaza la identidad, las instrucciones, la configuración ni los permisos del harness”.
GBrain por dentro: Markdown, Postgres y un grafo 
El diseño tiene cuatro piezas que conviene conocer antes de instalar nada, porque explican casi todas las decisiones de la instalación.
1. Los ficheros mandan. Tu cerebro vive en uno o varios repositorios de Markdown. La base de datos es un índice que se puede reconstruir desde esos ficheros, y un borrado en git se convierte en un borrado suave en el índice. En la jerga de GBrain, un brain es una base de datos y un source es un repositorio dentro de ella.
2. Dos motores de base de datos. Por defecto usa PGLite (Postgres 17 compilado a WASM, sin configurar nada), pensado para cerebros personales de hasta unas 50.000 páginas. Si necesitas más, o compartir el cerebro entre máquinas, pasas a Postgres con pgvector, ya sea en Supabase o en tu propio servidor.
3. Páginas con tipo. Cada página tiene frontmatter, una línea de tiempo y hechos. El tipo lo marca un schema pack: el que viene por defecto, gbrain-base-v2, define 15 tipos (persona, empresa, proyecto, nota, email, slack, deal, tuit, análisis, concepto, fuente…). No es una carpeta de notas sueltas, es un modelo de datos.
4. Un grafo que se teje solo. Cuando escribes una página que menciona [[people/alice-example]], GBrain extrae el enlace con reconocimiento de patrones, sin llamar al LLM. Así se construye el grafo de quién conoce a quién y qué empresa sale en qué reunión. El README tiene la honestidad de describir esos enlaces como “evidencia que inspeccionar, no prueba”.
Encima de eso va la búsqueda. GBrain combina vectores, palabras clave, fusión RRF, un impulso según el tipo de fuente y un reranker, más paseos por el grafo. Y tiene una capa opcional, gbrain think, que en vez de devolverte páginas te devuelve una respuesta redactada, con citas y con un análisis de lo que le falta para responder mejor.
El bucle que describe el README es este: señal, búsqueda, respuesta, escritura, enlace automático y sincronización. El agente consulta antes de contestar y escribe lo que aprende después.
Y de noche, si lo activas, trabaja solo. gbrain autopilot --install instala un proceso en segundo plano que, según el README, deduplica páginas de personas, arregla citas, puntúa la relevancia, busca contradicciones y prepara las tareas del día siguiente. Es el “dream cycle” que se dispara con el prompt Run dream.
Antes de darle un cerebro a tu agente, ponle reglas que no olvide
En la lección 3 escribimos el AGENTS.md de un proyecto real regla a regla, y vemos por qué las reglas de la sesión van ahí y no en la memoria del agente.
Entra en el curso gratis →Requisitos antes de instalar GBrain 
La lista es corta, y eso es buena noticia:
- Bun 1.4.4 o superior. Es el único requisito duro. Si no lo tienes,
curl -fsSL https://bun.sh/install | bashy añade~/.bun/bina tuPATH. - macOS o Linux. El instalador es un script de shell para esos dos sistemas.
- Postgres es opcional. PGLite viene incluido y no necesitas levantar nada.
- Las claves de API también son opcionales para empezar. La búsqueda por palabras clave funciona sin ninguna.
Las claves entran en juego cuando quieres algo más que buscar texto. Esta es la tabla que se deduce de la guía de instalación:
| Clave | Para qué la usa GBrain |
|---|---|
VOYAGE_API_KEY |
Embeddings por defecto (voyage-4, 1024 dimensiones) y reranker (rerank-3-lite) con una sola clave |
OPENAI_API_KEY |
Embeddings alternativos, extracción automática de hechos y modelos de chat |
ANTHROPIC_API_KEY |
Extracción automática de hechos, modelos de chat y expansión de consultas para buscar mejor |
Sin clave de chat, la extracción de hechos, el enriquecimiento, la síntesis y la expansión de consultas se quedan apagadas. Cuando hay clave, tira primero de Anthropic y, si no, de OpenAI.
Si prefieres no mandar nada fuera, la lista de proveedores de embeddings es larga e incluye opciones locales: Ollama, llama.cpp (llama-server) y LM Studio, además de OpenRouter, Gemini, Azure OpenAI, Together o LiteLLM. Para el reranker en local propone llama.cpp con Qwen3-Reranker.
Instalación de GBrain paso a paso 
Antes del primer comando, el aviso que el autor pone en mayúsculas: GBrain no está en npm. El paquete gbrain de npm es otro proyecto que no tiene nada que ver. No ejecutes npm install -g gbrain ni bun add -g gbrain.
⚠️ La forma buena es instalar desde GitHub con la rama
stable. La ramalatest-stablees la línea alfa, aunque el nombre invite a pensar lo contrario.
1. Instala el CLI 
# Instala GBrain desde la rama estable del repositorio
bun install -g github:garrytan/gbrain#stable
Si prefieres clonar, el equivalente es git clone --branch stable del repositorio y dentro bun install && bun link.
Hay un problema conocido con el bloqueo de postinstall de Bun que puede romper la instalación global (lo tienen documentado en el issue #218). Si bun install -g falla de forma rara, empieza por ahí.
2. Conéctalo a tu agente 
Aquí cambia según el agente que uses. Para los dos más habituales hay un comando que lo deja todo listo:
# Si trabajas con Claude Code
gbrain setup claude-code

# Si trabajas con Codex
gbrain setup codex
gbrain setup claude-code registra GBrain como servidor MCP por stdio (gbrain serve), añade hooks y escribe un bloque brain-first en tu ~/.claude/CLAUDE.md para que el agente consulte el cerebro antes de responder. La versión de Codex hace lo propio en AGENTS.md.
Si usas otro agente, o ninguno, inicializa el cerebro a mano:
# Cerebro local con PGLite y sin embeddings (no necesita ninguna clave)
gbrain init --pglite --no-embedding
3. Mete tus notas y comprueba que todo responde 
Con el cerebro creado, el camino mínimo para verlo funcionar desde la terminal son tres comandos:
# Importa una carpeta de notas en Markdown sin generar embeddings
gbrain import ~/notes/ --no-embed

# Busca una frase que sepas que está en alguna nota
gbrain search "una frase de una nota" --json

# Diagnóstico general de la instalación
gbrain doctor
Para revisar la instalación a fondo tienes además gbrain bootstrap verify, gbrain doctor --json, gbrain models y gbrain models doctor.
4. Añade las claves cuando las necesites 
Puedes exportarlas como variables de entorno o guardarlas en ~/.gbrain/config.json con el propio CLI:
# Guarda la clave en la configuración de GBrain
gbrain config set VOYAGE_API_KEY pa-...
gbrain config get oculta los secretos salvo que le pases --raw.
Un detalle que despista: si creaste el cerebro con --no-embedding, añadir la clave no enciende los embeddings por sí solo. La guía indica el camino explícito:
# Reinicializa el cerebro con el modelo de embeddings de Voyage
gbrain init --force --embedding-model voyage:voyage-4
5. Pasa a Postgres si se te queda pequeño 
Si el cerebro crece o lo quieres compartir, gbrain init --prefer-postgres busca por orden una URL en el entorno, Supabase, un Postgres local, Docker (si lo permites) y, si nada de eso existe, vuelve a PGLite.
Para mover un cerebro que ya tienes:
# Genera un plan de migración y sale sin tocar nada
gbrain migrate --to postgres --url-env GBRAIN_TARGET_URL --json
Ese comando imprime el plan y termina con código de salida 3. Lo apruebas después con --yes --expect <plan_hash>. Es un mecanismo para no migrar a ciegas y está muy bien pensado.
6. Activa el piloto automático (opcional) 
gbrain autopilot --install deja programado el mantenimiento nocturno. Según el README, la optimización de skills (skillopt) tarda unos 20 minutos y cuesta alrededor de 1 dólar en llamadas a la API, así que no es gratis, pero tampoco es una sangría.
Si prefieres no instalar nada en local, existe una versión alojada de pago en gbrain.io. El autohospedaje es gratis.
💡 Los tiempos que da el propio proyecto: instalación en unos 30 minutos, arranque de un agente personal en unos 15 y el tutorial completo de cerebro personal en unas 2 horas. Cuenta con la tarde entera si vas a importar tus notas de verdad.
Conectar GBrain con OpenClaw 
GBrain se concibió para OpenClaw, así que la integración es de las más completas. Hay dos caminos.
El primero es el plugin de ClawHub. El repositorio trae un openclaw.plugin.json que registra el servidor MCP y un motor de contexto llamado gbrain-context-engine. Instalas y activas el plugin con ese id y asignas el hueco correspondiente con plugins.slots.contextEngine = gbrain-context-engine.
El segundo es registrarlo como servidor MCP desde el CLI de OpenClaw:
# Registra GBrain en OpenClaw con ruta absoluta al binario
openclaw mcp add gbrain --command "$(command -v gbrain)" --arg serve --arg --surface --arg starter --arg --advertise --arg verbs --env GBRAIN_HOME=$HOME
La documentación insiste en usar la ruta absoluta del binario, porque el gateway que OpenClaw lanza con launchd no tiene ~/.bun/bin en su PATH. Es el típico fallo que te cuesta una hora si no lo sabes.
Después, para que el agente consulte el cerebro antes de cada respuesta:
# Escribe las instrucciones brain-first en el AGENTS.md del workspace
gbrain setup openclaw
Admite --dry-run para ver qué va a tocar y --workspace <dir> para elegir el agente. Además del bloque en AGENTS.md, instala un pequeño plugin de hooks (gbrain-turn-rule). Para comprobar que todo está en su sitio, openclaw mcp list debe mostrar gbrain. Si quieres llevarte también las skills de GBrain al workspace, gbrain skillpack scaffold --harness openclaw --workspace <ws>.
Conectar GBrain con Hermes Agent 
Con Hermes Agent, el agente de Nous Research, la documentación de GBrain está escrita contra la versión v0.20.0 (2026.8.3). El registro es un comando largo con dos manías que conviene conocer:
# Registra GBrain como servidor MCP en Hermes
printf 'Y\n' | hermes mcp add gbrain --env GBRAIN_HOME=$HOME --connect-timeout 60 --command $(which gbrain) --args serve --surface starter --advertise verbs
La primera manía: --args tiene que ser la última opción. La segunda: el comando devuelve código 0 aunque la conexión falle o lo canceles, así que no te fíes del código de salida. Comprueba con hermes mcp list y hermes mcp test gbrain.
Luego toca que Hermes use el cerebro de verdad:
# Añade las instrucciones brain-first al SOUL.md de Hermes
gbrain setup hermes --instructions-only
Esto escribe un bloque marcado en ~/.hermes/SOUL.md y un hook pre_llm_call en la configuración. Ojo: si SOUL.md no existe, el setup no lo crea.
Hay un matiz técnico interesante. Hermes no lee las instrucciones que publica un servidor MCP, así que GBrain le hace llegar la memoria esencial por otra vía, un fichero de contexto de proyecto:
# Genera .hermes.md en la raíz del repo con la memoria esencial
gbrain compile-context --target hermes --include-core
El fichero se excluye de git solo, a través de .git/info/exclude. Para el resto de agentes (Claude Desktop, Cursor, ChatGPT, Perplexity, opencode y compañía) el servidor genérico es gbrain serve --surface starter, y si necesitas exponerlo en remoto tienes gbrain serve --http con OAuth 2.1 o gbrain mcp expose sobre Tailscale.
Memoria, MCP, skills... montar el entorno de tus agentes cambia cada semana. Cada domingo, +7.200 developers reciben 12 recursos seleccionados sobre programación con IA. Gratis, desde 2018.
Suscríbete gratis →Lo que GBrain mejora frente a la memoria de OpenClaw 
Para ser justos, hay que empezar por lo que OpenClaw ya hace bien, que no es poco.
Su memoria es Markdown plano en el workspace del agente. Tiene un MEMORY.md de largo plazo que se carga al empezar cada sesión, notas diarias en memory/AAAA-MM-DD.md que se indexan para buscarlas, un USER.md opcional y un proceso de dreaming, activo por defecto, que asciende lo importante de las notas diarias a MEMORY.md. La documentación oficial lo resume así: el modelo solo recuerda lo que se guarda en disco, no hay estado oculto. Y la búsqueda, con el plugin memory-core sobre SQLite, ya es híbrida (vectores y palabras clave) si configuras un proveedor de embeddings.
Entonces, ¿qué aporta GBrain? Cuatro cosas concretas.
Escala sin truncar. Si MEMORY.md supera el presupuesto de ficheros de arranque, el fichero sigue en disco pero la copia que se inyecta al modelo se trunca. GBrain no inyecta un fichero: el agente consulta lo que necesita en cada turno sobre un índice que en la instalación de Garry Tan supera las 155.000 páginas.
Estructura en lugar de notas. Las notas diarias de OpenClaw son prosa con fecha. GBrain guarda páginas con tipo (persona, empresa, reunión, proyecto), cada una con su línea de tiempo y sus hechos con fuente. Preguntar “qué sé de esta empresa y quién me la presentó” deja de ser buscar entre párrafos.
Un grafo de relaciones. Los enlaces entre personas, empresas y documentos se extraen solos y se pueden recorrer. El README publica el efecto en su benchmark propio (BrainBench): en preguntas de relaciones, el recall@5 en producción pasa de 0,6626 a 0,7241 al activar la recuperación por relaciones. Son cifras del propio proyecto, medidas en su banco de pruebas, pero al menos están publicadas con método en docs/eval.
Correcciones y retirada de hechos. Un hecho mal recordado en MEMORY.md se queda ahí hasta que alguien lo edita. En GBrain un hecho tiene procedencia y se puede corregir o retirar de forma explícita, y el ciclo nocturno busca contradicciones entre páginas.
🔑 Lo que no cambia: OpenClaw sigue siendo quien decide, habla contigo y ejecuta herramientas. Su
SOUL.md, su configuración y sus permisos siguen siendo suyos. GBrain solo se queda con la parte de recordar.
Lo que GBrain mejora frente a la memoria de Hermes Agent 
En Hermes la diferencia es todavía más visible, porque su memoria nativa es deliberadamente pequeña.
Según su documentación, Hermes guarda la memoria persistente en dos ficheros dentro de ~/.hermes/memories/: MEMORY.md con un límite de 2.200 caracteres (unos 800 tokens) y USER.md con 1.375 caracteres (unos 500 tokens). Se cargan en el system prompt como una foto fija al inicio de la sesión, y esa foto “nunca cambia a mitad de sesión”: lo que el agente escribe llega al disco al momento, pero no lo ve hasta la siguiente.
La herramienta memory solo tiene acciones de añadir, parchear y borrar. No hay acción de leer. Y cuando la memoria se llena no se compacta sola: la herramienta devuelve un error y el agente tiene que consolidar o quitar entradas. Para el historial existe session_search, una búsqueda de texto completo (SQLite FTS5) sobre las sesiones pasadas.
Es un diseño sensato para un asistente personal: poco contexto fijo, siempre a mano y barato en tokens. Pero 2.200 caracteres dan para tus preferencias, no para tu vida profesional.
Lo que GBrain añade a Hermes:
- Capacidad sin techo práctico: no compites por caracteres con el resto de la memoria.
- Consulta durante la sesión: el cerebro se consulta por MCP cuando hace falta, no es una foto que se congela al arrancar.
- Búsqueda semántica sobre conocimiento, no solo texto completo sobre conversaciones.
- Memoria esencial siempre cargada, a través del
.hermes.mdque generagbrain compile-context, para lo que sí conviene que el agente sepa sin preguntar.
Hermes ya admite proveedores de memoria externos que funcionan junto a la memoria nativa (Honcho, Mem0, Supermemory, Hindsight y otros desde su catálogo de plugins). GBrain no va por ese camino de plugin de memoria, sino como servidor MCP más instrucciones en SOUL.md. La consecuencia práctica es la ventaja que más pesa de todas.
La ventaja que no tiene ninguno de los dos: un cerebro compartido 
La memoria de OpenClaw vive en el workspace de OpenClaw. La de Hermes, en ~/.hermes. La de Claude Code, en su CLAUDE.md y su auto memory. Si usas dos o tres agentes (y a estas alturas, ¿quién no?), cada uno tiene su cuaderno y ninguno lee el del vecino.
GBrain invierte la relación. La memoria es tuya, vive en tu repositorio y en tu base de datos, y los agentes son clientes que se conectan a ella. Lo que Hermes aprende en Telegram por la mañana lo consulta Claude Code en la terminal por la tarde. Si mañana cambias de agente, el cerebro se queda.
La guía de límites de memoria del proyecto lo formula así: GBrain puede llevar hechos y preferencias duraderas entre agentes que tienen acceso al mismo cerebro y la misma fuente. Y deja fuera, a propósito, lo que debe seguir siendo local: el progreso de la tarea actual, la salida temporal de herramientas, rutas locales, plugins activos, la configuración de MCP y las credenciales.
💡 Este es el argumento de fondo para instalarlo. Si solo usas un agente y tu memoria cabe en una hoja, la memoria nativa te sobra. Si usas varios y llevas meses acumulando contexto, tener una sola fuente de verdad se nota cada día.
GBrain frente a Claude-Mem, MemPalace y otros sistemas de memoria 
En Web Reactiva hemos repasado varios sistemas de memoria para agentes, y cada uno ataca una capa distinta. La tabla es cualitativa: no hay un benchmark común que los mida a todos igual.
| Sistema | Qué recuerda | Dónde vive | Multiagente | Para quién |
|---|---|---|---|---|
| GBrain | Personas, empresas, reuniones, hechos con fuente | Markdown + PGLite o Postgres | Sí, por MCP (Claude Code, Codex, OpenClaw, Hermes y más) | Quien usa varios agentes y acumula mucho conocimiento |
| Memoria de OpenClaw | Notas diarias y memoria de largo plazo | Markdown + SQLite en el workspace | Solo OpenClaw (importa de otros) | Usuarios de OpenClaw con memoria moderada |
| Memoria de Hermes | Preferencias y hechos cortos | Dos ficheros con límite de caracteres | Solo Hermes | Asistente personal ligero |
| Claude-Mem | Lo que pasa en cada sesión de código | Base de datos local con hooks | Varios agentes de código | Developers que retoman trabajo entre sesiones |
| MemPalace | Conversaciones completas, organizadas en un palacio | Local, ChromaDB | Por MCP | Quien quiere memoria local sin API |
| Memoria de Claude Code | Reglas, convenciones y patrones del proyecto | CLAUDE.md y auto memory |
Solo Claude Code | Cualquier proyecto con Claude Code |
La diferencia de enfoque es nítida. Claude-Mem es memoria operativa de programación: qué ficheros tocaste, qué bug encontraste el viernes. MemPalace guarda las conversaciones tal cual y apuesta por recuperarlas bien. GBrain es un modelo de conocimiento sobre tu mundo: gente, empresas, decisiones y la relación entre todo ello. Por eso Garry Tan lo usa con agentes personales que leen su correo y su calendario, no solo con agentes de código.
Tu segundo cerebro, escrito por tu agente
Crea tu segundo cerebro con LLM Wiki, solo con prompts
Si lo que te atrae de GBrain es tener tu conocimiento en Markdown que mantiene el agente, la guía monta un wiki en ocho pasos: esquema, tus enlaces, un vídeo de YouTube, revisión y skills, cada operación con su commit.
Quiero montar mi wiki →Ocho pasos, solo prompts, con Claude Code, Codex u OpenCode
También conviene no olvidar que nada de esto excluye a lo demás. Un CLAUDE.md bien escrito sigue siendo el sitio de las reglas del proyecto. GBrain no compite con él: de hecho, gbrain setup claude-code escribe ahí su bloque de instrucciones.
Las integraciones que hacen de GBrain algo más que una base de notas 
Una memoria solo es útil si algo la alimenta. GBrain trae recetas para conectar fuentes reales, que puedes listar con gbrain integrations list:
- Google: Gmail, Calendar y Contactos con tu propio cliente OAuth.
- Reuniones: transcripciones de Fireflies como primera integración.
- Slack como fuente, y webhooks de correo y calendario.
- Voz: Twilio con OpenAI Realtime.
- Credenciales: un almacén propio,
gbrain creds.
Las skills también forman parte del paquete. GBrain incluye skills y recetas curadas que gbrain skillpack scaffold copia al repositorio de tu agente, y una herramienta, skillopt, que propone cambios en los SKILL.md y solo se queda con los que puntúan mejor. Si las skills te pillan de nuevas, en la guía de protocolos de la IA generativa tienes cómo encajan con MCP.
Si estás montando la memoria de tus agentes, cada domingo compartimos lo que vamos probando sobre herramientas de IA para developers. Ya somos +7.200 y es gratis.
Suscríbete gratis →Limitaciones y letra pequeña de GBrain 
El README es bastante transparente con sus límites, y merece la pena tenerlos presentes:
- PGLite se queda en unas 50.000 páginas. Para más, Postgres con pgvector.
- Tus datos pueden salir de tu máquina. Los proveedores en la nube de embeddings, reranking, extracción y síntesis reciben texto. Y aunque trabajes sin ninguna clave, el modelo de tu agente ve lo que el cerebro le devuelve.
- Exportar a Markdown no es una copia de seguridad completa. Las páginas que solo viven en la base de datos, los hechos sin resolver, el historial y el estado operativo necesitan su propio backup.
- El grafo depende del mantenimiento. Escribir una página y actualizar el grafo son operaciones separadas, y la frescura depende de los trabajos programados.
- Memorable, la memoria procedimental, viene apagada y su relay puede enviar trazas redactadas y consultas fuera de tu máquina. Pide consentimiento explícito.
- El ritmo de cambios es altísimo. Las PR de la comunidad se agrupan en oleadas, y cualquier cambio de esquema, ranking, protocolo MCP o seguridad requiere discusión de diseño previa. Con 547 issues abiertas y más de 13.000 commits, prepárate para leer el changelog antes de cada actualización.
- PGLite tiene algún susto conocido: el error
RuntimeError: Aborted()es un problema del WAL, y la propia documentación da la salida congbrain pglite-repair --dry-runy después--yes.
🛡️ Si vas a meter tu correo y tus reuniones, decide antes qué proveedores reciben texto. La opción totalmente local existe (Ollama o llama.cpp para embeddings y reranker), pero tienes que configurarla tú.
Los casos en los que GBrain compensa 
GBrain tiene sentido cuando se cumplen dos condiciones: usas más de un agente y tu memoria ya no cabe en un fichero. Si las dos son verdad, es de lo más completo que hay ahora mismo en open source.
Si solo usas Claude Code para programar, probablemente te baste con un buen CLAUDE.md y, si acaso, algo como Claude-Mem. Si tu Hermes recuerda tus preferencias y poco más, sus 2.200 caracteres están bien pensados. Instalar una base de datos de conocimiento para recordar que prefieres TypeScript es matar moscas a cañonazos.
Pero si tu agente personal lee tu correo, asiste a tus reuniones y lleva la cuenta de con quién hablas y de qué, la memoria nativa se queda corta rápido. Ahí GBrain marca la diferencia, y lo hace dejando la memoria en ficheros que son tuyos.
Lo que más me gusta del planteamiento es esa inversión: la memoria deja de ser una propiedad del agente y pasa a ser tuya. Los agentes vienen y van (en dos años hemos visto nacer y morir unos cuantos). Tu conocimiento debería quedarse.
TL;DR 
- 🧠 GBrain es la memoria open source (MIT) que Garry Tan, CEO de Y Combinator, escribió para sus agentes de OpenClaw y Hermes, con más de 31.900 estrellas en GitHub.
- 🔧 Se instala con
bun install -g github:garrytan/gbrain#stableygbrain setup claude-code(ocodex,openclaw,hermes). No está en npm: el paquete con ese nombre es otro. - 🗄️ Guarda tu conocimiento en Markdown, lo indexa en PGLite (hasta ~50.000 páginas) o Postgres con pgvector, y lo sirve por MCP con búsqueda híbrida y un grafo de relaciones.
- ⚡ Frente a OpenClaw y Hermes aporta escala sin truncar (Hermes limita
MEMORY.mda 2.200 caracteres), páginas con tipo, hechos corregibles con fuente y, sobre todo, un mismo cerebro para todos tus agentes. - 🎯 Merece la pena si usas varios agentes y acumulas mucho contexto. Para un solo agente de código, un buen
CLAUDE.mdsigue bastando.
FAQ 
¿Qué es GBrain?
GBrain es un sistema de memoria open source para agentes de IA creado por Garry Tan. Guarda personas, empresas, reuniones y hechos en repositorios de Markdown, los indexa en Postgres y los sirve por MCP o CLI a agentes como Claude Code, Codex, OpenClaw o Hermes. Tiene licencia MIT.
¿Cómo se instala GBrain?
Necesitas Bun 1.4.4 o superior. Se instala con bun install -g github:garrytan/gbrain#stable y después se conecta con gbrain setup claude-code, gbrain setup codex, o se inicializa a mano con gbrain init --pglite --no-embedding. Funciona en macOS y Linux.
¿Puedo instalar GBrain con npm?
No. El autor avisa de que GBrain no está publicado en npm y de que el paquete gbrain de npm es un proyecto distinto. Usa siempre la forma github:garrytan/gbrain#stable o clona la rama stable.
¿GBrain necesita claves de API?
No para empezar. La búsqueda por palabras clave funciona sin claves. Con VOYAGE_API_KEY activas embeddings y reranker, y con ANTHROPIC_API_KEY u OPENAI_API_KEY activas extracción de hechos, síntesis y expansión de consultas. También admite proveedores locales como Ollama o llama.cpp.
¿GBrain sustituye a OpenClaw o a Hermes Agent?
No. GBrain no es un agente, es la capa de memoria que se conecta a ellos. El agente sigue decidiendo, conversando y ejecutando herramientas; GBrain le da un sitio donde consultar y guardar lo que sabe. Su configuración, identidad y permisos siguen en el agente.
¿Qué mejora GBrain frente a la memoria de Hermes Agent?
Hermes limita su memoria persistente a dos ficheros de 2.200 y 1.375 caracteres, que se cargan como foto fija al inicio de la sesión. GBrain no tiene ese techo, se consulta durante la sesión por MCP, ofrece búsqueda semántica y comparte la memoria con otros agentes.
¿Qué mejora GBrain frente a la memoria de OpenClaw?
OpenClaw ya usa Markdown y búsqueda híbrida, pero inyecta MEMORY.md en el contexto y lo trunca si supera su presupuesto. GBrain aporta páginas con tipo, un grafo de relaciones entre personas y empresas, hechos con procedencia que se pueden corregir, y un cerebro que comparten varios agentes.
¿Qué base de datos usa GBrain?
Por defecto PGLite, que es Postgres 17 compilado a WASM y no requiere configuración, recomendado hasta unas 50.000 páginas. Para cerebros más grandes o compartidos entre máquinas usa Postgres con pgvector, en Supabase o autohospedado, y migra con gbrain migrate --to postgres.
¿Mis datos salen de mi máquina con GBrain?
Depende de los proveedores que configures. Los servicios en la nube de embeddings, reranking, extracción y síntesis reciben texto. Puedes trabajar en local con Ollama, llama.cpp o LM Studio, aunque el modelo de tu agente siempre verá lo que el cerebro le devuelva.
¿Es GBrain mejor que Claude-Mem o MemPalace?
Resuelven problemas distintos. Claude-Mem registra lo que pasa en tus sesiones de programación, MemPalace guarda conversaciones completas en local y GBrain modela tu conocimiento (personas, empresas, decisiones) para varios agentes a la vez. Elige según qué quieres que recuerde tu agente.
Fuentes 
- Repositorio de GBrain en GitHub
- Guía de instalación de GBrain
- GBrain con OpenClaw
- GBrain con Hermes Agent
- Límites de la memoria en GBrain
- Changelog de GBrain
- Memoria en OpenClaw (documentación oficial)
- Memoria persistente en Hermes Agent (documentación oficial)
- Hermes Agent: el agente que aprende de sus errores — Web Reactiva
- Claude-Mem, memoria persistente para Claude Code — Web Reactiva
- MemPalace: el sistema de memoria de Milla Jovovich — Web Reactiva
🧨 Última oportunidad para recibir la dinamita que mereces sobre programación con IA el próximo domingo: Suscríbete gratis a Web Reactiva en https://webreactiva.com/newsletter

Escrito con la ayuda de la IA generativa de Claude, fuentes fidedignas y con un human in the loop:
Dani Primo.
12 recursos para developers cada domingo en tu bandeja de entrada
Además de una skill práctica bien explicada, trucos para mejorar tu futuro profesional y una pizquita de humor útil para el resto de la semana. Gratis.