Buscar código, audio y vídeo con EmbeddingGemma 2
Tabla de contenidos
Escribes «dónde se evita que un usuario edite publicaciones ajenas» y el buscador te devuelve la función que lo hace, aunque se llame assert_owner y no aparezca ni una de tus palabras. Escribes «la persona muestra un diagrama» y te devuelve el segundo exacto de un vídeo. Escribes «problemas de despliegue» y aparece un fragmento de audio.
Todo con un único modelo, que cabe en tu portátil y se puede ejecutar en el navegador.
Eso es lo que promete EmbeddingGemma 2, el modelo de embeddings que Google DeepMind publicó el 6 de octubre de 2026. La demo impresiona. Lo que toca averiguar es si mejora lo que ya tienes funcionando y en qué casos merece la pena.
En este artículo vas a encontrar:
- Qué es EmbeddingGemma 2 y qué cambia frente a la primera versión
- Los casos de uso donde encaja, de buscar código por intención a encontrar momentos en vídeos
- Lo que dicen las primeras pruebas independientes, con sus aciertos y sus fallos
- Cuánto puedes comprimir el índice sin perder calidad
- Código para empezar y proyectos que ya lo usan
- Tres ideas concretas que yo probaría y cuándo no compensa migrar
¿Qué es EmbeddingGemma 2 y qué cambia respecto a la primera versión? 
EmbeddingGemma 2 es un modelo open source de embeddings que convierte texto, código, imágenes, audio y vídeo en vectores de 768 números dentro de un mismo espacio. Eso permite comparar una frase con una captura de pantalla o con un trozo de podcast usando la misma operación: medir la distancia entre dos vectores.
Un embedding no genera texto. No responde preguntas ni escribe código. Su trabajo es otro: traducir contenido a coordenadas para que lo que significa lo mismo quede cerca. Es la pieza que hay debajo de casi cualquier buscador semántico y de cualquier sistema RAG.
Según la model card oficial, estos son los datos clave:
- 740M parámetros en total, repartidos en tres piezas: un modelo de texto de 270M, un encoder de visión de 170M y un encoder de audio de 300M.
- Puedes cargar solo los encoders que necesites. Si solo vas a buscar texto, te quedas en 270M.
- Contexto de 8.192 tokens compartido entre todas las modalidades.
- Más de 100 idiomas, con la advertencia de que el rendimiento varía según el idioma.
- Licencia Apache 2.0, disponible en Hugging Face y Kaggle.
La primera EmbeddingGemma, de septiembre de 2025, era solo de texto y tenía unos 308M parámetros. Si vienes de Gemma 4 y sus modelos para ejecutar en local, la familia es la misma, pero el oficio es otro: Gemma 4 genera, EmbeddingGemma 2 indexa y recupera.
¿Qué dicen los benchmarks oficiales? 
El salto grande está en código. En MTEB Code, la v2 marca 78,68 de NDCG@10 frente a 68,76 de la v1, una mejora relativa de alrededor del 14 % (fuente: model card). En texto multilingüe, en cambio, apenas se mueve: 61,36 frente a 61,15 en MTEB multilingual v2.
| Benchmark | v1 | v2 | Qué mide |
|---|---|---|---|
| MTEB multilingual v2 | 61,15 | 61,36 | Texto en muchos idiomas |
| MTEB Code v1 (NDCG@10) | 68,76 | 78,68 | Recuperar código |
| MMEB v2 Image (Hit@1) | — | 57,28 | Imágenes |
| MMEB v2 VisDoc (NDCG@5) | — | 67,84 | Documentos visuales |
| MMEB v2 Video (Hit@1) | — | 50,67 | Vídeo |
| MAEB | — | 49,39 | Audio |
🔑 La lectura rápida: si tu buscador es solo de texto en un idioma con mucho corpus, la v2 no promete un cambio grande. Si buscas código o necesitas imágenes, audio o vídeo, ahí es donde está la novedad.
¿Qué significa que los embeddings sean multimodales? 
Significa que una consulta escrita puede encontrar una imagen, un fragmento de audio o un fotograma de vídeo, porque todo acaba en el mismo mapa de 768 dimensiones. No hay un índice para imágenes y otro para texto que luego tengas que mezclar a mano.
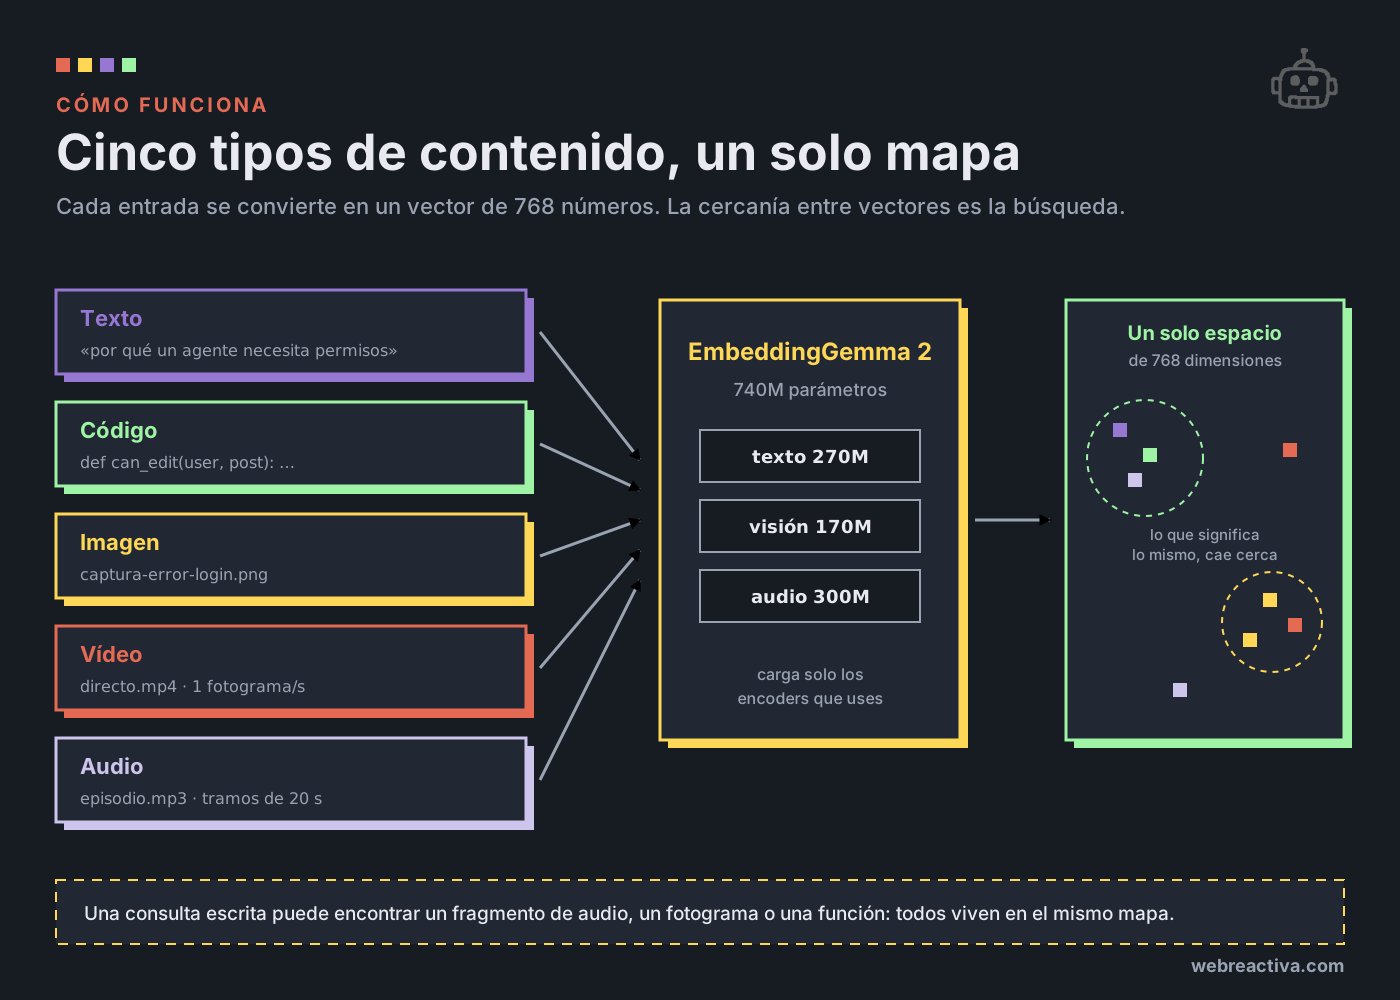
Cada modalidad tiene sus límites, y conviene conocerlos antes de diseñar nada (fuente: model card):
| Modalidad | Cómo se mide | Límite práctico por entrada |
|---|---|---|
| Texto y código | 1 token por subpalabra | Hasta 8.192 tokens |
| Imagen | 280 tokens por imagen por defecto (de 70 a 1.120) | Unas 29 imágenes con el presupuesto por defecto |
| Vídeo | 1 fotograma por segundo, 140 tokens por fotograma | Unos 58 fotogramas |
| Audio | 25 tokens por segundo, mono a 16 kHz | Unos 327 segundos |
Ese último dato condiciona el diseño. Un episodio de podcast de una hora no entra entero: tienes que trocearlo. Y cuanto más fino lo trocees, más preciso será el minuto que devuelvas.
Hay dos detalles de la letra pequeña que te ahorran disgustos:
- Los textos llevan prefijo de tarea. Una consulta de búsqueda va como
task: search result | query: ...y un documento comotitle: ... | text: .... Las imágenes, el audio y el vídeo no llevan prefijo. Google avisa de que omitir el prefijo puede bajar la calidad. - Nada de float16. La model card pide bfloat16 o float32, porque float16 puede producir NaN o embeddings degradados sin avisar.
⚠️ Los vectores de la v1 y la v2 no son compatibles. Si migras, toca reindexar todo el corpus.
¿Para qué sirve EmbeddingGemma 2? Doce casos de uso 
Sirve para cualquier tarea que consista en encontrar, agrupar o comparar contenido por su significado. Google lista como usos previstos la recuperación (texto, código, multimodal y RAG), la clasificación, el clustering, la similitud semántica y la verificación de hechos.
Estos son los casos más interesantes, aterrizados a ejemplos concretos. Son aplicaciones contempladas por Google o enseñadas en sus demos; la calidad depende de tu contenido y hay que medirla en cada caso.
| Caso | Ejemplo concreto | Modalidad |
|---|---|---|
| Buscar código por intención | «Dónde se evita que un usuario edite publicaciones ajenas», aunque no exista una función llamada permissions |
Texto → código |
| Dar contexto a un agente de programación | Recuperar funciones y archivos relevantes antes de que el agente implemente o revise un cambio | Texto → código |
| Buscar en documentación privada | Encontrar la explicación de una integración entre manuales, notas y documentos locales | Texto |
| RAG sobre archivos multimedia | Recuperar texto, imágenes o audio relacionados con una pregunta y pasárselos al modelo que responde | Mixta |
| Buscar momentos en vídeos | Localizar «la persona muestra un diagrama» y devolver el fragmento con su timestamp | Texto → vídeo |
| Buscar en grabaciones de audio | Recuperar fragmentos relacionados con «problemas de despliegue» con una consulta escrita | Texto → audio |
| Buscar imágenes con lenguaje natural | Encontrar «captura de un error de autenticación» en una carpeta de imágenes | Texto → imagen |
| Buscar por ejemplo visual | Partir de una imagen y recuperar otras parecidas | Imagen → imagen |
| Clasificar sin entrenar un clasificador | Comparar un mensaje con descripciones de categorías: facturación, soporte técnico o cancelaciones | Texto |
| Enrutar consultas | Decidir si una petición encaja mejor con documentación, código o soporte, por similitud con sus descripciones | Texto |
| Agrupar contenido | Organizar comentarios, incidencias o documentos por temas sin etiquetas previas | Texto |
| Detectar contenido parecido | Encontrar documentos o consultas que dicen prácticamente lo mismo | Texto |
Fíjate en que la mitad de la tabla es texto puro. La parte multimodal es la que da titulares, pero clasificar, enrutar y deduplicar sin entrenar nada son trabajos que cualquier equipo tiene encima de la mesa y que ahora puedes resolver con un modelo de 270M en tu propia máquina.
¿Por qué importa para los agentes de programación? 
Porque un agente sin buen contexto inventa. Antes de tocar un fichero, el agente necesita encontrar qué código hace lo que le has pedido cambiar. Si su búsqueda es grep, depende de que adivine los nombres. Si es semántica, puede buscar por intención.
Ese es el caso donde la v2 sale mejor parada en las pruebas que veremos ahora: recuperar código. Y es justo lo que hacen herramientas de memoria para agentes como MemPalace o los buscadores locales que se conectan por MCP.
Un buscador mejor no arregla un agente sin reglas
Recuperar el código correcto es la mitad del trabajo. La otra mitad es el flujo: en la lección 3 escribimos las reglas de la sesión en un AGENTS.md, regla a regla, sobre un proyecto real.
Entra en el curso →¿Qué dicen las primeras pruebas independientes? 
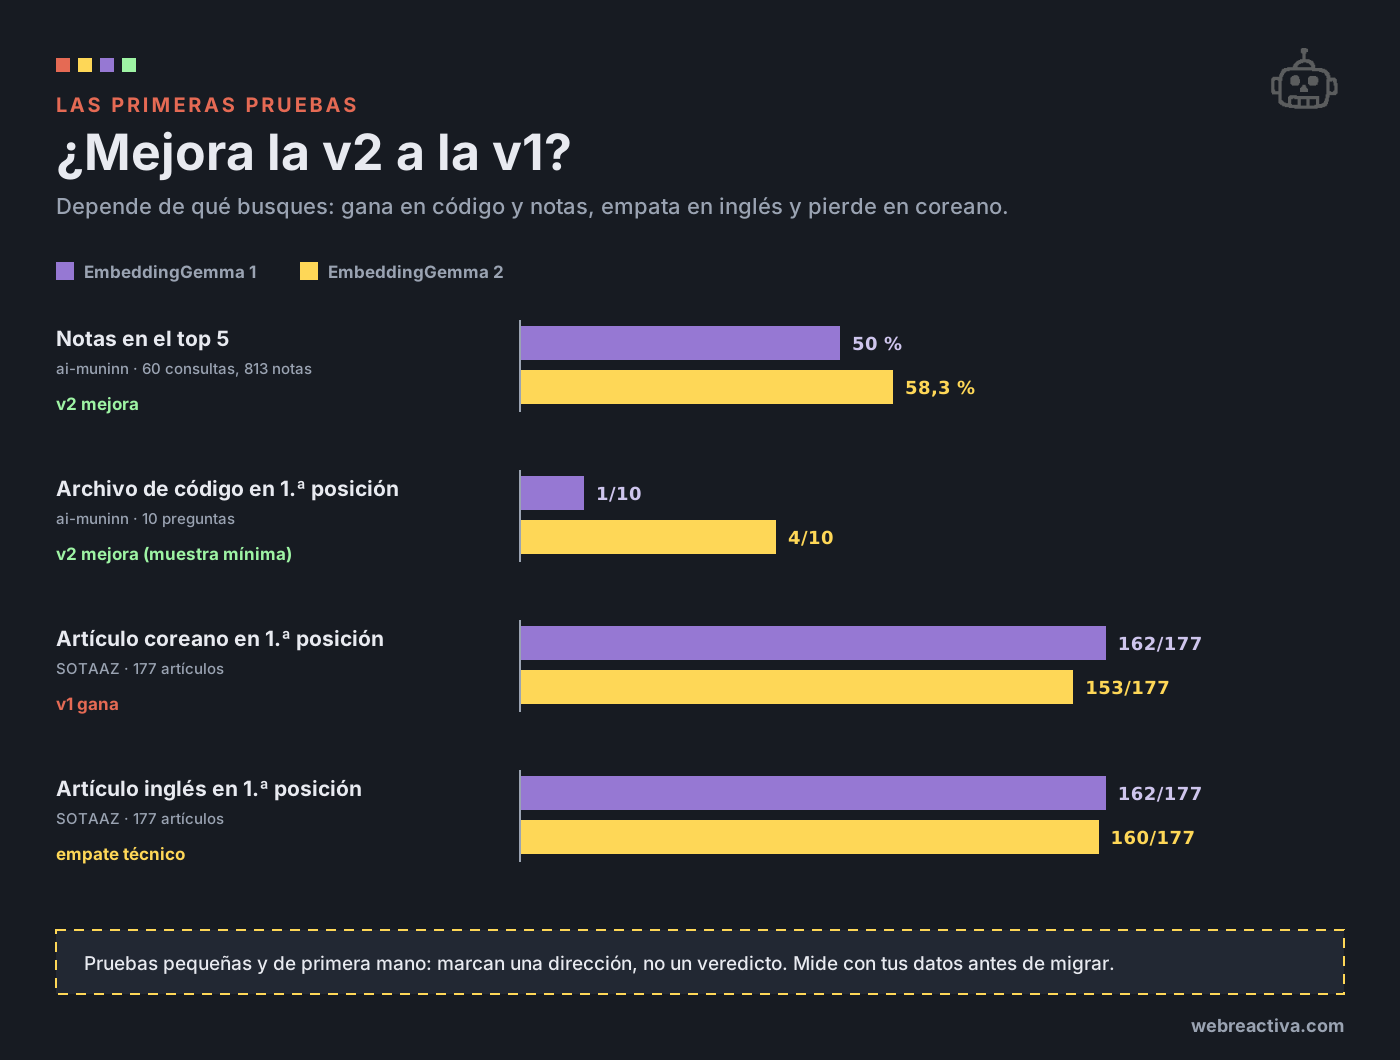
Que la v2 mejora en notas y código, empata en inglés y pierde en coreano. Con el modelo recién salido, todavía hay más prototipos que evaluaciones serias, pero ya hay tres pruebas de primera mano que merece la pena leer con calma.
ai-muninn: mejor en notas y código, mixto en multimedia 
El autor de ai-muninn comparó las dos versiones como buscador de las notas de su asistente de IA, en un M1 Max con 32 GB. Su sistema en producción usa QMD, un buscador local que ejecuta la v1 con llama.cpp.
| Prueba | v1 | v2 |
|---|---|---|
| Nota correcta en el top 5 (60 consultas, 813 notas) | 50 % | 58,3 % |
| Nota correcta en primera posición | 38,3 % | 41,7 % |
| Archivo de código correcto en primera posición (10 preguntas) | 1/10 | 4/10 |
| Latencia mediana por consulta | 50,3 ms | 48,3 ms |
| Tiempo para indexar 813 notas | 81,8 s | 138,8 s |
| Memoria pico (RSS) | 1,03 GiB | 2,75 GiB |
Hay un dato que me gusta mucho de esta prueba: ninguna consulta que la v1 tenía en el top 5 se cayó con la v2. Mejora sin romper.
El precio está en la indexación (1,7 veces más lenta) y en la memoria (2,7 veces más). La latencia por consulta, que es lo que nota el usuario, se queda igual.
En multimedia, el resultado es mixto:
- Escenas visuales: resultados razonables en las tres consultas reales, aunque una era una coincidencia aproximada.
- Capturas de pantalla: dos de tres consultas acertaron, con todas las puntuaciones apelotonadas entre 0,66 y 0,70. Poca separación entre lo bueno y lo malo.
- Audio: «una persona hablando» devolvió narraciones en los tres primeros puestos. «Música animada» devolvió sobre todo voz y no encontró la intro musical.
⚠️ La prueba de código son 10 preguntas y la de música tenía una sola pista musical distinta. El propio autor lo presenta como una dirección, no como un resultado firme. Y su instalación de producción sigue en la v1, porque llama.cpp todavía no carga la arquitectura de la v2.
SOTAAZ: en coreano, la v1 ganó 
SOTAAZ evaluó 177 artículos, usando sus descripciones como consultas. En coreano, la v1 colocó primero el artículo correcto 162 veces, frente a 153 de la v2, una diferencia estadísticamente significativa (p = 0,022). En inglés, 162 frente a 160: sin diferencia significativa.
La distancia casi desaparece en el top 5: 176 aciertos de la v1 frente a 175 de la v2. La v2 encuentra el artículo, pero lo coloca un puesto más abajo con más frecuencia.
Su conclusión es honesta: las mejoras de la model card se concentran en código, imágenes, audio y vídeo, y ellos solo probaron texto. Actualizar a la v2 no garantiza mejorar un buscador de texto que ya funciona.
💡 Si tu buscador es en español, nadie ha publicado todavía una prueba equivalente. El español tiene mucho más corpus que el coreano, pero eso es una intuición, no un dato. Mide antes de migrar.
Pruebas como la de ai-muninn o SOTAAZ son las que compartimos cada domingo: lo que pasa cuando alguien mide una herramienta de IA en su proyecto, no en la demo. Somos +7.200 developers.
Quiero esa dinamita 🧨¿Cuánto ocupa el índice y cuánto se puede comprimir? 
Con cuantización binaria a 768 dimensiones conservas en torno al 99 % de la calidad usando 30 veces menos RAM para los vectores. Es el resultado de la prueba que Qdrant hizo con acceso anticipado al modelo.
El punto de partida explica por qué esto importa. Con 10 millones de documentos, los vectores en float32 a 768 dimensiones ocupan 30,7 GB de RAM. El modelo es ligero; los vectores no tanto.
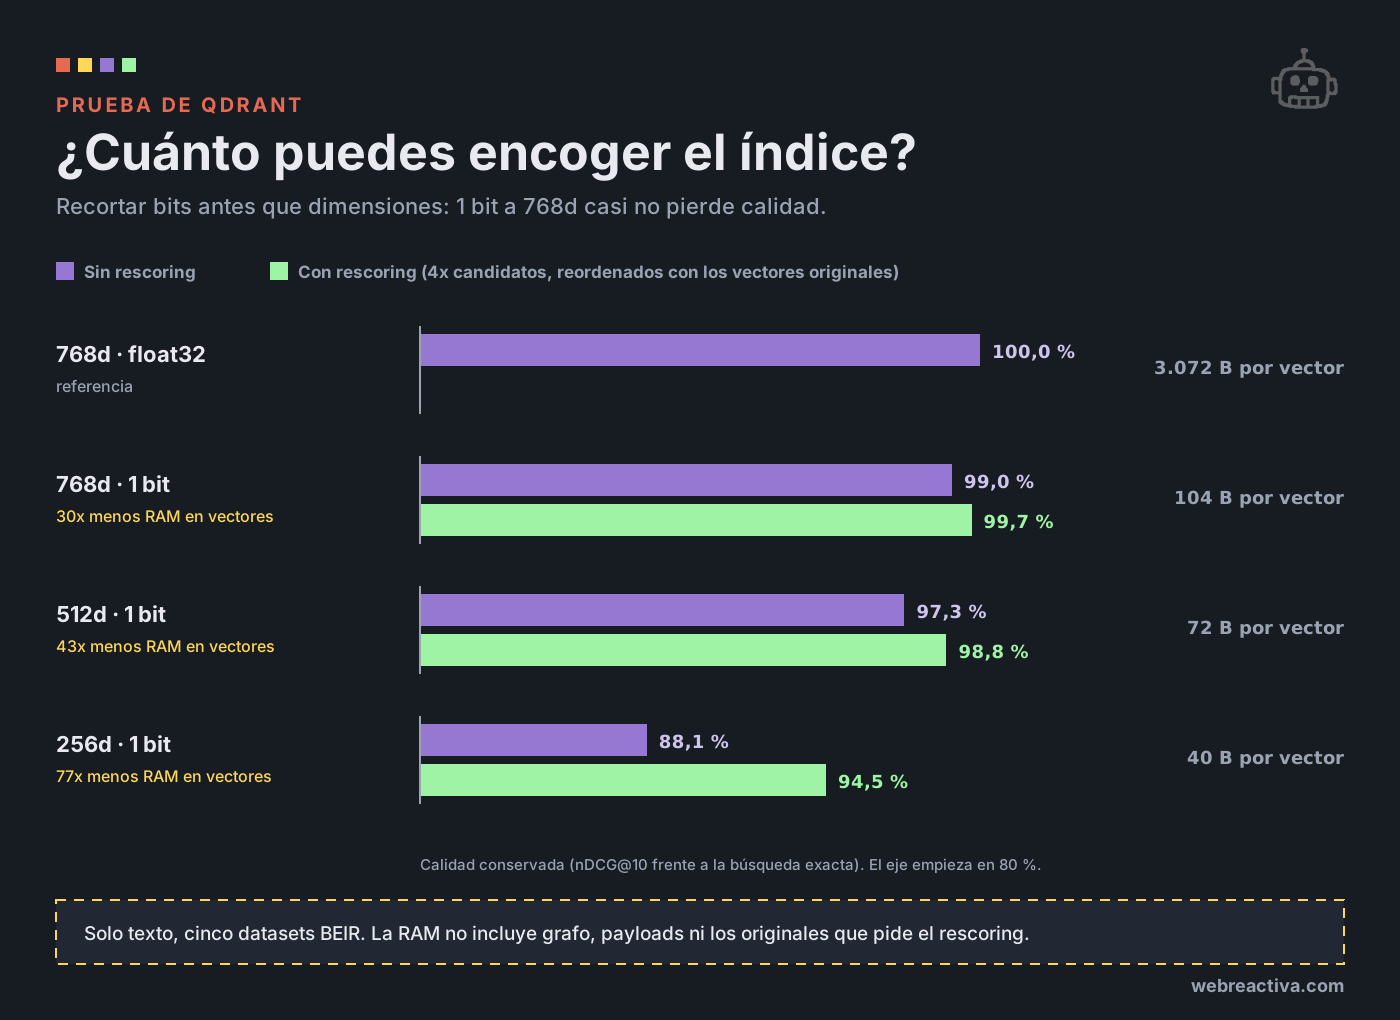
Qdrant midió sobre cinco datasets BEIR (SciFact, NFCorpus, ArguAna, SCIDOCS y FiQA) qué porcentaje de la calidad de la búsqueda exacta se conserva:
- 768d a 1 bit: 99,0 % sin rescoring, 99,7 % con rescoring. 104 bytes por vector en vez de 3.072.
- 512d a 1 bit: 97,3 % y 98,8 %, con 43 veces menos RAM.
- 256d a 1 bit: 88,1 % y 94,5 %, con 77 veces menos RAM.
- 128d a 4 bits: 84 %, con un presupuesto de memoria parecido al de 512d a 1 bit.
La conclusión de Qdrant es clara: recorta bits antes que dimensiones. Las dimensiones se pueden recortar gracias a Matryoshka (la v2 admite quedarse con las primeras 512, 256 o 128 sin volver a generar el embedding), pero cada recorte duele más que pasar a binario.
El rescoring consiste en pedir 4 veces más candidatos de los que necesitas y reordenarlos con los vectores originales. Mejora la calidad, pero obliga a guardar esos originales en algún sitio.
⚠️ Las cifras de RAM de Qdrant cuentan solo los vectores: no incluyen el grafo del índice, los payloads ni los vectores originales del rescoring. Y la prueba es solo de texto, así que no dice nada sobre imágenes o audio.
La model card añade otro aviso: truncar a 128 dimensiones degrada mucho la calidad multimodal. En MMEB pasa de 58,38 a 512d a 45,65 a 128d. Para texto puede valer; para imágenes y vídeo, mejor no bajar de 256.
¿Cómo se usa EmbeddingGemma 2 con sentence-transformers? 
Con sentence-transformers y el identificador google/embeddinggemma-2, cambiando el prompt_name según sea consulta o documento. Este es el ejemplo mínimo, sacado de la ficha del modelo en Hugging Face:
pip install -U sentence-transformers transformers
import torch
from sentence_transformers import SentenceTransformer

# bfloat16 si la GPU lo soporta; si no, float32. Nunca float16
dtype = torch.bfloat16 if torch.cuda.is_available() and torch.cuda.is_bf16_supported() else torch.float32

model = SentenceTransformer(
    "google/embeddinggemma-2",
    model_kwargs={"torch_dtype": dtype},
    # Solo el encoder de texto: 270M en vez de 740M
    config_kwargs={"vision_config": None, "audio_config": None},
)

query = "dónde se evita que un usuario edite publicaciones ajenas"
documents = [
    "def assert_owner(user, post): raise PermissionDenied si post.author != user",
    "def render_feed(posts): devuelve el HTML del listado de publicaciones",
]

# Prefijos de tarea distintos para consulta y documentos
query_emb = model.encode(query, prompt_name="SearchQuery")
doc_embs = model.encode(documents, prompt_name="Document")

print(model.similarity(query_emb, doc_embs))
La ficha lista más prompts para otras tareas: QuestionAnswering, FactChecking, CodeRetrieval, Classification, Clustering y SentenceSimilarity. Para buscar código, CodeRetrieval es el que usó ai-muninn en su prueba (task: code retrieval | query: ).
Si tus documentos tienen título, la recomendación es formatearlos a mano:
# Documento con título: el formato que pide la model card
doc_emb = model.encode(f"title: {title} | text: {body}")

# Vector más pequeño: trunca y vuelve a normalizar
small = model.encode(query, prompt_name="SearchQuery", truncate_dim=256, normalize_embeddings=True)
Para imágenes, audio y vídeo, la ficha muestra un encode que recibe un diccionario con el texto y marcadores <|image|>, <|video|> o <|audio|>, que se rellenan con los ficheros de las claves correspondientes. El ejemplo de audio no aparece completo en la ficha, así que revisa la documentación antes de montar algo en serio.
🛡️ La forma de cargar solo algunos encoders cambia según la librería. Lo de
config_kwargsvale para sentence-transformers; si usas otra, compruébalo en su documentación.
Si lo que quieres es un RAG completo con una base de datos vectorial y un modelo que responda, ya montamos uno paso a paso en el asistente personal con RAG de Laravel AI SDK. La pieza de embeddings es intercambiable: puedes sustituirla por EmbeddingGemma 2 y comparar.
Monta el RAG entero
Del vector suelto a un RAG que responde, sin escribir el backend
Verás cómo se conectan un Vector Store, un modelo local con Ollama y un bot con memoria en workflows reales de n8n, y cómo un MCP te escribe esos workflows desde Claude Code.
Entrar a la masterclass →Masterclass en directo · 1h50min · 14 capítulos
¿Qué proyectos usan ya EmbeddingGemma 2? 
De momento, sobre todo demos y prototipos: búsqueda multimodal en el navegador, galerías de fotos que se buscan por texto y buscadores de documentos para agentes. Estos son los que he encontrado:
| Proyecto | Qué hace | Estado y alcance |
|---|---|---|
| EmbeddingGemma 2 WebGPU | Búsqueda multimodal sobre imágenes, vídeos y audio desde el navegador | Demo pública. Su autor indica que usa un único modelo para la recuperación |
| ruNNtime | Su autor presentó una galería de fotos que se busca con texto usando los componentes de texto y visión de la v2 | Port experimental a WebGPU y TypeScript |
| Local Knowledge Layer | Indexa documentos locales (PDF, Markdown, DOCX…) y ofrece búsqueda a agentes por MCP | Solo texto, SQLite y vectores de 256 dimensiones. Multimedia en la hoja de ruta |
| Google AI Edge Gallery | Incluye Instant Media Search y Video Moments Finder | Demos oficiales para buscar archivos y momentos de vídeo en el dispositivo |
| LiteRT multimodal search | Búsqueda multimodal en el navegador con LiteRT | Referencia oficial para experimentar con despliegue local |
Local Knowledge Layer es el más fácil de entender si trabajas con agentes. Expone dos herramientas MCP de solo lectura, search_documents y get_document_context, y se arranca con tres comandos:
uv sync --python 3.12
./lkl index
./lkl search "Where are the rules for approving agent actions?"
Tiene una decisión de diseño que me parece sensata para empezar: no usa un índice aproximado, compara la consulta con todos los vectores guardados en SQLite. Con unos miles de documentos va de sobra y te ahorras una base de datos vectorial. Eso sí, el SQLite guarda el texto extraído de tus documentos, así que trátalo como información sensible.
En el hilo de r/LocalLLaMA sobre la demo de WebGPU, el mayor entusiasmo está en poder ejecutar la búsqueda multimodal dentro del navegador, sin servidor. La discusión todavía tiene más reacciones a las demos que mediciones propias.
¿Qué tres proyectos probaría yo con EmbeddingGemma 2? 
Un buscador de episodios que te lleve al minuto, un buscador de código para el agente y un archivo audiovisual de los directos. Son propuestas mías para Web Reactiva, no casos medidos, pero ilustran bien dónde encaja cada parte del modelo.
1. Buscador de episodios con enlace al minuto 
La demo más clara: escribes una idea y te devuelve los momentos de los episodios donde se habló de ella. Por ejemplo, «dónde hablamos de decisiones que la IA toma sin preguntar», con enlace al minuto correspondiente.
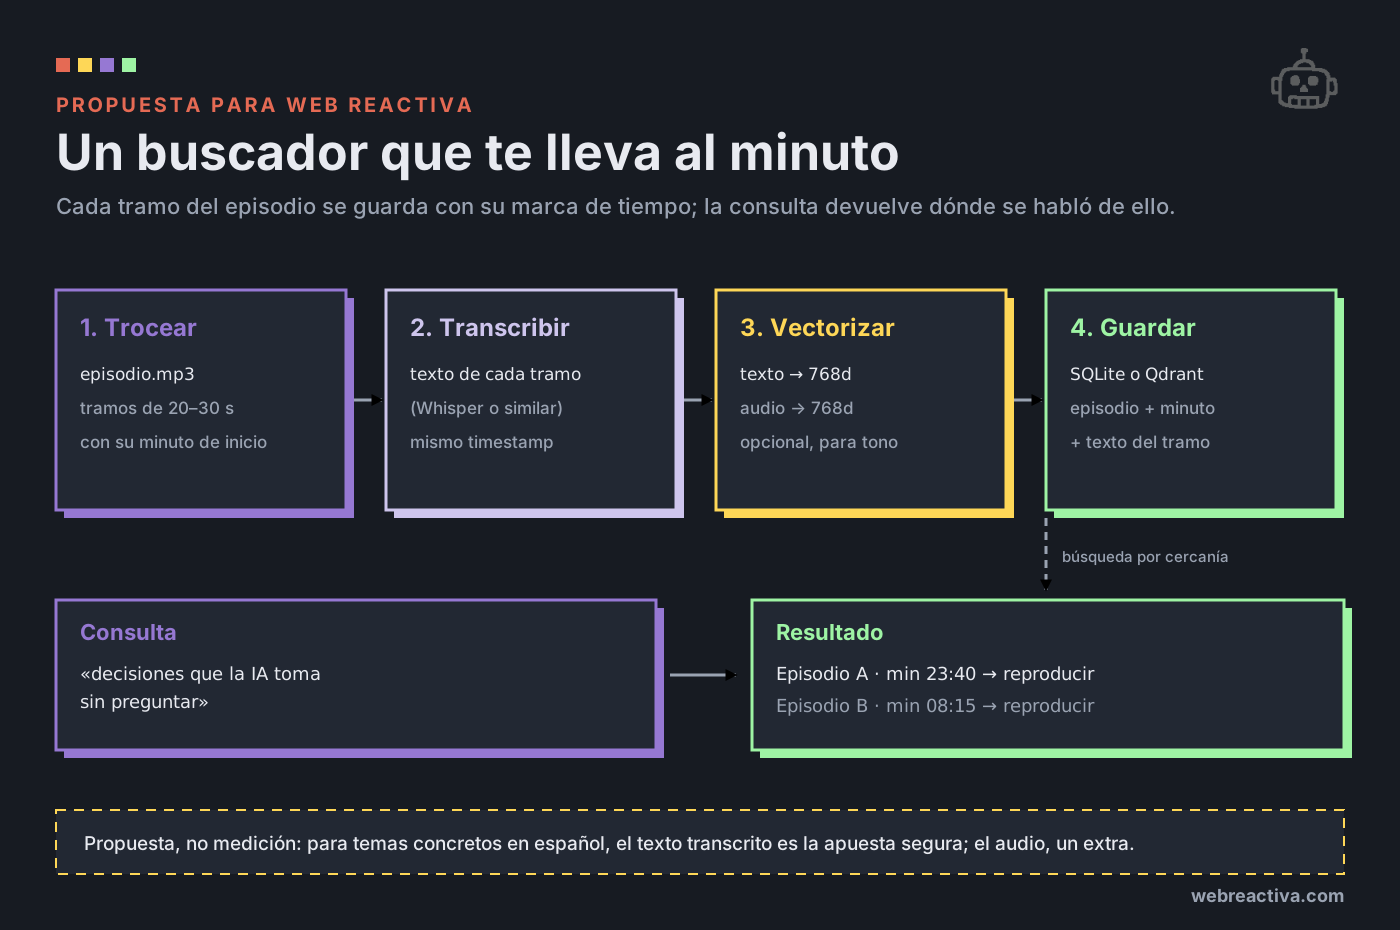
Así lo montaría:
- Trocear cada episodio en tramos de 20 a 30 segundos, guardando el minuto de inicio. El límite de audio por entrada son unos 327 segundos, así que trocear es obligatorio de todas formas.
- Transcribir cada tramo y conservar el mismo timestamp.
- Vectorizar el texto de cada tramo y, de forma opcional, también el audio.
- Guardar en SQLite o Qdrant el episodio, el minuto y el texto.
- Buscar por cercanía y devolver un enlace que abra el reproductor en ese segundo.
¿Por qué transcribir si el modelo entiende audio? Porque la evidencia que hay sobre audio es diferenciar voz de música, y ni siquiera eso salió bien del todo en la prueba de ai-muninn. Encontrar «el momento donde explico por qué un agente necesita permisos» dentro de un podcast largo en español es un problema mucho más fino, y nadie ha publicado todavía una prueba de eso.
El texto transcrito es la apuesta segura. El audio puede sumar después, como segunda señal.
Cada domingo, +7.200 developers comparten en la newsletter lo que van probando con IA en su día a día, también los experimentos en local como este. Gratis, desde 2018.
Suscríbete gratis →2. Buscador de código para un agente sobre un repo 
Recuperar funciones y archivos por lo que hacen antes de que el agente edite. Es el caso con mejor pinta en las pruebas (de 1/10 a 4/10 en primera posición, con todas las cautelas de una muestra de 10) y el que más subió en los benchmarks oficiales.
La forma más rápida de probarlo sin escribir mucho es algo como Local Knowledge Layer apuntando a tu repo, conectado por MCP a tu agente. Si ya usas un plugin de memoria como Claude-Mem, la comparación con y sin búsqueda semántica sobre el código es un buen experimento de una tarde.
3. Archivo audiovisual de los directos 
Encontrar capturas y fragmentos de vídeo para reutilizarlos en nuevos contenidos: «la pantalla con el error de autenticación», «el momento del diagrama de arquitectura». Aquí entran la búsqueda por texto sobre fotogramas (a 1 fotograma por segundo) y la búsqueda por ejemplo visual.
Ojo con las capturas de pantalla: en la prueba de ai-muninn fueron lo menos convincente, con puntuaciones muy juntas. Para capturas con mucho texto, probablemente funcione mejor extraer el texto con OCR y combinar las dos señales.
¿Cuándo no compensa actualizar desde la v1? 
Cuando tu buscador es solo de texto, ya funciona bien y no tienes forma de medir si la v2 lo mejora. Migrar implica reindexar todo, más memoria y, en algunos stacks, esperar a que tus herramientas soporten la nueva arquitectura.
| Situación | ¿Migrar a la v2? | Por qué |
|---|---|---|
| Buscas código o das contexto a un agente | Sí, merece la prueba | Es donde más sube en benchmarks y pruebas |
| Necesitas imágenes, audio o vídeo | Sí, es la novedad | La v1 era solo de texto |
| Buscador de texto en inglés que funciona | Solo si mides mejora | Empate en la prueba de SOTAAZ |
| Buscador de texto en coreano | Con cautela | La v1 ganó en primera posición |
| Buscador de texto en español | Mide antes | No hay pruebas publicadas todavía |
| Tu stack depende de llama.cpp | Espera | Aún no carga la arquitectura gemma-embedding2 |
| Memoria muy justa en el servidor | Carga solo el encoder de texto | La v2 completa usa bastante más RAM |
💡 Si solo te llevas una cosa: prepara un conjunto de 50 o 100 consultas reales con su respuesta correcta antes de tocar nada. Con eso, comparar la v1, la v2 o cualquier otro modelo es cuestión de minutos. Sin eso, estás eligiendo a ciegas.
Hay otro motivo para no perseguir cada modelo nuevo: un cambio de embeddings es un cambio de toda la base de datos. No es como cambiar de modelo de chat, donde vuelves atrás con una línea de configuración.
TL;DR 
- 🧭 EmbeddingGemma 2 convierte texto, código, imágenes, audio y vídeo en vectores de 768 dimensiones en un mismo espacio, con 740M parámetros y licencia Apache 2.0.
- 🧩 Puedes cargar solo el encoder de texto (270M) y quedarte con un modelo pequeño para buscar, clasificar o agrupar.
- 💻 Donde más mejora es en código: de 68,76 a 78,68 en MTEB Code, y de 1/10 a 4/10 en la prueba de ai-muninn.
- ⚖️ En texto puro la mejora es pequeña o nula: empate en inglés y la v1 ganó en coreano. En español, mide antes.
- 🗜️ Con cuantización binaria a 768d conservas en torno al 99 % de la calidad con 30 veces menos RAM en los vectores, según Qdrant.
Preguntas frecuentes 
¿Qué es EmbeddingGemma 2?
Es un modelo open source de embeddings de Google DeepMind, publicado el 6 de octubre de 2026. Convierte texto, código, imágenes, audio y vídeo en vectores de 768 dimensiones dentro de un mismo espacio, para buscar, clasificar o agrupar contenido por significado.
¿En qué se diferencia EmbeddingGemma 2 de la primera versión?
La v1 era solo de texto y tenía unos 308M parámetros. La v2 tiene 740M, añade encoders de visión y audio, y mejora mucho en recuperación de código (78,68 frente a 68,76 en MTEB Code). En texto multilingüe apenas cambia.
¿EmbeddingGemma 2 funciona en español?
La model card indica soporte para más de 100 idiomas, con un rendimiento que varía según el idioma. Todavía no hay pruebas independientes publicadas en español, así que conviene medir con tus propias consultas.
¿Cuánta memoria necesita EmbeddingGemma 2?
Depende de los encoders que cargues. En la prueba de ai-muninn, en un M1 Max con float32, el pico de memoria fue de 2,75 GiB frente a 1,03 GiB de la v1. Cargar solo el encoder de texto reduce el modelo a 270M parámetros.
¿Puedo usar EmbeddingGemma 2 en el navegador?
Sí. Hay una demo pública con WebGPU en Hugging Face y una demo oficial de búsqueda multimodal con LiteRT. Las dos ejecutan la búsqueda en local, sin servidor.
¿Puedo buscar dentro de un podcast con EmbeddingGemma 2?
Puedes, pero tienes que trocear el audio, porque el límite por entrada ronda los 327 segundos. Para encontrar temas concretos en episodios largos, lo más fiable hoy es transcribir y vectorizar el texto de cada tramo con su timestamp.
¿Qué es la cuantización binaria y cuánto pierde con EmbeddingGemma 2?
Es guardar cada dimensión del vector con un solo bit en lugar de 32. En la prueba de Qdrant, a 768 dimensiones conservó el 99 % de la calidad con 30 veces menos RAM en los vectores, y el 99,7 % si se reordenan los candidatos con los vectores originales.
¿Puedo reducir las dimensiones de los vectores de EmbeddingGemma 2?
Sí, gracias a Matryoshka puedes quedarte con las primeras 512, 256 o 128 dimensiones y volver a normalizar. La model card avisa de que 128 dimensiones degrada mucho la calidad en imágenes y vídeo.
¿Merece la pena migrar de EmbeddingGemma 1 a la 2?
Si buscas código o necesitas multimedia, sí merece una prueba. Si tienes un buscador de texto que funciona, mide antes: los vectores no son compatibles y migrar obliga a reindexar todo.
¿Funciona EmbeddingGemma 2 con llama.cpp u Ollama?
En la prueba de ai-muninn, llama.cpp todavía no cargaba la arquitectura de la v2. La model card documenta el uso con sentence-transformers y transformers; para otros runtimes, revisa su soporte antes de planificar nada.
Fuentes 
- Model card de EmbeddingGemma 2, Google AI for Developers
- google/embeddinggemma-2, Hugging Face
- Testing EmbeddingGemma 2 on our knowledge base, ai-muninn, 7 de octubre de 2026
- Is EmbeddingGemma 2 better than EmbeddingGemma 1 for Korean search?, SOTAAZ, 7 de octubre de 2026
- How small can Google’s new EmbeddingGemma 2 get?, Qdrant, 6 de octubre de 2026
- EmbeddingGemma 2 WebGPU, webml-community
- Local Knowledge Layer, GitHub
- ruNNtime, Software Mansion
- Google AI Edge Gallery, GitHub
- LiteRT multimodal search, Google AI Edge
🧨 Última oprtunidad para recibir la dinamita que mereces sobre programación con IA el próximo domingo: Suscríbete gratis a Web Reactiva en https://webreactiva.com/newsletter

Escrito con la ayuda de la IA generativa de Claude, fuentes fidedignas y con un human in the loop:
Dani Primo.
12 recursos para developers cada domingo en tu bandeja de entrada
Además de una skill práctica bien explicada, trucos para mejorar tu futuro profesional y una pizquita de humor útil para el resto de la semana. Gratis.