Code review en Claude Code: cómo revisa código Anthropic
Tabla de contenidos
Claude escribe alrededor del 90 % del código de Claude Code. Entre junio y septiembre de 2026, los pull requests fusionados en ese repositorio se duplicaron con creces. Y la proporción de cambios revertidos bajó más de un 40 %.
Con esos números, la pregunta obvia es quién lee todo eso.
La respuesta corta: casi nadie. Al menos, casi ninguna persona. El equipo de Claude Code lo ha contado en un artículo de su blog de ingeniería firmado por Addy Osmani, Morgan Westlee Lunt y Qing Wang, y la frase que lo resume es esta: “We didn’t remove review. But we did move most of the reading to machines, optimized for human time and attention”. No quitaron la revisión. Se la pasaron a las máquinas y guardaron la atención humana para donde hace falta.
Aquí vamos a desmontar ese artículo pieza a pieza para que veas qué puedes copiar en tu equipo aunque no tengas el presupuesto de Anthropic.
- Qué objetivo persiguen y qué métricas usan para no engañarse
- Las siete capas que atraviesa un cambio antes y después del merge
- Cómo asignan el nivel de riesgo y cuándo hace falta una o dos personas
- El problema de las revisiones que no terminan nunca y cómo lo resolvieron
- Una lista de pasos para adoptar el proceso, de menos a más
¿Qué problema intenta resolver el equipo de Claude Code? 
El problema es de volumen: hay más código del que cualquier equipo puede leer. En el monorepo de Anthropic se pasó de unos 2.500 cambios diarios en mayo a más de 30.000 en septiembre, según el propio artículo (que enlaza a cómo rediseñaron el control de versiones).
Doce veces más cambios en cuatro meses. Ningún equipo humano escala así.
Ante eso hay dos reacciones típicas. La primera es aprobar a ciegas, el famoso LGTM con el diff sin abrir. La segunda es convertir la revisión en un embudo donde los PR esperan días. Las dos acaban mal: una mete bugs en producción y la otra mata la ventaja de que el agente escriba rápido.
El equipo de Claude Code redefinió para qué sirve revisar. Según el artículo, la revisión cumple dos funciones:
- Encontrar y corregir problemas antes de que el cambio salga.
- Construir contexto compartido sobre el código, para que el equipo entienda lo que tiene entre manos.
Las máquinas pueden hacer la primera mejor y más rápido que una persona. La segunda necesita otra solución, y la veremos más abajo.
También cambiaron el momento. La revisión dejó de ser “a gate at the end of the road”, una barrera al final del camino, para pasar a ejecutarse “continuously, more like spellcheck while you write”. Como el corrector ortográfico que subraya en rojo mientras escribes, no como el profesor que te devuelve el examen corregido una semana después.
🔑 El cambio de mentalidad: la revisión no es un trámite al final. Es algo que ocurre todo el rato, y la mayor parte la hace Claude antes de que una persona vea el PR.
Si te preguntas si de verdad hace falta revisar todo lo que genera la IA, en este post con las técnicas de Simon Willison tienes la parte filosófica. Aquí vamos a la parte operativa: cómo lo hace un equipo que ya vive en ese mundo.
¿Qué métricas usan para saber si funciona? 
Miden el tiempo humano que consume la revisión y usan las reversiones e incidentes como guardarraíl. El objetivo declarado es que la mayoría de PR de los repos de Claude Code (CLI, apps de escritorio y web, apps móviles) se fusionen con “at most one human in the loop”, como mucho una persona en el bucle, sin que suban las reversiones ni los incidentes.
Lo que miden en concreto:
- Aprobaciones humanas por PR, en mediana y en el percentil 95.
- Comentarios humanos por PR.
- Tiempo que un PR pasa esperando a una persona.
- Como control: tasa de reversiones y de incidentes.
El equilibrio importa. Si solo midieras velocidad, el incentivo sería aprobar todo. Si solo midieras bugs, el incentivo sería revisar hasta el infinito. Al optimizar el tiempo humano con las reversiones como freno, cualquier atajo que meta errores se nota en la métrica de control.
Es la misma lógica que usarías con un coche: quieres llegar antes, pero miras el cuentakilómetros y también el número de multas.
La revisión empieza en las reglas que le das al agente
En la lección 3 escribimos el AGENTS.md de un proyecto real, regla a regla: el mismo sitio donde el equipo de Claude Code corrige lo que su revisor repite una y otra vez.
Entra en el curso gratis →¿Por qué capas pasa un cambio antes de llegar a producción? 
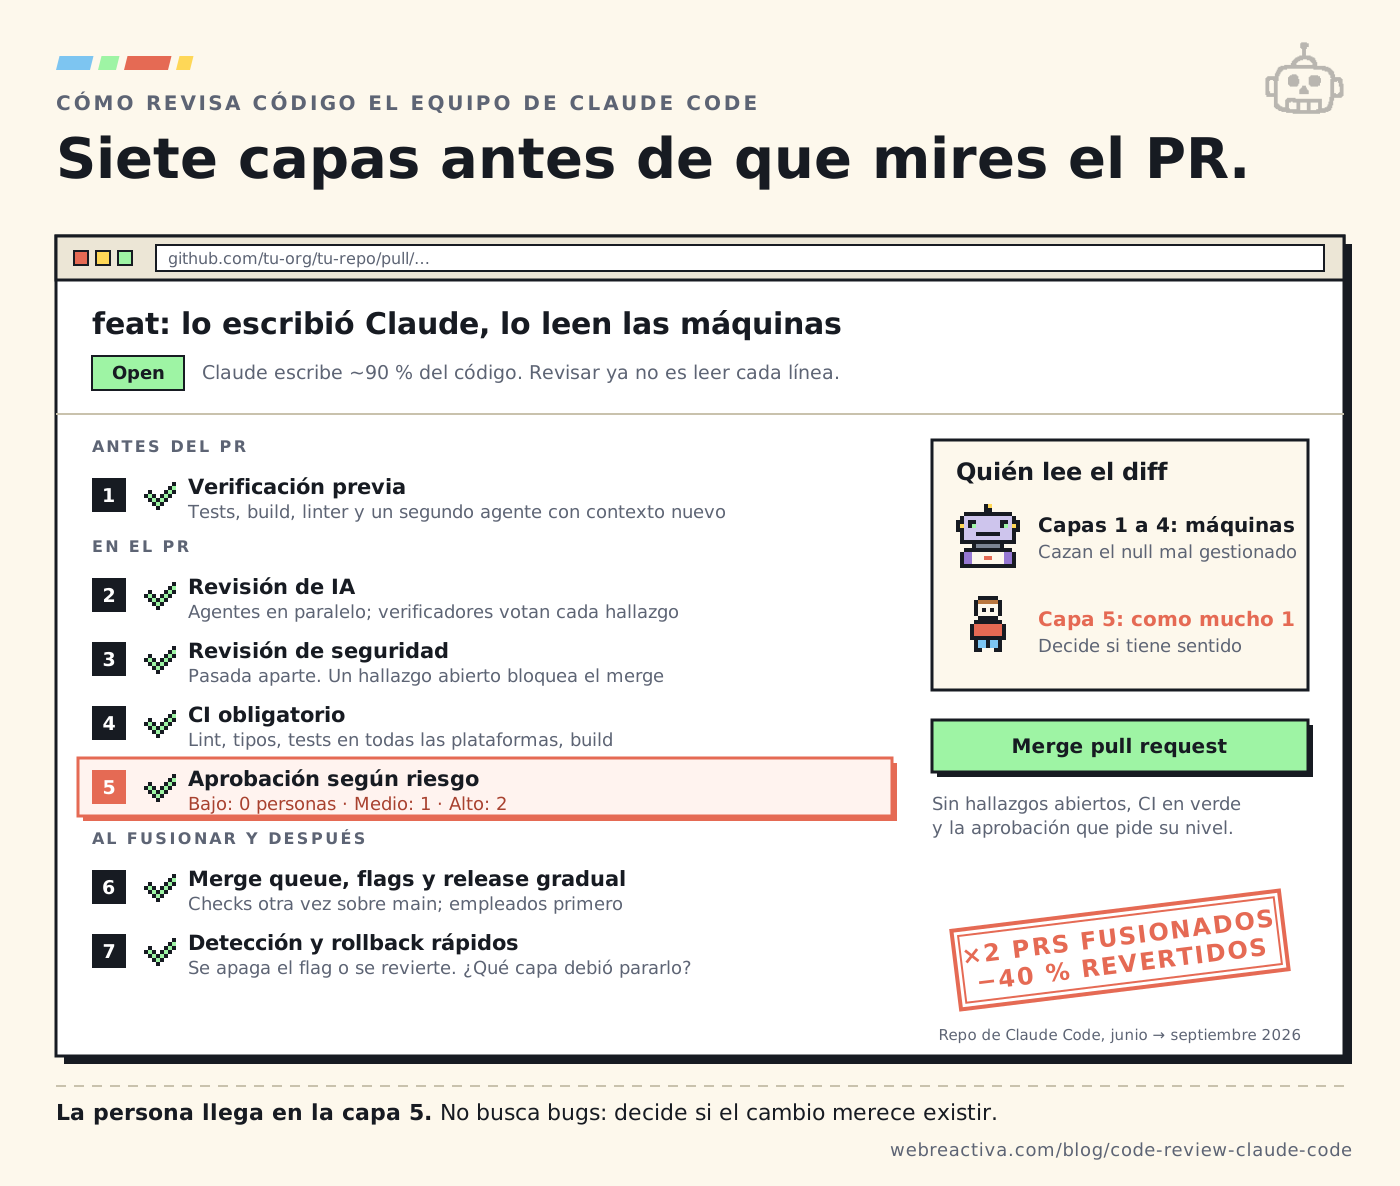
Por siete capas, y ninguna pretende ser perfecta. La idea es que lo que se escapa de una lo pare la siguiente. El artículo describe el ciclo de vida completo de un cambio, que resumo en esta tabla:
| Capa | Qué hace | ¿Bloquea el merge? |
|---|---|---|
| 1. Verificación antes del PR | Tests, build, linter y un segundo agente que revisa el diff con contexto nuevo | Lo hace el autor antes de abrir el PR |
| 2. Revisión de IA en cada PR | Agentes en paralelo buscan bugs, verificadores votan cada hallazgo | Sí, si hay hallazgos abiertos |
| 3. Revisión de seguridad | Pasada separada centrada en vulnerabilidades | Sí, si hay hallazgos abiertos |
| 4. CI obligatorio | Lint, tipos, tests en todas las plataformas, build y empaquetado | Sí |
| 5. Aprobación según riesgo | Un clasificador decide: ninguna, una o dos personas | Sí |
| 6. Merge queue, flags y release gradual | Repite checks sobre main, publica primero para empleados | Sí (la queue) |
| 7. Detección y rollback rápidos | Autor y on-call vigilan, se apagan flags o se revierte | Después del merge |
La capa humana es la quinta. Cuando una persona llega al PR, ya han pasado por él un agente revisor, un revisor de seguridad y la batería de CI. Esa persona no está buscando un null mal gestionado. Está decidiendo si el cambio tiene sentido.
Vamos capa por capa, que cada una tiene trucos aprovechables.
¿Qué verifica Claude antes de abrir un pull request? 
Verifica que su trabajo funciona, y lo enseña. La instrucción es darle a Claude algo que pueda ejecutar (tests, build, una captura de pantalla) y pedirle que “show the output instead of saying it’s done”: que enseñe la salida en lugar de decir que ya está.
¿Tanto cambia pedirle que enseñe las pruebas?
Boris Cherny, creador de Claude Code, estima que darle al modelo una forma de verificar su trabajo “makes the final result two to three times better”, de dos a tres veces mejor (lo dijo en X). Y te cuesta una línea en el prompt.
Antes del PR, el equipo usa skills internas con tres papeles distintos:
- Una busca bugs en el diff.
- Otra simplifica el cambio.
- Otra comprueba el comportamiento de extremo a extremo.
Los cambios de interfaz se revisan además contra las guías de diseño del producto. Y, como paso final, un segundo agente revisa el diff en un contexto nuevo, sin el historial de la conversación que lo generó. El motivo es el mismo por el que tú no ves las erratas de tu propio texto: el autor sabe lo que quería decir y lee eso, no lo que escribió.
Puedes replicar esto hoy con lo que ya trae Claude Code. /code-review busca bugs, /simplify limpia sin cazar errores y /security-review mira vulnerabilidades. En los 20 comandos secretos de Claude Code tienes cómo funciona cada uno y en qué orden ejecutarlos.
💡 Si solo copias una cosa de este post: añade a tu
CLAUDE.mdla regla de que el agente debe enseñar la salida de los tests antes de dar algo por terminado. Cuesta una línea.
¿Para qué sirven CLAUDE.md y REVIEW.md en la revisión? 
Sirven para que el revisor no repita los mismos comentarios. Cuando el revisor señala una y otra vez el mismo tipo de problema, el equipo no lo corrige PR a PR: lo arregla en la fuente. Eso puede ser una skill, una regla de lint o uno de estos dos ficheros.
CLAUDE.md recoge el stack, las convenciones, los objetivos y los no objetivos del proyecto. La recomendación es mantenerlo corto y enlazar a otros documentos para el detalle.
REVIEW.md lo escriben los code owners y le dice al revisor qué importa en cada parte del código. El artículo da ejemplos de lo que funciona bien dentro de ese fichero:
- Definir qué es un fallo en ese repo concreto. En documentación, un fallo es que “it lies” (miente). En configuración, que “it misroutes” (enruta mal).
- Poner un límite a los nits, los comentarios de detalle menor.
- Listar rutas que el revisor debe ignorar.
- Exigir el fichero y la línea como evidencia de cada hallazgo.
- Pedir que el resumen empiece con un recuento y diga con claridad cuándo no hay nada que corregir.
Quédate con este último punto. Un revisor que nunca dice “esto está bien” acaba generando ruido, y el ruido entrena a la gente a ignorar los comentarios.
Un REVIEW.md mínimo inspirado en esas pautas podría quedar así:
# Qué revisar en este repoQué cuenta como fallo:- docs/: un fallo es que la documentación miente sobre el comportamiento real- config/: un fallo es una ruta o variable que apunta al sitio equivocado- src/billing/: cualquier cambio en cálculo de importes es ImportantQué ignorar:- Rutas generadas: dist/, *.generated.ts- Estilo y formato: ya lo cubre el linterFormato de los hallazgos:- Como mucho 3 nits por revisión- Cada hallazgo incluye fichero y línea- El resumen empieza con el recuento ("2 Important, 1 Nit")- Si no hay nada que corregir, dilo en una fraseSi tu CLAUDE.md es un cajón desastre de 600 líneas, el problema de la revisión empieza ahí. Con el skill de security-guidance tienes otro ejemplo de cómo Claude Code revisa su propio código mientras lo escribe, que es la misma idea aplicada a la seguridad.
Si estás afinando tu CLAUDE.md o tu primer REVIEW.md, cada domingo compartimos lo que vamos aprendiendo sobre trabajar con agentes en equipos reales. Ya somos +7.200 developers.
Suscríbete gratis →¿Cómo funciona la revisión automática en cada PR? 
En cada PR, varios agentes buscan bugs en paralelo, unos verificadores votan cada hallazgo y los que sobreviven se ordenan por severidad. El revisor compara el diff con todo el repositorio y con la intención declarada del PR. En los arreglos de bugs, además, busca la causa raíz y no solo el síntoma.
La versión pública de este sistema es Code Review for Claude Code, disponible en los planes Team y Enterprise. Para usarlo en local sin el servicio gestionado tienes /code-review, una versión más ligera.
Con la vista previa del producto, los PR internos que recibían comentarios de revisión sustanciales pasaron del 16 % al 54 %. La mayoría de PR de más de 1.000 líneas reciben algún hallazgo. Los pequeños suelen salir limpios.
El servicio deja elegir por repositorio tres modos de esfuerzo:
| Modo | Cuándo tiene sentido |
|---|---|
| Quick | Repos de bajo riesgo, documentación, herramientas internas |
| Standard | El grueso del código de producto |
| Deep | Código donde un bug que se escapa sale muy caro |
Los hallazgos se etiquetan como Important, Nit o Pre-existing, y se descartan los que solo hablan de estilo, de diagnósticos o de limpieza. La etiqueta Pre-existing es importante: separa “esto lo has roto tú” de “esto ya estaba roto”, y evita que el autor de un PR pequeño cargue con deuda que no es suya.
Y hay una regla que cambia la cultura del equipo: “Every finding has to be answered”. Cada hallazgo se responde. O lo corriges, o resuelves el hilo explicando por qué no aplica. No vale dejarlo ahí esperando a que nadie lo mire.
⚠️ Esa regla solo funciona si el revisor tiene poco ruido. Si marca veinte cosas irrelevantes por PR, obligar a responderlas todas es castigar al equipo. Primero afinas el
REVIEW.md, luego endureces la regla.
¿Qué papel tiene la revisión de seguridad? 
Es una pasada separada que puede bloquear el merge. Ningún PR se fusiona con hallazgos abiertos, ni de la revisión de bugs ni de la de seguridad. Un falso positivo se cierra con un motivo breve, y si un commit posterior corrige el problema, el hallazgo se cierra solo.
Para tu equipo, las opciones que menciona el artículo son la GitHub Action de security review, que es de código abierto, o el comando /security-review en local.
¿Por qué separarla de la revisión general? Porque los bugs de seguridad no se parecen a los bugs normales. Un revisor que busca lógica rota no tiene por qué fijarse en que un parámetro llega sin sanear a una consulta. Mezclarlos diluye la atención de los dos.
¿Qué checks automáticos son obligatorios? 
Lint, comprobación de tipos, tests en todas las plataformas, build y empaquetado. Según el artículo, un PR típico de la CLI puede ejecutar decenas de checks. Si alguno falla, no hay merge.
Hay un detalle de proceso muy aprovechable: la plantilla de PR pide cómo se ha probado el cambio y cómo revertirlo. Claude puede rellenarla, pero quien pidió el cambio la firma.
Esa pregunta de “cómo lo reviertes” es una pequeña trampa útil. Si no sabes responderla, el cambio es demasiado grande o demasiado acoplado.
Tanto check tiene un coste, claro. Cuando los agentes multiplican los PR, el CI se convierte en el siguiente cuello de botella. Anthropic lo cuenta en otro artículo sobre cómo escalaron el análisis de impacto de tests, que merece lectura si tu pipeline ya tarda más que el propio agente.
¿Cuándo hace falta que una persona apruebe el cambio? 
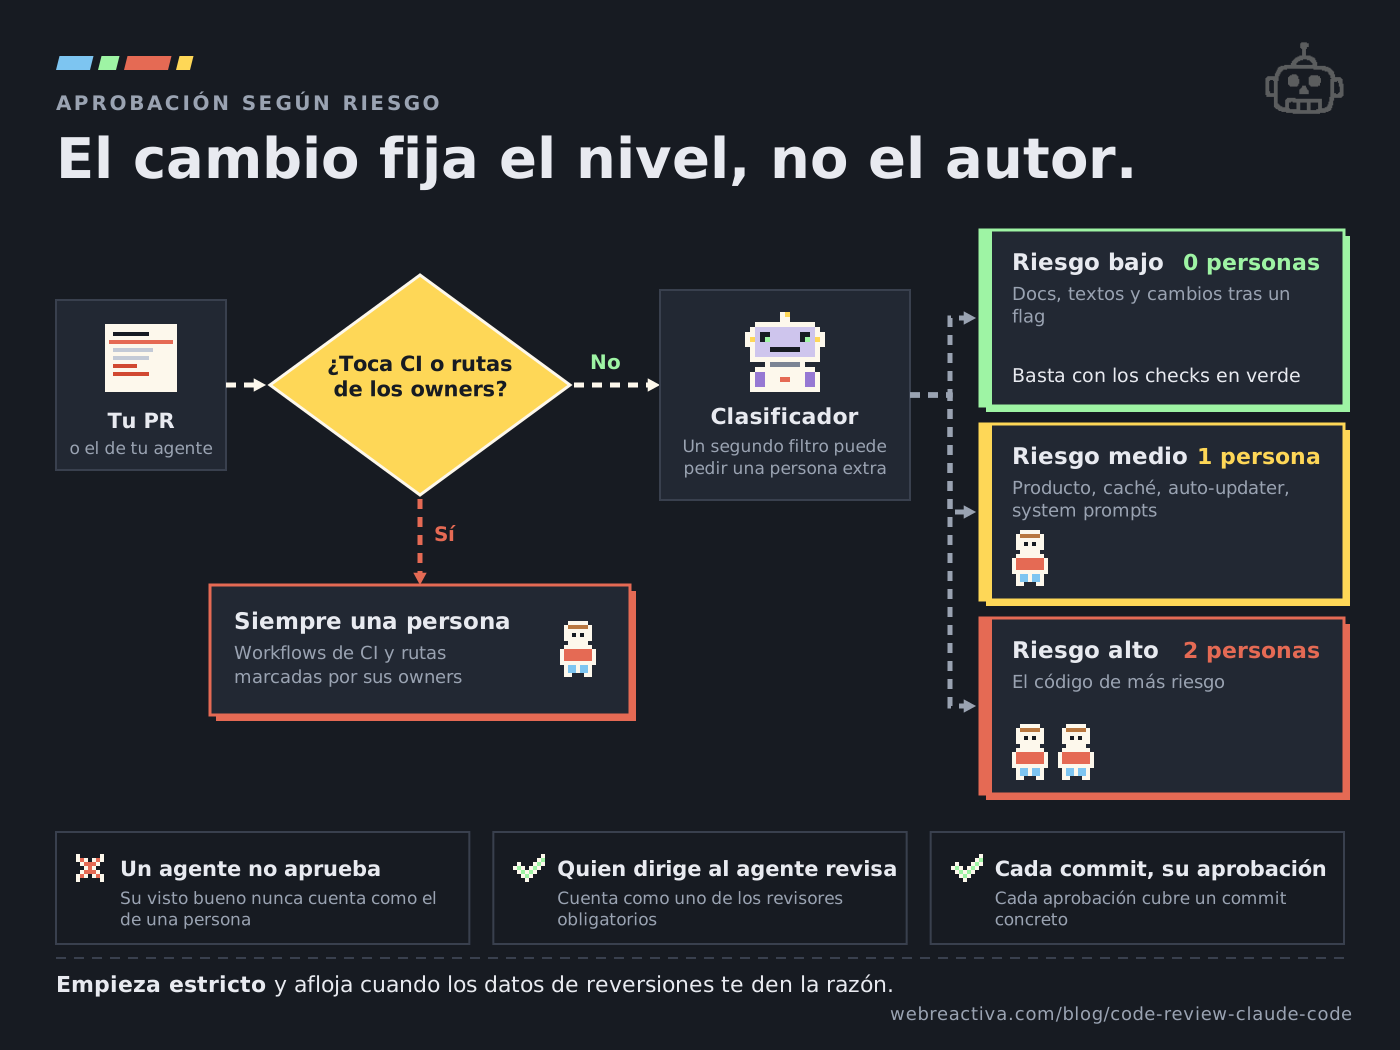
Depende del riesgo del cambio, y el riesgo lo decide un clasificador. Esta es la parte que más vas a querer copiar. El artículo lo resume en una tabla de tres niveles:
| Riesgo | Ejemplos | Aprobaciones humanas |
|---|---|---|
| Bajo | Docs, textos, features internas, cambios aditivos tras un flag | Ninguna, si la revisión automática y la de seguridad están en verde |
| Medio | Cambios normales de producto y áreas sensibles (caché, auto-updater, system prompts) | Una persona |
| Alto | El código de mayor riesgo y rutas que siempre exigen dos personas | Dos personas |
La frase clave es “The change sets the tier, not the author”. El cambio fija el nivel, no el autor. Da igual que el PR lo haya escrito la persona más veterana del equipo o un agente: si toca facturación, es alto riesgo.
Sobre esa base hay varias salvaguardas:
- Un segundo clasificador puede exigir una persona aunque el nivel no lo pida.
- Las rutas marcadas por los owners y cualquier fichero de workflow de CI siempre requieren a una persona.
- Solo los autores de una lista de confianza acceden a las rutas ligeras.
- “An agent’s approval never counts as a person’s”: la aprobación de un agente nunca cuenta como la de una persona.
- En los PR escritos por un agente, “the person directing the agent counts as one of the required reviewers”. Quien dirige al agente cuenta como uno de los revisores obligatorios.
- “An approval covers one specific commit”. Si entran commits nuevos después de aprobar, hay que volver a aprobar.
Lo de los workflows de CI siempre con persona tiene mucho sentido: es la puerta por la que un cambio puede desactivar todas las demás capas. Si un agente puede editar el pipeline que lo vigila, el pipeline no vigila nada.
Y lo de que quien dirige al agente cuenta como revisor cierra un agujero clásico. Sin esa regla, el PR que ha generado tu agente lo aprueba un compañero que no sabe qué le pediste, y tú das por hecho que él lo ha mirado. Al final, nadie lo ha mirado.
🛡️ Puedes montar la base de esto en GitHub sin herramientas nuevas:
CODEOWNERSpara las rutas sensibles, branch protection que exija su aprobación y la opción de descartar aprobaciones cuando llegan commits nuevos.
¿Qué pasa después de hacer merge? 
Entra en juego la red de seguridad final: merge queue, feature flags, release gradual y rollback rápido. La revisión no termina en el merge, porque ninguna revisión atrapa todo.
La merge queue vuelve a ejecutar los checks sobre main con el cambio aplicado. Evita el caso de dos PR que pasan por separado y rompen main juntos.
Los cambios salen primero detrás de un flag interno para empleados de Anthropic, cuyo uso intensivo detecta regresiones antes que los usuarios. Después llega la release gradual: primero el canal latest y, por detrás, stable.
Si algo falla, el autor y la persona de guardia vigilan. Los flags se apagan sin desplegar y las builds rotas se revierten. Claude Code tiene una rotación semanal de on-call, y las revisiones de incidentes se hacen una pregunta concreta: “which layer should have caught the issue”, qué capa debería haberlo parado.
Con esa pregunta, el equipo sale de cada incidente con una capa mejor y sin buscar culpables.
El artículo también es honesto con lo que les falta: no tienen circuit breakers que endurezcan la aprobación de forma automática cuando suben las métricas de errores. Es decir, si mañana se disparan las reversiones, nadie sube el nivel de riesgo por defecto sin intervención manual.
Tu IA puede mentirte
Monta tus propias capas de verificación antes de fiarte del agente
Verás en directo cómo revisar lo que programa un agente con skills, pruebas en navegador con Playwright, casos Gherkin y adversarial review entre modelos.
Entrar a la masterclass →Acceso con suscripción Web Reactiva Premium · Métodos en directo + casos Gherkin
¿Cómo mejoran al revisor con el tiempo? 
Con evaluaciones construidas a partir de incidentes reales y midiendo el ruido de cada comentario. Un revisor de IA que no se evalúa empeora en silencio cada vez que cambias el prompt o el modelo.
Los incidentes se convierten en evals. El equipo recopila los PR que causaron incidentes, junto con sus fix-forwards y reverts, y expertos confirman cada bug. El revisor se ejecuta contra ese conjunto a diario. Cualquier cambio en prompts, herramientas o modelo se puntúa contra todos los casos: si la puntuación sube, se queda; si no, se descarta.
El ruido se mide. Cada comentario se clasifica según cómo responde el autor: corregido, incorrecto, intencionado o irrelevante. Además ejecutan el revisor sobre PR que saben que están limpios, para ver cuánto inventa. La prioridad está escrita: “catching real bugs first and cutting review rounds second”. Primero cazar bugs reales, después reducir rondas.
Si te interesa la parte de evaluar modelos con otros modelos, en el post sobre modelos juez tienes la base teórica de lo que están haciendo aquí.
¿Por qué algunas revisiones no terminaban nunca? 
Porque el revisor seguía encontrando cosas, el autor (otro agente) las corregía, y el revisor encontraba más. Un PR de la CLI llegó a pasar por más de cincuenta rondas durante una noche antes de detenerse.
Cincuenta.
Al tirar de git blame descubrieron el motivo: alrededor del 59 % de lo que el revisor marcaba era código que ya estaba ahí desde su primera pasada. No eran bugs nuevos introducidos por las correcciones. Era el revisor volviendo a mirar lo mismo y sacando un hallazgo distinto cada vez.
Las medidas que tomaron:
- Tope de rondas. Tras tres, el revisor deja de revisar y le pide al autor que replantee el enfoque.
- Re-revisión solo del diff tras las primeras pasadas, no del PR entero.
- Marcar la clase de bug, para que se corrijan todas las instancias a la vez y no una por ronda.
- No repetir hallazgos ya publicados.
También lanzan revisiones nocturnas sobre código existente para detectar bugs antiguos, en lugar de que aparezcan en el PR de alguien que pasaba por allí.
Los resultados, antes y después:
| Métrica | Antes | Después |
|---|---|---|
| PR aprobados tras una ronda de revisión y corrección | 65 % | 78 % |
| PR que necesitan cinco o más rondas | 8,9 % | 1,5 % |
| Media de revisiones hasta aprobar | 2,08 | 1,32 |
Si montas un bucle de agente que escribe y agente que revisa, por ejemplo con Agent Teams, este es el primer problema con el que te vas a encontrar. Ponle un tope de rondas desde el día uno.
🔑 Un revisor de IA sin límite de rondas no converge. Siempre encuentra algo. Tres rondas y, si no basta, la conversación pasa a ser sobre el enfoque, no sobre el código.
¿En qué siguen siendo imprescindibles las personas? 
En las decisiones que no se resuelven leyendo un diff. El artículo enumera cinco:
- Decidir si construir algo: dirección, criterio y alcance. Un equipo mantuvo revisión humana para los cambios externos justo por esa pregunta: “should we even do this?”, ¿deberíamos hacer esto siquiera?
- Revisar código de riesgo: facturación, auto-updater, workflows de CI.
- Revisar arquitectura que otros van a copiar. Un mal patrón en un sitio visible se replica en veinte.
- Leer la evidencia: la salida de los tests, el comando ejecutado, la captura, los hallazgos del revisor.
- Asumir el resultado (“owning the outcome”): una persona responde de cada cambio que sale.
El cuarto punto cambia tu trabajo. Ya no lees el código línea a línea: lees la evidencia de que funciona, como haría un auditor.
Esto conecta con un riesgo del que hemos hablado antes, la deuda cognitiva: si nadie lee el código, ¿quién lo entiende?
Las personas siguen decidiendo qué se construye y respondiendo del resultado. Cada domingo, +7.200 developers comparten cómo está cambiando ese trabajo con la IA. Gratis, desde 2018.
Quiero esa dinamita 🧨¿Cómo comparte contexto el equipo si nadie lee todo el código? 
Pidiéndole a Claude que se lo explique. Según el artículo, nadie mantiene un modelo mental completo de Claude Code. Cuando alguien necesita entender una parte, le pide a Claude un explainer de esa porción concreta. El ejemplo que dan: “How does Claude Code retrieve managed settings?”.
Tarda unos minutos y refleja el código tal como está hoy, no como estaba cuando alguien escribió la documentación hace seis meses.
Algunas personas van más allá y le piden a Claude un artefacto HTML que visualice esa parte del sistema, algo que el equipo cuenta en otro post sobre la eficacia de los HTML generados con Claude Code.
Es la segunda función de la revisión, el contexto compartido, resuelta de otra forma. En lugar de que cinco personas lean un diff trivial “para estar al día”, cada una pregunta por lo que necesita cuando lo necesita.
¿Qué significa “you land it, you own it”? 
Que quien hace merge de un cambio suele ser quien arregla lo que falle. No es una norma de castigo. El artículo lo deja claro: “It isn’t blame”. Quien arregla es quien más contexto tiene, y las revisiones de incidentes analizan el sistema, no a la persona.
La regla funciona porque el resto del proceso la hace soportable:
- Cambios pequeños.
- Todo reversible: flags, reverts, releases graduales.
- El alcance del cambio define el nivel de escrutinio.
- Las regresiones se detectan por telemetría y uso interno, no por quejas de usuarios.
Sin esas condiciones, “you land it, you own it” sería una forma elegante de decir “apáñatelas”. Con ellas, es una forma de acortar el tiempo entre que algo se rompe y que alguien con contexto lo arregla.
¿Qué pasa cuando hay que cambiar de dirección? 
Que toca cerrar PR. Como escribir código es barato, a veces se escribe código que no debería existir. Lo habitual, según el artículo, es que alguien en el canal pregunte “por qué”, cite una decisión previa o proponga una vía más simple.
El consejo es plantear la alternativa pronto, en el hilo, y no como un comentario bloqueante sobre un PR ya terminado. Decirle a alguien que su trabajo no vale cuando ya está hecho duele más y cuesta más que decirlo cuando es una idea.
Esto vale igual si el trabajo lo ha hecho un agente: el PR es barato, pero la persona que lo dirigió ha invertido atención en él.
¿Cómo adopto este proceso en mi equipo? 
Por fases y empezando estricto. El artículo cierra con una lista de pasos que te reordeno de lo más barato a lo más caro, para que puedas empezar el lunes.
Antes del pull request
- Da al agente checks que pueda ejecutar y lístalos en un
CLAUDE.mdcorto. Añade hooks que lancen formatter y linter. - Ejecuta
/code-reviewy/security-reviewen local, o una revisión con subagente en contexto nuevo. - Crea un
REVIEW.mdy ve moviendo a él los comentarios de revisión que se repiten.
En cada pull request
- Exige CI y añade a la plantilla de PR las secciones “Testing”, “Risk” y “How to revert”.
- Añade un revisor de IA (Code Review for Claude Code o la GitHub Action de Claude Code) en un solo repo. Afina el
REVIEW.mdunas semanas y después amplía. - Añade revisión de seguridad automática y exige que todos los hilos estén resueltos antes del merge.
- Ajusta el esfuerzo al riesgo: Quick, Standard o Deep.
- Limita las rondas y, tras las primeras, revisa solo el diff nuevo.
Aprobación
- Define niveles de riesgo asignados por el cambio, no por el autor. Empieza estricto y afloja con evidencia.
- Reserva las rutas ligeras para autores de confianza.
- Usa
CODEOWNERSy branch protection para que autenticación, facturación, CI, workflows de release e instaladores siempre requieran una persona. - Nunca dejes que la aprobación de un bot sustituya a la de una persona obligatoria, y descarta aprobaciones cuando entren commits nuevos.
Merge y después
- Merge queue, feature flags, uso interno primero, releases graduales y rollback en un paso.
- Convierte incidentes y reverts en un conjunto de evals y reevalúa el revisor cada vez que cambies su prompt, sus herramientas o el modelo.
- Mide el tiempo humano, con reversiones e incidentes como guardarraíl.
Si quieres automatizar alguno de estos pasos fuera del PR, como las revisiones nocturnas sobre código existente, las Claude Code Routines te dejan programarlas en la nube de Anthropic.
¿Y si no usas Claude Code? La mayoría de la lista no depende de la herramienta. Los niveles de riesgo, el tope de rondas, la plantilla con “cómo revertir” o el CODEOWNERS funcionan igual con PR-Agent, con Open Code Review o con cualquier otro revisor.
💡 Empieza estricto. Es más fácil quitar una aprobación obligatoria cuando tienes datos de que sobra que ponerla después de un incidente.
¿Qué limitaciones tiene este modelo? 
Las tiene, y algunas las reconoce el propio artículo:
- Faltan circuit breakers. No hay nada que endurezca la aprobación de forma automática si suben los errores.
- El revisor publica hallazgos, no aprobaciones. El anuncio de Code Review dice que aprobar un PR sigue siendo una decisión humana. En sus repos internos, los owners pueden decidir qué cambios de bajo riesgo se fusionan solo con checks automáticos, pero eso es una decisión de cada equipo.
- Exige infraestructura. Merge queue, flags, releases por canales y on-call semanal no son gratis. Un equipo de tres personas no va a montarlo todo, y no debería intentarlo a la vez.
- Depende de que el revisor tenga poco ruido. Toda la parte de “cada hallazgo se responde” se viene abajo con un revisor que marca tonterías.
Y una que no dicen pero conviene tener presente: sus cifras son de un equipo que construye la propia herramienta de IA, con acceso al modelo, a sus creadores y a un volumen de uso interno que pocas empresas tienen. Los porcentajes de mejora te sirven como dirección, no como promesa.
Cuando el revisor falla, el equipo no se pregunta por qué el modelo es malo. Se pregunta qué no tenía el modelo a la vista, y la corrección va a un CLAUDE.md, a una skill o a un check nuevo. Es la costumbre que más fácil te va a resultar llevarte a tu equipo, uses la herramienta que uses.
TL;DR 
- 🚀 El equipo de Claude Code duplicó los PR fusionados entre junio y septiembre de 2026 y bajó más de un 40 % los revertidos, con Claude escribiendo el 90 % del código.
- 🔧 Siete capas: verificación previa, revisión de IA con verificadores que votan, seguridad que bloquea, CI, aprobación según riesgo, merge queue con flags y rollback rápido.
- ⚖️ El riesgo lo fija el cambio, no el autor. Bajo: ninguna persona. Medio: una. Alto: dos. Y la aprobación de un agente nunca cuenta como humana.
- 🔁 Tope de tres rondas de revisión y re-revisión solo del diff: los PR con cinco o más rondas bajaron del 8,9 % al 1,5 %.
- 🎯 Las personas deciden si construir algo, revisan lo arriesgado, leen la evidencia y responden del resultado.
Preguntas frecuentes 
¿Cuánto código de Claude Code escribe Claude?
Alrededor del 90 %, según el artículo del equipo publicado en octubre de 2026. Con ese volumen, la revisión humana línea a línea dejó de ser viable y pasaron a un modelo por capas donde las máquinas hacen la mayor parte de la lectura.
¿Qué es Code Review for Claude Code?
Es el servicio gestionado de Anthropic que revisa cada pull request con varios agentes en paralelo y verificadores que filtran falsos positivos. Está disponible en los planes Team y Enterprise y permite elegir por repositorio los modos Quick, Standard o Deep.
¿Qué diferencia hay entre Code Review y el comando /code-review?
El servicio gestionado revisa cada PR en GitHub de forma automática. El comando /code-review ejecuta una versión más ligera en local, dentro de tu sesión de Claude Code, y lo puedes usar antes de abrir el PR sin plan de equipo.
¿Qué es REVIEW.md?
Es un fichero que escriben los responsables del código para decirle al revisor de IA qué importa en cada parte del repositorio: qué cuenta como fallo, qué rutas ignorar, cuántos nits permitir y qué evidencia exigir en cada hallazgo. Complementa a CLAUDE.md, que recoge las convenciones generales.
¿Qué significan las etiquetas Important, Nit y Pre-existing?
Important marca un problema que hay que corregir, Nit un detalle menor y Pre-existing un problema que ya estaba en el código antes del PR. Separar lo preexistente evita que el autor de un cambio pequeño cargue con deuda que no ha generado.
¿Cuándo hace falta aprobación humana en el modelo de Anthropic?
Depende del nivel de riesgo que asigna un clasificador al cambio. Los cambios de bajo riesgo, como documentación o features tras un flag, no la necesitan si las revisiones automáticas están en verde. Los de riesgo medio requieren una persona y los de alto riesgo, dos. Los workflows de CI y las rutas marcadas por los owners siempre requieren una persona.
¿Cuenta la aprobación de un agente como revisión?
No. El artículo es explícito: la aprobación de un agente nunca cuenta como la de una persona. En los PR que escribe un agente, la persona que lo dirige cuenta como uno de los revisores obligatorios, y cualquier commit nuevo invalida las aprobaciones anteriores.
¿Cómo evitar que un revisor de IA entre en un bucle infinito de rondas?
Limitando las rondas (tres en el caso de Anthropic), revisando solo el diff nuevo tras las primeras pasadas, marcando la clase de bug para corregir todas las instancias a la vez y no repitiendo hallazgos ya publicados. Con esas medidas, los PR que necesitaban cinco o más rondas bajaron del 8,9 % al 1,5 %.
¿Cómo se mide si un revisor de IA funciona bien?
Anthropic usa dos vías. Convierte los PR que causaron incidentes en un conjunto de evaluación que ejecuta a diario, y clasifica cada comentario según la respuesta del autor (corregido, incorrecto, intencionado o irrelevante). También ejecuta el revisor sobre PR limpios para medir cuánto inventa.
¿Puedo aplicar este proceso sin Claude Code?
Sí, buena parte. Los niveles de riesgo por cambio, CODEOWNERS, branch protection, el tope de rondas, la plantilla con “cómo revertir”, la merge queue y los feature flags son independientes de la herramienta. Lo específico de Claude Code es el revisor gestionado y los comandos /code-review y /security-review.
Fuentes 
- How the Claude Code team does code review, blog de Claude, octubre de 2026: el artículo original con el proceso y todas las cifras
- Documentación de Code Review for Claude Code: modos, etiquetas y configuración con
REVIEW.md - Anuncio de Code Review: presentación del servicio para Team y Enterprise
- Automated security reviews in Claude Code:
/security-reviewy la GitHub Action - Redesigning source control: el contexto del salto de 2.500 a más de 30.000 cambios diarios
- Cómo escalaron el análisis de impacto de tests: el CI como siguiente cuello de botella
- Buenas prácticas de Claude Code: documentación oficial sobre
CLAUDE.mdy verificación
🧨 Última oprtunidad para recibir la dinamita que mereces sobre programación con IA el próximo domingo: Suscríbete gratis a Web Reactiva en https://webreactiva.com/newsletter

Escrito con la ayuda de la IA generativa de Claude, fuentes fidedignas y con un human in the loop:
Dani Primo.
12 recursos para developers cada domingo en tu bandeja de entrada
Además de una skill práctica bien explicada, trucos para mejorar tu futuro profesional y una pizquita de humor útil para el resto de la semana. Gratis.