Comparativa de modelos juez: Jev vs Clef vs OpenAI Decisions
Tabla de contenidos
Seis semanas. Es lo que ha tardado Jev en dejar de estar solo.
Cuando TypeSafe sacó su modelo que no escribe texto y solo devuelve decisiones con probabilidades, parecía una rareza. Hoy el catálogo de models.dev tiene una treintena de modelos de decisión de casi veinte fabricantes, desde Cloudflare y OpenAI hasta Perplexity, Liquid AI o Microsoft. Algunos son más baratos que Jev. Otros le ganan en pruebas concretas. Y uno trae pesos abiertos con licencia Apache 2.0.
Así que la pregunta ya no es «¿qué es esto?» (eso lo contamos en System One y Jev: la IA que decide sin escribir). La pregunta es otra: si quiero meter un juez en mi aplicación o en mi agente, ¿cuál elijo?
En este artículo vas a encontrar:
- Qué modelos compiten hoy con Jev y qué los separa de un LLM al que le pides que juzgue
- Los precios verificados en el catálogo de models.dev, con los que hay que pedir prueba antes de creer
- Los benchmarks publicados, quién los ha medido y por qué no hay un ganador absoluto
- Lo que han encontrado los developers en sus pruebas: calibración, tokens fantasma y el peligro del orden de las opciones
- Qué modelo probaría para cada escenario y cómo montar tu propia comparativa con un caso de desarrollo real
Y una advertencia desde ya: webreactiva.com usa dos de estos modelos en producción. Lo que te cuento al final sobre cambiar de juez no viene de un benchmark. Viene de nuestro propio código.
¿Qué es un modelo juez y en qué se diferencia de un LLM que juzga? 
Un modelo juez, o modelo de decisión, recibe un contexto y unas preguntas tipadas y devuelve probabilidades sobre las respuestas posibles, sin generar texto. No escribe un párrafo explicando por qué el pull request es peligroso. Te dice que hay un 0,87 de probabilidad de que lo sea.
Un LLM convencional también puede hacer de juez. Le pides una salida estructurada, un JSON con una etiqueta, y lo hace. La diferencia está en todo lo demás: genera tokens uno a uno, cobra por esos tokens de salida, tarda segundos en lugar de milisegundos y la «confianza» que te devuelve es otra cosa que escribe, no una probabilidad medida.
Por eso conviene separar tres grupos:
| Grupo | Ejemplos | Cómo decide | Para qué sirve en la comparativa |
|---|---|---|---|
| Modelos de decisión especializados | Jev, Clef, d1, Decider, GPT-6 Luna Decisions | Devuelven distribuciones de probabilidad, sin texto | Son los protagonistas |
| Modelos abiertos o autoalojados | Clef (pesos), Kev, Laya, CLM | Igual, pero en tu máquina | Privacidad y ajuste fino |
| LLM usados como jueces | Cualquier modelo general con salida estructurada | Generan tokens con una etiqueta | Referencia de calidad, no equivalente técnico |
Este artículo va del primer grupo, con el segundo como invitado. Si lo que buscas es el patrón clásico de LLM como juez dentro de un sistema de evaluación, lo tienes en cómo construir, evaluar y mejorar con la API de Claude.
🔑 Que un modelo pueda juzgar no lo convierte en un modelo de decisión. La diferencia es de latencia, de coste y, sobre todo, de calibración: un modelo de decisión está entrenado para que su 0,9 signifique algo.
¿Qué preguntas le puedes hacer a un modelo de decisión? 
Casi todos hablan el mismo idioma: el contrato System One que publicó TypeSafe con Jev. Le pasas un state (el contexto) y una lista de preguntas, cada una de un tipo:
| Tipo | Qué hace | Ejemplo en un proyecto real |
|---|---|---|
noul |
Decisión binaria con probabilidad | ¿Este PR introduce un problema de seguridad? |
choice |
Elige entre varias opciones | ¿Qué herramienta debería ejecutar el agente ahora? |
score |
Valora en una escala ordenada | ¿Qué calidad tiene esta respuesta, del 1 al 5? |
box |
Devuelve las coordenadas de un objeto en una imagen | ¿Dónde está el botón de pago en esta captura? |
Ese cuarto tipo es nuevo. Llegó con Jev 1.14 el 14 de octubre de 2026 y solo funciona con jev-1.14.0. En la misma versión, Jev pasó a aceptar imágenes, pero como función experimental: hay que activarla con una cabecera que ya avisa de lo que es.
TypeSafe-Danger-Zone-Images: true
TypeSafe dice en el anuncio de Jev 1.14 que la visión tiene «demasiada irregularidad» para producción. Las imágenes se colocan dentro del state, las instrucciones o los criterios, y se facturan como tokens de entrada.
Que todos hablen System One no significa que sean intercambiables sin más. OpenAI, por ejemplo, llama predicate a lo que Jev llama noul en su Decisions API. Cloudflare acepta hasta 64 preguntas por llamada en Clef; OpenAI hasta 400. Y la ventana de contexto va de los 8.192 tokens de Laya al millón largo de GPT-6 Luna Decisions.
⚠️ La compatibilidad de interfaz no implica la misma precisión, la misma calibración ni los mismos límites por petición. Tampoco garantiza que la versión que descargas para ejecutar en local sea la misma que sirve la API.
Herramienta gratis · Contador
¿Cuántos tokens ocupa tu state?
Todo lo que viene ahora, del contexto máximo al precio por decisión, depende de un número que solo tienes tú: lo que pesa el estado que le vas a pasar al juez. Pega un diff, un ticket o un log real y sal de dudas.
Le das
Un texto pegado en la caja
Te devuelve
Sus tokens y su precio en más de 100 modelos
¿Qué modelos compiten hoy con Jev? 
El ecosistema ha crecido tan rápido que ya hay directorios dedicados, como Awesome System One. Esta es la selección de los que tiene sentido probar en un proyecto, con lo que he podido verificar en fuentes oficiales y en el catálogo de models.dev:
| Modelo | Fabricante | Entradas | Despliegue | Lo que lo distingue |
|---|---|---|---|---|
| Jev 1.14 | TypeSafe AI | Texto; imágenes en experimental | API (y pasarelas) | El original, buena calibración, tipo box |
| Clef (27B) | Cloudflare | Texto, imágenes | API y pesos Apache 2.0 | Precisión y control, 64k de contexto |
| Clef-flash (9B) | Cloudflare | Texto, imágenes | API y pesos Apache 2.0 | Velocidad y precio |
| Clef-omni | Cloudflare | Texto, imagen, audio, vídeo | API y pesos Apache 2.0 | El más multimodal |
| GPT-6 Luna Decisions | OpenAI | Texto, imágenes | API | 400 preguntas por llamada, retención cero |
| d1 / d1-ultra | Liquid AI | Texto, imágenes | API y versiones locales | Modelos compactos y eficientes |
| Decider 1.2 (27B y Flash 4B) | Perplexity | Texto, imágenes | API | De los más baratos del catálogo, 262k de contexto |
| Decision-1 | Microsoft | Texto | API | Mismo precio que Jev |
| Drex (1.5, 2.0, Max) | Nace AI | Texto; Max con imágenes | API | Bien situado en JevBench |
| Kev 4B | Comunidad | Texto | API y local | Alternativa abierta que se compara con Jev |
| Laya | Convai Innovations | Texto | Local y API gratuita | Muy pocos parámetros |
| CLM | Contrastive-LM | Texto | Local | Evaluación contrastiva |
Hay más nombres circulando, como Nimble-v4-max (Bespoke Labs), kettei (Sqwish Labs) o SubQ Snap (Subquadratic), que aparecen en directorios y rankings pero no en models.dev. Los incluyo en la conversación, con la advertencia de que sus fichas no las he podido contrastar con una fuente primaria.
¿Y de dónde sale Clef? Según el anuncio de Cloudflare del 1 de octubre, Clef usa como base un Qwen3.8-27B congelado y Clef-flash un Qwen3.5-9B, con adaptadores LoRA de rango 256 y una cabeza de enrutado entrenados encima. La calibración la empujan con una pérdida de Brier en el entrenamiento. Es decir, han convertido un LLM abierto en un juez en lugar de entrenar uno desde cero.
Antes del juez, un flujo con tu agente que puedas repetir
Un juez solo sirve si sabe qué está juzgando. En la primera lección ves el flujo completo con un agente y tus prompts, sobre un proyecto real, para saber en qué punto meter cada decisión.
Entra en el curso gratis →¿Cuánto cuesta cada modelo juez? 
Casi todos cobran solo los tokens de entrada. La salida es gratis porque no hay texto generado que cobrar: devuelven unas pocas probabilidades. Así que la cifra que importa es el precio por millón de tokens que les mandas.
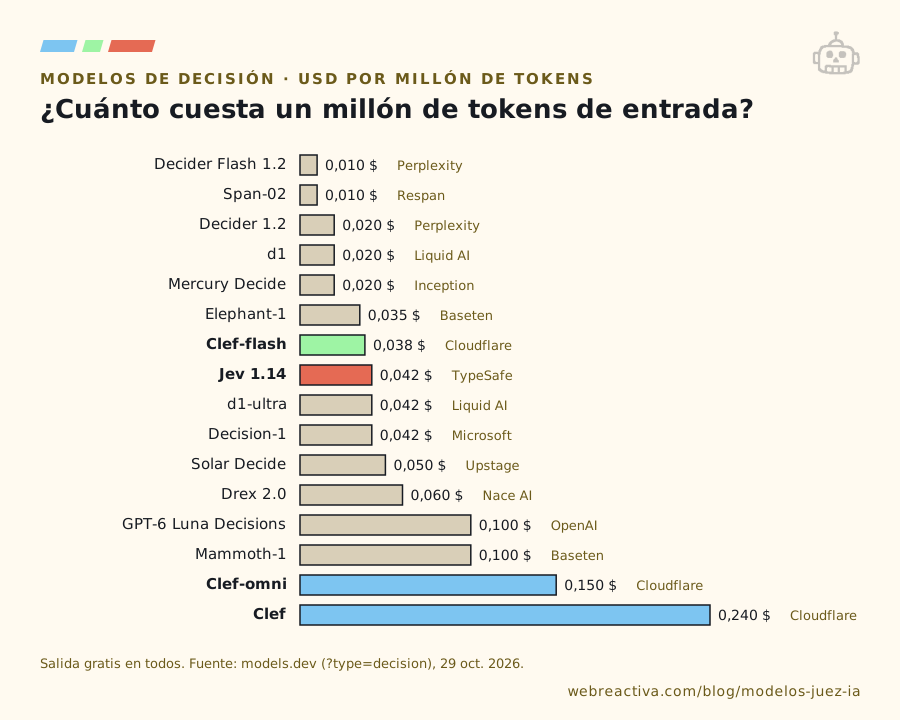
Estos son los precios de las APIs oficiales o de OpenRouter, sacados del catálogo de models.dev el 29 de octubre de 2026:
| Modelo | Entrada / 1M tokens | Contexto | Comprobación |
|---|---|---|---|
| Decider Flash 1.2 (4B) | 0,010 $ | 262.144 | models.dev |
| Decider 1.2 (27B) | 0,020 $ | 262.144 | models.dev |
| d1 | 0,020 $ | 65.536 | models.dev |
| Clef-flash | 0,038 $ | 24.576 | Ficha oficial de Cloudflare |
| Jev 1.14 | 0,042 $ | 32.000 | models.dev y TypeSafe |
| d1-ultra | 0,042 $ | 32.768 | models.dev |
| Decision-1 | 0,042 $ | 32.768 | models.dev |
| Drex 2.0 | 0,060 $ | 131.072 | models.dev |
| GPT-6 Luna Decisions | 0,100 $ (sin caché) | 1.050.000 | Docs de OpenAI |
| Clef-omni | 0,150 $ | 65.536 | models.dev |
| Clef | 0,240 $ | 65.536 | Ficha oficial de Cloudflare |
| Laya | Gratis | 8.192 | models.dev |
Y los que solo aparecen en directorios secundarios, para que los tengas en el radar: kettei-core a 0,020 $, Nimble-v4-max a 0,040 $, SubQ Snap a 0,050 $ y kettei-fat a 0,060 $. Antes de contratar, pide la tarifa al proveedor.
Un detalle de Clef-flash que no sale en los titulares: cuando Cloudflare bajó su precio a 0,038 $ el 9 de octubre, recortó su contexto alojado de 64k a 24.576 tokens. Si tu state es largo, se trunca. Más barato, sí, pero con letra pequeña.
¿Por qué no aparecen en models.dev si buscas en el sitio de siempre? 
El catálogo de precios que usamos en las herramientas gratuitas de Web Reactiva se genera desde https://models.dev/api.json. Cuando fui a buscar Jev y Clef en nuestro propio fichero generado, había cero resultados.
¿El motivo? models.dev excluye los modelos de tipo decision de la respuesta por defecto. Si quieres verlos, tienes que pedirlos:
# Todos los modelos, jueces incluidos
curl -s "https://models.dev/api.json?type=all" -o models-all.json

# Solo los modelos de decisión
curl -s "https://models.dev/api.json?type=decision" -o models-decision.json
Si mantienes una calculadora de costes o un selector de modelos que tire de esa API, revisa la URL. Te estás dejando fuera una categoría entera.
¿Qué costaría un millón de decisiones al mes? 
Con 1.000 tokens por decisión, un millón de decisiones son mil millones de tokens de entrada. Multiplica:
| Modelo | Coste mensual estimado |
|---|---|
| Decider Flash 1.2 | 10 $ |
| d1 | 20 $ |
| Clef-flash | 38 $ |
| Jev | 42 $ |
| GPT-6 Luna Decisions | 100 $ |
| Clef-omni | 150 $ |
| Clef | 240 $ |
Solo tokens de entrada, sin impuestos, sin descuentos de caché y sin mínimos comerciales. Entre Jev y Clef-flash la diferencia es de 4 dólares al mes. Entre Jev y Clef, casi seis veces.
Pero ojo con las peticiones pequeñas. En una comparativa comunitaria entre Jev y Kev publicada en r/LocalLLaMA el 25 de septiembre, sus autores observaron que Jev contaba unos 257 tokens fijos de más en cada petición. Si tus decisiones son de 100 tokens, eso multiplica el coste real por más de tres. No es una tarifa oficial, es una observación: compruébala en tus propios registros de uso antes de hacer cuentas.
💡 Calcula el coste con la facturación real de una semana de pruebas, no con la tabla de precios. Los tokens de sistema, los recuentos fijos y el truncado cambian las cuentas en peticiones cortas.
Cada semana aparece un modelo de decisión nuevo con su precio y su benchmark. En la newsletter de los domingos te traemos lo que merece la pena probar y lo que comparten los +7.200 developers de la comunidad.
Apúntate gratis →¿Quién juzga mejor según los benchmarks? 
No hay un ganador. Y quien te diga lo contrario te está enseñando el benchmark que le conviene.
La comparativa más completa entre Jev y sus rivales la publicó Cloudflare, que es parte interesada. Midió Clef, Clef-flash, Jev, Kev, Laya y una variante de Jev sobre DiffusionGemma en diez pruebas del Jev Decision Index. Me quedo con siete:
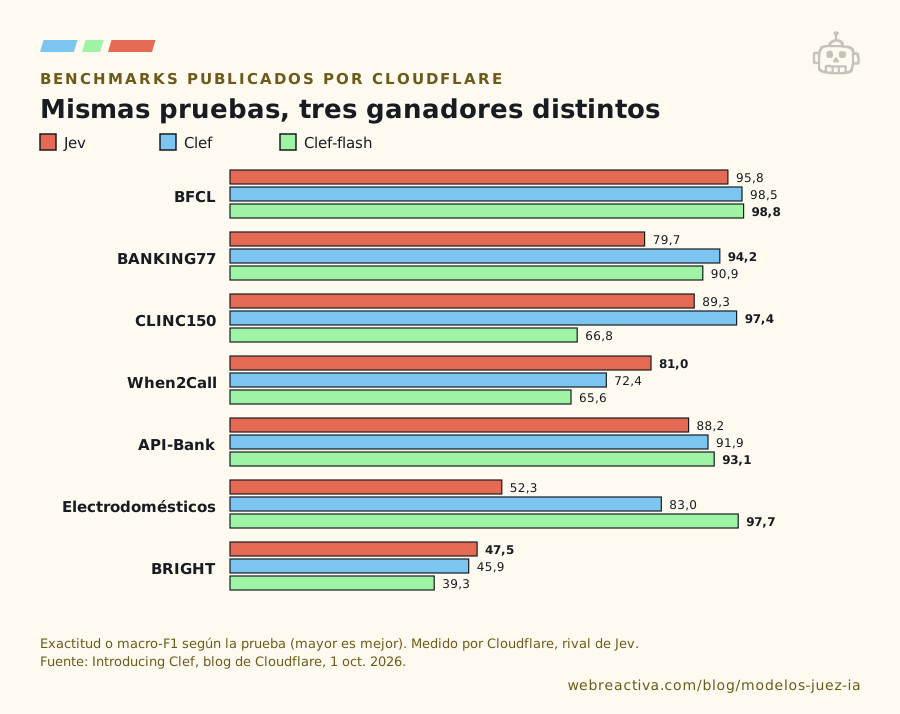
Prueba a prueba:
- Clef gana en clasificación de intenciones (BANKING77 y CLINC150). En CLINC150 saca 97,4 frente al 89,3 de Jev.
- Clef-flash gana en llamadas a funciones (BFCL, API-Bank) y arrasa en la prueba de electrodomésticos con un 97,7, donde Jev se queda en 52,3.
- Clef-flash se hunde en CLINC150: 66,8. El modelo pequeño no aguanta bien cuando hay 150 intenciones y casos fuera de dominio.
- Jev gana en When2Call (81,0 frente a 72,4 de Clef), la prueba que mide si un agente sabe cuándo usar una herramienta y cuándo no.
Ese último dato es el que yo miraría si estás montando un agente. Clasificar tickets y supervisar acciones son tareas distintas, y un modelo puede ser excelente en una y mediocre en la otra.
🔑 Un modelo puede ser muy bueno clasificando y malo decidiendo cuándo actuar. No elijas juez por una puntuación global: elige por la prueba que más se parece a tu caso.
¿Y los rankings independientes como JevBench? 
JevBench, de Benchmark Heaven, combina calidad, calibración, velocidad y coste en una puntuación compuesta. En su versión 1.7.3 de octubre, por encima de Jev 1.13 aparecen, en este orden, Super Decider, kettei-fat, Fastino GLiDE, Torchcast 4B, d1-ultra, SubQ Snap 1.1, Drex Max y Nimble-v4-max.
Varios de esos modelos son más baratos que Jev. Y lo superan.
Pero ese compuesto no mide solo acierto. Un modelo puede subir puestos por ser rápido y barato aunque falle más en los casos difíciles. Además, no mezcles versiones: Jev 1.13 y 1.14 no son el mismo modelo, y una puntuación de JevBench 1.4 no se compara con una de la 1.7.
¿Qué modelo juez es más rápido? 
Un juez está para meterse en el camino crítico de tu aplicación, así que la latencia pesa tanto como el acierto. Estas son las medidas que Cloudflare publicó sobre sus 43 pruebas:
| Modelo | Mediana | p95 |
|---|---|---|
| Laya | 5,8 ms | 222,5 ms |
| Clef-flash | 38,8 ms | 122,4 ms |
| Kev 9B | 51,4 ms | 187,9 ms |
| Clef | 209,3 ms | 238,6 ms |
| Jev | 524,1 ms | 536,0 ms |
Medio segundo para Jev frente a 39 milisegundos para Clef-flash. Más de trece veces más.
Ahora el matiz. Son medidas de Cloudflare sobre su propia infraestructura, con Clef sirviéndose en una H200, y Jev medido desde fuera. Según el changelog de Workers AI (este dato no he podido contrastarlo en la ficha oficial), Cloudflare mejoró después el servicio de Clef hasta una mediana de 152 ms y un p95 de 351 ms con unos 800 tokens de entrada. Desde España, la latencia que notes dependerá también de la red y de dónde se ejecute la inferencia.
OpenAI, por su parte, solo dice que su Decisions API devuelve respuestas tipadas «unas 10 veces más rápido» que su Responses API. Sin cifras absolutas.
Incluso el más lento de la tabla contesta en medio segundo, y lo hace con todas las preguntas de la petición a la vez. Puedes meter varias decisiones por segundo dentro de un flujo. Eso abre usos que con un LLM generativo eran impensables, como los que repasamos en 12 ideas que puedes construir con Jev.
Construye agentes con criterio
Dónde va el juez cuando tu agente deja de ser un LLM con tools
Verás los seis niveles de arquitectura de un agente, de los guardarraíles a la orquestación, y cómo encajar un modelo que revisa lo que hace otro, con evals de LLM as Judge y código real.
Ver la arquitectura entera →6 niveles de arquitectura, en directo
¿Qué han encontrado los developers en sus pruebas? 
En los foros aparecen cosas que las fichas comerciales se callan. Estas son cuatro pruebas comunitarias que conviene conocer antes de elegir.
Jev contra Kev: la calibración es la diferencia 
El 25 de septiembre, un hilo de r/LocalLLaMA comparó Jev y Kev 4B con 362 casos nuevos, que no podían estar en el entrenamiento de ninguno. En exactitud la diferencia fue pequeña en varias tareas. Donde Jev se separó fue en calibración y en detección de paráfrasis.
Es decir: los dos acertaban parecido, pero cuando Jev decía «estoy seguro al 90 %», se podía uno fiar más. Ese mismo hilo es el que detectó los 257 tokens extra por petición.
Logs de servidor: los pesos abiertos no vienen enseñados 
En r/LocalLLM, el 14 de octubre, un developer probó a clasificar la categoría de un incidente a partir de unas 1.500 líneas de logs de servidor. Sin ajuste fino, estos fueron los aciertos:
| Modelo | Acierto sin ajuste |
|---|---|
| Jev | 75 % |
| Clef | 70 % |
| Clef-flash | 56 % |
| Kev | 51 % |
| Laya | 29 % |
Tener los pesos abiertos te permite especializar un modelo. No te da un buen modelo gratis. Sin adaptación, el abierto más pequeño se queda en menos de un tercio de acierto.
Pac-Man: decisiones repetidas en tiempo real 
El 8 de octubre, también en r/LocalLLaMA, alguien enfrentó a seis modelos de decisión jugando a Pac-Man. Jev hizo 2.750 puntos de media, Clef-flash 2.538 y Clef 2.476. Es una forma curiosa de medir decisiones encadenadas a toda velocidad.
Y es un juego. El entorno puede premiar estrategias concretas, así que no extrapoles el resultado a la revisión de código.
El orden de las opciones lo cambia todo 
Esta es la que más me preocupa. En una reproducción abierta del patrón System One, recogida en Awesome TypeSafe Jev, la exactitud sobre el mismo conjunto de preguntas pasó del 72 % al 21 % solo con invertir el orden de las opciones.
Es un resultado de esa implementación concreta, no de todos los modelos. Pero demuestra que un juez necesita pruebas de estabilidad: reordena las opciones, reformula la pregunta y comprueba que la respuesta no cambia.
⚠️ Una probabilidad no está calibrada por el hecho de existir. Si tu juez dice «90 %» en mil decisiones, unas 900 deberían ser correctas. Eso solo lo sabes contrastando con resultados reales.
¿Qué modelo juez elegiría para cada escenario? 
Depende del error que no te puedes permitir. Esta es mi lectura, caso a caso.
Jev — la referencia. Lo pondría en todas las pruebas como punto de comparación. Interfaz sencilla, 0,042 $ por millón, buena calibración según las pruebas independientes y el mejor resultado en When2Call. Su gran pega es que es una API cerrada de un único proveedor, y que la visión todavía es experimental.
Clef — calidad y control. El rival más sólido cuando importa la precisión en clasificación y en uso de herramientas. Pesos con licencia Apache 2.0, 64k de contexto e imágenes de serie. Cuesta casi seis veces más que Jev por la API de Cloudflare, pero puedes alojarlo tú.
Clef-flash — decisiones frecuentes y baratas. Lo probaría primero para clasificar tickets, filtrar, enrutar o cualquier evaluación muy repetitiva. Su latencia es la más baja entre los modelos que aciertan bien en las pruebas de Cloudflare. Vigila el contexto de 24k y su caída en CLINC150.
GPT-6 Luna Decisions — si ya vives en OpenAI. Hasta 400 preguntas por llamada, imágenes por URL o base64, un millón de tokens de contexto y retención cero de datos para clientes elegibles. A 0,10 $ por millón, más caro que Jev, pero con el paraguas empresarial que algunas empresas necesitan para firmar.
Decider y d1 — el extremo barato. Decider Flash a 0,01 $ y d1 a 0,02 $, ambos con imágenes. Son las opciones a probar cuando el volumen es enorme y el coste manda. Con ellos, más que con ningún otro, mide antes de confiar.
Clef-omni — cuando el estado no es texto. Audio y vídeo, además de imagen. Según la cobertura del lanzamiento, Cloudflare habla de 1,5 segundos para valorar un vídeo de 21 segundos con sonido. A cambio, rinde por debajo de Clef en varias tareas de texto: no lo elijas si no necesitas la multimodalidad.
Laya y CLM — para aprender y experimentar en local. Sirven para entender cómo funcionan estos modelos, probar sin mandar datos fuera y entrenar variantes. No los pondría como sustitutos de Jev en tareas de alta precisión.
| Si te importa sobre todo… | Prueba primero | Y compáralo con |
|---|---|---|
| Decidir cuándo actúa un agente | Jev | Clef |
| Clasificar intenciones o tickets | Clef | Clef-flash |
| Latencia mínima | Clef-flash | Laya (local) |
| Coste mínimo | Decider Flash | d1 |
| Datos en tu infraestructura | Clef (pesos) | CLM |
| Integración y cumplimiento empresarial | GPT-6 Luna Decisions | Jev |
| Audio y vídeo | Clef-omni | — |
Elegir juez es la mitad del trabajo; la otra mitad es medirlo con tus datos. Cada domingo, gratis, compartimos lo que vamos aprendiendo al meter IA en proyectos reales, con 12 recursos seleccionados.
Quiero esa dinamita 🧨¿Qué aprendimos al usar Jev y Clef en webreactiva.com? 
Aquí no hay benchmark. Hay código en producción.
El buscador de este sitio, el selector de modelos y los revisores de las herramientas gratuitas preguntan a un modelo de decisión. Toda esa lógica pasa por una sola puerta, askDecision, que encadena proveedores: primero Jev, y si falla o tarda, Clef. Como los dos hablan System One, cada proveedor es poco más que una URL y una clave:
const PROVIDERS = { jev: { url: () => "https://api.typesafe.ai/v1/systemone", model: () => "jev-latest", unwrap: (body) => body, }, clef: { // Misma API que Jev; la respuesta llega envuelta en { result } url: () => `https://api.cloudflare.com/client/v4/accounts/${process.env.CLOUDFLARE_ACCOUNT_ID}/ai/run/@cf/cloudflare/${process.env.CLEF_MODEL || "clef"}`, model: () => process.env.CLEF_MODEL || "clef", unwrap: (body) => body.result ?? body, },};Cambiar de Clef a Clef-flash es una variable de entorno. Añadir un tercer proveedor, una entrada más en ese objeto. Esa es la parte fácil.
La difícil vino después. Los umbrales del buscador están medidos con Jev. Cuando decimos «si la intención supera 0,6, enseña este resultado», ese 0,6 es un 0,6 de Jev. El 0,6 de Clef no significa lo mismo, porque cada modelo calibra a su manera. Así que antes de poner Clef como primera opción hay que volver a pasar el conjunto etiquetado y reajustar.
Y hay otra trampa con la clasificación por lotes: si un lote sale mitad de Jev y mitad de Clef porque el primero falló a medias, las notas no casan entre sí. Por eso esa tarea usa un solo modelo, sin alternativa. O todo de uno, o se reintenta entero.
🛡️ Cambiar de juez no es cambiar de URL. Es cambiar la escala de tus umbrales. Si tienes decisiones automáticas apoyadas en probabilidades, vuelve a medir antes de cambiar de proveedor.
¿Cómo comparo modelos juez con un caso real de desarrollo? 
Con tus datos, con casos de resultado conocido y midiendo el error que te duele. Los benchmarks públicos sirven de filtro inicial. La decisión final sale de aquí.
Imagina que quieres un juez en tu agente de programación que decida si un cambio está listo para revisión humana. No le pidas un informe. Dale el diff, los tests y los requisitos, y hazle preguntas concretas:
{
  "state": {
    "requirements": "...",
    "git_diff": "...",
    "test_results": "..."
  },
  "questions": {
    "requirements_met": {
      "type": "noul",
      "instructions": "Are all stated requirements met?"
    },
    "risk": {
      "type": "choice",
      "instructions": "What is the change risk?",
      "options": ["low", "medium", "high"]
    },
    "review_priority": {
      "type": "score",
      "instructions": "How urgently does this need review?",
      "options": ["low", "normal", "urgent"]
    }
  }
}
Es una petición de ejemplo. Las claves exactas cambian entre proveedores y versiones (recuerda el predicate de OpenAI).
Después lanza los mismos casos contra Jev, Clef, Clef-flash, GPT-6 Luna Decisions, uno barato como Decider o d1, y uno local. Y mide más cosas que la exactitud:
| Métrica | Qué te dice |
|---|---|
| Exactitud | Cuántos juicios acierta |
| Falsos negativos | Cuántos cambios peligrosos deja pasar |
| Falsos positivos | Cuántos cambios válidos bloquea |
| Calibración (ECE o Brier) | Si puedes fiarte de sus probabilidades |
| Cobertura a un umbral | Cuánto trabajo automatizas con un error aceptable |
| Latencia p50 y p95 | Cuánto retrasa el flujo |
| Coste real | Cuánto cuestan 10.000 decisiones según la factura, no según la tabla |
| Estabilidad | Si cambia la respuesta al reordenar opciones o reformular |
Un juez con un 90 % de exactitud puede ser peor que uno con un 85 % si el primero deja pasar más cambios peligrosos. En revisión de código, un falso negativo cuesta mucho más que un falso positivo.
Tres reglas para que el experimento valga algo:
- Usa casos con resultado conocido, que tú hayas etiquetado.
- No reutilices ejemplos públicos que puedan estar en el entrenamiento.
- Aplica los mismos criterios a todos los modelos, con el mismo
statey las mismas preguntas.
Si quieres ir un paso más allá, saca el juez del agente. En lugar de que Claude Code, Codex o el agente que uses decida por sí mismo si ha terminado, si una acción es segura o si cumple los requisitos, que lo decida una capa aparte que puede usar Jev, Clef o el que toque. Es una pieza más del harness de tu agente: la mides por separado, la cambias sin rehacer el agente y decides cuándo una respuesta de baja confianza sube a un modelo más potente o a una persona.
¿Con qué modelos empezaría una primera prueba? 
Con seis. Suficientes para ver diferencias y pocos para no ahogarte en datos:
| Modelo | Papel en la prueba |
|---|---|
| Jev 1.14 | Referencia comercial |
| Clef | Techo de calidad |
| Clef-flash | Velocidad y coste |
| GPT-6 Luna Decisions | Integración empresarial |
| Decider 1.2 | El extremo barato |
| Drex Max o kettei-fat | Contraste con los bien situados en JevBench |
Si los datos tienen que quedarse en tu infraestructura, cambia uno de los comerciales por Clef alojado por ti o por CLM, y añade Laya como referencia compacta.
Me quedo con tres ideas de toda esta investigación.
Jev no ha monopolizado la categoría que inventó. En seis semanas han aparecido modelos entrenados para decidir, adaptadores que convierten LLM abiertos en jueces, APIs de los grandes proveedores y plataformas para especializarlos.
El beneficio no es cambiar un LLM caro por otro barato. Es poder tomar decenas de decisiones estructuradas, con incertidumbre medible, dentro del flujo de tu aplicación.
Y los benchmarks son el filtro, no la sentencia. El juez que te conviene depende del error que quieres evitar, de las opciones que le dejas y de la latencia que aguanta tu sistema.
¿Cuál vas a poner a prueba primero?
TL;DR 
- ⚖️ Un modelo juez devuelve probabilidades sobre preguntas tipadas (
noul,choice,scorey ahorabox) sin generar texto, y casi todos hablan la API System One de Jev - 💸 Los precios van de 0,01 $ por millón (Decider Flash) a 0,24 $ (Clef); Jev cuesta 0,042 $ y la salida es gratis en todos
- 📊 No hay ganador: Clef gana clasificando, Clef-flash en llamadas a funciones y velocidad, y Jev en decidir cuándo usar herramientas (When2Call)
- 🖼️ Jev 1.14 acepta imágenes desde el 14 de octubre de 2026, pero en modo experimental con la cabecera
TypeSafe-Danger-Zone-Images: true - 🛡️ Cambiar de juez obliga a recalibrar tus umbrales: el 0,6 de un modelo no es el 0,6 de otro
Preguntas frecuentes sobre modelos juez de IA 
¿Qué es un modelo juez de IA? 
Es un modelo que recibe un contexto y unas preguntas tipadas y devuelve probabilidades sobre las respuestas, sin generar texto. Se usa como clasificador, enrutador, verificador o supervisor dentro de una aplicación o un agente. Jev, de TypeSafe, popularizó la categoría en septiembre de 2026 con el nombre de System One models.
¿Cuál es la mejor alternativa a Jev? 
Depende de la tarea. Clef, de Cloudflare, supera a Jev en clasificación de intenciones y tiene pesos abiertos con licencia Apache 2.0. Clef-flash es más rápido y algo más barato. Jev sigue ganando en When2Call, la prueba sobre cuándo debe un agente usar una herramienta.
¿Cuánto cuesta Jev frente a Clef? 
Jev cuesta 0,042 dólares por millón de tokens de entrada. Clef cuesta 0,24 dólares y Clef-flash 0,038 dólares. Ninguno cobra los tokens de salida, porque solo devuelven probabilidades.
¿Jev admite imágenes? 
Sí, desde Jev 1.14, publicado el 14 de octubre de 2026, pero como función experimental que TypeSafe no recomienda para producción. Se activa con la cabecera TypeSafe-Danger-Zone-Images: true y las imágenes se facturan como tokens de entrada. La misma versión añade el tipo de decisión box, que devuelve las coordenadas de un objeto.
¿Qué modelo de decisión es el más rápido? 
Según las medidas de Cloudflare, Clef-flash tiene una mediana de 38,8 ms y un p95 de 122,4 ms, frente a los 524 ms de mediana de Jev. Laya es aún más rápido en mediana, 5,8 ms, pero acierta mucho menos. Son medidas del propio fabricante de Clef.
¿Es lo mismo un modelo de decisión que usar un LLM como juez? 
No. Un LLM puede juzgar devolviendo una etiqueta en JSON, pero genera tokens, cobra por la salida y su confianza es texto que escribe. Un modelo de decisión devuelve una distribución de probabilidad, suele cobrar solo la entrada, responde en milisegundos y está entrenado para que sus probabilidades estén calibradas.
¿Puedo ejecutar un modelo juez en local? 
Sí. Clef, Clef-flash y Clef-omni publican sus pesos con licencia Apache 2.0, y hay alternativas abiertas como Kev, Laya o CLM. Las pruebas comunitarias muestran que sin ajuste fino los modelos pequeños aciertan bastante menos que Jev o Clef.
¿Por qué no aparece Jev en la API de models.dev? 
Porque models.dev excluye los modelos de tipo decision de su respuesta por defecto. Para verlos hay que pedir https://models.dev/api.json?type=decision o ?type=all. Si tu herramienta de precios usa la URL por defecto, no los verá.
¿Qué es la calibración de un modelo juez y por qué importa? 
Un modelo está bien calibrado cuando sus probabilidades coinciden con la realidad: de todas las veces que dice «90 %», acierta en torno al 90 %. Importa porque los umbrales de tus decisiones automáticas dependen de esas cifras. Se mide con métricas como ECE o la puntuación de Brier contrastando con resultados reales.
¿Puedo cambiar de Jev a Clef sin tocar mi código? 
Casi, porque los dos hablan la API System One, y cambiar de proveedor es cambiar la URL y la autenticación. Lo que no se mantiene son los umbrales: cada modelo calibra distinto, así que hay que volver a medir con tus casos etiquetados antes de cambiar el proveedor principal.
Fuentes 
- TypeSafe: Jev 1.14: imágenes en modo experimental y el tipo
box - TypeSafe: Introducing System One Models and Jev: arquitectura, precio y limitaciones declaradas
- Cloudflare: Introducing Clef: benchmarks y latencias frente a Jev, arquitectura de Clef
- Cloudflare Workers AI: Clef y Clef-flash: precios, contexto y límites de imágenes
- OpenAI: Decisions API: contrato, tipos de pregunta, precio y retención de datos
- models.dev: catálogo de precios y especificaciones, consultado con
?type=decision - JevBench: ranking compuesto de calidad, calibración, coste y latencia
- Awesome System One: directorio de modelos y herramientas
- Awesome TypeSafe Jev: reproducciones abiertas y experimentos
- Reddit: Jev vs Kev: comparativa comunitaria de calidad, calibración y facturación
- Reddit: Evaluating Jev alternatives: evaluación comunitaria de varias alternativas
🧨 Última oprtunidad para recibir la dinamita que mereces sobre programación con IA el próximo domingo: Suscríbete gratis a Web Reactiva en https://webreactiva.com/newsletter
Escrito con la ayuda de la IA generativa de Claude, fuentes fidedignas y con un human in the loop:
Dani Primo.
12 recursos para developers cada domingo en tu bandeja de entrada
Además de una skill práctica bien explicada, trucos para mejorar tu futuro profesional y una pizquita de humor útil para el resto de la semana. Gratis.